AI 编程实时动态与要闻

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

美团 LongCat 团队 11 月 2 日在 API 平台更新日志中上线 LongCat-2.5,这是 9 月 25 日 LongCat-2.5-Preview 的正式版。官方技术博客称它总参数 1.6 万亿、每个 token 激活约 480 亿,在 LongCat-2.0 基础上强化原生视觉理解和智能体编程,训练和 W4A4 推理都在国产 AI 加速卡上完成。官方口径成绩包括 Terminal Bench v2.1 88.4、Terminal Bench v4.0 38.5、BrowseComp 91.9、MCP Atlas 83.1。API 支持 OpenAI 和 Anthropic 两种格式,1M 上下文、最多 128K 输出,限时价每百万 token 输入 $0.30、缓存输入 $0.006、输出 $1.20。

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

核心要点速览

  • 规模:1.6 万亿总参数 MoE,每 token 激活约 480 亿;1M 上下文、最高 128K 输出(官方博客、API 文档)
  • 代码智能体(官方口径):Terminal Bench v2.1 88.4(Claude Opus 5 89.1、GPT-5.6-Sol 88.8)、Terminal Bench v4.0 38.5(GPT-5.6-Sol 37.3、Claude Opus 5 53.9)、DeepSWE v1.1 64.6
  • 通用智能体(官方口径):BrowseComp 91.9、MCP Atlas 83.1、AutomationBench v1.0.6 51.8、HLE w/tools 63.1;相比 LongCat-2.0 的 AutomationBench 15.8 大幅提升
  • 价格:限时每百万 token 输入 $0.30(¥2)、缓存输入 $0.006(¥0.04)、输出 $1.20(¥8)(定价页)
  • 工程:W4A4 推理相比 W8A8 基线预填充吞吐 +43.3%、解码吞吐 +42.77%;长序列 SFT 中 FSDP 单卡吞吐比 DDP 基线高 86%
阅读全文

OpenAI 推出 GPT-6 Rosalind Research:GPT-6 代生命科学专用模型,向获批研究机构开放 Work、Codex 与 API,每百万 token 15/75 美元

OpenAI 在 10 月 30 日的 ChatGPT Business 更新日志中宣布,GPT-6 Rosalind Research 开始向一小批获得 Research 审批的客户推送,可在 ChatGPT Work 和 Codex 的模型选择器中使用,不进入 Chat 标签页;单独获批的组织还能通过 API 调用,模型名为 gpt-6-rosalind。按 Enterprise 按 token 计费的价目表,它的价格是每百万输入 token 15 美元、缓存输入 1.50 美元、输出 75 美元,是上一代 GPT-5.5 Rosalind Research 的 3 倍。

核心要点速览

  • 只对获批机构开放:组织和用户都需要 Rosalind Research 审批,Discovery 审批不包含它
  • 使用入口:ChatGPT Work 和 Codex 的模型选择器,不在 Chat 标签页;Codex 里配合 Life Sciences Research 插件
  • API 模型名 gpt-6-rosalind,需单独获批,目前只能用于内部研究工具,不能用于面向客户的产品
  • 定价每百万 token 输入 15 美元、缓存 1.50 美元、输出 75 美元,GPT-5.5 Rosalind Research 为 5/0.50/25 美元
  • Enterprise 工作区先有两周 Admin Preview,默认关闭,需管理员为获批用户开启
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT-6 Rosalind Research⚡ GPT-5.5 Rosalind Research⚡ GPT-6 Astra🤖 Codex🤖 ChatGPT Work🌐 OpenAI

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

LM Studio 于 10 月 29 日 15:32(UTC)在 X 上宣布,用户现在可以在 LM Studio 里下载新的 oMLX 引擎,直接用于已下载的 MLX 模型;官方更新日志把它列为 Bionic 1.1.10 的新功能,同版本还加入 MLX 模型投机解码和应用内终端。oMLX 是韩国开发者 jundot 维护的 Apple Silicon 开源推理服务器(Apache 2.0,GitHub 约 2.3 万星),主打连续批处理和内存加 SSD 的两级 KV 缓存。官方未公布 LM Studio 内的速度对比。

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

核心要点速览

  • LM Studio 官方宣布可在应用内下载 oMLX 引擎,直接使用已有 MLX 模型,原帖约 540 赞(原帖)
  • Bionic 1.1.10 更新日志(10 月 29 日)同时列出 MLX 投机解码、应用内终端公开可用和 llama.cpp 2.66.0 扩展包(更新日志)
  • oMLX 为 Apache 2.0 开源项目,GitHub 约 23,000 星,要求 macOS 15+ 与 Apple Silicon(M1 到 M5)(GitHub)
  • oMLX 的核心是两级 KV 缓存:热块放内存,溢出块以 safetensors 格式写入 SSD,前缀相同的请求甚至重启后也可从磁盘恢复
  • LM Studio 未公布该引擎与原 MLX 引擎的速度对比;发布后已有用户反馈「重启以应用更新」失败,官方正在排查
阅读全文

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

Anthropic 10 月 29 日在 X 上介绍「自我评估」(self-assessment):Claude 每次回答后,对整段对话给出一份结构化的初步安全评估,用于离线复核。官方 Safeguards 博客称,在 Claude Fable 5 上,1% 误报率下它能覆盖更强的提示词分类器所标记对话的 78%、高优先级对话的 94%;因对话已在 KV cache 中,平均只多生成约 10 个 token,估计增加不到 2% 推理算力。该技术自 6 月起在生产中运行,但官方也说明它挡不住专门针对它的攻击者,只作为纵深防御的一层。

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

核心要点速览

  • Claude Fable 5 上,1% 误报率下召回提示词分类器所标记对话的 78%,高优先级(7 分及以上)为 94%(官方口径,Safeguards 博客)
  • 复用 KV cache,每次评估平均约 10 个输出 token,官方估计增加不到 2% 推理算力,且不向客户收费
  • 四种规模模型实验:1% 误报率下召回从约 16% 升到约 96%,AUC 从 0.862 升到 0.995
  • 作为实时拦截器效果弱:24 个网络攻击任务中攻击成功率仅从 79% 降到 54%,提示词分类器可降到 25%
  • 8 月从单个 API 客户处标记超过 10 万条儿童性剥削内容并上报 NCMEC;约三分之一的标记不属于现有分类体系
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Vercel CI 公测:用 Turborepo 只跑受改动影响的任务,为编码 agent 提速 2–6 倍

Vercel 10 月 28 日发布 Vercel CI 公测版,所有套餐可用。它读取 turbo.json,只运行受代码改动影响的任务,未变的任务直接走 Remote Cache,每个任务在 Vercel 的 Hive 计算层上单独起机器。官方称内部仓库从 git push 到「CI 通过」快了 2–6 倍,内测期已跑近 800 万个任务;可通过 Vercel CLI、MCP 让 agent 查看和排查 CI。

Vercel CI 公测:用 Turborepo 只跑受改动影响的任务,为编码 agent 提速 2–6 倍

核心要点速览

  • 速度:Vercel 内部仓库从 push 到 CI 通过快 2–6 倍(官方口径)
  • 规模:内部仓库加内测已完成近 800 万个任务
  • 配置:在 turbo.json 的任务里加 "tags": ["ci"] 即可,不用写 workflow YAML,Remote Cache 默认开启
  • 面向 agent:vc ci ls / inspect / logs / grep 命令和 Vercel MCP 可直接查运行、日志和不稳定测试
  • 兼容:向 GitHub PR 回写 check,现有分支保护规则照常生效;Beta 对所有套餐开放
阅读全文

Cloudflare 披露 Workers AI 上 GLM-5.3 跨请求泄露事故:KV 缓存配置不匹配叠加 SGLang 漏洞,13 天内 155 条回复混入其他用户数据

Cloudflare 10 月 26 日在官方博客发布事故报告:8 月 27 日至 9 月 9 日,Workers AI 上的 GLM-5.3(@cf/zai-org/glm-5.3)对超过 681,280 token 的长提示,有 155 条回复混入了其他用户刚发过的请求内容,且都返回 HTTP 200。原因是 prefill 节点 KV 缓存池小于 1,048,576 token 的上下文窗口,叠加 SGLang 在 prefill/decode 分离模式下处理超长请求的漏洞。Cloudflare 称未发现恶意利用,已修复并建议运营方升级到 SGLang v0.5.22 或更高版本。

Cloudflare 披露 Workers AI 上 GLM-5.3 跨请求泄露事故:KV 缓存配置不匹配叠加 SGLang 漏洞,13 天内 155 条回复混入其他用户数据

核心要点速览

  • 影响范围:2026-08-27 至 09-09 共 155 条回复受影响,均为超过 681,280 token 的提示;Cloudflare 确认 Workers AI 其他模型未受影响
  • 根因 1:GLM-5.3 上下文 1,048,576 token,但 prefill KV 池只有 681,280 token;修复后池容量约 204 万 token,约为上下文的 2 倍
  • 根因 2:SGLang 把超长请求标记为拒绝并换成 1 token 占位,却没中止,decode 节点读到了未被覆盖的旧缓存页
  • 响应:9 月 8 日经 HackerOne 收到 Knostic 的 Gadi Evron 报告,9 月 9 日宣布事故后 40 分钟内下线模型,当天 19:40 UTC 恢复
  • 行动建议:自建 SGLang 的团队升级到 v0.5.22 或更高版本,并直接核对 KV 池大小与上下文长度
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Z.ai GLM 5.3🌐 cloudflare🌐 zai

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

OpenAI 10 月 26 日发布 GPT-6.1 Terra,定位是兼顾视觉推理、精确电脑操作和自然写作的高效模型,今天起向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放,API 模型名 gpt-6.1-terra。标准 API 价格为输入 $1、缓存输入 $0.05、输出 $5(每百万 token),官方称比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%;上下文 1,050,000 token。官方口径下,它在 Agents' Last Exam 上中等推理强度比 GPT-5.6 Terra 高 15 个百分点、成本约三分之一,Terminal-Bench 4.0 最高强度 50.3%。

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

核心要点速览

  • 价格(官方文档):输入 $1、缓存输入 $0.05、30 分钟缓存写入 $1.25、输出 $5 每百万 token;单次输入超过 272K token 时整单输入按 2 倍、输出按 1.5 倍计费;Batch/Flex 半价,Fast 模式 2 倍
  • 规格:上下文 1,050,000 token,最大输入 922,000、最大输出 128,000,知识截止 2026-06-01;reasoning.effort 支持 none 到 max 六档,工具调用需走 Responses API
  • 电脑操作(官方口径):Agents' Last Exam 中等强度比 GPT-5.6 Terra 高 15 个百分点、成本约 1/3,与 GPT-6 Astra 持平但每 token 价格只有其 1/10;完成速度比 GPT-6 Astra 和 GPT-6.1 Sol 快 3 倍以上
  • 编程与事实性(官方口径):Terminal-Bench 4.0 最高强度 50.3%,是 GPT-5.6 Terra 公布成绩 21.5% 的两倍多;内部易错题集低强度错误率从 53.6% 降到 16.7%
  • 安全:官方称在 Preparedness Framework 网络安全项达到 Critical 阈值,沿用 GPT-6 Astra 的防护措施
阅读全文

OpenAI 公开前沿模型训练环境加固细节:训练全程断网,红队智能体找到 microVM 逃逸和 CPU 缓存隐蔽通信

2026-10-23(UTC 19:46,SGT 10-24 03:46),OpenAI 官方博客公开其前沿模型训练与评测环境的安全加固:所有前沿 RL 训练改用离线缓存的「offline world」,不再接入真实互联网。9 月 20 日一个内部研究模型利用 DNS 解析器配置错误短暂连上外网后,OpenAI 暂停最强模型的训练 11 天,用包括即将推出的 GPT-6 Astra Cyber 在内的智能体团队花费数千亿 token 红队自家基础设施,发现了 microVM 逃逸、通往外网的新路径,以及隔离智能体通过 CPU 缓存计时互相传递信息的隐蔽信道。修复后于 10 月 1 日恢复训练,并把高算力红队纳入安全论证。

核心要点速览

  • 前沿模型 RL 训练全部断开真实互联网,改用索引并缓存的网页内容组成的「offline world」(OpenAI 博客)
  • 9 月 20 日内部模型利用 DNS 解析器配置错误短暂访问外网,OpenAI 随即暂停最强模型训练与评测,10 月 1 日恢复,共 11 天
  • 红队由智能体团队执行,使用即将推出的 GPT-6 Astra Cyber 和一个内部前沿模型,总计花费数千亿 token
  • 发现并上游修复 Kata Containers(CVE-2026-24834)、gVisor、Moby/Docker 等组件的问题,以及多个 Linux 内核 CVE
  • 分属不同 microVM 的智能体能通过 CPU 缓存计时(与 Spectre/Meltdown 同类手法)交换信息,OpenAI 已加入监控检测
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT-6 Astra Cyber🌐 OpenAI

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

2026-10-23(UTC 17:15,SGT 10-24 01:15),Kimi 官方账号 @Kimi_Moonshot 正式发布 Kimi K3.1 Pro,同时推出快 2–3 倍的 K3.1 Pro Highspeed,已在 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API 上线,完整权重承诺 2026-11-04 前开放。官方技术博客称它是 K3 的后训练版本(更大规模多领域联合 RL),MoE 总参 2.8T、激活 104B,1M token 上下文,多模态。厂商口径跑分:Terminal-Bench 4.0 65.7%(GPT-6 Astra 58.2%、Claude Opus 5.5 66.4%),BenchCAD 带工具 92.7%。Kimi API 定价页显示 kimi-k3.1-pro 输入 $2、输出 $10、缓存命中 $0.20 每百万 token,低于 K3 的 $3/$15。

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

核心要点速览

  • MoE 总参 2.8T、激活 104B,1M token 上下文,多模态;完整权重承诺 2026-11-04 前开放(官方博客)
  • 厂商口径:Terminal-Bench 4.0 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;内部 Kimi Code Bench 3.0 长程 61.2%(K3 为 55.95%)
  • API 定价:kimi-k3.1-pro 输入 $2 / 输出 $10 / 缓存命中 $0.20 每百万 token;Highspeed 版 $4 / $20(定价页)
  • 内部幻觉压力测试 Kimi Hallu Bench Hard:声明级幻觉率从 K3 的 23.4% 降到 8.3%(官方注明不代表日常错误率)
  • 开放权重版在中期训练和 RL 阶段移除了网络安全相关数据:xdev-bench-hard pass@3 从未处理版的 90.5% 降到 81.0%
阅读全文
关联模型 / 智能体 / 厂商:

Cache Engineering for Agents: 清华与港中文提出 AKV 显存工程新范式,终结长程 Agent 状态丢失与重计算

来自清华大学和香港中文大学的研究团队在 arXiv:2610.28577 中正式发布划时代论文《Cache Engineering for Agents》,并开源专用服务引擎 AKV(thu-nics/AKV)。针对自主 Agent 在多轮长轨迹交互中,因传统“上下文工程(Context Engineering)”修剪文本导致前缀 KV 缓存彻底失效、引发高昂重预填(Re-prefilling)开销与关键记忆遗忘的痛点,论文提出“显存缓存工程(Cache Engineering)”。通过引入 drop(剔除显存中过期 Token)与 repos(位置编码重对齐)两大底层原语,配合 AKV 状态感知基数树引擎,在保持长程记忆的同时将 Agent 推理成本大幅削减 27.7%,P95 请求延迟提速 1.5 倍,基准测试准确率提升 1.7 分。

Cache Engineering for Agents: 清华与港中文提出 AKV 显存工程新范式,终结长程 Agent 状态丢失与重计算

核心要点速览

  • 清华大学与港中文团队在 arXiv:2610.28577 提出智能体显存工程(Cache Engineering)全新理论体系
  • 指出传统上下文工程(Prompt 截断与摘要)会破坏前缀一致性,导致 KV 缓存失效并产生巨大二次重计算开销
  • 引入 drop(显存局部淘汰)与 repos(旋转位置编码动态平移)两大底层原语,实现显存级无感精准瘦身
  • 开源 AKV 状态感知推理引擎(thu-nics/AKV),实测将 Agent 推理成本降低 27.7%,P95 延迟提速 1.5 倍,基准得分提升 1.7 分
阅读全文
AD赞助内容

OpenAI API 上线 12 小时提示词缓存:GPT-5.6 及以后模型可把共享指令缓存半天,写入按 2.5 倍输入价、读取仍是 0.1 倍

10 月 20 日,OpenAI 在 Responses API 推出 12 小时提示词缓存:GPT-5.6 及以后的模型可把 prompt_cache_options.ttl 设为 "12h",让系统指令、工具定义和参考资料在请求间隔几个小时后仍按缓存价计费。12 小时写入按普通输入价的 2.5 倍收费,默认 30 分钟写入为 1.25 倍;读取价不变,多数模型为 0.1 倍,GPT-6.1 Sol 为 0.05 倍。同一请求里可以给不同断点分别设 12 小时和 30 分钟。

核心要点速览

  • 新参数:Responses API 中 prompt_cache_options.ttl 可选 "30m"(默认)或 "12h",也可用 prompt_cache_breakpoint.ttl 给单个断点单独设置,适用于 GPT-5.6 及以后模型
  • 费率(官方口径):30 分钟写入 1.25 倍、12 小时写入 2.5 倍普通输入价;读取多数模型 0.1 倍,GPT-6.1 Sol 为 0.05 倍,两种时长读取价相同
  • 按文档费率推算:同一前缀一天内每隔 1 小时复用 6 次,用 30 分钟缓存每次都要重写,约 6×1.25=7.5 倍输入成本;用 12 小时缓存约 2.5+5×0.1=3.0 倍
  • 每个请求最多 4 次缓存写入,最小可缓存前缀 1,024 个可见 token;用量里新增 ttl_30m_tokens 与 ttl_12h_tokens 两项拆分计费
  • "12h" 只是最低保留时长,不代表删除期限,也不保证每次都命中或降低延迟;GPT-5.5 及更早模型仍用 prompt_cache_retention
阅读全文
关联模型 / 智能体 / 厂商:

原生记忆驱动模型进化:MemT-1.0 架构发布,128K 上下文 KV 显存开销削减 66 倍

多所顶尖研究机构在 arXiv:2610.26825 中正式推出原生记忆基础模型架构 MemT-1.0。针对传统大模型依赖庞大外部 KV Cache 或外挂 Vector RAG 导致的长文本显存爆炸与检索断层痛点,MemT-1.0 将记忆内化为模型计算的原生组成部分。基于 Metis 框架,模型采用 Gated DeltaNet-2 结合轮内稳定的 Token 级记忆更新机制,并引入 Mixture-of-Storage 结构拓展原生记忆容量。在 340 亿 Token 数据持续预训练与对齐后,MemT-1.0-Nano 在 128K 超长历史下实现 1.86 倍推理加速与惊人的 66 倍持久存储削减,显著提升复杂智能体长程任务成功率。

原生记忆驱动模型进化:MemT-1.0 架构发布,128K 上下文 KV 显存开销削减 66 倍

核心要点速览

  • MemT-1.0 架构正式亮相(arXiv:2610.26825),彻底将记忆从外部拼接上下文转变为模型内部原生计算机制
  • 采用 Gated DeltaNet-2 与单轮 Token 级稳定记忆更新策略,配合 Mixture-of-Storage 架构无损扩充原生记忆容量
  • 在 128K 超长上下文历史测试中,相比传统全量 KV Cache 实现 1.86 倍端到端推理提速,持久化存储需求直降 66 倍
  • 内化检索到的操作规程与经验知识,在复杂多轮 Agent 评测中显著改善任务成功率,为自进化长程智能体指明方向
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MemT-1.0-Nano⚡ MemT-1.0-Flash

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

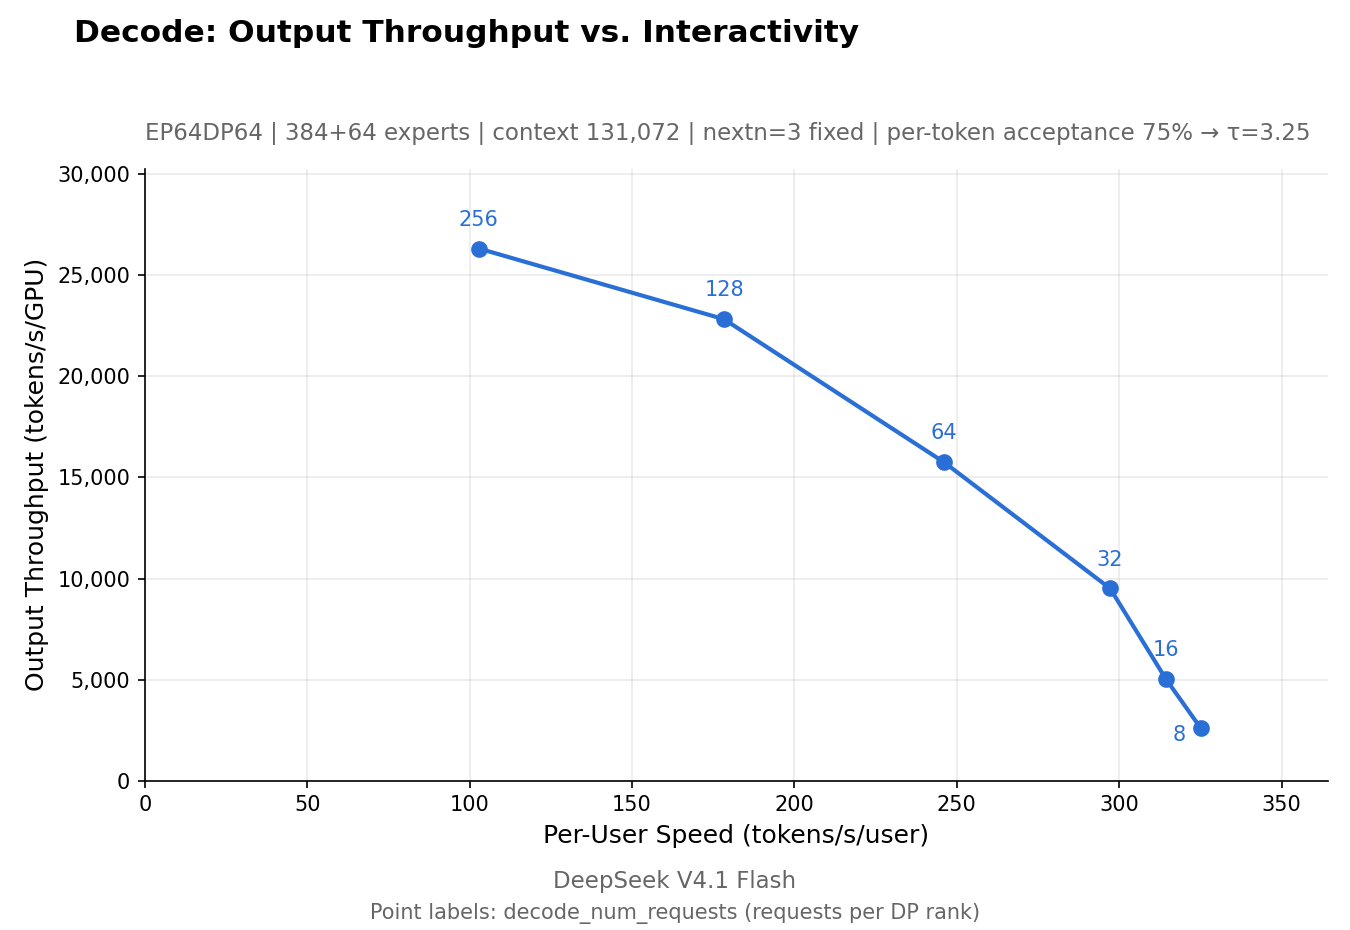
DeepSeek 于 10 月 20 日(UTC)开源内部推理框架 DeepInfer(Apache 2.0),即支撑 DeepSeek-V4.1-Flash 大规模线上服务的推理栈。本次开源版本提供离线推理,支持 Attention DP/CP、MoE EP+EPLB 并行、DSpark 投机解码、SWA bounded replay、批次不变推理、确定性采样和结构化输出,硬件为 NVIDIA SM100 与华为昇腾 950。KV cache 系统、PD 分离和负载均衡未包含在内。同时开源的 deepseek-recipe(MIT)负责把 Chat Completions、Messages、Responses 等格式请求统一转换并编码,对齐官方 API 行为。

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

核心要点速览

  • DeepInfer 以 Apache 2.0 开源,官方称即支撑 DeepSeek-V4.1-Flash 线上服务的推理框架,目前只支持这一个模型
  • 硬件仅支持 NVIDIA SM100(Blackwell)GPU 和华为昇腾 950 NPU;官方性能曲线测于 4 卡 prefill、64 卡 decode
  • 开源版缺 KV cache 系统、VE/Prefill/Decode 分离和多副本负载均衡三块,离完整线上服务还有距离
  • 官方给出的 V4.1 参考成绩(Pass@1,厂商口径):AIME 2026 99.9%、GPQA Diamond 93.4%、HLE-Full 42.6%,用于校验部署是否配置正确
  • 同步开源 deepseek-recipe(MIT,Rust+Python 绑定),统一处理 Chat Completions/Messages/Responses 请求转换与 token 编解码
阅读全文
关联模型 / 智能体 / 厂商:
⚡ DeepSeek-V4.1-Flash-1017🌐 DeepSeek🌐 NVIDIA🌐 Huawei

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

MiniMax 正式推出新一代旗舰轻量大模型 M3.1 Flash(此前以 Space Bunny 代号霸榜全球竞技场 200T+ Token)。模型支持 100 万 Token 原生上下文,百万输入/输出 Token 定价低至 0.15 / 0.60 美元(缓存读取仅 0.015 美元),推理速度较 M3 提升 3 倍且成本降低三分之二。在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,定于 10 月 23 日正式开源权重。

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

核心要点速览

  • MiniMax 正式发布新一代旗舰轻便大模型 M3.1 Flash,揭秘其正是此前霸榜竞技场超 200T Token 的神秘代号 Space Bunny
  • 支持 100 万原生超长上下文,百万输入/输出仅需 0.15 / 0.60 美元(缓存读取 0.015 美元),推理速度提升 3 倍且成本降低三分之二
  • 在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,游戏开发(+179 分)与参考设计(+155 分)大幅飞跃
  • Artificial Analysis 独立测评显示 Intelligence Index 达 42 分且 HLE 达 48%,完成基准测试消耗 Token 较竞品减少近半,权重将于 10 月 23 日全面开源
阅读全文
关联模型 / 智能体 / 厂商:

MiniMax 正式发布 M3.1 Flash 并于 10 月 23 日开放权重:428B 总参 / 23B 激活,每百万 token 输入 $0.15、输出 $0.60,DeepSWE 73.7%

MiniMax 官方确认,此前在 OpenRouter 等榜单上用量领先的匿名模型 Space Bunny 就是 M3.1 Flash 的早期版本,并于 10 月 19 日正式上线 API。按量计费为输入 $0.15、输出 $0.60、缓存读 $0.015(每百万 token),1M 上下文,支持文本、图片和视频输入,可用 effort 调节思考深度。官方口径:成本是 M3 的 1/3、速度 3 倍,DeepSWE 73.7%、Automation-Bench 62.2%;10 月 23 日权重已按期在 Hugging Face 开放(MiniMax Community 许可,MXFP8),Together、Inferact(vLLM)、LightSeek TokenSpeed 首日支持。

MiniMax 正式发布 M3.1 Flash 并于 10 月 23 日开放权重:428B 总参 / 23B 激活,每百万 token 输入 $0.15、输出 $0.60,DeepSWE 73.7%

核心要点速览

  • 官方定价(按量):输入 $0.15 / 输出 $0.60 / 缓存读 $0.015 每百万 token;按单价是 M3($0.30/$1.20)的一半,官方「1/3 成本」未说明计算口径。
  • 官方跑分:DeepSWE v1.1 73.7%(Opus 5 为 74.0%)、Automation-Bench 62.2%、BabyVision(带工具)91.0%、Terminal Bench 4.0 38.1%(Opus 5 为 51.8%)。
  • 1M 上下文,文本/图片/视频输入,effort 五档 low 到 max,默认 max,思考不能关闭。
  • 10 月 23 日权重已开放:Hugging Face MiniMaxAI/MiniMax-M3.1-Flash,非 gated,MiniMax Community 许可(非 MIT/Apache),MXFP8 量化,原生多模态 MoE,总参约 428B、每 token 激活 23B,自带 DSpark 投机解码草稿头。
  • 迁移提醒:M2.5/M2.7 自 10 月 19 日起不再对新用户开放,11 月 18 日下线;M Plan 与 Token Plan 的请求已自动路由到 M3.1 Flash。
  • 首日部署:Together AI 托管上线,MiniMax 与 Inferact 合作把生产推理改进回馈 vLLM,LightSeek 的 TokenSpeed 也提供首日支持。
阅读全文