AI 编程实时动态与要闻

前 GitHub CEO Thomas Dohmke 的 Entire 发布面向 Agent 协作的 Git 托管平台:用 Trails 取代 PR,官方称推送比 GitHub 快最多 89 倍

Entire 联合创始人兼 CEO Thomas Dohmke 10 月 26 日在 X 和官方博客宣布 Entire 正式上线,定位是「为 Agent 与人协作打造的 Git 托管平台」。它由三部分组成:用评测分数替代 diff 评审的 Trails、兼容 Git 的分布式托管(可多区域复制,也可从 GitHub 镜像),以及把 Agent 会话存进仓库的 Continuous Memory。CI 首批接入 Buildkite 和 Depot,今天起对所有开发者开放。

前 GitHub CEO Thomas Dohmke 的 Entire 发布面向 Agent 协作的 Git 托管平台:用 Trails 取代 PR,官方称推送比 GitHub 快最多 89 倍

核心要点速览

  • 推送速度(官方/厂商口径,开源基准):每秒推送 Entire 418 次、Cursor Origin 65、Pierre 15、GitLab 10、GitHub 4.7,即比 GitHub 快最多 89 倍、比 Cursor Origin 快 6 倍
  • Trails:每次 push 都由多个评审 Agent 在云沙箱里独立打分(默认有 Security、Slop、Human Review Required 等评测),显示最近 5 次和当前分数,可配置 Gates 要求人工批准和 CI 通过才能合并
  • Continuous Memory:开源、本地优先的 entire-graph 和 entire-brain 两个插件,官方测试中 entire-graph 最多省 71% token
  • 区域:首发支持美国、欧盟、澳大利亚、印度托管,可从 GitHub 镜像并保留 GitHub 为主仓库
  • 价格:博客未公布
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Grok Imagine 官方发布 AI 制作的《奥德赛》第 1 集(约 7 分钟、4K),240 万浏览,AI 能否讲好长篇故事引发争论

Grok Imagine 官方账号(@imagine)在 UTC 2026-10-23 19:23 发布《Odyssey》系列第 1 集(原帖),称由 Grok Imagine 制作,与 Wonder Studios(@WonderStudiosX)和导演 Dev Walker(@glumlot_)合作完成;视频时长约 7 分 12 秒,提供 3840×2160 版本。抓取时原帖约 12,055 赞、1,275 转发、433 引用、974 回复、240 万浏览,官方还在帖中问大家是否想看完整制作拆解。过去半天 X 上讨论持续升温:支持者认为这是 AI 视频从十几秒片段走向「按集交付」的一步,批评者则指出表演不连贯和 AI 画面瑕疵。这是一条 X 热议,观点按观点呈现,不是对影片质量的结论。

核心要点速览

  • 主帖:Grok Imagine 官方原帖,UTC 10-23 19:23 发布,抓取时约 12,055 赞、1,275 转发、433 引用、974 回复、6,361 收藏、240 万浏览
  • 官方说明:由 Grok Imagine 制作,与 Wonder Studios 和导演 Dev Walker 合作;视频约 7 分 12 秒,提供 4K(3840×2160)版本
  • 官方在帖中询问是否需要完整的制作拆解,尚未公布具体流程、片段数或成本
  • 讨论两极:一方认为 AI 视频开始能按集交付、导演和分镜比模型更关键;另一方批评表演不连贯和画面瑕疵
  • 本条按 X 热议处理;网上流传的制作天数、素材数量等数字未经官方确认,本文不采用
阅读全文
关联模型 / 智能体 / 厂商:

腾讯优图与清华开源 Looking Ahead 自回归视频生成:利用前瞻注意力机制攻克长序列累积漂移

腾讯优图实验室(Tencent ARC)联合清华大学在 arXiv:2610.29989 正式发布并开源基于自回归(AR)架构的长视频生成新范式 Looking Ahead(TencentARC/Looking-Ahead)。针对传统自回归视频模型采用逐帧、逐 Token 单向外推导致误差呈指数级累积、在数十帧后画面严重变形崩溃的行业顽疾,Looking Ahead 提出前瞻注意力(Lookahead Attention)机制。系统在保持自回归高效流式生成特性的同时,引入全局规划前瞻流对未来时空锚点进行宏观锁定,反向约束当前局部帧的微观生成,全面终结自回归视频的时空漂移与纹理闪烁,树立了开源自回归视频生成新标杆。

腾讯优图与清华开源 Looking Ahead 自回归视频生成:利用前瞻注意力机制攻克长序列累积漂移

核心要点速览

  • 腾讯优图与清华大学在 arXiv:2610.29989 联合发布并开源 Looking Ahead 长视频自回归生成框架
  • 彻底攻克传统自回归模型因单向逐 Token 生成导致的误差累积与画面后期崩溃崩塌(Cumulative Drift)
  • 首创前瞻注意力机制(Lookahead Attention),以双流全局规划锚点反向约束当前局部帧的时空一致性
  • 在长序列物理一致性与动态保真度评测中大幅超越现有开源自回归基线,代码与模型权重全面开放
阅读全文
关联模型 / 智能体 / 厂商:

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

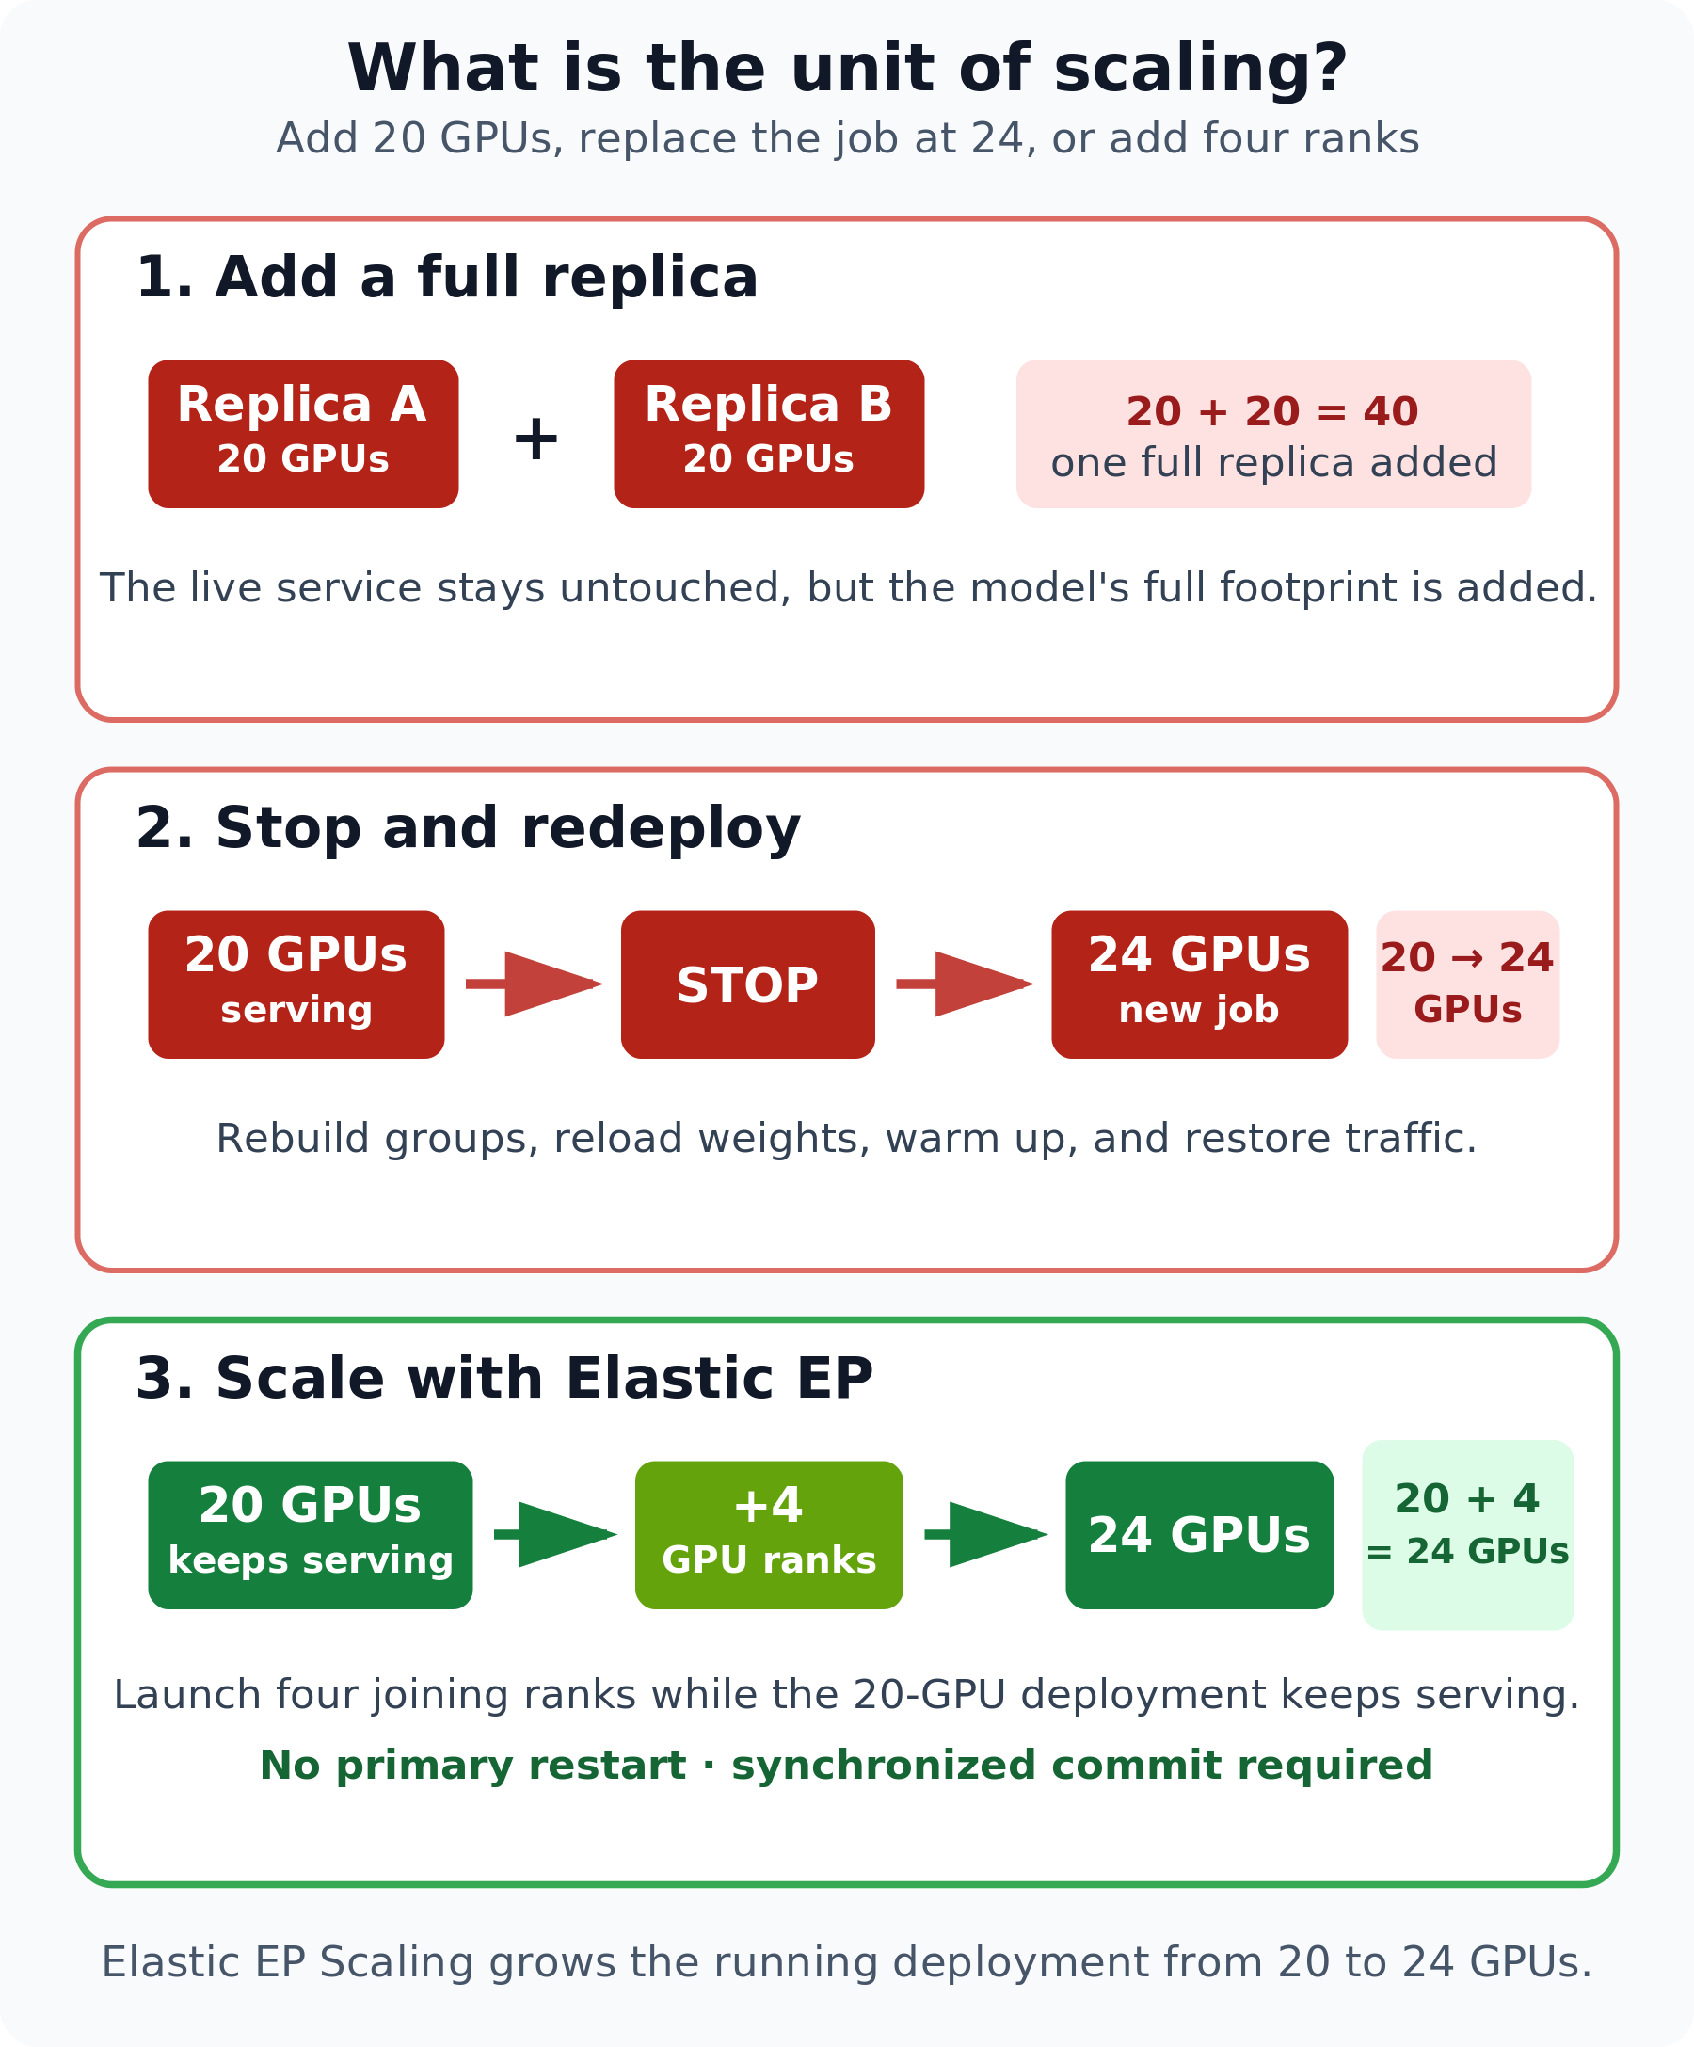
LMSYS 团队联合 NVIDIA Dynamo 团队在官方技术博客与 X(@lmsysorg)正式宣布,高性能大模型推理框架 SGLang 推出弹性专家并行(Elastic EP)与 NIXL(Near-Instant Cross-Node Link)动态伸缩后端。针对超大 MoE 架构(如 DeepSeek-V3/V4)在传统静态专家并行下因单卡硬件故障导致全集群崩溃重启、以及业务高峰期无法在线扩容的严重痛点,Elastic EP 实现了专家-GPU 映射解耦。依托 NVIDIA NIXL 高性能通信原语与 Mooncake 调度器,SGLang 首次实现在完全不中断在线推理请求的前提下,将运行中的 MoE 集群动态扩容(如从 20 卡无感扩展至 24 卡),并支持单节点故障的秒级自动降级容错。

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

核心要点速览

  • LMSYS 与 NVIDIA Dynamo 团队联手发布 SGLang Elastic EP,正式支持 MoE 模型在线动态扩缩容
  • 彻底破解静态专家并行(Static EP)在单节点硬件故障时全集群宕机的致命痛点,支持秒级自动容错降级
  • 集成 NVIDIA NIXL 高性能跨节点通信原语(--moe-a2a-backend nixl),支持 RDMA 与 NVLink 原生零拷贝调度
  • 实现零停机在线扩容(Live Scale-Up),集群可在持续处理生产推理请求的同时从 20 卡在线平滑扩容至 24 卡
阅读全文
AD赞助内容

humans& 发布首个模型 Ampersand v0.1:基于 GLM 5.3 训练的群体协作模型,已通过 Agents API 开放

10 月 20 日,AI 创业公司 humans& 发布首个模型 Ampersand v0.1,定位是帮一群人达成个人和共同目标的“协作者”,而不是独自完成任务的助手。它基于 Z.ai 的 GLM 5.3(约 744B 总参数、约 40B 激活)用长程多人模拟强化学习训练,模拟用户由自研用户模型 Persimmon 扮演。模型即日起通过兼容 OpenAI Agents API 的接口开放,无需排队。

humans& 发布首个模型 Ampersand v0.1:基于 GLM 5.3 训练的群体协作模型,已通过 Agents API 开放

核心要点速览

  • 基座:GLM 5.3 MoE,约 744B 总参数、约 40B 激活,上下文 1,048,576 tokens(官方模型卡)
  • 长期协作模拟评测(官方口径):Ampersand 12.94,基座 GLM 5.3 为 9.89
  • Collaborative Intelligence 团队协作 59.1%(GLM 5.3 为 54.3%);CooperBench 协同编码成功率 39.0%,GLM 5.3 协同时仅 17.3%
  • 代价:SWE-bench Pro v2(Hard-51)82.4%,略低于基座的 84.3%;官方也承认它有时会“过度指导”
  • 接入:模型 ID ampersand-v0.1,可直接用官方 OpenAI SDK 指向 humans& 的 base URL
阅读全文
关联模型 / 智能体 / 厂商:

推理算力也能滚雪球复利!GitSwarm 发布:基于 Git 分支与原子提交解锁分布式复合推理

在攻克前沿数学猜想、自动化软件重构与跨学科科研发现等长程复杂任务(Long-Horizon Problem Solving)时,人类科研团队的成功依赖于认知成果的‘跨轮次复利累积’:失败的尝试、部分的推导与中间实验数据均能作为持久资产被后续同伴审视、分叉与整合。然而,现有的推理期扩展(Test-Time Scaling)范式几乎完全局限于孤立的单条探索轨迹(如 Monte Carlo Tree Search 或 Best-of-N 采样),各条路径彼此隔绝,中间算力成果在失败时被全盘丢弃,无法实现知识复利。学术研究团队在最新研究(arXiv:2610.04862)中正式提出了‘复合推理(Compounding Inference)’理论与开源系统 GitSwarm。GitSwarm 首次将开发者熟悉的 Git 版本控制协议深度改造为多智能体底层协作中枢:同构 Agent 群自主决定如何推进任务,并在共享且可自由分叉的 Git 仓库中通过‘原子提交(Atomic Commits)’固化中间产物,通过语义依赖追踪(Semantic Dependencies)跨分支提取经验并验证合成新方案。在数学竞赛 IMOProofBench-Advanced 极限压测中,GitSwarm 驱动 GPT-5.5 在单次运行中以 100% 的成功率全通全部 30 道高难难题;在复杂程序生成基准 ProgramBench 上达成 79.4% 平均得分(大幅碾压同期最强基线的 65.1%),论文已正式公开。

核心要点速览

  • 提出‘复合推理(Compounding Inference)’新范式与 GitSwarm 架构,彻底告别单分支推理算力浪费
  • 以真实 Git 仓库为协作中枢,通过原子提交、语义依赖图与分支合并实现多智能体长程认知资产累积
  • IMOProofBench-Advanced 30 道国际奥数难题单次运行 100% 全通,ProgramBench 跑分高达 79.4% 碾压基线
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 联手 Ironclad 用强化学习训练 GPT-6 Astra 操作专业软件:合同工作流得分 55.0%(Sol 41.6%),单次耗时减半

OpenAI 公布首个“垂直 SaaS 共建”计算机操作研究:与合同平台 Ironclad 共同定义 11 个法务/采购/商务任务,在 Ironclad 托管环境里用 RL 训练 GPT-6 Astra。Astra 平均 rubric 得分 55.0%(GPT-5.6 Sol 41.6%),估算单次耗时 19.2 分钟 vs 37.0 分钟;内部模型已达 63.7%。OpenAI 同时开放软件公司申请合作。

OpenAI 联手 Ironclad 用强化学习训练 GPT-6 Astra 操作专业软件:合同工作流得分 55.0%(Sol 41.6%),单次耗时减半

核心要点速览

  • 11 个真实合同任务、每个 8–50 条评分标准;资深用户人工约需 30–40 分钟/任务(OpenAI 原文)
  • GPT-6 Astra(Max 推理)平均得分 55.0%,GPT-5.6 Sol(High 推理)41.6%,相对提升约 32%
  • 估算单次耗时 37.0 → 19.2 分钟(约 -48%);注意这是按模型速度模拟的时间,不是客户实测节省
  • 演示任务中 Astra 约 20 分钟满足 ~94% 标准,Sol 约 32 分钟满足 ~85%;内部研发模型已到 63.7%
  • 训练数据来自 SEC EDGAR 公开合同并去除个人信息,未用 OpenAI 或 Ironclad 客户数据
阅读全文

AgentWorld 首发长程多智能体协作基准:50+ 轮跨角色黑盒博弈,引入因果协作效率 CCE 指标

针对现有评测大多局限于 20 步以内的短程或单体能力简单累加的缺陷,宾大等学者发布开源多智能体协作评测基准 AgentWorld。在包含 50+ 轮交互的 MMORPG 沙箱中构建 100 项人工校验任务,涉及 3-20 个具备非对称技能的黑盒智能体。研究提出因果协作效率(CCE)图算法,实测顶级模型成功率仅 52.0%,揭示长程规划衰减与沟通崩溃两大瓶颈。

AgentWorld 首发长程多智能体协作基准:50+ 轮跨角色黑盒博弈,引入因果协作效率 CCE 指标

核心要点速览

  • 超长程协作与黑盒博弈:打破以往 20 步以内的玩具评测,设置跨越 50+ 轮交互的 MMORPG 沙盒,支持 3 至 20 个具备非对称角色与独立状态的智能体协同。
  • 首创 CCE 因果协作指标:提出因果协作有效性(Causal Collaboration Effectiveness, CCE)图分析算法,精确量化团队整体动作中有多少比例真正对最终成功产生因果贡献。
  • 前沿模型天花板实测:在 Gemini 3 Flash、Claude Haiku 4.5、GPT-5 Mini 与 DeepSeek R1-70B 的测评中,最高任务成功率仅为 52.0%,揭示多智能体在长上下文遗忘与角色认知混乱上的严峻瓶颈。
阅读全文
关联模型 / 智能体 / 厂商:

cf-mailroom 开源:基于 Cloudflare 与 MCP 的人机协同全栈邮件系统

独立开发者 wong2 开源 cf-mailroom,这是一套完全跑在 Cloudflare 基础设施(Workers + Email Routing + D1 + R2 + Web Push)上的自托管人机协同邮件系统。系统为人类提供类 Gmail Web UI,同时向 AI Agent 开放基于 MCP(Model Context Protocol)的安全读写与邮件发送能力。支持入站邮件自然语言自动打标、Agent 智能回复草稿生成及一键人工审核,大幅降低企业与开发者构建自主邮箱 Agent 的基础设施门槛。

cf-mailroom 开源:基于 Cloudflare 与 MCP 的人机协同全栈邮件系统

核心要点速览

  • 架构全托管:完全基于 Cloudflare Workers + D1 关系库 + R2 对象存储与 Email Routing,无需自建 SMTP/IMAP 邮件服务器
  • 人机无缝协作:人类通过类 Gmail Web 前端操作,外部 AI Agent 通过官方 MCP 协议标准获取读写上下文与代发能力
  • Agent 回复审核流:内置 AI 自动草稿功能与 Playbook 编排,邮件在人类一键 Click-to-Send 确认前保持草稿状态,彻底规避幻觉失控
  • 企业级访问保护:开箱支持 Cloudflare Access 零信任鉴权,保护私有域名邮件与 OAuth 授权端点
  • 一键 Deploy 体验:支持 Cloudflare 部署按钮全自动创建 D1/R2 存储与数据库迁移,开源代码获 200+ Stars
阅读全文

腾讯混元联合复旦开源 ExplorationBench:首创可验证“外星世界”科学探索基准,破解大模型泛化记忆幻象

腾讯混元团队(Tencent Hunyuan,@TencentGlobal)联合复旦大学 NLP 实验室(黄萱菁、张奇团队)正式开源了面向前沿 AI 系统的科学自主探索评测基准 ExplorationBench(arXiv: 2609.30199,项目主页: explorationbench.com)。面对现有模型在传统科学考题中仅仅依赖海量预训练数据的“死记硬背”、难以判定其是否具备真正科学探索与假设验证能力的行业难题,团队开创性构建了由 AlienCode 与 AlienLogic 两大交互沙箱组成的“可验证外星世界(Alien Worlds)”。沙箱底层运行与人类现实常识截然冲突的确定性新物理/代码法则,系统必须自主提出假说、设计实验调用工具并闭环验证真伪。

腾讯混元联合复旦开源 ExplorationBench:首创可验证“外星世界”科学探索基准,破解大模型泛化记忆幻象

核心要点速览

  • 首创“外星世界(Alien Worlds)”反常识可执行沙箱,彻底切断大模型从预训练语料中检索答案的记忆作弊通路。
  • 涵盖 AlienCode 与 AlienLogic 两大沙箱环境,包含 55 个科学发现目标与 140 组严谨多步推演任务。
  • 为模型提供带缺陷的手册、任务特定环境反馈与专用工具调用 Schema,全生命周期考查智能体的主动假设检验能力。
  • 横向评测 10 大前沿模型发现:虽然顶尖模型能摸索掌握未知规则,但在多轮长程探索中极易发生停滞或推翻早期正确结论。
  • 项目主页、自动化沙箱运行镜像与完整评测基准套件已在 GitHub 与 Hugging Face 全面公开。
阅读全文
AD赞助内容

NYU 联合 DeepMind 开源数学自主发现系统:首创内在趣味性量化指标,脱离人工预设自拓定理库

纽约大学(NYU)联合 Google DeepMind 杰出科学家 Rémi Munos 等在 Hugging Face 与 ArXiv 正式公开了《Learning to Discover Interesting Mathematics》(arXiv: 2609.28603)。随着大语言模型在形式化数学证明(Lean 4、Mathlib)中展现出强悍的求解能力,AI 已经能够轻易生成成千上万个冷僻枯燥的平凡定理,但大模型究竟能否自主识别出“真正有学术价值且有趣的数学新知”始终未解。团队首创以“证明长度与命题表述长度之比”作为定理内在趣味性的量化指标,并训练了 27B 参数的证明难度预测模型,使系统能够在无人预设目标的情况下,自主猜想、筛选高价值定理并自我扩建形式化数学知识库。

NYU 联合 DeepMind 开源数学自主发现系统:首创内在趣味性量化指标,脱离人工预设自拓定理库

核心要点速览

  • 首次提出大模型自主数学探索的“内在趣味性(Intrinsic Interestingness)”客观数学量化度量指标。
  • 实证证明定理的内在趣味性与下游数学工具箱的应用效用(Extrinsic Utility)呈现强正相关。
  • 训练了专用的 27B 证明难度预测模型,难度判定准确率全面超越 GPT-4o 等通用闭源旗舰基座。
  • 将系统生成的定理与现有庞大数学库 Mathlib 的重合率从 91.9% 骤降至 30.6%,成功拓展出 69.4% 的全新数学分布。
  • 论文预印本、形式化评测套件与自拓定理库生成脚本已在 ArXiv 与 Hugging Face 全面开放。
阅读全文
关联模型 / 智能体 / 厂商:

DHH:阿里云成 Omacom 创始企业赞助商,投 300 万美元并将 Omarchy 带上 Qwen Book

DHH(@dhh)宣布阿里云成为 Omacom Foundation 创始企业赞助商:提供 300 万美元资金、合作推进 Omarchy China,并将 Omarchy 带到新发布的 Qwen Book。他强调智能体电脑需要原生的智能体操作系统。详情见 omarchy.org 新闻稿。

DHH:阿里云成 Omacom 创始企业赞助商,投 300 万美元并将 Omarchy 带上 Qwen Book

核心要点速览

  • 阿里云投入 300 万美元,成为 Omacom Foundation 创始企业赞助商。
  • 合作推进 Omarchy China,并将 Omarchy 带到新发布的 Qwen Book 硬件。
  • 定位:智能体电脑需要原生 agentic OS(Omarchy)。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Alibaba Qwen 3.8 Flash🌐 alibaba🌐 Qwen (通义千问)

Anthropic 启动 Model Hardware Standard 研究预览:让 AI 代理安全操作实验与制造设备

Anthropic 启动 Model Hardware Standard(MHS)研究预览第一阶段,为 AI 代理安全操作科研与先进制造设备定义标准接口。官方称 MHS 目前最覆盖实验室与制造装备;许多开发者已用 Claude Code 操作开发板和相机,预览旨在把这类设备纳入同一安全界面。该标准把编码代理从仓库推进到物理产线与实验台,是 Agent 从软件工具走向具身操作的关键基础设施。

核心要点速览

  • 编码代理正从软件仓库走进实验室与产线,标准化硬件接口是下一层基础设施。
  • Claude Code 已被用于操作开发板和相机;MHS 要把这些设备收进统一安全界面。
  • 预览第一阶段聚焦科研与先进制造设备的可发现、可安全操控接入。
阅读全文

Cursor 正式上线自研 Git 代码托管平台 Origin:深度融合编辑器与云端 Agent

Cursor 正式推出自研 Git 代码托管平台 Origin,实现代码编写、分支管理与云端 Agent 调度的端到端打通。支持一键同步现有 GitHub 仓库,首日打通 Vercel、Buildkite 与 Depot 的 CI/CD 自动化交付。

核心要点速览

  • Cursor 从 AI 编程编辑器正式进军代码托管基础设施层,提供极速轻量体验;
  • 支持无缝双向同步已有 GitHub 仓库,降低开发团队的迁移与试用门槛;
  • 打通 Vercel、Buildkite 与 Depot 等主流 CI/CD 管道,实现从代码生成到生产部署秒级闭环。
阅读全文
关联模型 / 智能体 / 厂商:

StackBlitz Bolt.new 上线 Prompt Queue:支持构建中持续投喂任务与多人协作排队

StackBlitz 旗下 Bolt.new 推出 Prompt Queue(提示词队列)功能。开发者无需等待当前应用构建完成即可连续发送下一条修改指令,队列将自动按序执行。该队列支持多人实时共享与协同编辑,团队成员可共同编辑需求队列,并同步内置了一键自动安全审计与加固代理。

核心要点速览

  • 生成式原型构建从“单轮等待”转变为“持续流式投喂”,大幅减少开发者等待空窗。
  • 支持多人实时协同队列,团队成员可共同排队任务并实时查看应用差异。
  • 同步上线一键安全审计代理,由智能体全库扫描漏洞并自动发布加固版本。
阅读全文
关联模型 / 智能体 / 厂商: