AI 编程实时动态与要闻

AWS 发布 TorchNeuron:PyTorch 原生跑在 Trainium 上,10 月 20 日以 Apache 2.0 开源

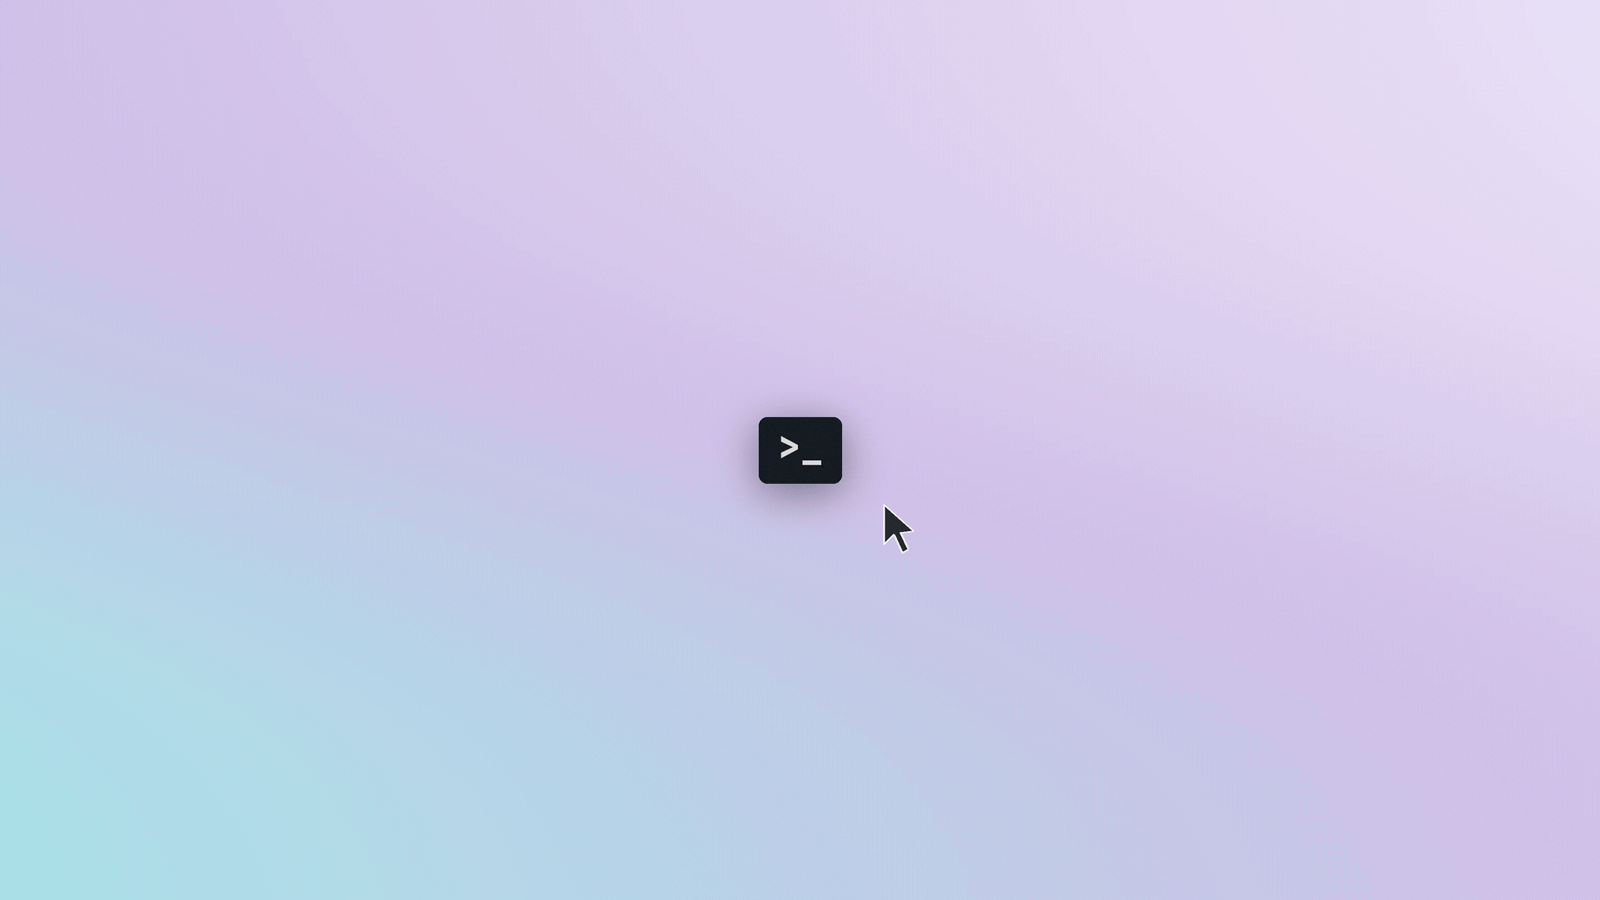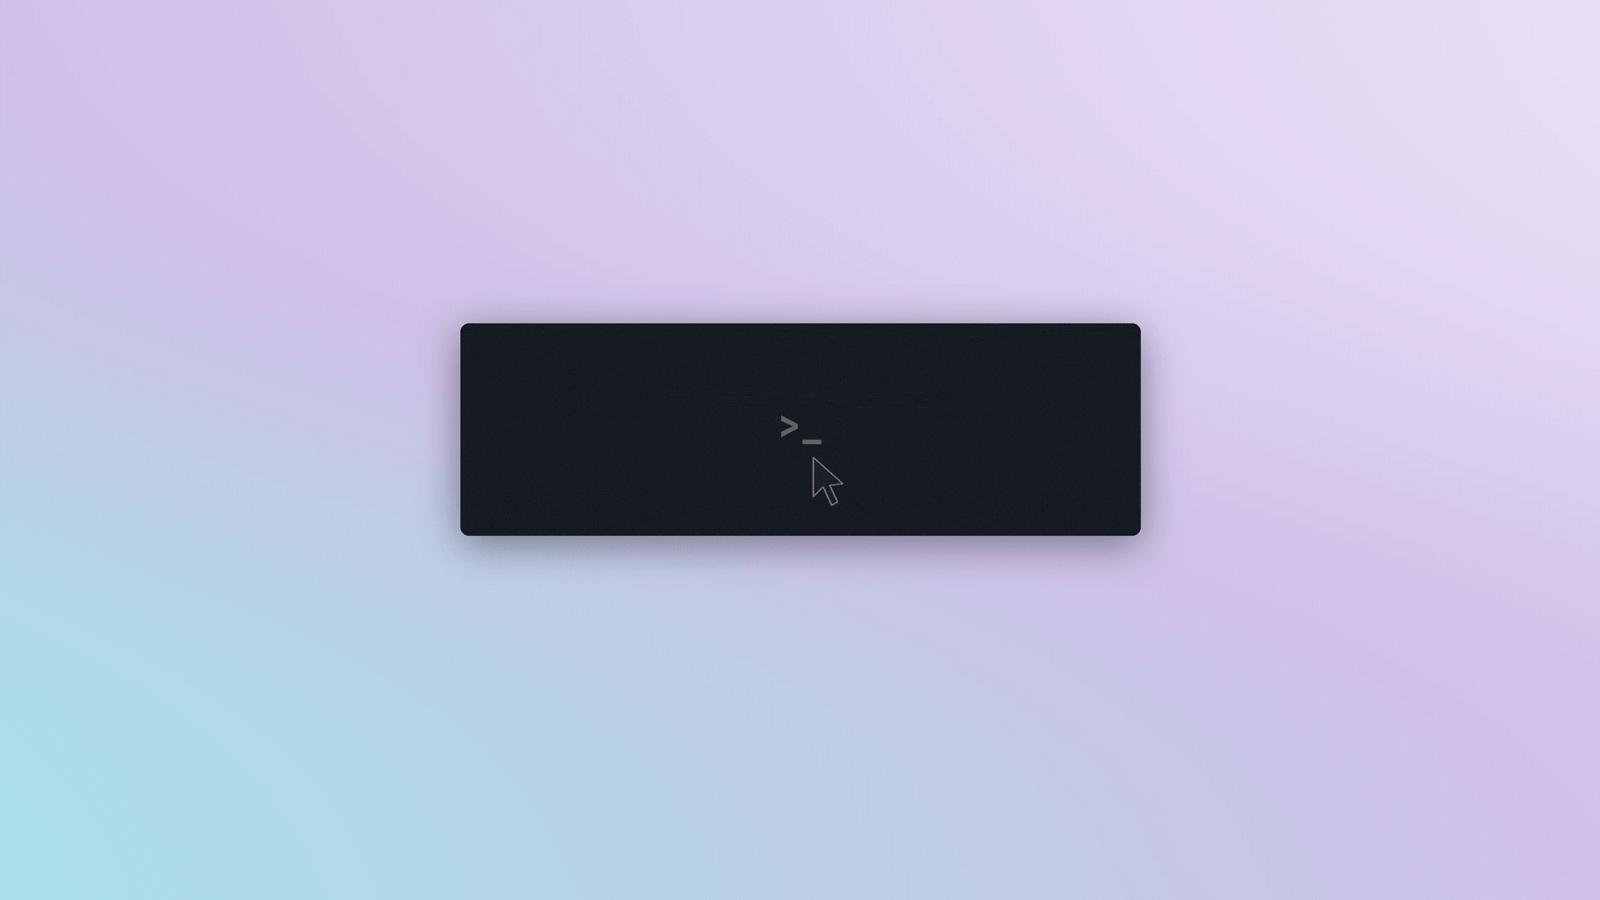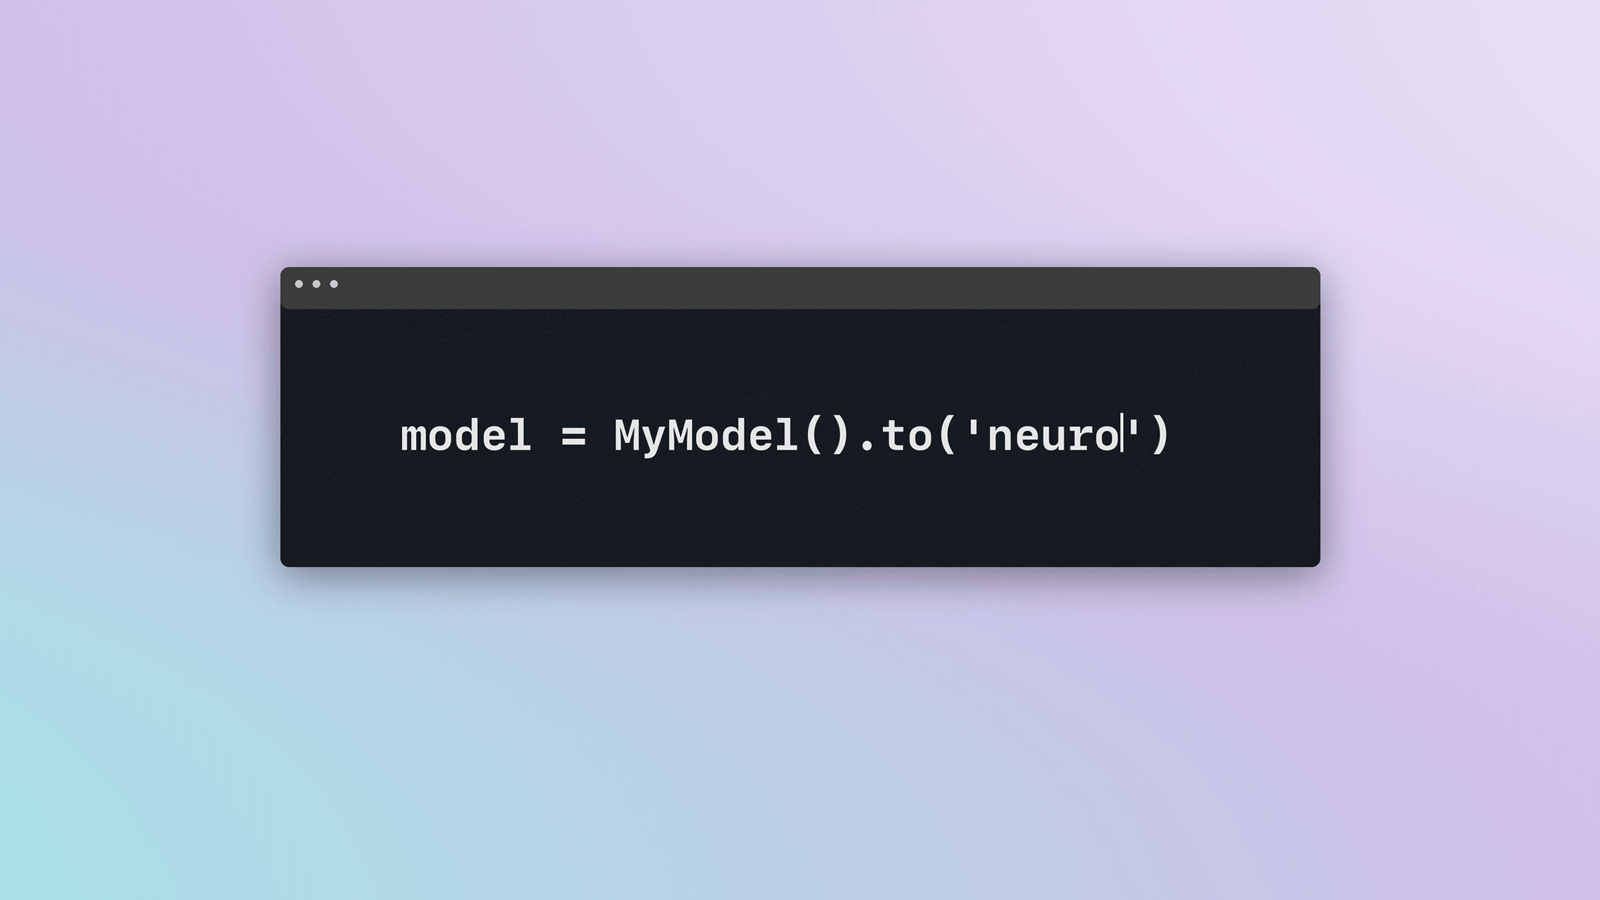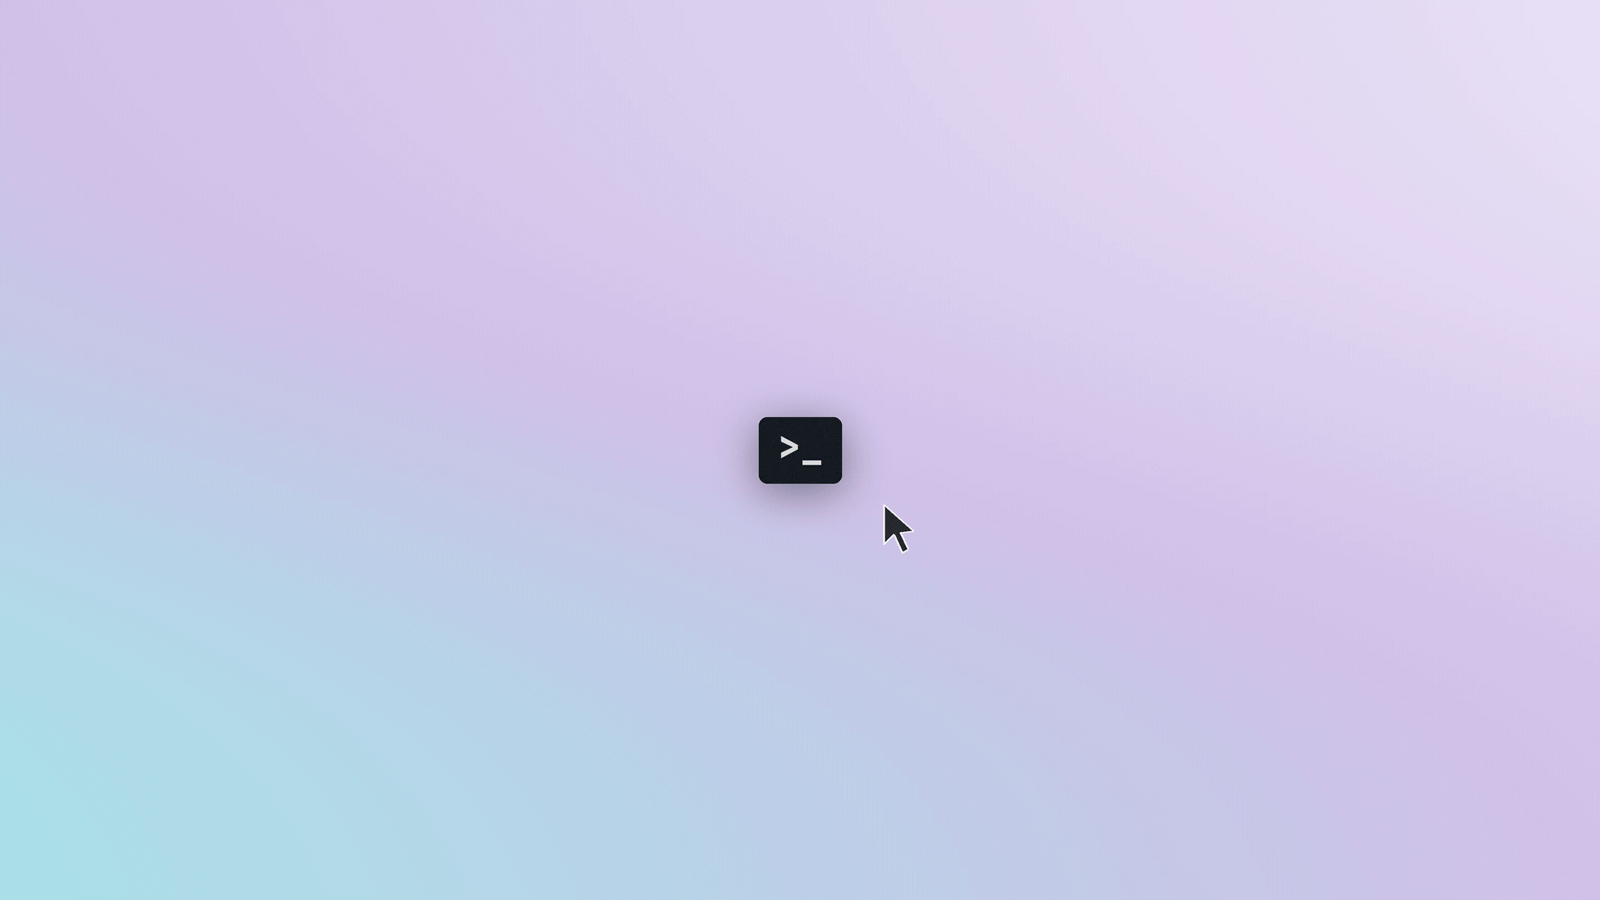
Amazon 10 月 19 日宣布 TorchNeuron:通过 PyTorch 标准的 PrivateUse1 设备后端机制,把 Trainium 注册成原生 "neuron" 设备,支持 eager 模式、torch.compile 和 FSDP/DTensor/DDP 等原生分布式 API,覆盖 Trn2 与 Trn3。官方称现有 PyTorch 代码只需改一处设备配置即可运行,将于 10 月 20 日在 PyTorch Conference North America 以 Apache 2.0 开源。官方文档显示,目前它仍处于封闭 Beta。
AWS 发布 TorchNeuron:PyTorch 原生跑在 Trainium 上,10 月 20 日以 Apache 2.0 开源

核心要点速览

  • 开源时间:10 月 20 日 PyTorch Conference North America,许可证 Apache 2.0(官方口径)。
  • 支持硬件:Trainium2、Trainium3;通过 PrivateUse1 注册为 neuron 设备,支持 eager 与 torch.compile(backend="neuron")。
  • 迁移改动:官方宣传「一处配置、无需重写」;文档列出的最小改动是 .to("cuda") 改 .to("neuron"),张量并行还要按 NeuronCore 数量调整分片配置。
  • PyTorch 2.9 是最后一个基于 PyTorch/XLA 的版本,从 PyTorch 2.10 起 Neuron 改走 TorchNeuron,老脚本升级时需要修改。
  • 质量与生态:官方称每次构建都对数十万个模型做回归测试,已接入 TorchTitan,Hugging Face 工具链已原生支持 Trainium;官方未公布性能跑分。
阅读全文
关联模型 / 智能体 / 厂商:

Ai2 发布 Olmo-core 3:开源万亿级 MoE 训练栈;B300 上 1.2T 达 858 TFLOP/s/GPU

Allen Institute for AI 于 2026-10-01 发布 Olmo-core 3:面向大规模 MoE 的开源训练框架(GitHub、PyPI ai2-olmo-core)。相对旧 FSDP 路径改走 DDP + Expert Parallelism;8×B300 上 47B MoE 吞吐约 2.7×(52k vs 19.4k tok/s/GPU);系统基准含 1.2T(512 GPU,最高 858 useful-model TFLOP/s/GPU)与 DeepEP v2 短测 2.38T。技术报告见 allenai.org/papers/olmocore3。

Ai2 发布 Olmo-core 3:开源万亿级 MoE 训练栈;B300 上 1.2T 达 858 TFLOP/s/GPU

核心要点速览

  • 公告日 2026-10-01:Ai2 官博 + HF 镜像 + 代码 allenai/OLMo-core
  • 并行:Expert / Pipeline / 分布式优化器;rowwise EP(NVSHMEM)+ GPU-resident routing + grouped GEMM;可选 DeepEP v2
  • 吞吐锚点(官博):专家池 8→128、active≈3.2B 时吞吐跌幅 <5%;8×B300 上 47B MoE 52k vs 旧栈 19.4k tok/s/GPU(约 2.7×)
  • 规模:1.2T / 58.36B active / 512 GPU,最高 858 TFLOP/s/GPU(随机路由系统基准);DeepEP v2 短测达 2.38T
  • 精度与内存:MXFP8 相对 BF16 吞吐约 +21%、峰值活跃内存 103→95 GiB;拓扑无关 checkpoint;下一代 Olmo 将用 MoE
阅读全文
关联模型 / 智能体 / 厂商:
⚡ olmo⚡ olmoe⚡ Olmo Core 3🌐 allenai🌐 ai2🌐 Nvidia (NIM)

Hugging Face TRL 1.14.0:DPO/KTO/GRPO 改走分块 log-prob,修 DDP 梯度未 all-reduce;H100 上峰值显存可降 31%

Hugging Face 于 2026-09-25 发布 TRL v1.14.0:移除 trl.losses 中 Liger 风格 fused loss 复写,DPO/KTO/GRPO 统一走 _ChunkedLogProbFunction 再进各自原有 loss,避免公式漂移与 plain DDP 下梯度未 all-reduce;内置 Triton logprob+entropy 融合核(相对 selective_log_softmax+entropy_from_logits 约 14×);单 H100、Qwen3-0.6B、bs=4、seq 512 上,chunked+precompute_ref_log_probs 中位 step 0.1971s(相对 v1.13 fused 降 12.1%)、峰值 4.83GB(降 31%)。并删除 6 个低使用 experimental trainer,vLLM 支持窗升至 ≤0.30.0。

Hugging Face TRL 1.14.0:DPO/KTO/GRPO 改走分块 log-prob,修 DDP 梯度未 all-reduce;H100 上峰值显存可降 31%

核心要点速览

  • 发版:v1.14.0 = PyPI trl 1.14.0,文档 huggingface.co/docs/trl
  • 架构:删除 trl.losses(含 FusedLinearDPOLoss 等);DPO/KTO/GRPO = backbone → _ChunkedLogProbFunction → 各自原 loss;use_liger_kernel=True 仍启 Liger 模型核,但 loss 改走 TRL chunked path
  • 性能(官方表,1×H100 / Qwen3-0.6B / bs=4 / seq512):v1.13 fused 0.2243s / 7.05GB → v1.14 chunked+precompute_ref_log_probs=True 0.1971s(−12.1%)/ 4.83GB(−31%)
  • 内核:trl.kernels 融合 logprob+entropy,H100 bf16 V=151936 H=4096 8192 tokens:0.89ms vs 12.8ms(约 14×),默认 CUDA/ROCm/XPU 开启
  • 破坏:移除 BCO/PRM/XPO/NashMD/GRPOWithReplayBuffer/GSPO-token 等 6 个 experimental trainer;修 plain DDP 下 KTO 梯度未 all-reduce;vLLM 支持窗 >=0.20.0,<=0.30.0
阅读全文
关联模型 / 智能体 / 厂商: