
AI 编程实时动态与要闻

vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

紧随 DeepSeek-V4.1-Flash-1017 开源发布,vLLM 官宣 Day-0 深度适配,在 SemiAnalysis AgentX 评测中创下每美元 TCO 产出 13 亿 Token、单 GPU 吞吐高达 830K tok/s(保障单用户 100 tok/s 交互速率)的纪录,较初代提速 5 倍;OpenRouter 亦同步上线,第三方供应商最低仅需 $0.10/M 输入与 $0.50/M 输出。
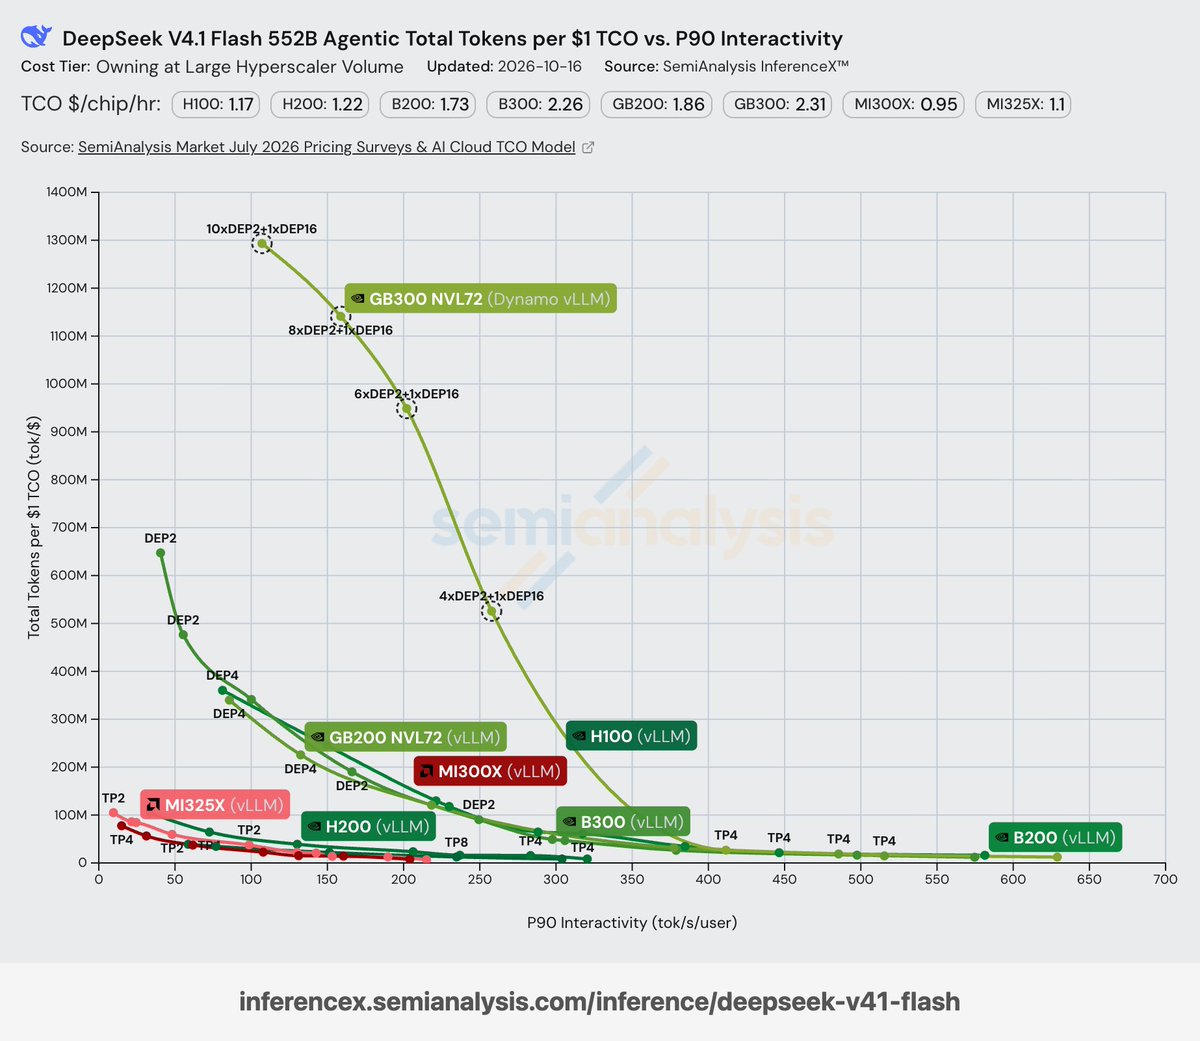
vLLM 与 OpenRouter 同步上线 DeepSeek-V4.1-Flash-1017 Day-0 极速推理:AgentX 单卡吞吐飙至 830K tok/s,每美元狂吞 13 亿 Token

核心要点速览

  • vLLM 在 SemiAnalysis AgentX 基准上为 DeepSeek-V4.1-Flash-1017 实现单 GPU 830K tok/s 吞吐(保障单用户 100 tok/s 速率),每美元 TCO 产出高达 13 亿 Token,较初代提速 5 倍
  • 模型在 DeepSWE v1.1 上斩获 77.0%(超越 Claude Opus 5 的 74.0%),NL2Repo-Bench 达 68.2%,Apex Bench 达 72.1%,且输出更加精炼
  • OpenRouter 同步上线 deepseek/deepseek-v4.1-flash-1017,最低仅 $0.10/M 输入与 $0.50/M 输出;官方 API(deepseek-flash)维持 $0.15/$0.60 不变
阅读全文
关联模型 / 智能体 / 厂商:

LM Studio 首日接入 Inco Splash:M5 Max 上 Qwen3.8-27B 约 144 tok/s

LM Studio 宣布与 Inco 合作,在发布首日就把 Splash 推理引擎接入 LM Studio。官方称在 M5 Max 上运行 Qwen3.8-27B 可达约 144 tok/s,并给出安装指引(lmstudio.ai/blog/splash-engine)。此前 Inco 已开源 Splash;此次意味着本地桌面用户可在 LM Studio 内直接用上该 Apple 硅优化引擎,而不必单独拼装推理栈。

核心要点速览

  • LM Studio 首日接入 Inco Splash 推理引擎,面向本地桌面一键可用。
  • 宣称 M5 Max 上 Qwen3.8-27B 约 144 tok/s,并给出官方安装博文。
  • 把 Apple 硅优化推理从独立引擎推进到主流本地客户端分发通道。
阅读全文
关联模型 / 智能体 / 厂商:

Inco 开源 Splash:M5 Max 上 Qwen3.8-27B 达约 144 tok/s,专为 Apple 硅优化

Inco AI 发布开源本地推理引擎 Splash,面向 Apple 硅与 Qwen3.8-27B 等型号优化。官方称在 M5 Max MacBook Pro 上可达约 144 tok/s,解码速度约为 Ollama 的 3 倍、oMLX 的 2 倍,智能体扇出子代理时接近 4 倍;LM Studio 已在 Day 0 接入并可在 Settings > Runtime > Experimental backends 启用。

核心要点速览

  • 开源 Splash:专为 Apple 硅与 Qwen3.8-27B 优化的本地推理引擎。
  • 官方演示:M5 Max 上约 144 tok/s;相对 Ollama/oMLX 可达约 3×/2×,子代理扇出时接近 4×。
  • LM Studio Day 0 接入;引擎仓库 github.com/incoai/splash,说明见 lmstudio.ai/blog/splash-engine。
阅读全文