
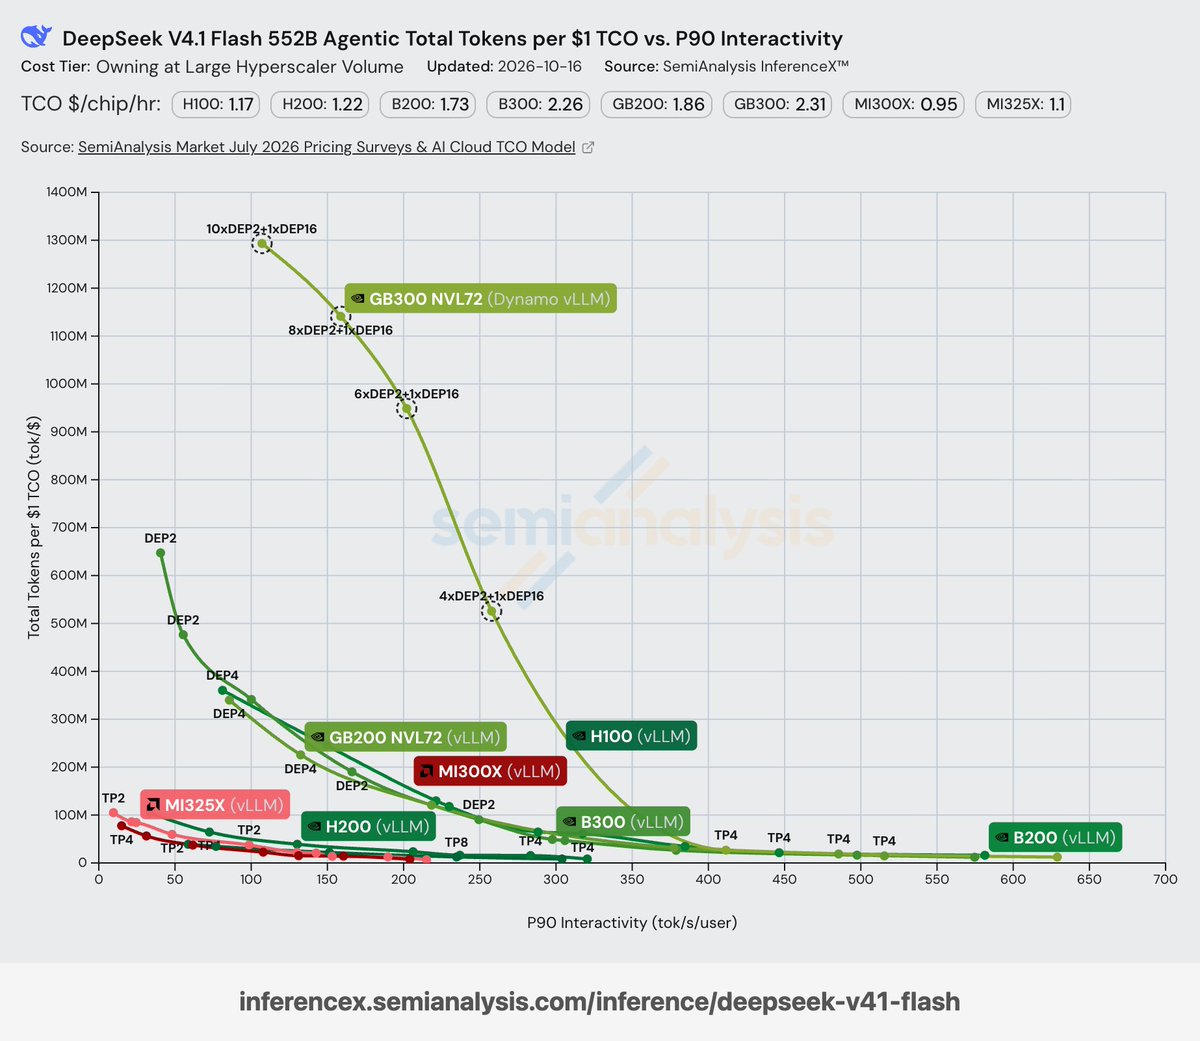
紧随 DeepSeek-V4.1-Flash-1017 开源发布,vLLM 官宣 Day-0 深度适配,在 SemiAnalysis AgentX 评测中创下每美元 TCO 产出 13 亿 Token、单 GPU 吞吐高达 830K tok/s(保障单用户 100 tok/s 交互速率)的纪录,较初代提速 5 倍;OpenRouter 亦同步上线,第三方供应商最低仅需 $0.10/M 输入与 $0.50/M 输出。
核心要点速览
- ✓vLLM 在 SemiAnalysis AgentX 基准上为 DeepSeek-V4.1-Flash-1017 实现单 GPU 830K tok/s 吞吐(保障单用户 100 tok/s 速率),每美元 TCO 产出高达 13 亿 Token,较初代提速 5 倍
- ✓模型在 DeepSWE v1.1 上斩获 77.0%(超越 Claude Opus 5 的 74.0%),NL2Repo-Bench 达 68.2%,Apex Bench 达 72.1%,且输出更加精炼
- ✓OpenRouter 同步上线 deepseek/deepseek-v4.1-flash-1017,最低仅 $0.10/M 输入与 $0.50/M 输出;官方 API(deepseek-flash)维持 $0.15/$0.60 不变
本地显存不够?先比较云端 API 与自部署的实际成本
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
在长程代码智能体(Coding Agent)与自动化工作流(如 DeepSeek Harness、Tencent CodeBuddy 及 Claude Code)的生产落地中,单次任务往往伴随数十至上百轮的“工具调用—环境反馈—上下文追加”循环。尽管 DeepSeek-V4.1-Flash-1017 在模型侧通过强化学习大幅缩短了冗余思维链输出并提升了工具调用准确率,但在高并发 Agent 循环中,推理引擎仍面临三大核心痛点:一是超长共享前缀(高达 1M 上下文)与高频增量解码交织导致的注意力算子带宽瓶颈;二是混合专家(MoE)架构在大批量并发下的跨卡通信延迟;三是如何在保障单用户 100 tok/s 丝滑交互体验的前提下,将百万 Token 的总拥有成本(TCO)压缩至极致。
架构亮点与底层机制
针对 DeepSeek-V4.1-Flash-1017 的非对称混合专家(MoE)与高压缩 KV 缓存架构,vLLM 社区与官方团队在 Day-0 完成了全链路推理内核与调度器协同优化,并由 OpenRouter 实现全球多供应商即时路由:
- 面向长程 Agent 循环的 FlashMLA 与前缀缓存协同:
vLLM深度整合针对 V4.1-Flash 定制的FlashMLA算子与零开销异步块级前缀缓存(Automatic Prefix Caching),将多轮工具调用中的缓存命中页(Cached Tokens)、增量输入(Input Tokens)与解码输出(Output Tokens)统一纳入高吞吐流水线调度,彻底消除多轮回放的重复预填充开销。 - 输出 Token 精简与计算-通信全重叠:受益于
DeepSeek-V4.1-Flash-1017模型本身更紧凑的推理轨迹(Shorter Outputs)以及vLLM底层的双微批次(Dual-Microbatch)All-to-All 通信掩盖机制,单步 Agent 决策的端到端延迟显著下降,使得自 Day-0 初代版本以来的 Agentic 総合吞吐量实现了 5 倍(5x) 跃升。 - OpenRouter 零门槛多供应商生态与 API 无缝替换:
OpenRouter第一时间上线deepseek/deepseek-v4.1-flash-1017专属路由节点,同时 DeepSeek 官方 API 保持deepseek-flash模型别名与既有定价不变,并同步开放索引规模达数千亿网页、原生过滤 SEO 垃圾信息的自研Search与Fetch接口。
权威 Benchmark 与实测跑分对比
根据 vLLM 发布的 SemiAnalysis AgentX 权威基准实测及 DeepSeek-V4.1-Flash-1017 官方评测数据:
- SemiAnalysis AgentX 推理吞吐与 TCO 纪录:在严格限制单用户输出速率不低于 100 tok/s 的生产级 SLA 下,
vLLM驱动的DeepSeek-V4.1-Flash-1017实现了单卡 830K tok/s(含缓存命中 + 新增输入 + 解码输出)的惊人吞吐,每美元总拥有成本(TCO)可产出高达 13 亿(1.3B)Token,较初代发布时的 Agent 吞吐提升 5 倍。 - 核心编码与智能体评测跃升:在官方基准中,
DeepSeek-V4.1-Flash-1017在 DeepSWE v1.1 上斩获 77.0%(超越Claude Opus 5的74.0%),在 Terminal-Bench 4.0 取得 42.3%,NL2Repo-Bench 达 68.2%,Automation-Bench 达 60.5%,Apex Bench 达 72.1%,无工具 HLE(纯文本子集) 达 44.0%(全集 42.6%)。 - 极致性价比定价:在
OpenRouter平台上,第三方算力供应商最低报价下探至 $0.10 / 百万输入 Token 与 $0.50 / 百万输出 Token;DeepSeek 官方端点则维持 $0.15 / 百万输入 与 $0.60 / 百万输出 的亲民价格。
开发者实战落地与开箱指南
对于自建推理集群的团队,建议拉取最新 vLLM 镜像并从 Hugging Face 下载 MIT 协议开源权重 deepseek-ai/DeepSeek-V4.1-Flash-1017,开启前缀缓存(--enable-prefix-caching)与 FlashMLA 后端以复现 830K tok/s 级 Agent 吞吐。对于直接调用云端 API 的开发者,可在 DeepSeek Harness v0.2.1-rc.1+、Tencent CodeBuddy 或任意兼容 OpenAI SDK 的客户端中,将模型名设为 deepseek-flash(官方端点)或 deepseek/deepseek-v4.1-flash-1017(OpenRouter),零代码改动即可享受更高跑分与更短响应耗时。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察