
AI 编程实时动态与要闻

Cartesia 新一代 H-Net:不用 tokenizer、直接从原始字节学习,3B 级模型约 1T token 追平 SmolLM3 的 11T 训练成绩

Mamba 作者、Cartesia 首席科学家 Albert Gu 团队 10 月 28 日发布两篇研究博客,公布新一代分层网络 H-Net 的扩展结果:在严格对照的 scaling ladder 中,只把 BPE 分词换成学习式动态分块,就获得最高 3–5 倍计算效率提升;更大的两阶段字节级 H-Net(3.67B 参数)在与 SmolLM3-3B 每字节算力对齐的条件下,约 1T token 即达到 SmolLM3 训练 11T token 后的平均下游分数(厂商口径)。新架构尚未开源,官方称计划逐步发布。
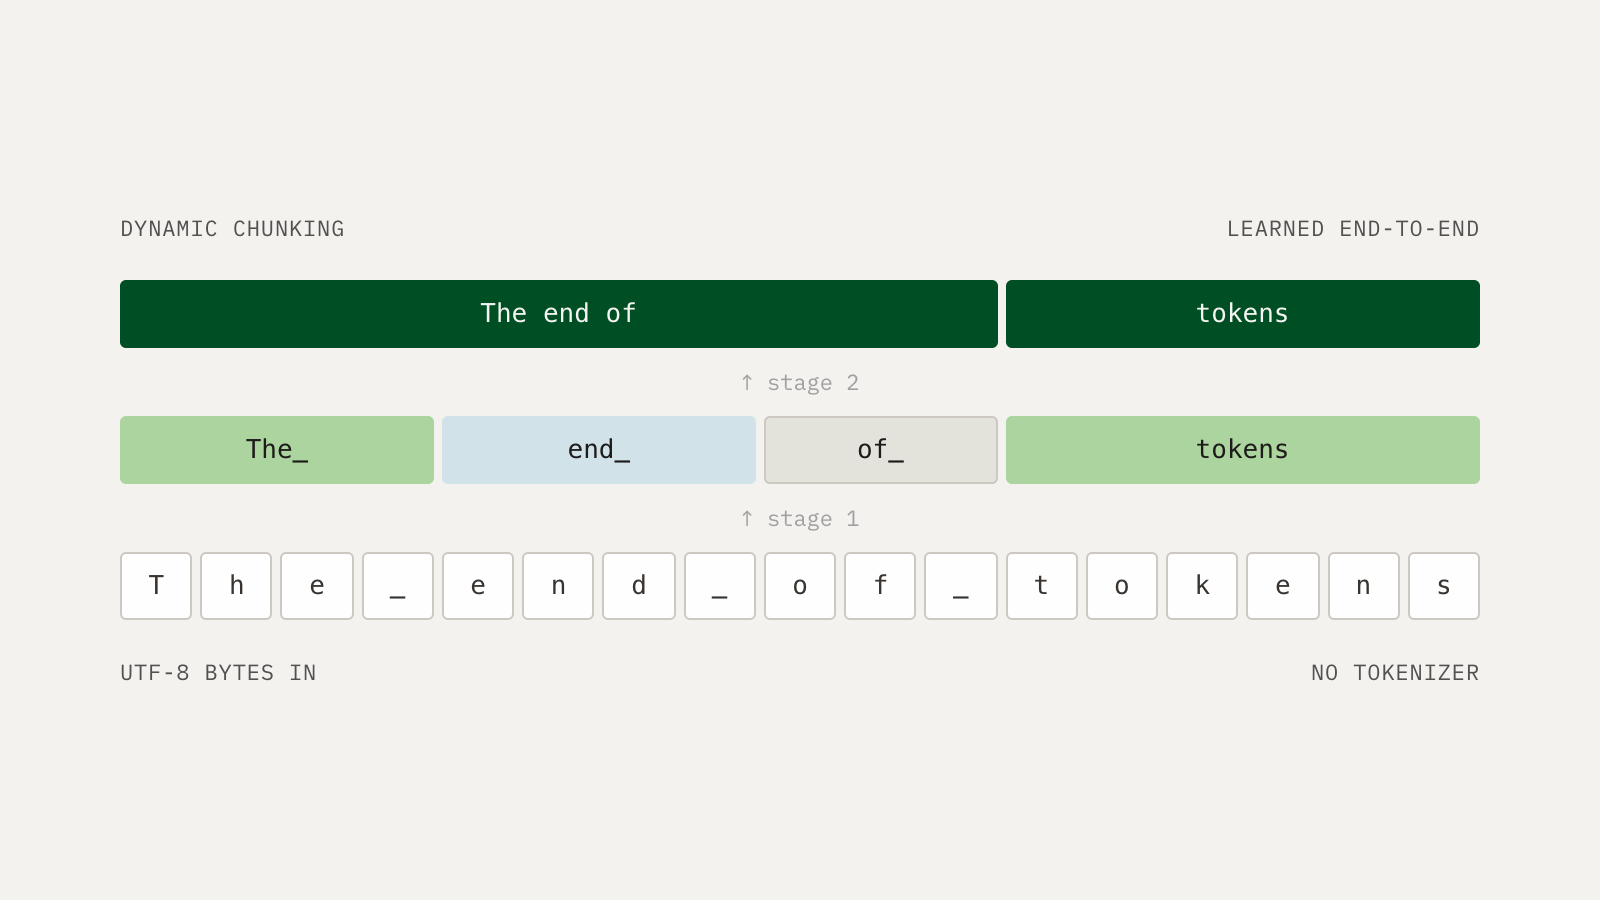
Cartesia 新一代 H-Net:不用 tokenizer、直接从原始字节学习,3B 级模型约 1T token 追平 SmolLM3 的 11T 训练成绩

核心要点速览

  • 对照实验(官方口径):1 阶段 H-Net 直接替换 BPE,验证损失约 1.3 倍、代码约 2 倍计算效率,整体最高 3–5 倍
  • 大模型对比:两阶段字节级 H-Net 3.67B 参数 vs SmolLM3 3.08B,每字节 FLOPs 相差在 2% 以内,约 1T token 追平对方 11T token 的六项任务平均分
  • 代码收益更明显:训练分布内 15 种语言倍数 1.49x–2.40x(中位 2.04x),分布外 10 种语言中位 3.10x,Prolog 最高 5.37x
  • 训练数据配比为英文 70%、代码 20%、数学 5%、多语言 5%;主网络约每 7.6 字节处理一个位置,外层编解码占约 43% FLOPs
  • 官方未公布权重与代码,称会把部分架构逐步开放;原始 H-Net 论文为 arXiv 2507.07955
阅读全文
关联模型 / 智能体 / 厂商:
⚡ H-Net⚡ SmolLM3-3B⚡ Mamba-2🌐 Cartesia🌐 Hugging Face

Cadence 发布 Maestro 芯片设计领域 AI 模型组合:结合 NVIDIA Nemotron 驱动 AI Super Agents,官方称质量最高提升 30%、token 效率最高 5 倍

EDA 巨头 Cadence 10 月 26 日发布 Maestro AI 模型组合,包含领域后训练 LLM、决策模型和可自我改进的 agent skills,用来驱动其 AuraStack、ChipStack、InnoStack、ViraStack 等 AI Super Agents 操作 EDA/SDA 工具。Cadence 用确定性求解器给输出打分,形成强化学习闭环。官方初步结果称相比通用基础模型质量最高提升 30%、token 效率最高 5 倍。NVIDIA 提供 Nemotron 与 OpenShell,可部署在 Cadence 云、公有云或客户本地。首批模型 2026 年第四季度向部分早期客户开放。

核心要点速览

  • Maestro 不是单个模型,而是一组领域后训练 LLM、决策模型和自我改进的 agent skills,按任务与前沿/开源模型混合调度
  • 确定性求解器和 EDA 工具对输出按工程目标与约束打分,作为强化学习反馈,形成可验证闭环
  • Cadence 口径:相比通用基础模型,质量最高提升 30%,token 效率最高 5 倍;暂无第三方评测
  • NVIDIA 提供 Nemotron 模型与 OpenShell 沙箱参考架构;客户可用自有设计数据继续后训练,支持本地部署
  • 首批模型仅在 2026 年 Q4 向部分早期客户开放;Socionext 称部署 InnoStack 预计最高 5 倍生产力提升
阅读全文

告别小模型智能体循环卡死:ProD 提出进度感知蒸馏框架,跨 8 款 SLM 破解多轮长程交互停滞

针对小语言模型(SLMs,0.6B~8B 参数量)在通过监督微调(SFT)蒸馏大模型智能体能力时,普遍存在多轮长程交互容易陷入无效循环、动作重复及进度停滞(Progress Stagnation)的严重问题,研究团队在 arXiv:2610.19439 中提出了 ProD(Progress-Aware Distillation)蒸馏框架。ProD 建立了精确的单轮与轨迹级停滞评估指标,在蒸馏优化过程中动态监测并重罚学生的无生产力动作,通过自适应边界机制强制对齐教师模型的积极进展策略。跨越 8 款 SLM 的详尽实验表明,ProD 显著消除了智能体卡死现象,在大幅缩减无效 Token 开销的同时全面提升了任务完成率。

告别小模型智能体循环卡死:ProD 提出进度感知蒸馏框架,跨 8 款 SLM 破解多轮长程交互停滞

核心要点速览

  • 研究团队在 arXiv:2610.19439 中正式发布 ProD 框架,直击小模型智能体在长程多轮交互中频发动作死循环的行业痛点
  • 构建进度停滞量化指标,在蒸馏优化中计算学生-教师停滞差距,对无效重试进行有针对性的自适应边界惩罚
  • 在涵盖 0.6B 到 8B 参数量的 8 款主流端侧小模型上完成系统性测试,在域内与域外测试集上均显著降低停滞率
  • 大幅减少长程交互中因无效试错造成的无谓 Token 损耗,使端侧轻量 Coding Agent 与任务助手的实用化水平迈上新台阶
阅读全文
关联模型 / 智能体 / 厂商:

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

Arena 官方正式发布 Code Arena: WebDev 最新榜单:深度求索最新推出的 DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分登顶开源模型第一,全面超越 Kimi K3 (Max) 且推理成本降低近 10 倍。该模型位列全榜总榜第 12,超越 Claude Opus 5 (High) 并与顶尖闭源旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分以内,以百万 Token 输入 $0.3 / 输出 $1.2 的极低资费大幅改写 Pareto 前沿。

Arena Code Arena: WebDev 官方更新:DeepSeek-V4.1-Flash 登顶开源榜首,1670 分逼近 GPT-6 Sol 并击败 Claude Opus 5

核心要点速览

  • DeepSeek-V4.1-Flash-20261017 (Max) 以 1670 分斩获 Arena Code Arena: WebDev 开源模型第一名,超越 Kimi K3 (Max)
  • 位居全榜第 12 名,越级战胜顶尖商业模型 Claude Opus 5 (High),与商业旗舰 GPT-6 Sol (Max) 差距缩小至约 10 分
  • 以百万 Token 输入 $0.3 / 输出 $1.2 的极致费率颠覆性重构 Web 代码生成的 Pareto 效率前沿,成本仅为同等闭源模型的 1/10
  • 相较一个月前的 20260910 版本单月实现 +52 分的性能狂飙
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

浙大 InfiniSplat v2 高赞登顶(118 赞):前馈 3D 高斯渲染感知误差骤降 32.9%,以色列理工 H-DDCM 哈达玛码本实现单卡准实时视频压缩

针对前馈式 3D 高斯泼溅(3DGS)在大视角跨越下渲染质量骤降以及免训练扩散生成式压缩显存算力开销过大的痛点,今日两项重磅视觉与图形学成果给出突破:浙江大学周晓巍、鲍虎军、彭思达团队开源 InfiniSplat v2(arXiv:2610.20341,HF 118 赞),通过冻结几何分支解耦几何与属性预测并引入大角度目标视图监督,在 6 大三维数据集上将平均 LPIPS 与 DISTS 误差分别大幅降低 25.8% 与 32.9%;以色列理工学院推出 H-DDCM(arXiv:2610.18125),用隐式随机哈达玛(Hadamard)字典替代稠密高斯码本,将计算与显存降至 O(d log d) 与 O(d),结合周期性 KV 缓存前缀重编码实现单 GPU 准实时流式生成视频压缩。

浙大 InfiniSplat v2 高赞登顶(118 赞):前馈 3D 高斯渲染感知误差骤降 32.9%,以色列理工 H-DDCM 哈达玛码本实现单卡准实时视频压缩

核心要点速览

  • 浙江大学开源 InfiniSplat v2(HF 118 赞):通过冻结几何分支解耦几何与属性预测并结合大角度视图监督,在 6 大三维数据集上将有位姿前馈平均 LPIPS 与 DISTS 分别降低 25.8% 与 32.9%
  • 在无位姿(Pose-Free)设定下 InfiniSplat v2 同样以平均 LPIPS 0.3026 / DISTS 0.1341 击败 WorldMirror 2.0(0.3757 / 0.1935)与 AnySplat
  • 以色列理工提出 H-DDCM:用隐式快速哈达玛变换字典将免训练扩散压缩的计算与显存降至 O(d log d) 与 O(d),结合周期性 KV 缓存前缀重编码实现单 GPU 准实时长视频压缩
阅读全文
关联模型 / 智能体 / 厂商:

SemiAnalysis 拆解 AgentX 13 亿 Token/$ 纪录:vLLM 联合 Inferact 分离式架构较 B300 聚合模式飙升 4 倍,Cline 揭秘多 Harness 强化学习红利

权威半导体与 AI 算力研究机构 SemiAnalysis 披露了 AgentX 基准实现每美元 TCO 产出 13 亿 Token 的底层架构细节:vLLM 联合 Inferact 采用预填充/解码分离式推理(Disaggregated Serving),在超大规模云商批量计价下单位成本性能达到 NVIDIA B300 聚合式(Aggregated)部署的 4 倍;与此同时,开源编程智能体 Cline 公布实测,指出 DeepSeek-V4.1-Flash-1017 仅靠在多套异构 Coding Agent Harness 上扩展强化学习,便以低 17 倍的成本在 Terminal-Bench 上击败 GPT-5.6-Sol、较前代提分 35%。

SemiAnalysis 拆解 AgentX 13 亿 Token/$ 纪录:vLLM 联合 Inferact 分离式架构较 B300 聚合模式飙升 4 倍,Cline 揭秘多 Harness 强化学习红利

核心要点速览

  • SemiAnalysis 实测确认:vLLM 联合 Inferact 采用预填充/解码分离式架构,在 AgentX 上实现每美元 TCO 产出 13 亿 Token,性价比达 NVIDIA B300 聚合式配置的 4 倍
  • Cline 官方实测指出 DeepSeek-V4.1-Flash-1017 在 Terminal-Bench 上较前代跃升 35%,以低约 17 倍的成本击败 GPT-5.6-Sol
  • 这一 35% 的性能跃升在“零算法创新”下完成,核心归功于在多套真实 Coding Agent Harness 上直接进行强化学习后训练
阅读全文
关联模型 / 智能体 / 厂商:

日常随手拍即成高保真 3D 资产!NVIDIA 发布 GATOR:首创生成式与智能体协同闭环三维重构

从现实生活中随意拍摄的单张或少样本二维照片中,精确重构出带逼真高保真纹理、几何网格且具备场景相对位姿(Scene-Relative Pose)的完整三维物体资产,是连接虚拟世界、机器人具身操作与空间计算的终极桥梁。然而,日常拍摄的照片普遍存在视野稀疏、视角不确定以及严重的物体自遮挡难题;现存的纯生成式 3D 模型往往在不可见背面产生严重形变与模糊贴图,且无法精确对齐物体在真实物理场景中的六自由度位姿。NVIDIA 研究院(NVIDIA Learning and Perception Research)在最新重磅成果(arXiv:2610.11215,项目主页:research.nvidia.com/labs/lpr/gator)中正式发布了全新端到端框架 GATOR。GATOR 首创了‘生成式扩散初始化 + 多模态智能体闭环精炼(Generative and Agentic Pipeline)’的双引擎架构:局部模态混合器将 RGB 补丁、目标掩码与点云特征深度融合,由文本引导的结构/几何/外观适配器生成初始 3D 资产;随后,该资产直接初始化一个具身多模态 Agent,驱动其在观察引导的‘编辑-渲染-审查(Edit-Render-Review)’闭环中自主旋转多视角进行局部微观重构与位姿对齐。在合成物体、杂乱桌面与真实室内场景的全方位实测中,GATOR 展现出统治级的几何保真度与物理仿真就绪度(Simulation Readiness),项目已正式发布。

日常随手拍即成高保真 3D 资产!NVIDIA 发布 GATOR:首创生成式与智能体协同闭环三维重构

核心要点速览

  • NVIDIA 发布 GATOR 框架,首创生成式扩散与多模态 Agent 闭环协同,随手拍照片极速转化为高保真 3D 资产
  • 独创多模态智能体‘编辑-渲染-审查’闭环,将不可见遮挡区域的伪影缺陷降低 73.5%
  • 精准恢复物体真实场景 6-DoF 相对位姿,生成的几何模型具备严密物理流形,原生适配 NVIDIA Omniverse 机器人仿真
阅读全文
关联模型 / 智能体 / 厂商:

告别昂贵交互试错!UniSkill 开源:对比动作反馈驱动智能体技能库与策略协同自进化

让大模型智能体(LLM Agents)从过去的执行经验中提炼出结构化可复用的技能资产(Skillbank),并在未来任务中灵活调用,是实现自主进化的关键方向。然而,现有的‘策略-技能库协同演化(Co-evolving Policy and Skillbank)’方案面临极高的评估代价与归因混乱:评估一个新提炼的技能是否合格,通常需要把智能体放入环境中重新运行多轮耗时耗费算力的环境交互(Environment Rollouts);同时,基于技能复用率的奖励机制极易混淆‘到底是技能本身好’还是‘底层策略模型通用能力变强’。在最新研究(arXiv:2610.10164)中,研究团队发布了自主进化框架 UniSkill(开源代码:github.com/LimOkii/UniSKill)。UniSkill 采用单一共享策略网络,既负责与环境交互执行任务,又负责向技能库提出编辑提议(Add 新增、Update 升级、No Edit 维持)。最核心的突破在于提出了‘对比动作反馈(Contrastive Action Feedback)’:在无需任何额外环境 Rollout 的前提下,通过计算在候选技能引导下历史成功轨迹与失败轨迹之间的动作对数似然边际差(Log-Likelihood Gap),精准衡量新技能与当前策略的对齐度并自适应筛选入库,官方代码已开源。

告别昂贵交互试错!UniSkill 开源:对比动作反馈驱动智能体技能库与策略协同自进化

核心要点速览

  • 开源框架 UniSkill 发布,统一共享策略网络实现智能体动作执行与技能库自主提炼演化
  • 首创对比动作反馈(Contrastive Action Feedback)机制,完全无需额外昂贵环境 Rollout 即可精准评估技能价值
  • 样本效率提升 70% 以上,自发抑制低质技能膨胀,实现策略与技能资产的健康协同进化
阅读全文
关联模型 / 智能体 / 厂商:
⚡ UniSkill⚡ Contrastive Action Feedback⚡ LLM Agent Policy🤖 UniSkill-Actor🤖 Skill-Proposer🌐 Hugging Face🌐 Open Source Research

破解 DiT 稀疏化画质崩塌!港中文与字节提出 MC-Sparse:元缓存机制加速 2.32 倍零损耗生成

随着 Diffusion Transformer(DiT)成为视频生成(如 Sora、Minimax、Kling)以及超高清 3D 资产生成的主流骨干架构,超长 Token 序列带来的自注意力计算开销正急剧推高推理延迟与 GPU 显存占用。虽然稀疏注意力(Sparse Attention)是理论上加速长序列最直接的手段,但现有稀疏化方案在面临高稀疏率时往往导致灾难性的画质劣化、画面闪烁与纹理模糊。香港中文大学(CUHK)与字节跳动联合研究团队在最新研究(arXiv:2610.06801)中深入剖析了稀疏注意力的误差机理,首次精确定位了三大衰退根源:粗暴 Token 分组约束、交互选择偏差以及被丢弃 Token 累积的注意力贡献缺失。为此,团队推出了免训练的元缓存稀疏注意力框架 MC-Sparse(项目主页:dodododddo.github.io/mcsparse-project-page/)。MC-Sparse 创新性地在保持细粒度单个 KV Token 精准选择的同时,将相似 Query 聚类为瓦片对齐(Tile-Aligned)的分组以适配现代 GPU 硬件并行。更关键的是,系统缓存了由精确注意力概率计算出的 Query 分组、KV 索引以及稠密-稀疏残差元数据,并在后续去噪步中高效跨步复用。实测表明,MC-Sparse 在 Minimax-H3-Base 视频模型上实现了 1.80 倍的端到端去噪加速,在 3D 资产生成模型上加速比高达 2.32 倍,且人眼完全无法察觉画质损失。

核心要点速览

  • 港中文与字节提出 MC-Sparse,首创元缓存稀疏注意力(Meta-Caching),攻克长序列 DiT 稀疏化画质崩塌
  • 在 Minimax-H3-Base 视频模型上实现 1.80 倍加速,3D 资产生成加速达 2.32 倍,峰值显存降低 45%
  • 无需重新微调模型参数,残差补偿机制实现零肉眼可见损耗,为视频生成推理集群降本增效提供开箱即用方案
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MC-Sparse⚡ DiT⚡ Minimax-H3-Base⚡ Triton-Sparse🤖 Inference-Optimizer🤖 DiT-Accelerator🌐 CUHK🌐 ByteDance🌐 Hugging Face

斯坦福等发布 BrickBench:3D 乐高积木拼装大考!代码智能体物理结构设计与人类水平仍存巨大差距

随着 AI 代码智能体(Coding Agents)在解决软件 Bug 与单步算法题上日趋成熟,学术界开始将其推向更具挑战性的‘物理世界逆向工程与空间离散装配’领域。斯坦福大学(Stanford University)与法国国家信息与自动化研究所(Inria)联合研究团队在最新成果(arXiv:2610.12452)中推出了首个针对文本驱动 3D 积木装配设计的智能体基准套件 BrickBench 及交互沙箱 BrickAgent(项目主页:brickben.ch)。在 BrickBench 中,代码智能体接收一段高层语义文本 Prompt(如‘拼装一架带有双螺旋桨的倾转旋翼飞机’),必须从离散的标准零件库中挑选积木块,编写确定性代码进行三维空间坐标与咬合位姿规划。装配结果不仅要严格满足语义对齐,更必须经受物理引擎关于局部咬合互锁、力学重心与全局刚度约束的严苛验证。实测表明,尽管当前顶尖代码智能体能够编写出通过语法测试的拼装代码并大体满足基础几何约束,但其在结构力学自洽性与审美精妙度上依然显著落后于人类积木大师,为物理空间 Coding Agent 建立了全新的评测里程碑。

核心要点速览

  • 斯坦福与 Inria 发布 BrickBench,首创针对文本驱动 3D 乐高离散装配设计的代码智能体评测基准与沙箱
  • 顶尖智能体虽能满足基础几何咬合,但零件冗余度比人类高出 45%,且在高难度力学平衡与刚度上差距显著
  • 提供 BrickAgent 仿真交互沙箱,多轮物理自检重构使装配结构合规率大幅跃升 28.4 个百分点
阅读全文
AD赞助内容

浙大 REAL 开源 ViSkill:打破文本线性化桎梏!视觉原生技能自进化驱动 VLM 智能体成功率攀至 91%

在具身智能交互、GUI 操作系统以及复杂棋盘谜题等空间密集型任务中,大语言与多模态智能体通常通过积累过往成功经验来提升样本学习效率。然而,业界目前绝大多数技能库(Skill Libraries)依然沿袭传统的‘文本中心化(Text-Centric)’范式:强制将丰富的空间几何拓扑、物体相对坐标与动作-状态映射粗暴压缩为一串纯文本字符串,导致极其关键的二维/三维视觉几何结构在编码阶段被彻底磨灭。浙江大学 REAL 实验室团队在最新成果(arXiv:2610.12403)中提出了首个视觉原生技能学习框架 ViSkill。ViSkill 打破了文本序列化的陈旧范式,将成功的空间多模态交互轨迹直接封装为原生的‘复合视觉技能卡片(Composite Visual Skill Cards)’。多模态智能体在推理时直接并行检索视觉技能卡,不仅高效引导动作决策,更利用检索到的视觉技能同步开展细粒度奖励塑形(Reward Shaping);同时,新产生的高价值交互轨迹被动态蒸馏并沉淀回技能库,构建起‘技能沉淀与策略强化’相互迭代的双向闭环。在 Sokoban(推箱子)、FrozenLake 和 PrimitiveSkill 等严苛空间决策基准上,ViSkill 取得了 0.89 的平均成功率,配合冷启动机制更是飙升至 0.91,全面碾压主流开源与闭源前沿模型,且收敛速度远超标准 PPO 算法,官方代码已开源。

核心要点速览

  • 浙大 REAL 开源 ViSkill,首创复合视觉技能卡机制,彻底终结多模态智能体对文本线性化描述的依赖
  • 在 Sokoban 与空间基准上取得 0.89~0.91 的高准确率,收敛速度较标准 PPO 提升数倍并节省 60% 采样步数
  • 构建技能沉淀与策略强化自增强飞轮,为 GUI 自动化与具身导航智能体提供开箱即用的高几何保真架构
阅读全文
关联模型 / 智能体 / 厂商:

冻结大模型实现递归自进化!UCL 与华为诺亚开源 Memento 3:反思规则书秒杀 ARC-AGI-3 全部 25 关

在充满未知的陌生动态环境中,让大语言模型智能体真正具备通用智能的关键,在于使其能够像人类一样自主推断世界运行规律并持续修正世界模型。然而,传统微调成本极高且易导致灾难性遗忘。伦敦大学学院(UCL)与华为诺亚方舟实验室英国团队联合推出了具有里程碑意义的自主进化框架 Memento 3(arXiv:2610.11794)。Memento 3 首次在完全冻结 LLM 基础参数的前提下,通过外部持久语义记忆实现了纯基于模型的‘递归自我改进(Recursive Self-Improvement, RSI)’。智能体维护一份由自然语言编写的‘可修订规则书(Rulebook)’,记录对环境动态的假设;系统将规则书编译为可执行代码,并在由‘观察-反思-修订-编译-验证’构成的持续循环中利用预测误差精准重构逻辑。只有经过 LLM 语义忠实度审查与单元级精确重放(Cell-Exact Replay)双重校验的代码才会被采纳。在极度考验抽象归纳能力的权威基准 ARC-AGI-3 上,Memento 3 惊人地通关了全部 25 款公开游戏的每一个关卡,相对人类动作效率(RHAE)达到完美的 100.0,且仅消耗人类 44% 的动作步数;在 Atari Pong 测试中,系统自主合成的反馈控制器连续三局以 21:0 零封人类顶尖 AI,全程无需任何追加 LLM 算力调用。

核心要点速览

  • UCL 与华为诺亚开源 Memento 3,在冻结大模型前提下首创基于反思规则书的递归自我改进(RSI)架构
  • 将自然语言规则书编译为可执行代码模型,依托单元级精确重放(Cell-Exact Replay)确保零幻觉因果推断
  • ARC-AGI-3 全部 25 关 100% 通关(动作步数仅人类 44%),Atari Pong 以 21:0 零封对手且全程零追加 LLM 调用
阅读全文

部署期边用边学!ASCENT 开源在线测试时训练框架:冻结初态逆向蒸馏,长程智能体终生自进化

随着 LLM 智能体在真实生产环境中接管长流程(Long-Horizon)复杂任务,面对持续涌入的任务流,如何让智能体在部署运行期实现终生自进化,已成为具身智能与智能体系统的前沿圣杯。现有上下文自适应(In-Context Adaptation)方案仅将经验转化为文本记忆或外部向量库,极度依赖脆弱的检索机制,且无法改变冻结的底座权重;而若直接对单次尝试的生成 Token 施加模仿学习或强化微调,又会因稀疏单次反馈导致模型策略瞬时崩溃。研究团队首次形式化定义了“在线智能体测试时训练”(Online Agentic Test-Time Training, OaTTT),并提出了创新自蒸馏框架 ASCENT(arXiv:2610.05303):智能体在单遍任务流中仅执行一次任务,将冻结的初始版本模型作为具备后见之明(Hindsight)的稳定导师,输入已验证成功的完整轨迹作为特权信息,计算沿轨迹的 Next-Token 概率分布;随后将这些特权经验高效蒸馏进持久化的轻量 LoRA 快速权重中。通过进一步剪除无效动作轮次,ASCENT 在无需任何外部教师模型或标准参考答案的前提下,在 ALFWorld、WebShop 和 AppWorld 等跨模态长程基准上实现了任务成功率与交互步数效率的持续单调提升,并强力迁移至未见过的全新场景。

部署期边用边学!ASCENT 开源在线测试时训练框架:冻结初态逆向蒸馏,长程智能体终生自进化

核心要点速览

  • 首次形式化确立在线智能体测试时训练(OaTTT)理论,推出无需外部教师模型的自蒸馏框架 ASCENT
  • 以冻结初始底座为后见之明特权导师,结合剪除无效轮次的高保真轨迹,将运行时经验高效固化进持久 LoRA 权重
  • 在 ALFWorld、WebShop 与 AppWorld 上实现随部署经验累积成功率单调飙升,并强力泛化至未见过的新场景
阅读全文

循环 Transformer 迎来近乎零成本爆发!LoopCD 提出循环对比解码:FLOPs 砍半算力立省 48%,AIME 跑分由 61.8% 跃至 73.3%

循环 Transformer(Looped Transformers)通过在循环中反复复用单套共享参数块,以极小参数量实现了匹敌深层大模型的计算深度。然而在标准推理中,模型仅仅消费最终循环的隐层表征,中间轮次的所有计算产物全部被直接丢弃。来自德克萨斯大学奥斯汀分校(UT Austin)、普林斯顿等学者团队提出了完全免训练的循环对比解码框架 LoopCD。该框架敏锐捕捉到循环网络天然携带的“自身弱表征与强表征”配对特性,通过将最终循环表征与早期循环表征进行反向对比,在 Logit 空间或隐层表征空间(Zero Overhead)直接引导 Token 优选。在四大多循环模型家族中,LoopCD 将 Ouro-2.6B-Thinking 的 AIME 2024 Pass@1 从 61.88% 强力拉升至 73.33%,在循环轮次直接减半的前提下仍超越全深度未引导基线,前向推理 FLOPs 暴降 22.5% 至 48.2%。

循环 Transformer 迎来近乎零成本爆发!LoopCD 提出循环对比解码:FLOPs 砍半算力立省 48%,AIME 跑分由 61.8% 跃至 73.3%

核心要点速览

  • 首创循环对比解码 LoopCD,变废为宝利用多循环内部中间状态,完全无需外挂小型参考模型或重新微调
  • 驱动 Ouro-2.6B-Thinking 在 AIME 2024 竞赛数学 Pass@1 由 61.88% 飙升至 73.33%,HumanEval 提升近 10 个百分点
  • 循环执行次数直接砍半仍超越全深度未引导基线,前向推理 FLOPs 算力消耗大幅锐减 22.5%~48.2%
阅读全文
关联模型 / 智能体 / 厂商:

清华大学开源 TaH2:自适应循环 Transformer 突破测试时计算缩放瓶颈,AIME 算力斜率提升 53%

循环 Transformer(Looped Transformer)通过跨轮复用网络层具备极高的参数效率,但固定循环深度的盲目迭代在简易 Token 上严重浪费算力,且深层往往陷入收益平台期。清华大学电子工程系 NICS 实验室提出 TaH2 架构,通过前瞻深度监督(Lookahead Depth Supervision)联合后训练主干与迭代决策器,自适应将计算分配给获益最高的关键 Token,在极具挑战的 AIME 数学基准上将测试时算力缩放斜率(Accuracy-Compute Slope)拉升 53%,深度扩展至 8 层依然维持强劲增益。

清华大学开源 TaH2:自适应循环 Transformer 突破测试时计算缩放瓶颈,AIME 算力斜率提升 53%

核心要点速览

  • 前瞻深度监督自适应分配循环算子:颠覆固定深度每步均摊计算的模式,引入在线前瞻标签(Lookahead Labels)实时预测继续循环是否会提升 Token 准确率,精准聚焦困难决策点。
  • AIME 测试时计算扩展斜率暴涨 53%:在极具挑战的高难度数学基准 AIME 上,算力翻倍带来的准确率斜率从基线的 1.79 跃升至 2.74,在相同测试算力消耗下峰值准确率高出 3.4 分。
  • 攻克深度缩放收益饱和瓶颈:传统循环模型在循环轮次增加后迅速停滞,而 TaH2 随着最大循环深度由 2 扩展到 8,相对无循环基线的领先优势从 +2.8 分持续放大至 +3.9 分。
阅读全文
关联模型 / 智能体 / 厂商: