AI 编程实时动态与要闻

X 热议:Jason Calacanis 称每年不到 4 万美元的 AI 订阅换来 200 万美元以上价值、已自动化至少 7 个全职岗位

天使投资人、This Week in Startups 主持人 Jason Calacanis 11 月 2 日在 X 上发帖:他每年在 Anthropic、Lovable、Grok Bot、ElevenLabs 等 AI 产品的 token 和订阅上花不到 4 万美元,却在 LAUNCH 和 This Week in Startups 获得 200 万美元以上的价值,已自动化至少 7 个全职岗位,平均任务速度快了 100%。他说过去 90 天的变化超过此前两年。帖子约 9 小时内获得约 2200 赞、23 万浏览,讨论集中在 AI 投资回报和岗位替代。以上数字都是他本人的说法,未经独立核实。

核心要点速览

  • 这是 Calacanis 的个人帖子,不是任何 AI 公司的官方数据或公告;4 万美元、200 万美元、7 个岗位、快 100% 都是他自报,没有公开明细。
  • 原帖(2026-11-02 05:27 UTC)约 2201 赞、106 转发、244 回复、42 引用、23 万浏览、715 次收藏(抓取时数据)。
  • 他提到的工具包括 Anthropic、Lovable、Grok Bot、ElevenLabs,以及一长串其他产品;他还说,过去 90 天的产品每周没用满 30 小时,就体会不到这类软件有多大变化。
  • 支持方:创业者 Steven Cohn(@spcohn)引用称他们也看到了同等的回报;拥有约 40 万粉丝的 Farzad(@farzyness)引用称「AI 的回报率高得惊人」,约 157 赞。
  • 质疑方:有用户调侃,把「自动化了 7 个全职岗位」配上 🚨 当成产品发布来宣传,而且每周用 30 小时本身就像一份新的全职工作。
阅读全文
关联模型 / 智能体 / 厂商:

ElevenLabs 发布音效模型 SFX v3:一句提示词生成多层音效,音乐与人声更好,API 已可调用(限量开放)

ElevenLabs 官方账号 10 月 29 日 18:03(UTC)发布 SFX v3,称它能从单条文本提示词生成更丰富、更精确的音效,音乐和人声表现更好,已在 ElevenCreative 和 ElevenAPI 上线。官方文档显示新模型 ID 为 eleven_text_to_sound_v3,沿用原有 Sound Effects API,但默认模型仍是 v2,且 v3 目前限量开放、并非所有地区可用。

ElevenLabs 发布音效模型 SFX v3:一句提示词生成多层音效,音乐与人声更好,API 已可调用(限量开放)

核心要点速览

  • 模型 ID:eleven_text_to_sound_v3,与 v2 共用同一个 Sound Effects API,只需改 model_id;默认仍是 eleven_text_to_sound_v2
  • 官方文档列出 4 项改进:多条指令同一提示词、能处理音乐与人声、更自然、高频声(锣、钟、哨)更少削波
  • 限量开放:没有权限的账号调用会返回 Unknown model 错误,且并非所有地区可用
  • 时长 0.1–30 秒,指定时长时按每秒 40 credits 计费(Sound Effects 接口通用口径),支持 loop 无缝循环
  • 跑分:官方未公布任何量化基准,文档建议用自己的提示词对比 v2 与 v3
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SFX v3⚡ eleven_text_to_sound_v3🌐 ElevenLabs

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

Mistral AI 正式推出 Voxtral 3 语音多模态大模型家族与配套的实时 Voice-Agent API。该套件包含 40 亿参数的 Mini 转录模型、超越 Whisper 与 Gemini 3.5 的 Small 转录模型,以及基于 LiveKit 的端到端语音智能体 SDK。系统支持 50 种语言高精听写与说话人分离、跨 35+ 语言带情感标签的情感语音合成(TTS)以及 30 分钟音频专业级声音克隆。在 Artificial Analysis 独立基准评测中,Small Transcribe 3 以 2.1% 极低字错率登顶全球语音识别榜单季军,Realtime 转录单步延迟低至 500ms 以内,每分钟语音智能体调度成本低至 0.04 美元。

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

核心要点速览

  • Mistral 官方正式发布 Voxtral 3 全栈语音多模态模型家族,包含转录、情感 TTS、专业声音克隆与实时 Voice-Agent SDK
  • 在 Artificial Analysis 独立实测中,Small Transcribe 3 斩获 2.1% 极低错词率,击败 ElevenLabs Scribe v2(2.2%)与 Grok Voice 2.0(2.3%)
  • Realtime Transcribe 3 响应时间压缩至 500ms 以内,端到端完整语音 Agent 回合交互延迟突破 1 秒大关
  • 极致价格革命:Mini 转录每分钟仅需 0.0035 美元,搭配 Mistral Small 4 调度的全托管语音智能体每分钟仅 0.04 美元
阅读全文
关联模型 / 智能体 / 厂商:

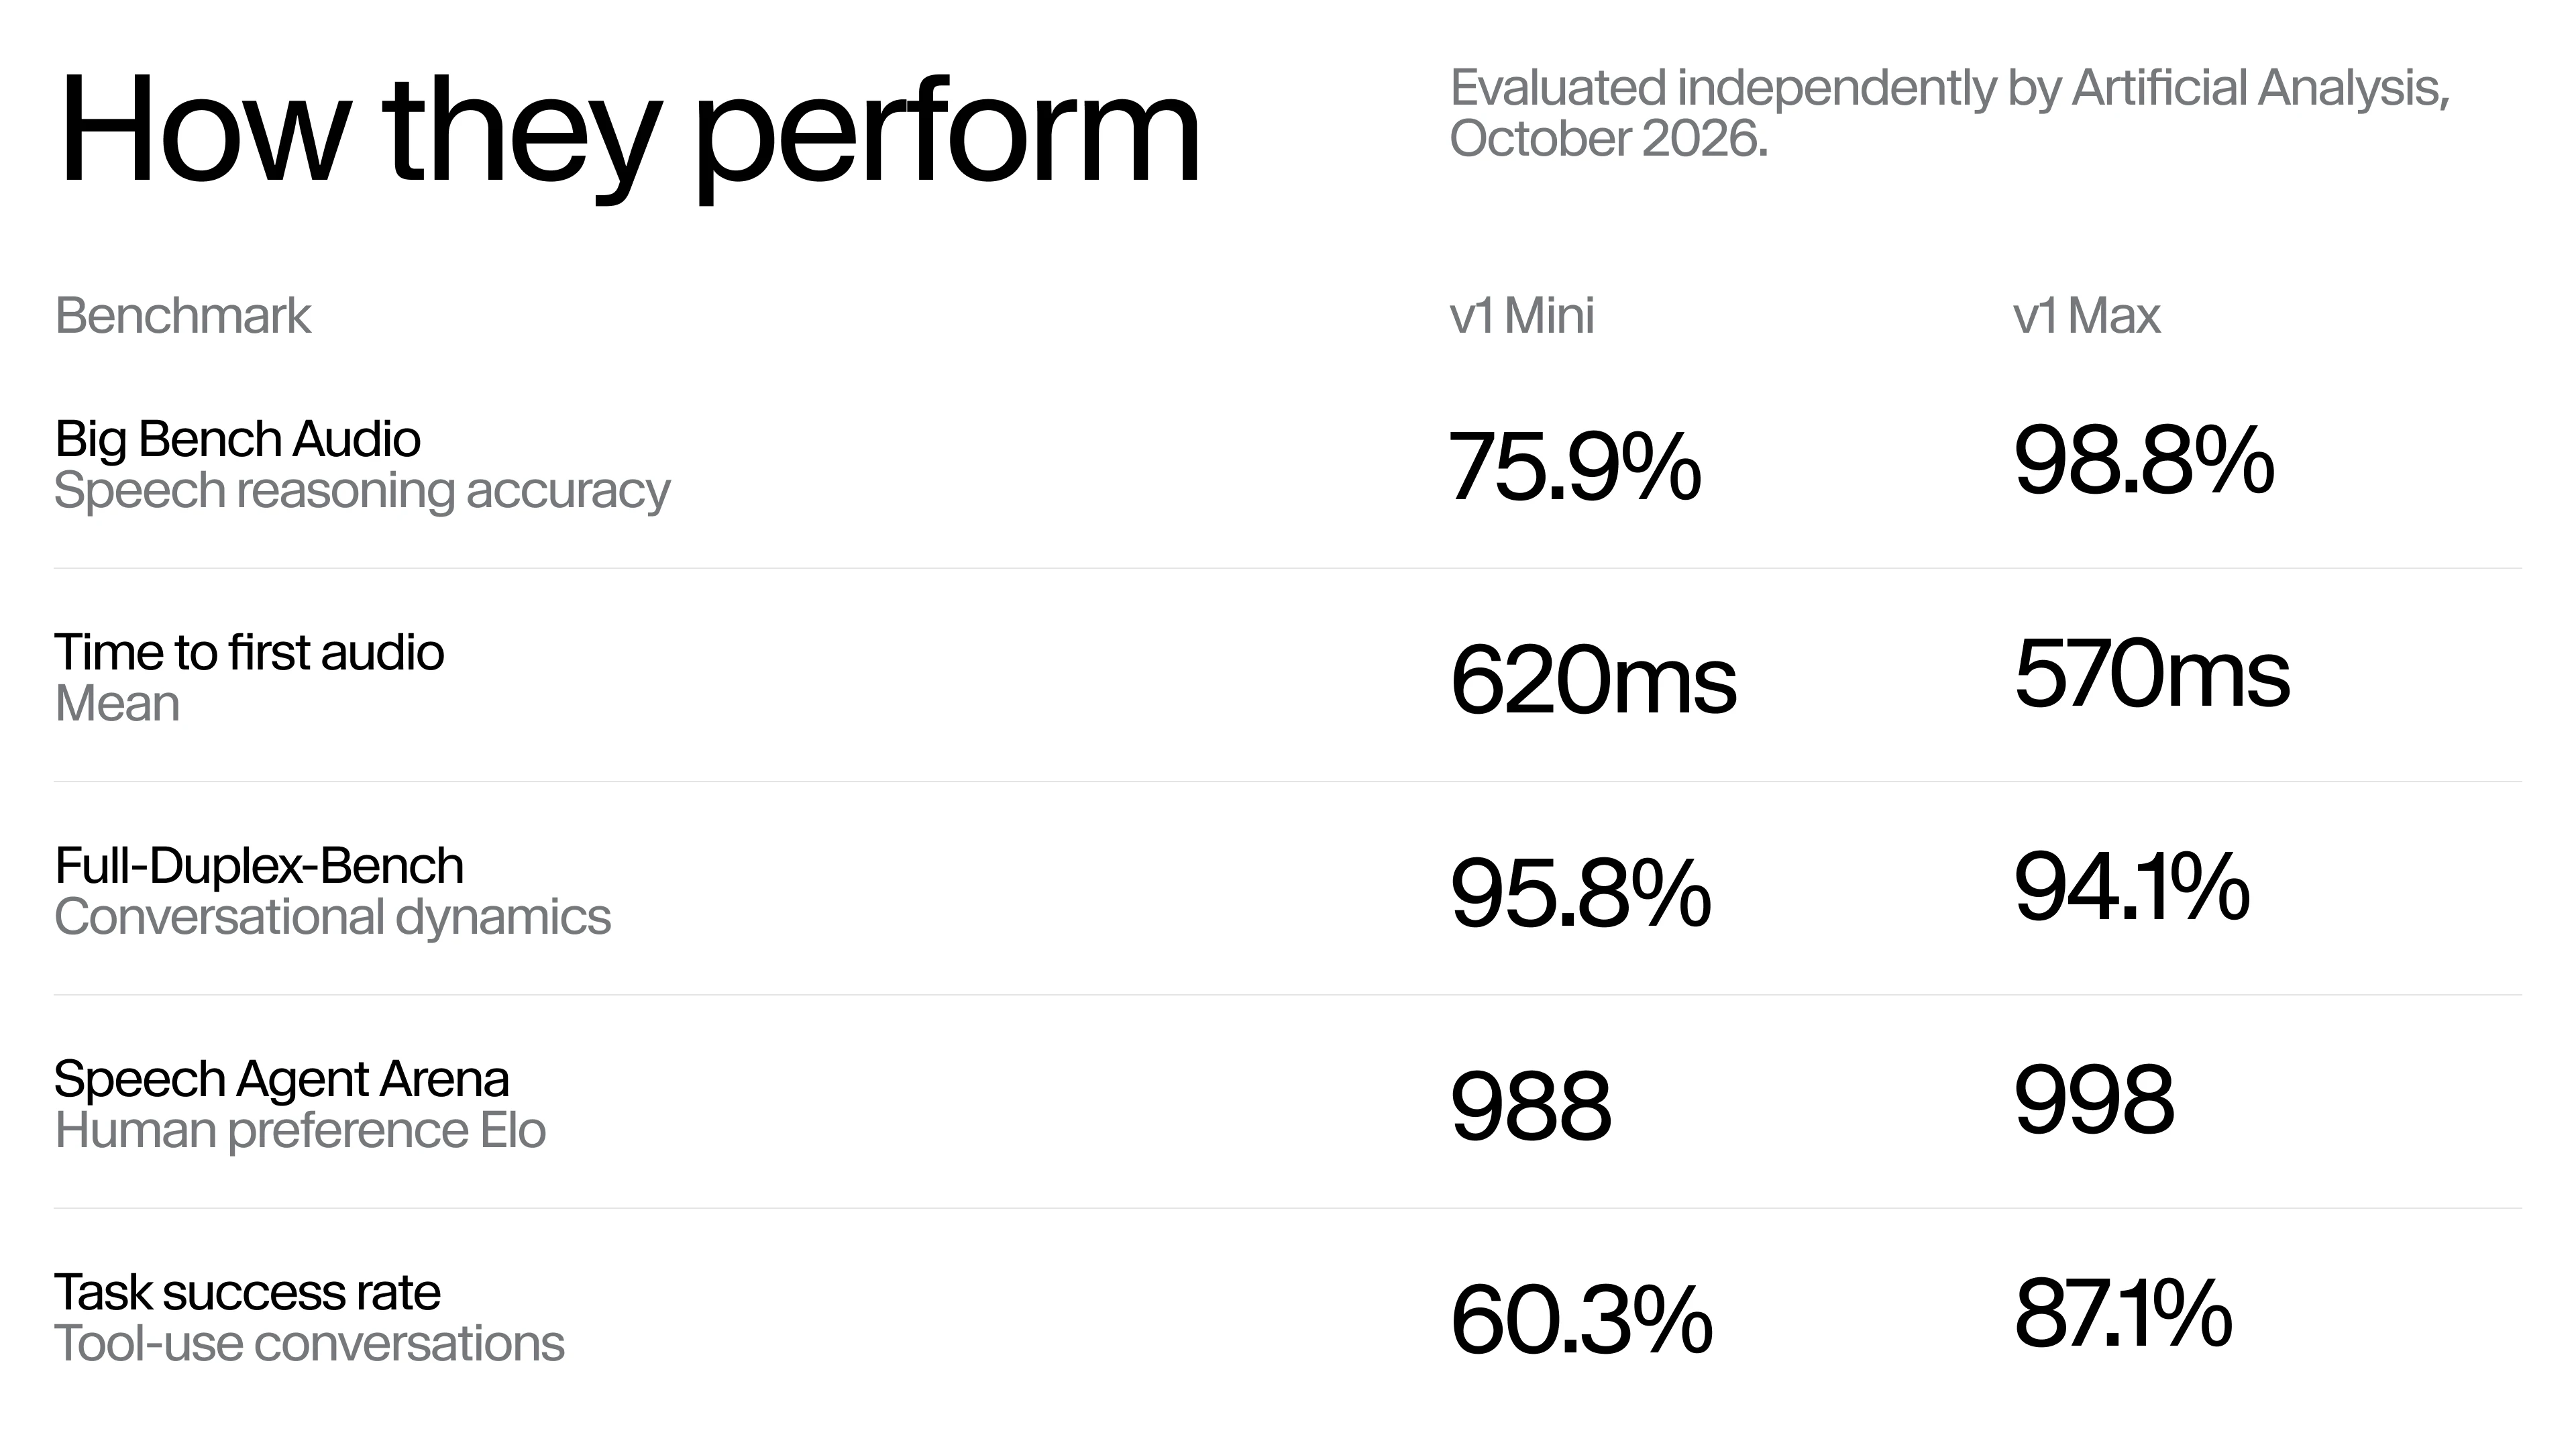
ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

10 月 20 日,ElevenLabs 发布 Eleven Realtime,一类端到端语音到语音模型,每个模型本身就是完整的语音 Agent,不再需要自己拼语音识别、大模型和语音合成。v1 Mini 主打低成本自然对话,v1 Max 面向客服和多步骤工具调用。两者支持 90+ 语言、可用 17,000+ 种音色。官方引用 Artificial Analysis 独立评测:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开始说话。接口兼容 OpenAI Realtime API,改端点和模型名即可迁移。

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

核心要点速览

  • 语音推理(Artificial Analysis 独立评测,官方引用):Big Bench Audio 1,000 道语音推理题,v1 Max 答对 98.8%,v1 Mini 75.9%
  • 速度(官方口径):Max 平均 0.57 秒开始说话,Mini 0.62 秒;官方推文说「半秒开口」,发布文给出的实测略高于半秒
  • 对话动态与偏好:Full-Duplex-Bench 上 Mini 95.8%、Max 94.1%;Speech Agent Arena 盲测 Max 998 分、Mini 988 分
  • 工具调用任务完成率 Max 87.1%、Mini 60.3%,官方因此建议重度调工具的场景用 Max
  • 覆盖 90+ 语言、17,000+ 音色;Realtime API 走 WebSocket(wss://api.elevenlabs.io/v1/convai/realtime),可直接用 OpenAI 官方 SDK,发布文未公布价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Eleven Realtime v1 Mini⚡ Eleven Realtime v1 Max🤖 ElevenAgents🌐 ElevenLabs🌐 Artificial Analysis
AD赞助内容

蚂蚁集团开源语音大模型 Ming-3.0-tts:发音准确率 93.2% 登顶全球开源榜,MIT 协议商用友好

在 Artificial Analysis 最新发布的全球文本转语音(TTS)独立基准评测中,蚂蚁集团(Ant Group)开源的 Ming-3.0-tts 斩获 93.2% 的发音准确率,在全部 31 款参评模型中位列第一(超越 ElevenLabs v4 的 91.7%)。该模型提供 0.5B 密集版与 7.9B MoE 架构版本,支持高质量声音克隆与预设音色,在受控声音评测榜以 1,069 Elo 分位居开源第一,且以极度宽松的 MIT 开源协议完全向开发者免费开放。

蚂蚁集团开源语音大模型 Ming-3.0-tts:发音准确率 93.2% 登顶全球开源榜,MIT 协议商用友好

核心要点速览

  • 蚂蚁集团开源新一代语音大模型 Ming-3.0-tts,在 Artificial Analysis 独立测评中斩获 93.2% 发音准确率登顶全球开源第一
  • 发音表现超越 ElevenLabs v4(91.7%),在受控声音竞技场以 1,069 Elo 分位居开源模型榜首
  • 提供面向低延迟端侧的 0.5B 稠密版与极致拟真的 7.9B MoE 旗舰版,支持 3 秒极速零样本声音克隆
  • 采用无限制 MIT 开源协议完全免费商用,权重与代码已全面上线 Hugging Face
阅读全文
关联模型 / 智能体 / 厂商:

LiveKit Agents 1.8.3:Gemini 3.8 Live 默认 NON_BLOCKING、GPTLive Azure,AssemblyAI Universal 与工具 handoff 防护

LiveKit 于 2026-09-26 在 GitHub 发布 Python 包 [email protected](PyPI livekit-agents 1.8.3):Google Gemini 3.8 Live 路径默认 tool_behavior=NON_BLOCKING,并在 text API 上以 parameters_json_schema 发送 FunctionTool schema;OpenAI 侧新增 GPTLiveModel.with_azure,Realtime inference client 迁入 agents core;STT 增加 AssemblyAI universal-3-6-pro 与 language_confidence,ElevenLabs realtime chunk duration 可配;语音栈修复并行工具取消 handoff、按 call_id 配对 tool output、fallback/stream adapter 原样转发帧,以及 LiveAvatar 打断与插件注册。同日 JS @livekit/[email protected] 强化 agent_turn 遥测与自适应打断。

LiveKit Agents 1.8.3:Gemini 3.8 Live 默认 NON_BLOCKING、GPTLive Azure,AssemblyAI Universal 与工具 handoff 防护

核心要点速览

  • 发版:[email protected] / PyPI 1.8.3;JS 同步 @livekit/[email protected]
  • Gemini:3.8 Live 默认 NON_BLOCKING tool_behavior;text API 用 parameters_json_schema 传 FunctionTool
  • OpenAI:GPTLiveModel.with_azure;Realtime inference client 迁入 agents core
  • STT:AssemblyAI universal-3-6-pro + language_confidence;ElevenLabs realtime chunk duration 可配
  • 语音正确性:并行工具不再取消 agent handoff;tool output 按 call_id 配对;Fallback/StreamAdapter 原样转发帧
阅读全文
关联模型 / 智能体 / 厂商:

Pipecat 1.12.0:IPA 发音变换跨 TTS 厂商复用,MOQTransport 客户端重连与 Classifier/LLMClassifier 评测面升级

开源语音/多模态助手框架 Pipecat 于 2026-09-26 发布 v1.12.0:TTSService.pronunciation_transform_ipa() 用词→IPA 映射生成可跨 Cartesia/ElevenLabs/Inworld/Deepgram 复用的发音变换;MOQTransport 增加客户端模式重连与 session-ending 标记;新增 Pipecat Classifiers、LLMClassifier、帧级 interruptible,以及 LLM run_inference 的 response_schema。PyPI pipecat-ai 1.12.0 已同步。

Pipecat 1.12.0:IPA 发音变换跨 TTS 厂商复用,MOQTransport 客户端重连与 Classifier/LLMClassifier 评测面升级

核心要点速览

  • 发版:v1.12.0 = PyPI pipecat-ai 1.12.0,文档 docs.pipecat.ai
  • 发音:pronunciation_transform_ipa({"Metformin": "mɛtˈfɔɹmɪn"}) 一次映射,按厂商写成 phoneme/SSML/斜杠 IPA;请放在 text_transforms 最后以免被后续变换改写
  • 传输:MOQTransport 客户端模式断线按 connection_timeout(默认升至 60s)退避重拨;session-ending 区分挂断与中断;relay_url 支持完整 URL
  • 评测:新增 Classifier(YesNo/Choice/Score)与 LLMClassifier 单次 LLM 批量答题;judge.eval.allow_continue=false 可禁 continue
  • 推理:LLMService.run_inference(..., response_schema=...) 由 OpenAI/Anthropic/Google 侧强制 JSON;帧默认 interruptible=True,UninterruptibleFrame 弃用
阅读全文
关联模型 / 智能体 / 厂商:

ElevenLabs MCP 上线语音/音乐/图像/视频生成:可在 ChatGPT、Claude、Cursor、Grok Bot 等一键调用

ElevenLabs 官方发布多模态 MCP:可在已有助手内生成语音、转写、配音、音乐、音效、图像与视频。声明已接入 ChatGPT、Claude、Cursor、Grok Bot、Hermes,一次安装即可在多端使用。

核心要点速览

  • ElevenLabs MCP 新增多模态生成:语音、音乐、图像、视频等。
  • 可在 ChatGPT、Claude、Cursor、Grok Bot、Hermes 等助手内直接调用。
  • 一次安装即可跨端生成 speech/transcripts/dubs/SFX/media。
阅读全文