AI 编程实时动态与要闻

X 热议:Ethan Mollick 称游戏圈反 AI 浪潮主要伤到独立工作室,起因是年度独立佳作《Big Walk》承认不到 0.1% 的代码与 AI 有关,引发 IGF 评审分歧

沃顿商学院教授 Ethan Mollick 11 月 11 日在 X 上发帖称,游戏圈的反 AI 浪潮「主要在伤害独立工作室」:在几乎所有编程都会用到 AI 的世界里,坚持「零 AI 代码」是做不到的标准,玩家若在乎人的创作,应奖励以人类美术和设计为核心的作品,而不是去审查 AI 使用。起因是 Kotaku 报道:House House 的独立游戏《Big Walk》被曝开发中用过 AI,工作室称与此相关的代码「远低于 0.1%」,其他环节没用生成式 AI,此前未披露是因为 Steam 不要求披露代码或聊天机器人的使用。此事让 2027 年独立游戏节(IGF)评审意见分裂。该帖约 1.27 万浏览、335 赞、77 条回复;他随后一帖称 GTA 6 将是「最后一款纯人工游戏」,获 600+ 赞。以下为观点讨论,不代表事实结论。
X 热议:Ethan Mollick 称游戏圈反 AI 浪潮主要伤到独立工作室,起因是年度独立佳作《Big Walk》承认不到 0.1% 的代码与 AI 有关,引发 IGF 评审分歧

核心要点速览

  • 《Big Walk》开发商 House House 称:与 AI 相关的代码 远低于 0.1%,其他环节未用生成式 AI(Kotaku 转述官方声明)
  • 未披露的理由:Steam 不要求披露代码或聊天机器人使用
  • 2027 年 IGF 评审分裂:部分评审签署公开声明主张「零例外」,另一部分认为如此有限的使用不应取消参评资格
  • Mollick 帖约 1.27 万浏览、335 赞、77 条回复;「最后一款纯人工游戏」帖 600+ 赞、2.2 万浏览
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Ethan Mollick 让 Claude 自主搭建「传送门」3D 网站,约 2.5 万次 Agent 运行做出 471 个世界,Agent 还自己长出了 204 节、8.75 万词的「官僚规则手册」

沃顿商学院教授 Ethan Mollick 11 月 9 日在 X 分享实验:他只给 Claude 一段描述,要求做一个穿过传送门、在 3D 世界间无尽飞行的网站,20 小时后上线 204 个世界,现已开源 471 个、约 140 万行 JavaScript。他在博客中写道,Agent 团队后来自发建立评审规则,规则手册膨胀到 204 节,开发速度从每天数百个跌到约十几个。帖子约 10 小时获 1262 赞、158 条回复。

X 热议:Ethan Mollick 让 Claude 自主搭建「传送门」3D 网站,约 2.5 万次 Agent 运行做出 471 个世界,Agent 还自己长出了 204 节、8.75 万词的「官僚规则手册」

核心要点速览

  • 一段描述起步,20 小时上线 204 个世界;仓库 README 显示截至 11 月 9 日共 471 个世界、约 140 万行 JavaScript(GitHub)
  • Claude 自己估计约 2.5 万次 Agent 运行,大多只做单一任务(如给图片打分);第 10 天形成 1 个主 Agent + 28 个并行团队(One Useful Thing)
  • Agent 自建评审制度:新版本须在 12 张测试截图上赢过盲评;规则手册 12 天内从 84 节涨到 204 节、8.75 万词,上线一个世界要约 1 天
  • 引入外部「顾问」Agent 团队梳理流程后,产出恢复到每天 30 个以上世界(Mollick 博客口径)
  • Mollick 帖子约 10 小时获 1262 赞、108 转发、158 条回复、约 6.2 万次浏览;回复焦点集中在「Agent 也会长出中层管理」和 token 成本
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:MIT 团队称 GPT-6 Astra 能直接读写神经网络权重,只改 Qwen3.5-0.8B 的 0.016% 权重让 MATH-500 从 7.9% 升到 48.1%

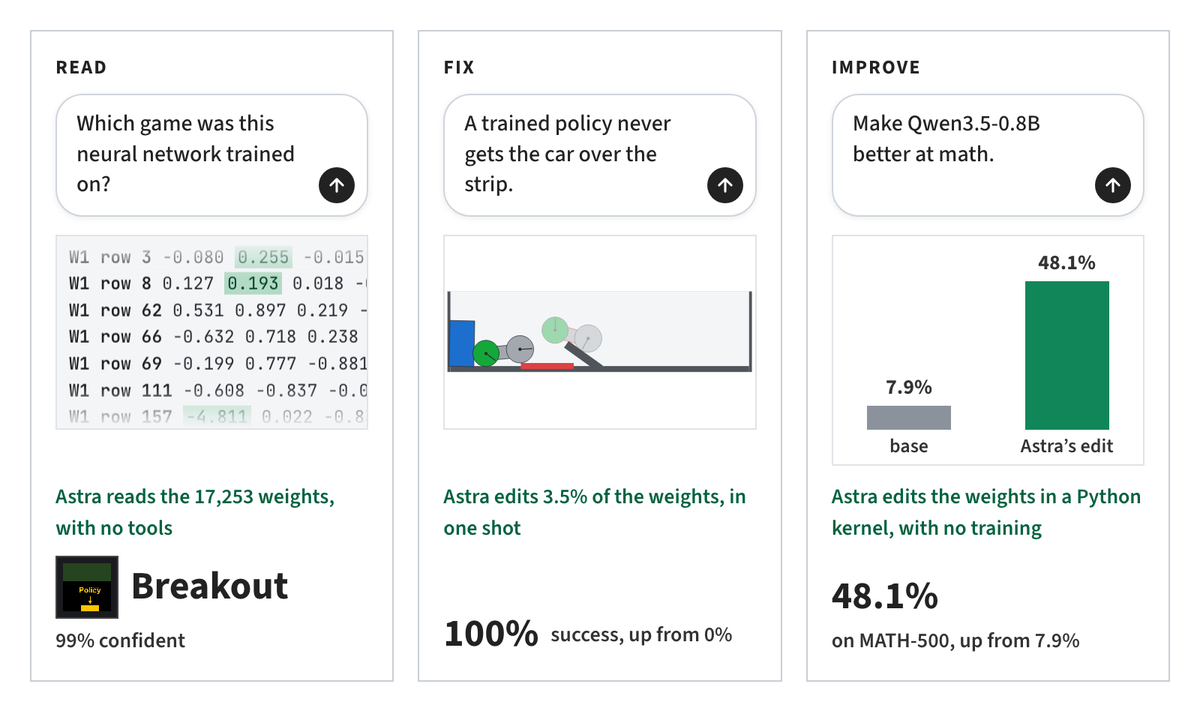
MIT CSAIL 博士生 Rikiya Takehi 11 月 2 日在 X 上发布「Weight-Space Programming(权重空间编程)」研究:作者团队(Takehi、Jayden Teoh、Alex Zhang、Omar Khattab)让 GPT-6 Astra 不用梯度、不做训练,直接阅读和修改神经网络权重。博客称 Astra 只改了 Qwen3.5-0.8B 的 13.1 万个权重(0.016%),修复了思考死循环,MATH-500 从 7.9% 升到 48.1%。原帖约 2.4 万赞、177 万浏览,Ethan Mollick 转评「等复现,但这很重要」。以上均为作者自报结果,尚未独立复现。

X 热议:MIT 团队称 GPT-6 Astra 能直接读写神经网络权重,只改 Qwen3.5-0.8B 的 0.016% 权重让 MATH-500 从 7.9% 升到 48.1%

核心要点速览

  • 原帖(2026-11-02 17:51 UTC)抓取时约 24,320 赞、2,697 转发、2,284 引用、177 万浏览、1.5 万收藏;沃顿商学院教授 Ethan Mollick 转评「等待复现,但这很重要」,约 880 赞。
  • 实验 8(作者口径):50 次前向预算下,Astra 只改 131,072 个权重(0.016%),Qwen3.5-0.8B 的 MATH-500 从 7.9% 升到 48.1%,IFEval 从 21.0% 升到 62.3%,触及 token 上限的回答从 93.0% 降到 33.1%。
  • 实验 5(作者口径):不给数据、梯度和工具,Astra 一次性写出的 MinAtar 策略网络在 Breakout 得 517.4 分,PPO 训练 1 亿步为 15.8、5 亿步为 25.3;Seaquest 为 53.1,低于 5 亿步 PPO 的 88.9。
  • 作者自己承认的边界:换成很少死循环的 Gemma 3 270M,Astra 的编辑没让 MATH-500 提升超过约 1 个点;作者结论是改权重能「移除遮住能力的障碍」,但不能凭空加能力。
  • 全部实验日志已公开在 GitHub 仓库 RikiyaT/lm_understand-logs,目前只有博客,没有同行评审论文,也没有第三方复现。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:哈佛 Gary King 新论文称 AI 审稿「在每项指标上」胜过顶尖人类审稿人,Ethan Mollick 呼吁学术界尽快适应

哈佛社会科学家 Gary King(@kinggary)UTC 2026-10-23 00:27 在 X 发布与 Steven Worthington 合写的新论文《AI Article Reviews Dominate Human Peer Reviews at Their Best: Evidence and Policy Choices》,摘要称 AI 生成的审稿意见在他们能构建的每项指标上,都优于报酬优厚、且被编辑和作者评为质量特别高的人类专家审稿。沃顿商学院教授 Ethan Mollick(@emollick)随后转述称研究覆盖 124 篇哈佛社会科学论文、使用的是 Claude Opus 4.8,并说学术界必须尽快想清楚如何让科研实践适应 AI,该帖约 1,675 赞、9.7 万浏览。过去 12 小时这一话题仍在 X 新闻热榜上发酵。这是 X 上的讨论和单篇论文的结论,不是期刊或 Anthropic 的官方结论。

核心要点速览

  • 论文作者为哈佛的 Gary King 与 Steven Worthington,主页注明最后更新于 2026-10-22(论文页面;King 原帖,抓取时约 472 赞、12 万浏览、371 次收藏)
  • 摘要原话:AI 审稿「by every measure we could construct」都优于「well-compensated」且被评为「unusually high quality」的人类专家审稿;论文同时讨论期刊政策选择及其「concerning downsides」
  • Ethan Mollick 的转述帖(原帖)称使用 Claude Opus 4.8、覆盖 124 篇论文,抓取时约 1,675 赞、9.7 万浏览、249 条回复
  • X 上不少转述帖还引用「前期刊编辑盲评 87% 选 AI 审稿」「错误陈述 5.5% 对 15.9%」等数字,本站未在论文原文中逐项核对,请以论文为准
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容