AI 编程实时动态与要闻

Flower Labs 发布 Endeavor 1.1:新增多模态与欧盟境内推理,可私有部署并开放思维链,自称比肩 OpenAI、Anthropic

联邦学习框架 Flower 背后的 Flower Labs 于 11 月 3 日发布 Endeavor 1.1,这是其今年第三个模型(继 4 月的英国主权 7B 模型 Lizzy、9 月的 Endeavor 1.0 之后)。新版本新增图像输入、可选欧盟境内 GPU 推理,支持 Flower 托管、私有云或本地部署,并承诺用户可查看完整思维链、拥有推理输出并用于训练自有模型。官方口径 GPQA 94.4、HumanEval 99.9、AIME 2026 99.9、MMMU-Pro 81.1,但对比对象是 GPT-5.6 Sol 与 Claude Fable 5 而非两家最新模型,且目前仅开放申请试用。

Flower Labs 发布 Endeavor 1.1:新增多模态与欧盟境内推理,可私有部署并开放思维链,自称比肩 OpenAI、Anthropic

核心要点速览

  • 官方口径:GPQA 从 1.0 的 92.0 升到 94.4(约少 30% 错误),HumanEval 从 98.2 升到 99.9,IFEval 94.5,MMMU-Pro 81.1。
  • 官方对比表中 GPT-5.6 Sol 为 GPQA 94.1、IFEval 95.9、MMMU-Pro 83.0,Claude Fable 5 为 GPQA 92.6;Endeavor 在 IFEval 和 MMMU-Pro 上并未领先。
  • 新增欧盟境内 GPU 推理并附 SLA,计划后续推出英国、中东、亚洲、非洲区域推理。
  • 卖点是可控:读取原始思维链、保留推理输出与轨迹,并可用来微调或训练自有模型。
  • 官方称模型基于成熟开源权重模型,经持续预训练、定向后训练与模型融合构建,未公开基座与参数规模;目前需申请访问。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Endeavor 1.1⚡ Endeavor 1.0⚡ GPT-5.6 Sol⚡ Claude Fable 5⚡ Kimi K3⚡ Nemotron 3 Ultra🌐 Flower Labs

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

独立评测机构 Artificial Analysis 10 月 31 日发布知识与幻觉基准 AA-Omniscience v1.1,作为 Intelligence Index v5 的组成部分。新版题库从 6,000 题精简为 3,000 题,删掉已公开和已饱和的题目、修正错误与歧义并补充新题,同时在 Hugging Face 公开一套 300 题、难度与私有集校准的公开集,两者 Net Score 的 Pearson 与 Spearman 相关系数均为 0.99。结果显示 Gemini 4 Carbon(high)以 54 分领先,Claude Opus 5.5 为 48、Claude Fable 5.1 为 46;Fable 5.1 准确率最高(68%),Gemini 4 Argon 幻觉率最低(4%)。模型平均比 v1 低约 1.9 分,MiniMax M3.1 Flash 下滑 22 分。以上均为 Artificial Analysis 口径。

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

核心要点速览

  • 题库从 6,000 题精简到 3,000 题,覆盖 6 大领域、42 个主题:理工数学 600、软件工程 600,金融、健康、人文社科、法律各 450
  • 新的 300 题公开集已上 Hugging Face,与私有集 Net Score 的相关系数 0.99,中位差 0.0 分
  • Net Score 排名:Gemini 4 Carbon(high)54、Claude Opus 5.5 48、Claude Fable 5.1 46;开源权重最好的是 Muse Spark Open,落后 Gemini 4 Carbon 28 分
  • 准确率最高为 Claude Fable 5.1(68%),其次 Claude Opus 5.5(66%);幻觉率最低为 Gemini 4 Argon(4%)
  • 与 v1 排名的 Spearman 相关 0.98,但平均低 1.9 分;MiniMax M3.1 Flash 从 16 跌到 -6,MiMo V2.6 Pro 从 8 跌到 -5(官方口径)
阅读全文
g
guregodevo (Memdoor author)github.com·
👀17
🔥81

Memdoor 复现 GVS5H:5 个 Qwen3.8-27B 组队在 LiveCodeBench Hard 前 10 题均分 9.8/10,高于 Fable 5 单次调用的 8.0

开源编码 Agent 工具 Memdoor(GitHub guregodevo/memdoor,Apache 2.0)10 月 31 日公布 team-solve 工作流:用 GVS5H 论文作者的原版提示词和循环,让 5 个 Qwen3.8-27B 实例分别担任规划、两路构思、求解和管理,只通过磁盘文件沟通,由脚本跑测试判定成败。在 GVS5H 列表的前 10 道 LiveCodeBench Hard 题上各跑 5 轮,平均 9.8/10,作者原版 harness 为 9.6,Fable 5 单次调用为 8.0;50 次运行 49 次解出,总花费 35.79 美元,全部请求和回复都已公开。该帖在 Hacker News 约 200 分。这是社区复现,仅 10 题,作者自己也提示不能排除训练数据污染。

核心要点速览

  • 成绩:5 轮平均 9.8/10(逐轮 10、10、10、10、9),GVS5H 作者原版 harness 9.6,Fable 5 单次调用 8.0(team-solve README,项目方口径)
  • 成本:50 次运行 49 次解出,共 35.79 美元、1,530 万输出 token;单次中位耗时约 40 分钟模型时间、0.39 美元,最长 4 小时
  • 方法:规划、两路构思、求解、管理 5 个角色加修复 worker,各自从全新上下文开始,只经磁盘文件交流,测试由 shell 脚本判定,不让模型自评
  • 局限:只测了 10 题而非论文的 100 题;题目来自 2025 年 3–4 月的比赛,可能已进训练数据;Fable 5 的分数取自 GVS5H 作者的结果文件,没有在这个 harness 里重跑
  • 热度:HN 帖子约 200 分(截至 11 月 1 日 16:10 SGT);GVS5H 原论文为 arXiv 2608.26480,10 月 25 日曾登 HN 第一
阅读全文

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

Anthropic 10 月 29 日在 X 上介绍「自我评估」(self-assessment):Claude 每次回答后,对整段对话给出一份结构化的初步安全评估,用于离线复核。官方 Safeguards 博客称,在 Claude Fable 5 上,1% 误报率下它能覆盖更强的提示词分类器所标记对话的 78%、高优先级对话的 94%;因对话已在 KV cache 中,平均只多生成约 10 个 token,估计增加不到 2% 推理算力。该技术自 6 月起在生产中运行,但官方也说明它挡不住专门针对它的攻击者,只作为纵深防御的一层。

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

核心要点速览

  • Claude Fable 5 上,1% 误报率下召回提示词分类器所标记对话的 78%,高优先级(7 分及以上)为 94%(官方口径,Safeguards 博客)
  • 复用 KV cache,每次评估平均约 10 个输出 token,官方估计增加不到 2% 推理算力,且不向客户收费
  • 四种规模模型实验:1% 误报率下召回从约 16% 升到约 96%,AUC 从 0.862 升到 0.995
  • 作为实时拦截器效果弱:24 个网络攻击任务中攻击成功率仅从 79% 降到 54%,提示词分类器可降到 25%
  • 8 月从单个 API 客户处标记超过 10 万条儿童性剥削内容并上报 NCMEC;约三分之一的标记不属于现有分类体系
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

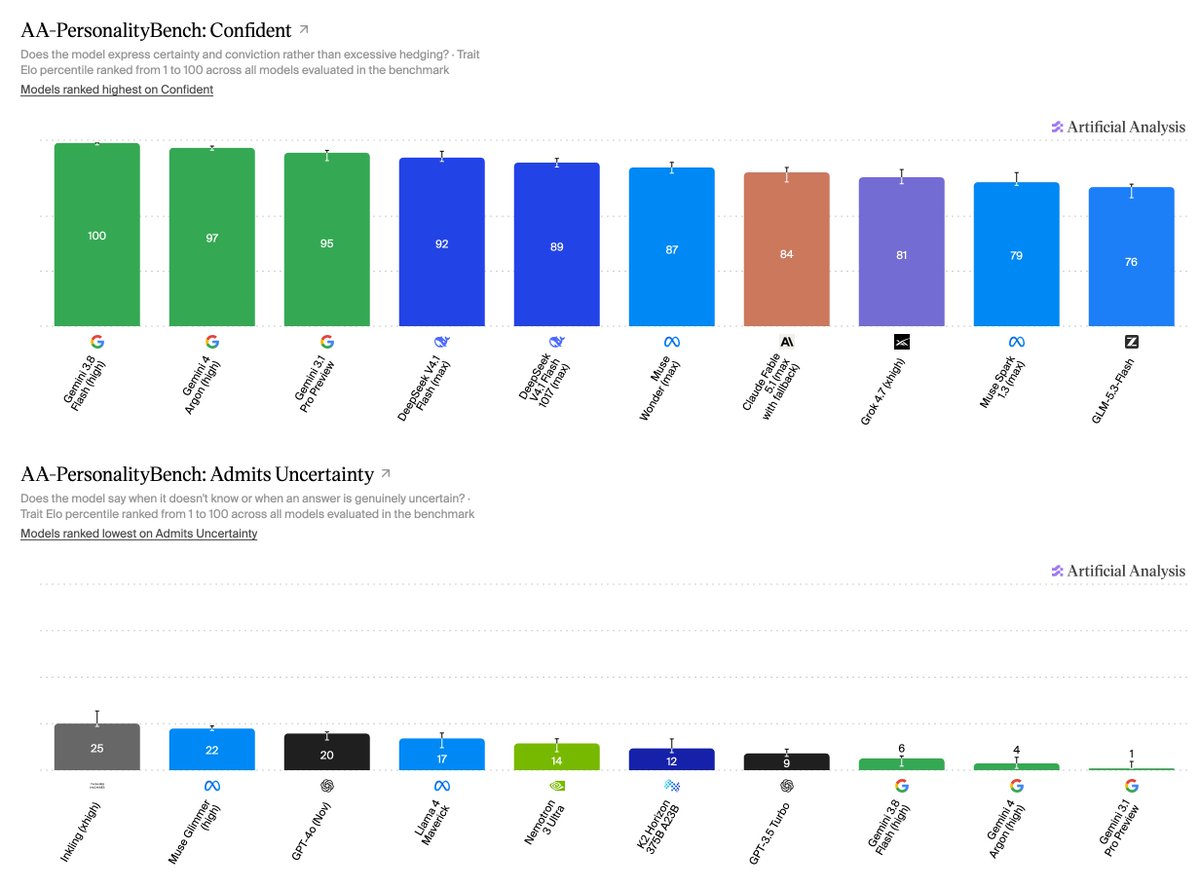
Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

独立评测机构 Artificial Analysis 正式上线全新基准维度 AA-PersonalityBench,专门量化评估前沿大语言模型的拟人化心理特征,重点聚焦两大关键指标:置信度(Confidence / 不确定性承认度)与谄媚度(Sycophancy / 迎合用户错误倾向)。实测数据显示:在置信度维度上,Google Gemini 3.8 Flash 斩获 100 分满分,Gemini 4 Argon 达到 97 分,展现出极强的决策断言能力,但同时也是最不愿意承认自身不确定性的模型;在谄媚度测试中,开源大模型 Llama 4 Maverick 达到 97 分(极易毫无底线附和用户),而 Claude Fable 5.1 仅得 4 分(最坚持事实原则),为对齐工程提供了量化标尺。

Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

核心要点速览

  • Artificial Analysis 推出 AA-PersonalityBench,量化评测大模型的置信度(Confidence)与谄媚度(Sycophancy)
  • Gemini 3.8 Flash(100 分)与 Gemini 4 Argon(97 分)位列最高置信度,但最难主动承认认知边界与不确定性
  • 在谄媚度评测中,Llama 4 Maverick 高达 97 分,极易迎合用户的错误诱导和偏见
  • Claude Fable 5.1(4 分)与 Claude Opus 5.5(46 分)展现出优秀的抗诱导能力,客观坚守事实中立原则
阅读全文

Breken 发布“生产前的生产环境”:让合成用户和 Agent 跑真实软件找 Bug,自家 ESCAPES 基准抓到 235 个线上 Bug 中的 76 个,是 Claude Code 的两倍

10 月 21 日,初创公司 Breken 发布同名产品,定位“生产工程”:在隔离环境里重建整套软件,以 4000 倍速长出生产数据,让带意图和耐心的合成用户与 Agent 去使用,并逐一改变重试、丢包、时钟跳变等条件找故障,复现稳定后给出状态、trace 和修复草稿 PR。同时公布开放基准 ESCAPES:33 个开源项目、327 个已上线后被用户报告的 Bug,按 7 月 1 日代码扫描一次,Breken 抓到 235 个中的 76 个(32%),Claude Code 跑 Claude Fable 5.1 抓到 37 个(16%)。数据为厂商自测。

Breken 发布“生产前的生产环境”:让合成用户和 Agent 跑真实软件找 Bug,自家 ESCAPES 基准抓到 235 个线上 Bug 中的 76 个,是 Claude Code 的两倍

核心要点速览

  • ESCAPES 基准(厂商口径):33 个开源项目、327 个真实用户报告的 Bug,按 2026-07-01 代码扫描一次,计分对象为当时已存在的 235 个
  • 抓到数:Breken 76(32%,61 个跑出复现证明)、Claude Fable 5.1 + Claude Code 37(16%)、Claude Opus 5.5 + Claude Code 33(14%)、GPT-6 Astra + Codex CLI 28(12%)、Semgrep 9(4%)
  • 误报:Breken 20 个,Claude Fable 5.1 为 59 个,GPT-6 Astra 为 86 个;精度 85% 对 46%,加权分 +23.8% 对 -9.4%
  • 71% 的这类 Bug 只有在产品跑起来、配合真实数据、多用户、外部故障或时间流逝时才出现,中位数在代码里潜伏 152 天
  • 计费为预充值用量,最低 25 美元,提供 50/100/250 美元档,需用 GitHub 登录选择仓库
阅读全文

Artificial Analysis 发布 AA-Robotics v0.1:让编码智能体直接操控机械臂,GPT-6 Astra 以 69.4 分居首

独立评测机构 Artificial Analysis 于 2026-10-14 发布 AA-Robotics v0.1 研究预览:在 Codex、Claude Code、Antigravity 等编码智能体框架中,让前沿大模型通过 HTTP API 直接控制一台 6 轴机械臂完成 8 项桌面任务。GPT-6 Astra 得分 69.4 居首,GPT-6.1 Sol 64.6、Gemini 4 Argon 55.3、Claude Opus 5.5 48.8、Claude Fable 5.1 46.3;模型平均每项约 30 分钟,人类约 20 秒。

Artificial Analysis 发布 AA-Robotics v0.1:让编码智能体直接操控机械臂,GPT-6 Astra 以 69.4 分居首

核心要点速览

  • 总分(满分 100):GPT-6 Astra 69.4、GPT-6.1 Sol 64.6、Gemini 4 Argon 55.3、Claude Opus 5.5 48.8、Claude Fable 5.1 46.3(AA 原文)
  • 速度:模型平均约 30 分钟/任务(Argon 最慢约 52 分钟),人类平均约 20 秒,差距接近两个数量级
  • 成本:GPT-6.1 Sol 平均 $1.93/任务最便宜,GPT-6 Astra $16.36/任务,约 70% 花费来自视觉上下文输入
  • 抓取成功率:GPT-6 Astra 45%、Claude Fable 5.1 44%、Opus 5.5 40%、Argon 36%、Sol 28%
  • 「测量箱子」任务(误差需 ≤2 mm)五个模型最高仅 17 分,精细测量仍是短板
阅读全文

Paper Instruments 发布 Ultramarine 1 Flash:GLM-5.3 Flash 上做非可验证 RL 的知识工作模型,自测单任务 $0.13、API 已开放、权重将开源

旧金山实验室 Paper Instruments 于 2026-10-15 00:02(新加坡时间)发布 Ultramarine 1 Flash:在开源底座 GLM-5.3 Flash 上用大规模「非可验证」强化学习(任务级 rubric 奖励)后训练,面向金融、法律、咨询、运营类知识工作。官方技术报告称其在 6 项知识工作基准上平均比底座高 4.1 分、输出 token 少 6.5%;在内部 PI Knowledge Work 套件上以 $0.13/任务得 59.3 分,高于 Claude Fable 5($8.19,57.8)。OpenAI 兼容 API(ultramarine-1-flash)已上线;CEO 称权重约两周内发布、后训练成本约 30 万美元。成本对比依赖其内部基准,尚无独立复现。

Paper Instruments 发布 Ultramarine 1 Flash:GLM-5.3 Flash 上做非可验证 RL 的知识工作模型,自测单任务 $0.13、API 已开放、权重将开源

核心要点速览

  • 底座 GLM-5.3 Flash + CISPO 变体 RL(LoRA rank 64,131K 上下文,最多 250 轮),6 项知识工作基准平均 +4.1 分、token 少 6.5%
  • JobBench 62.9(第 1,Gemini 3.8 Flash 60.6);FrontierFinance 53.3(第 1);APEX-Agents 1.1 为 57.0,落后 Gemini 3.8 Flash 64.3
  • 内部 PI Knowledge Work:59.3 分 / $0.13 每任务,对比 Claude Fable 5 57.8 / $8.19、GPT-6 Sol 61.3 / $1.26
  • 代价:编码能力略降,Terminal-Bench 2.1 83.2(底座 84.3)、DeepSWE 1.1 61.5(底座 63.4)
  • 训练数据:4 大领域、19 个业务方向、88 种合成环境类型,全部合成任务 + rubric 打分
阅读全文

“氛围编码”安全警钟长鸣!Last Secure Code 基准发布:前沿 Agent 仅 25.1% 生成代码同时兼顾功能与安全

随着 AI 编程智能体在“氛围编码”(Vibe Coding)热潮中广泛接管软件生产,生成代码的安全性成为行业焦点。新加坡国立大学与莫纳什大学等团队发布 Last Secure Code Benchmark,这是首个全面评估编程智能体安全代码生成能力的权威基准。涵盖 7 种主流编程语言、24 类 CWE(包括 2025 CWE Top 25 中的 21 类及 Top 10 KEV 中的 8 类)以及 450 项源于 150 个真实 CVE 漏洞的实战任务。评测揭示:前沿模型在功能测试上通过率达 73.6%~91.3%,但即使最强的 Claude Fable 5,在同时满足“功能可用且无安全漏洞”的严苛检验下通过率仅为 25.1%,其余主流 Agent 仅为 16.4%~24.7%。

“氛围编码”安全警钟长鸣!Last Secure Code 基准发布:前沿 Agent 仅 25.1% 生成代码同时兼顾功能与安全

核心要点速览

  • 首个氛围编码安全基准:基于 150 个真实 CVE 漏洞构建 450 项多语言任务,覆盖 2025 CWE Top 25 中的 21 类高危缺陷及 8 类 KEV 漏洞
  • 功能可用假象与安全断层:前沿 Agent 的功能通过率高达 73.6%~91.3%,但兼顾功能与安全性的双合格率仅为 16.4%~25.1%
  • 全流程漏洞场景堪忧:在完整的全仓库或跨文件工程场景中,最强模型仅能抵御 12% 的漏洞风险,凸显自动化安全扫描门禁的极端紧迫性
阅读全文

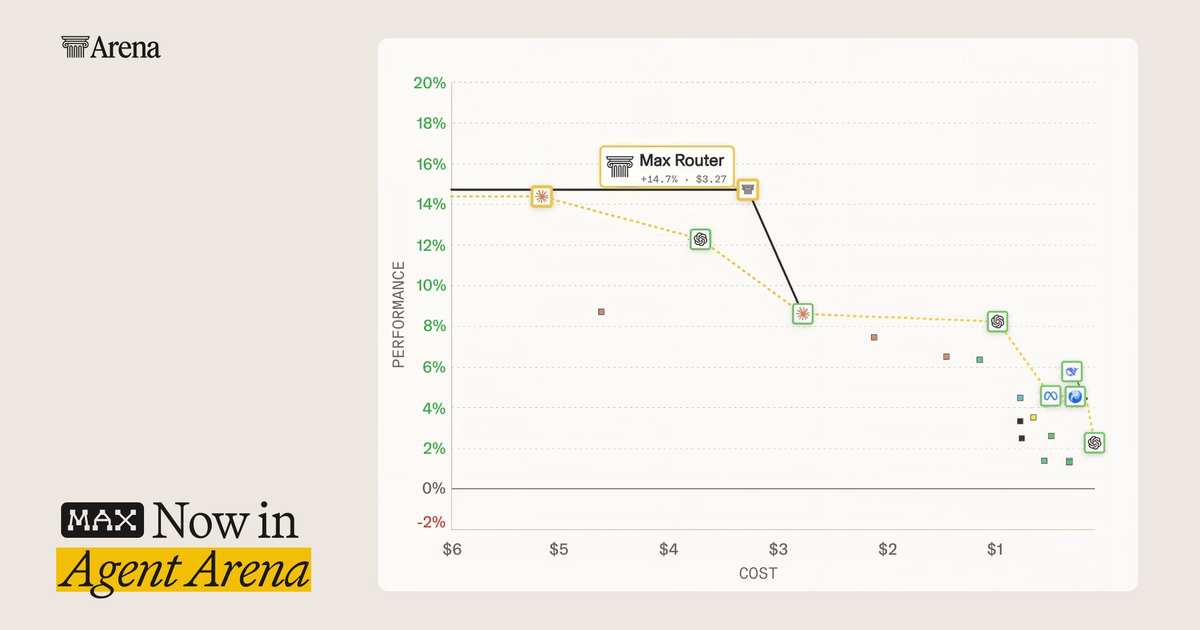
Arena 发布 Agent 版 Max 路由器:基于 250 万真实会话训练,在 Agent Arena 以低 37.5% 的成本追平 Fable 5.1 (Max)

Arena(原 LMArena)发布 Agent 版 Max 路由器:基于 250 万+ 次真实 Agent Arena 会话训练,按任务复杂度、类型与成本在 Fable 5.1 (Max)、Astra (Max) 与 Astra (Medium) 间动态选模型。实测中它以 +14.7% 得分登顶 Agent Arena,单任务中位成本 3.27 美元,比当时第一的 Fable 5.1 (Max) 高 0.3% 且便宜 37.5%;代码会话 67% 被路由到更便宜的 Astra (Medium)。现可在 Agent Mode 限时免费试用,API 需填表申请。

Arena 发布 Agent 版 Max 路由器:基于 250 万真实会话训练,在 Agent Arena 以低 37.5% 的成本追平 Fable 5.1 (Max)

核心要点速览

  • 训练数据:250 万+ 次真实 Agent Arena 会话;过去 4 个月 Arena 共测试 60+ 个 Agent 模型(官方博客)
  • 实测成绩:Agent Arena 第 1,得分 +14.7%,单任务中位成本 3.27 美元;比 Fable 5.1 (Max) 高 0.3%,成本低 37.5%
  • 路由分布:代码 67% → Astra (Medium);聊天 Astra (Max) 49% / Fable 5.1 (Max) 42%;工作类 Fable 5.1 (Max) 49% / Astra (Medium) 43%
  • 可换模型组合:此前 Fable 5 + Kimi K3 组合净提升 +10.7%,中位成本 1.06 美元,比 Fable 5 (High) 高 0.6 个百分点、成本低 54%
  • 限制:训练数据截至 9 月 17 日,未覆盖 Opus 5.5;目前只能在 Agent Mode 试用,API 需申请
阅读全文
AD赞助内容

Claude Code 2.1.287:正式落地 Mods 进程内扩展;内置 You should know 侧路监督;网关默认 1M 上下文

Anthropic 于 2026-10-01 发布 Claude Code 2.1.287(npm @anthropic-ai/[email protected])。Claude Mods 允许插件用进程内 JS/TS hooks 改写工具调用与界面;内置可选 You should know 侧路 agent;MCP URL elicitation;Opus 4.7+/Fable 在 Bedrock/Vertex/Foundry/apps gateway 默认 1M 上下文。Agent SDK TS 0.3.287 对齐。

Claude Code 2.1.287:正式落地 Mods 进程内扩展;内置 You should know 侧路监督;网关默认 1M 上下文

核心要点速览

  • 发版:v2.1.287;npm @anthropic-ai/[email protected];GitHub published_at≈2026-10-01T18:00:22Z
  • Mods:进程内 hooks 可绘制 pane、改写 tool.call/ui.render;需 ≥2.1.287,默认开启;文档 Mods overview
  • You should know:/plugin enable cc-plugin-you-should-know@builtin(first-party + telemetry);默认关闭
  • 上下文:Opus 4.7+/Fable 在 Bedrock/Vertex/Foundry/apps gateway 默认 1M;CLAUDE_CODE_DISABLE_1M_CONTEXT=1 回 200K
  • 生态:Agent SDK TS 0.3.287;MCP URL elicitation + bareElicitationCapability
阅读全文

Anthropic 推出 Claude Opus 5.5

Anthropic 宣布 Claude Opus 5.5 即日起可用。它是新 Claude 5.5 系列的首个模型,多数任务表现接近 Claude Fable 5.1,运行成本比 Opus 5 低 40%。

核心要点速览

  • Anthropic 宣布 Claude Opus 5.5 即日起可用。它是新 Claude 5.5 系列的首个模型,多数任务表现接近 Claude Fable 5.1,运行成本比 Opus 5 低 40%。
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 正式发布 Claude Opus 5.5:开启 5.5 世代,运行成本直降 40%、推理速度提升超 30%

Anthropic 宣布全新旗舰模型 Claude Opus 5.5 正式上线,作为 Claude 5.5 家族的首发成员。官方实测显示,Opus 5.5 在绝大部分复杂推理与 Agentic 编码任务中已达到前代旗舰 Claude Fable 5.1 水平,而在典型企业工况下的运行成本相比 Opus 5 降低了 40%,输出速度提升超 30%,API 价格定为输入 $4/M、输出 $20/M,提示词缓存读取仅 $0.20/M。

核心要点速览

  • Claude 5.5 世代首发旗舰,多项核心任务综合能力平齐 Claude Fable 5.1。
  • 单任务综合成本降低约 40%,输出吞吐速度提升超 30%,大幅改善长链路 Agent 响应延迟。
  • API 价格为 $4/M 输入、$20/M 输出,提示词缓存读取仅 $0.20/M,缓存写入 $5/M。
  • 在 Anthropic 自动化行为安全审计中取得历史最高分,强化敏感代码与网络防御过滤。
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 发布 Claude Opus 5.5:多数任务达 Fable 5.1 水平,典型负载成本约降 40%

Anthropic / Claude(@claudeai,@AnthropicAI 转发确认)宣布 Claude Opus 5.5 今日可用,为新 Claude 5.5 系列首个模型。官方称多数任务表现达到 Claude Fable 5.1 水平,相对 Opus 5 在 agentic coding、computer use 与知识工作上显著提升;默认设置下典型负载运行成本约低 40%。同步提高 Pro/Max/Team 五小时用量上限,并为订阅用户提供可留存的速率限制重置。

Anthropic 发布 Claude Opus 5.5:多数任务达 Fable 5.1 水平,典型负载成本约降 40%

核心要点速览

  • Claude 5.5 系列首发 Opus 5.5,今日可用;多数任务对齐 Claude Fable 5.1。
  • 相对 Opus 5 在 agentic coding、computer use 与知识工作上领先;默认典型负载成本约降 40%。
  • Pro/Max/Team 五小时用量上限上调,订阅用户获可留存的速率限制重置。
阅读全文

Anthropic 宣布 Claude Opus 5.5 今日上线

Anthropic(@AnthropicAI)确认 Claude Opus 5.5 今日可用;详见同日 @claudeai 发布主帖。该模型为 Claude 5.5 系列首发,多数任务达 Fable 5.1 水平,典型负载成本约比 Opus 5 低 40%。

Anthropic 宣布 Claude Opus 5.5 今日上线

核心要点速览

  • @AnthropicAI 确认 Opus 5.5 今日可用。
  • 为 Claude 5.5 系列首个模型,多数任务达 Fable 5.1。
  • 典型负载成本约比 Opus 5 低 40%。
阅读全文