AI 编程实时动态与要闻

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

Meta AI(@AIatMeta)于 11 月 5 日宣布,Connect 上预览的 Muse Realtime Avatar 开始在美国 Muse App 灰度:把 Muse Realtime Voice 变成可互动的实时形象。研究博客称系统为音频驱动的 Diffusion Transformer,与语音共享 speech token 流以同步口型与表情;单会话在 GB200 上可流式输出 448×768@25fps,用户话轮结束到音视频首字节约 870ms,并用 Meta Video Seal 做不可见水印。面向 18+ 用户;官方未公布全球时间表与开发者 API。

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

核心要点速览

  • 美国 Muse App 开始灰度 Realtime Avatar;Connect 时预览,现进入消费端(@AIatMeta)
  • 架构:语音 VQ token 同时驱动音频解码与 Avatar 视频;因果分块 + 自强制蒸馏,教师约 120 次评估压到学生 2 次(约 60×)
  • 性能口径:448×768@25fps,约 870ms 首包;单 GB200 相对 BF16 基线服务容量约 8×,可达 12 路并发(研究博客)
  • 主观评测:相对 Runway Characters、HeyGen LiveAvatar,评分者在整体与多数维度更偏好 Muse(厂商评测)
  • 安全:生成视频嵌入 Video Seal 不可见水印;示例不代表 App 内全部形象;无公开开发者 API
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark⚡ Muse Presence🤖 Muse🌐 Meta

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

2026-10-23(UTC 16:53,SGT 10-24 00:53),Block 官方账号 @blocks 发布 Dessa,Jack Dorsey 随后转发称其为「迄今最真实的全双工语音模型」。官方页面 block.xyz/dessa 介绍:Dessa 是真正的语音到语音模型,训练数据只有人类对话录音,不用文本、不用任何预训练模型;全双工,能边听边说,会自然插话和附和(“yeah!”“got it!”),推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行。官方称只用一套 NVIDIA GB200 NVL72 完成训练,学习语言所需的词量比 LLM 少数百倍。目前没有公开 API 或权重,只向一小批 AI 安全研究者开放早期访问。

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

核心要点速览

  • 训练数据只有人类对话语音:无文本、无预训练模型,从零训练(官方页面)
  • 全双工语音到语音:边听边说,会插话、附和,能直接听出并表达情绪、讽刺、笑声
  • 推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行
  • 官方称训练只用了一套 NVIDIA GB200 NVL72,学语言所需词量比 LLM 少数百倍
  • 暂无公开 API、权重或第三方跑分;目前只向少量 AI 安全研究者开放早期访问
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Dessa🌐 Block

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

在 DeepSeek 宣布开源其生产级推理引擎 DeepInfer 数小时后,vLLM 官方项目团队正式公布了针对 DeepSeek-V4.1-Flash 的实测重磅性能对标数据。采用 DeepSeek 官方完全相同的测试拓扑(131K 超长上下文、nextn=3 投机采样),vLLM 在 NVIDIA GB200 NVL 架构上针对 Batch Size 8~256 的全并发区间,将与 DeepInfer 的端到端吞吐差距压缩至 6% 以内;在下一代 GB300 架构上,单 GPU 吞吐量突破 1,000,000 Token/秒,单用户峰值输出达 826 Token/秒,折合单 GPU 每小时营收达 38.96 美元。同时宣布 FastH3-Omni 与 Spark-X2.6-4B 首发支持。

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

核心要点速览

  • vLLM 团队迅速公布实测对标数据,在 NVIDIA GB200 上运行 DeepSeek-V4.1-Flash 吞吐已追平至仅落后 DeepInfer 6%
  • 在下一代 NVIDIA GB300 硬件架构上,vLLM 实现单张 GPU 吞吐达 100 万 Token/秒,单用户峰值输出 826 Token/秒
  • 按 DeepSeek 线上非高峰期官方定价测算,单台 GPU 每小时可产生高达 38.96 美元的云端推理收益,经济效益惊人
  • 同步宣布对多模态视频大模型 FastH3-Omni 与拥有 100 万上下文的 4B 模型 Spark-X2.6-4B(Apache 2.0)提供 Day-0 首日原生支持
阅读全文
关联模型 / 智能体 / 厂商:

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

10 月 20 日,UCSD Hao AI Lab 的 FastVideo 团队开源 FastH3 Omni,这是 MiniMax H3 参考生成音视频(Ref2VA)模型的蒸馏版,可同时用文本、最多 9 张图、视频片段和人声参考生成带同步立体声的视频。采样从 50 步降到 8 次 transformer 计算,官方在 8 张 GB200 上测得端到端延迟降低 5.6–11.9 倍,训练代码一并开源,并提供面向 DGX Spark、RTX 5090 的 NVFP4 权重和 ComfyUI 支持。

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

核心要点速览

  • 步数:8 次 transformer 计算,基座 MiniMax H3 为 50 步,采用 PDD + DMD 蒸馏
  • 速度(官方口径):27 组对照负载、8×GB200,端到端延迟降低 5.6–11.9 倍;例如 15 秒单图请求 139.69 秒降到 14.14 秒
  • 输入:最多 9 张图、3 段视频、3 段音频,合计不超过 12 个参考;输出 24 FPS 视频 + 32kHz 立体声
  • 本地运行:DGX Spark(128GB)和 RTX 5090(32GB)用 NVFP4 QAD 权重,默认 480p;RTX 4090 可用 FP8 版
  • 许可:沿用 MiniMax-H3 Community License,不是 Apache/MIT
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Meta 首次详解训练 Muse Wonder 的吉瓦级超算 Prometheus:预训练有效算力 85%+、RL 90%+,目标扩到约 100 万块 GPU

Meta 工程博客 10 月 19 日发文,首次公开训练 Muse 系列(含 Muse Wonder)的俄亥俄州 New Albany 超算集群 Prometheus。一期已建成,目前有数十万块 GPU,满配目标约 100 万块。训练 Muse Wonder 时预训练 goodput(有效训练时间占比)超过 85%、强化学习超过 90%,平均无中断时间约 4.7 万 GPU 小时,之后经固件修复提升到 5.4 万以上。硬件为 GB200 NVL72 和 GB300 NVL72 两代平台,Vera Rubin NVL72 即将到位。

Meta 首次详解训练 Muse Wonder 的吉瓦级超算 Prometheus:预训练有效算力 85%+、RL 90%+,目标扩到约 100 万块 GPU

核心要点速览

  • 规模:一期已用于训练 Muse 系列,现有数十万块 GPU,满配约 100 万块,跨多栋建筑当作一台机器运行。
  • 稳定性:Muse Wonder 预训练 goodput 超 85%、RL 超 90%;平均无中断时间约 4.7 万 GPU 小时,现已超 5.4 万。
  • 中断率:2025 年年中峰值接近每 8K GPU 每天约 1000 次中断,一年工程后下降 99%。
  • 冗余设计:每个 NVL72 机柜只用 64 块 GPU、留 8 块热备,另备约 2% 机柜;3.2768 万卡任务需 523 个机柜共 37,656 块 GPU,约多 13%。
  • 网络:单栋楼 fabric 最多连 20,736 块 GPU,跨楼聚合网络覆盖 2 公里到 100 多公里。
阅读全文
关联模型 / 智能体 / 厂商:

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

半导体分析机构 SemiAnalysis 发布最新评测:Inferact(vLLM 核心团队)联合 Google 正式提交了首份基于 Google TPUv7 的 Kimi K3 2.8T 巨型 MoE 模型推理基准。在单芯片时租仅 1.21 美元(相比 GB300 2.31 美元、B300 2.26 美元、GB200 1.86 美元)下,借助 TorchTPU vLLM 大核与 TPU-Sync KVCache 卸载库,TPUv7 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X。

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

核心要点速览

  • Inferact(vLLM 核心团队)联合 Google 提交首份 Google TPUv7 Kimi K3 2.8T 巨型 MoE 推理基准
  • TPUv7 单芯片时租仅 1.21 美元,显著低于 GB300(2.31 美元)、B300(2.26 美元)与 GB200(1.86 美元)
  • 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X
  • 基于 TorchTPU vLLM 大核与 TPU-Sync KVCache 库,标志着 vLLM 在 Google TPU 架构上取得生产级重大突破
阅读全文
关联模型 / 智能体 / 厂商:

微软 MAI-Base-2 完成预训练:2.8T 总参 / 80B 激活 MoE,1.6 万张 GB200 跑 38 天,官方称预训练算力效率为 DeepSeek-V4-Pro-Base 的 4.2–12.3 倍

Microsoft AI 于 2026-10-15 发布技术博客与 PDF,宣布完成自研基座 MAI-Base-2 的预训练:每层 MoE(1 个共享 + 512 选 7 路由专家),80B 激活 / 2.8T 总参,102 层,原生无编码器视觉,50T token 训练混合、知识截止 2026 年 3 月。官方口径:在自建/外包的留出集 BPB 上低于所有参测开源模型,预训练 FLOPs 效率为 DeepSeek-V4-Pro-Base 的 4.2–12.3 倍。模型仍在后训练中,暂无 API、权重或发布日期,微软计划经 Foundry 向受信伙伴授权权重。

微软 MAI-Base-2 完成预训练:2.8T 总参 / 80B 激活 MoE,1.6 万张 GB200 跑 38 天,官方称预训练算力效率为 DeepSeek-V4-Pro-Base 的 4.2–12.3 倍

核心要点速览

  • 规模:80B 激活 / 2.8T 总参,102 层、隐藏维 8704,每层都是 MoE(1 共享 + 512 选 7);MAI-Base-1 为 35B / 1T、78 层、稠密与 MoE 交替(技术 PDF)
  • 算力:16k 张 GB200、2026 年 8–9 月共 38 天,平均 MFU 21%(按 BF16 2.5 PFLOPS 归一)、goodput 89%;Muon 优化器步仅占迭代时间 2.1%(165 ms)
  • 效率(厂商口径,基于缩放律估算):达到 DeepSeek-V4-Pro-Base 同等 BPB 所需 FLOPs 少 4.2–12.3 倍;相对 6 月的 MAI-Base-1 配方提升 6.3–12.7 倍
  • 数据:50T token 训练混合,VLM 数据占 18%(4.5T 唯一 token),唯一 token 比 Base-1 多约 36%,宣称全部为有机数据、不蒸馏其他模型
  • 可用性:仍在后训练,无公开 API/权重/日期;计划经 Microsoft Foundry 向受信伙伴授权权重,MAI-Base-3 已在筹备(官方博客)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI-Base-2⚡ MAI-Base-1⚡ MAI-Thinking-1⚡ DeepSeek-V4-Pro-Base⚡ Kimi K3⚡ Qwen3.8-2.4T-A95B🌐 Microsoft🌐 NVIDIA🌐 DeepSeek

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

vLLM 团队联合 Inferact、Red Hat 与 NVIDIA 于 10 月 9 日发布 Rubin 早期支持:基于 CUDA 13.4 的每日镜像已可在 Vera Rubin NVL72 上服务 DeepSeek、Kimi、GLM、MiniMax。官方口径下,SemiAnalysis AgentX 上 MiniMax M3 同等交互性单卡吞吐最高为 GB200 的 7.84 倍;MLPerf Inference v6.1 的 VLM 项上 Qwen3-VL-235B-A22B 相对 GB300 NVL72 最高 3.7 倍。

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

核心要点速览

  • 硬件对比 GB200 NVL72:NVFP4 算力 5 倍、HBM4 带宽约 2.4 倍、NVLink 双向带宽 1.7 倍,softmax 指数运算快 2–4 倍(vLLM 博文)
  • AgentX + MiniMax M3:同等交互性单卡吞吐最高 7.84 倍,150 TPS 约束下 5.18 倍(官方口径,早期结果)
  • MLPerf Inference v6.1:Qwen3-VL-235B-A22B 经 vLLM + Dynamo,相对 GB300 NVL72 最高 3.7 倍
  • CUDA 13.4 locality domain 拆分 MoE 权重,小 token decode 场景 MoE 层平均提速约 1.2 倍
  • 开箱镜像:vllm/vllm-openai:cu134-nightly(CUDA 13.4 + PyTorch 2.15)
阅读全文

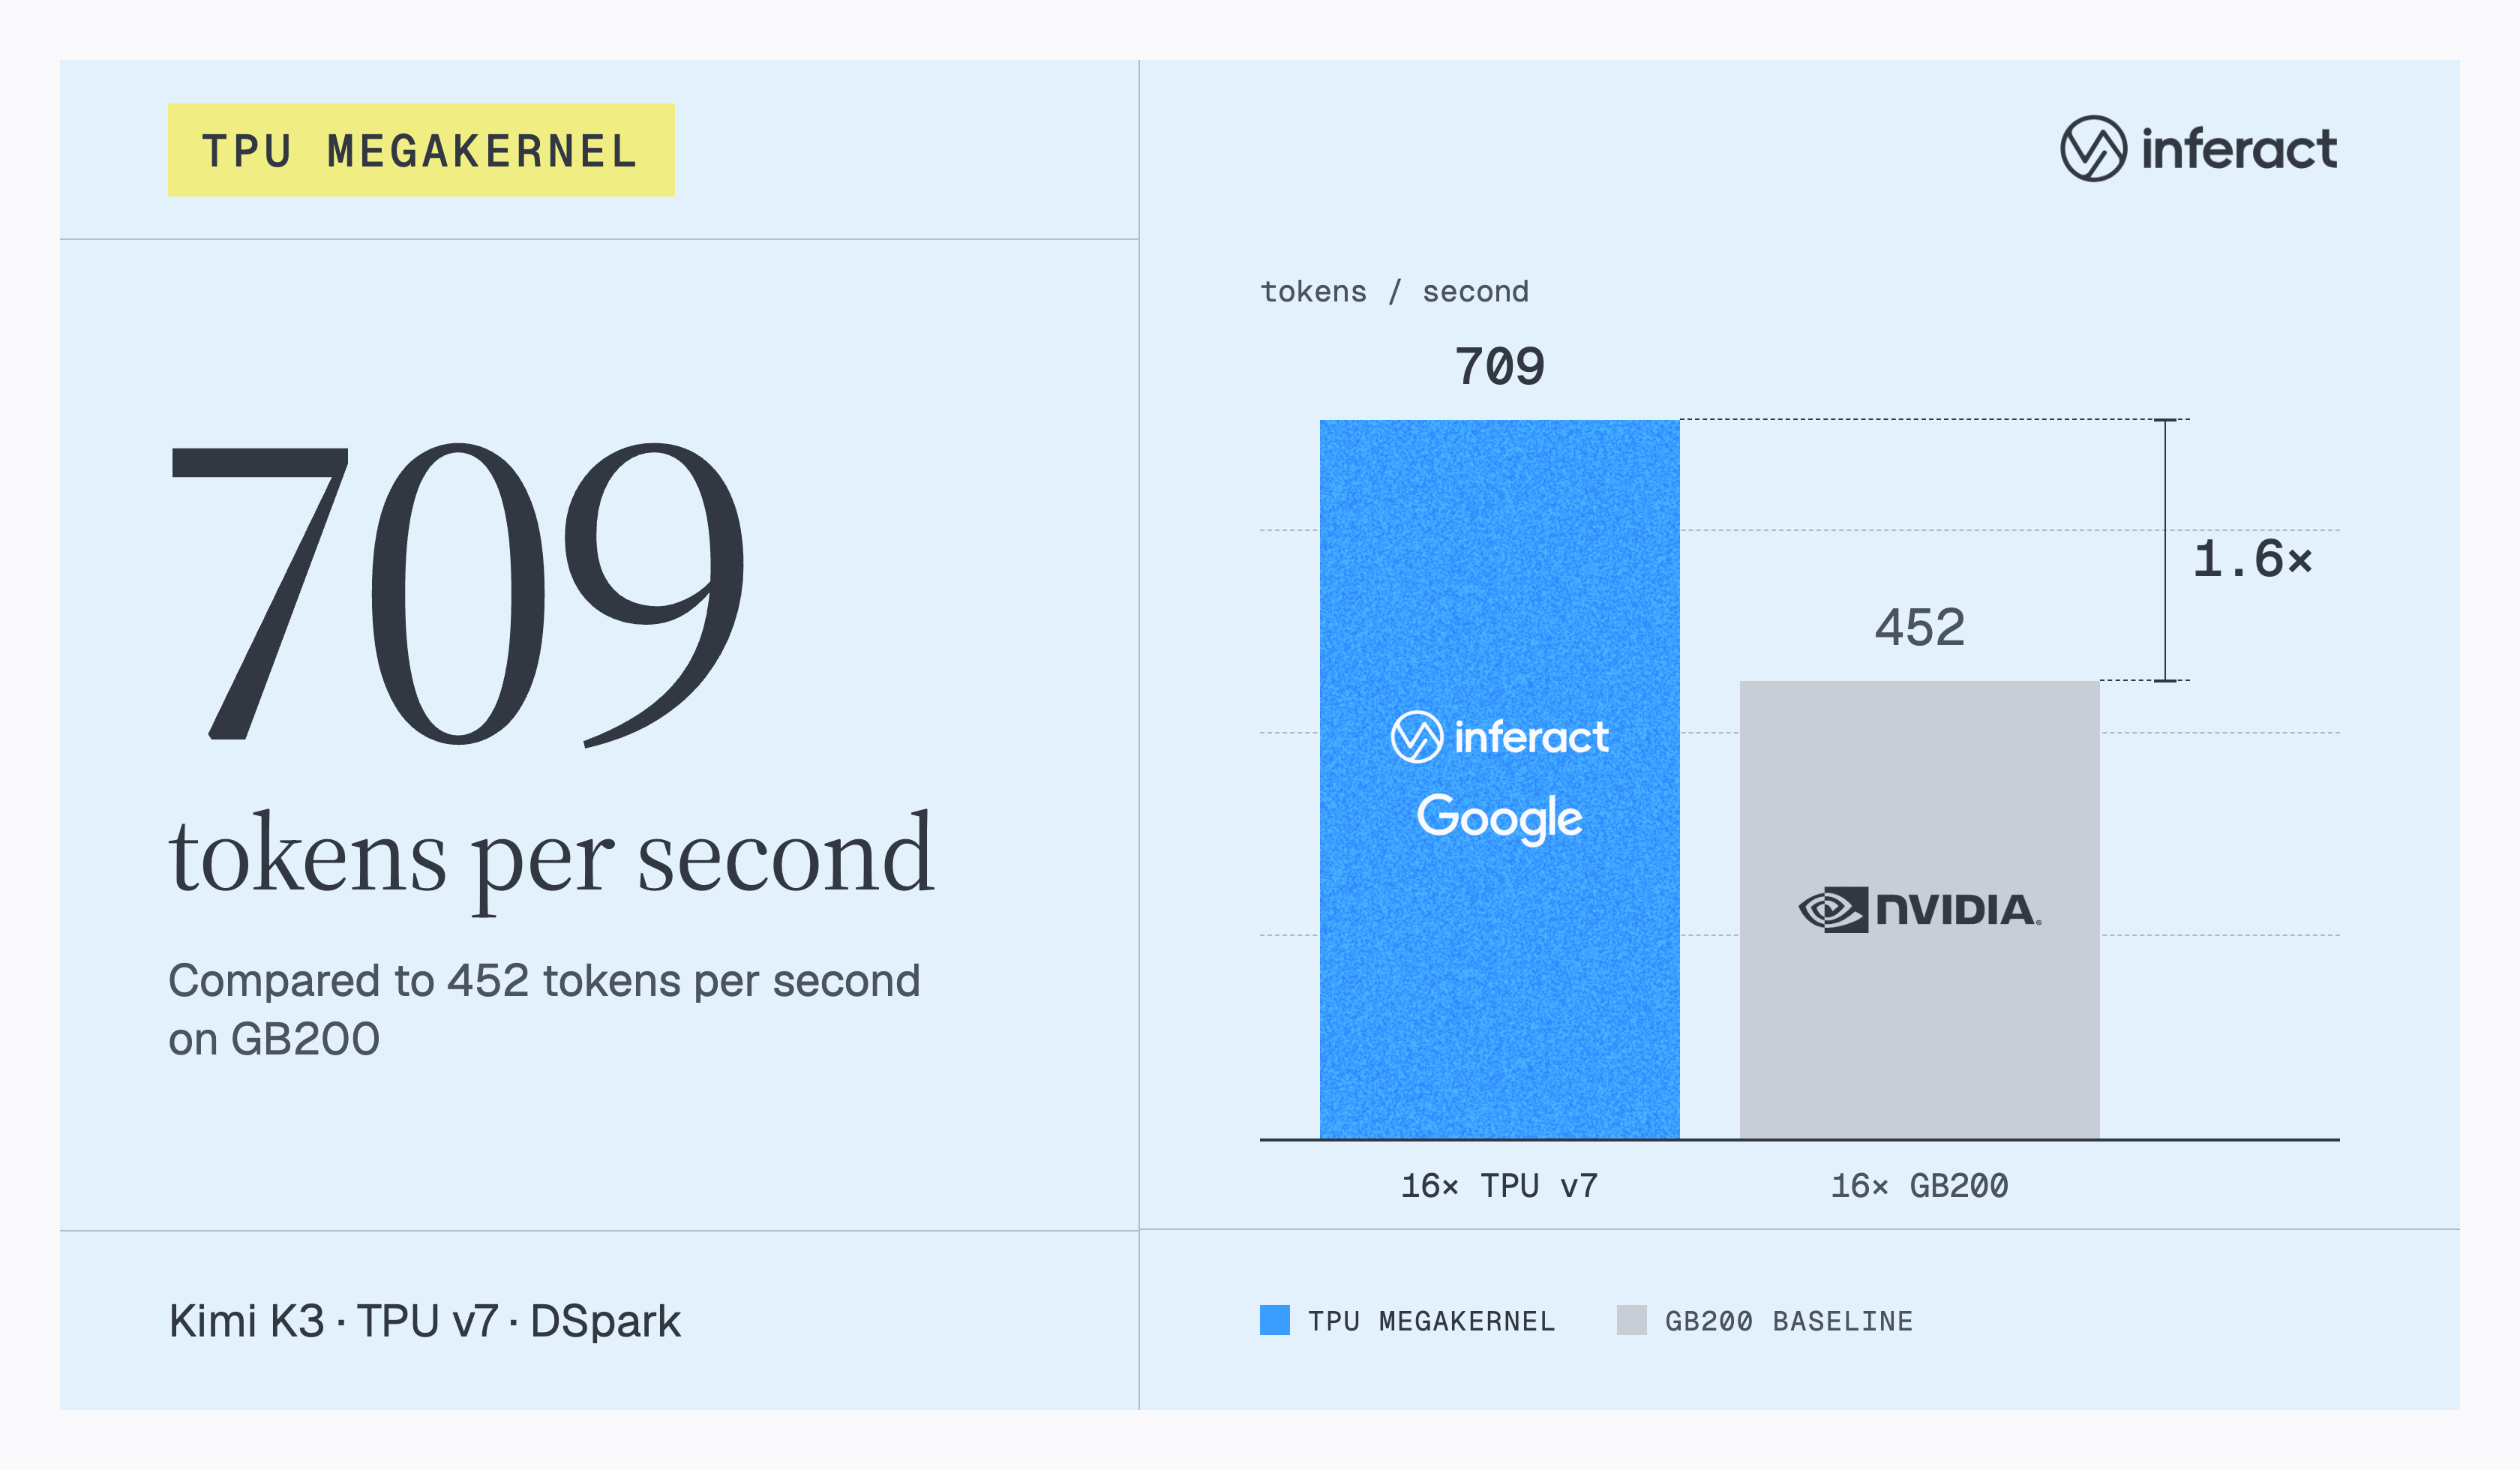
Inferact 开源 TPU Megakernel:Kimi K3 在 16×TPU v7 上跑出 709 tok/s,低并发反超 GB200

Inferact(vLLM 核心团队衍生公司)于 2026-09-23 发布并开源面向 TPU v7 的推理巨内核仓库 inferact/tpu-megakernels。官方博客显示,在 DSpark 推测解码(acceptance length=6)的低并发设定下,Kimi K3 在 16×TPU v7 Ironwood 上达到 709 tok/s,对照 16×GB200 基线 452 tok/s;关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×。整套 Kimi K3 的 92 层 MoE 解码被收敛进单一 Pallas 内核。

Inferact 开源 TPU Megakernel:Kimi K3 在 16×TPU v7 上跑出 709 tok/s,低并发反超 GB200

核心要点速览

  • 官方数字(Inferact 自测,非第三方复现):Kimi K3 + DSpark 在 16×TPU v7 上 709 tok/s,对照 16×GB200 452 tok/s(acceptance length=6)
  • 关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×;Qwen 3.8 27B 在 4×TPU v7 上报 1,515 tok/s vs 4×GB200 695 tok/s(含推测解码)
  • 架构要点:92 层 MoE 装进 单一 Pallas 巨核,跨层 weight prefetch,吃满 TPU 大容量 VMEM
  • 开源仓库:Inferact/tpu-megakernels(Apache-2.0),配套深度文:700 TPS on Kimi K3
阅读全文
关联模型 / 智能体 / 厂商:

LightSeek 开源 Kimi K3 三件套草稿模型:EAGLE-3 / DFlash2 / DSpark,配合 TorchSpec 与 vLLM

LightSeek Foundation 发布面向 Kimi K3 的草稿模型合集(EAGLE-3、DFlash2、DSpark),在 40 张 NVIDIA GB200 上用 TorchSpec 解耦训练,并公开数据配方。博客给出 10 项基准的接受长度与 SPEED-Bench 端到端吞吐;DFlash2 平均接受长度约 4.02,低并发吞吐优于 EAGLE-3。

核心要点速览

  • 三款草稿架构齐发:EAGLE-3、DFlash2、DSpark,面向 Kimi K3 投机解码加速。
  • 40×GB200 + TorchSpec 解耦训练;公开 kimi-mtp-dataset 配方与 Docker/CI。
  • HumanEval 等编码基准上 DFlash2 接受长度约 5.08,显著高于 EAGLE-3 的 3.29。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容