
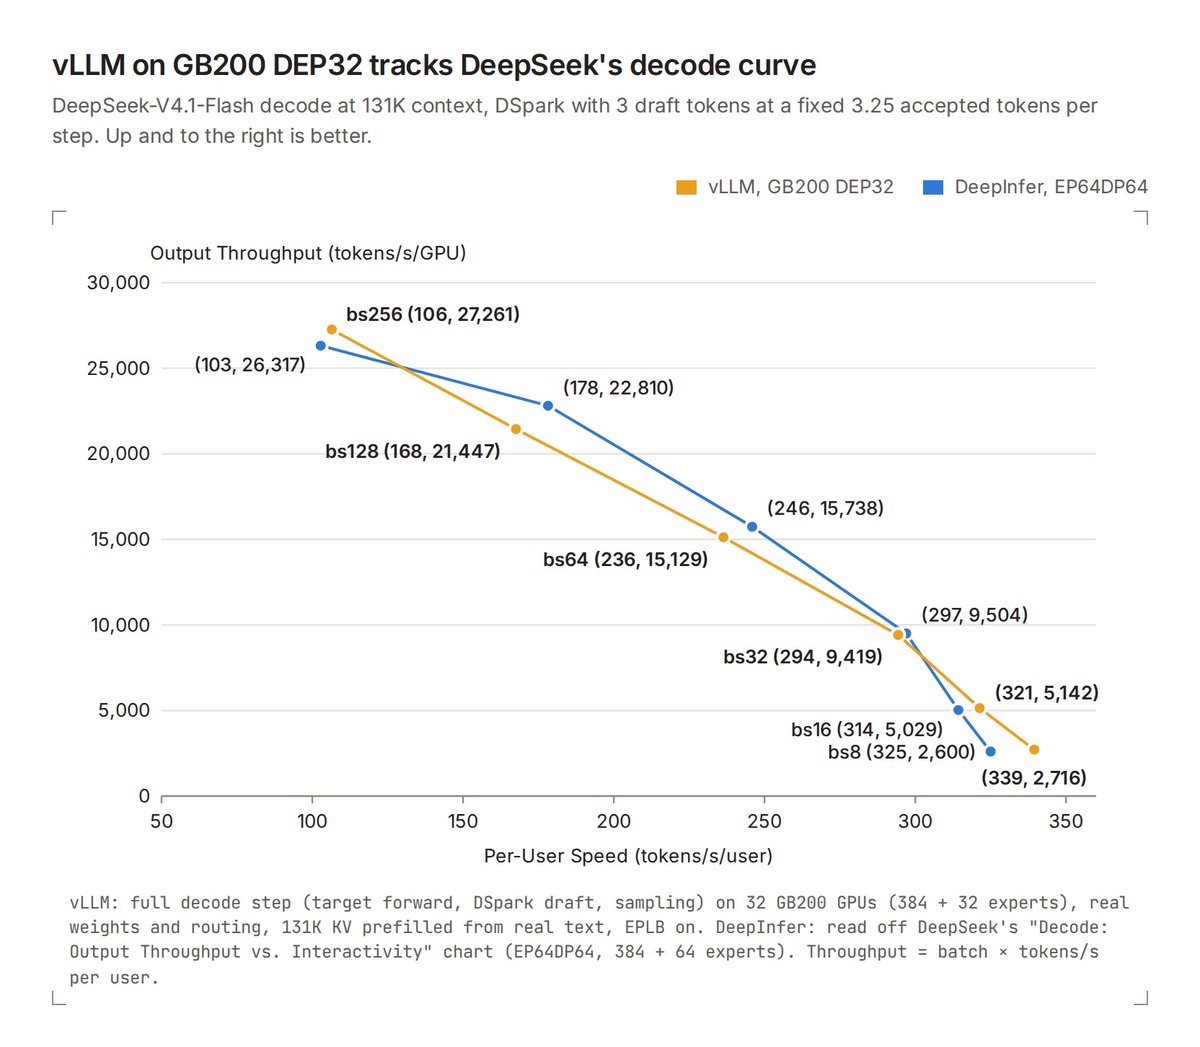
在 DeepSeek 宣布开源其生产级推理引擎 DeepInfer 数小时后,vLLM 官方项目团队正式公布了针对 DeepSeek-V4.1-Flash 的实测重磅性能对标数据。采用 DeepSeek 官方完全相同的测试拓扑(131K 超长上下文、nextn=3 投机采样),vLLM 在 NVIDIA GB200 NVL 架构上针对 Batch Size 8~256 的全并发区间,将与 DeepInfer 的端到端吞吐差距压缩至 6% 以内;在下一代 GB300 架构上,单 GPU 吞吐量突破 1,000,000 Token/秒,单用户峰值输出达 826 Token/秒,折合单 GPU 每小时营收达 38.96 美元。同时宣布 FastH3-Omni 与 Spark-X2.6-4B 首发支持。
核心要点速览
- ✓vLLM 团队迅速公布实测对标数据,在 NVIDIA GB200 上运行 DeepSeek-V4.1-Flash 吞吐已追平至仅落后 DeepInfer 6%
- ✓在下一代 NVIDIA GB300 硬件架构上,vLLM 实现单张 GPU 吞吐达 100 万 Token/秒,单用户峰值输出 826 Token/秒
- ✓按 DeepSeek 线上非高峰期官方定价测算,单台 GPU 每小时可产生高达 38.96 美元的云端推理收益,经济效益惊人
- ✓同步宣布对多模态视频大模型 FastH3-Omni 与拥有 100 万上下文的 4B 模型 Spark-X2.6-4B(Apache 2.0)提供 Day-0 首日原生支持
开发者 3 秒速决决策指标
本地显存不够?先比较云端 API 与自部署的实际成本
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
深度技术解析与实战评估
核心背景与行业痛点
当 DeepSeek-V4.1-Flash 成为全球高并发推理和 Coding Agent 的核心底座时,大模型厂商自研的高性能专用 Runtime(如 DeepInfer)与开源通用推理框架(如 vLLM、SGLang)之间的性能代差引发了业界的广泛焦虑。此前社区普遍担忧,专用框架借助私有硬件算子与定制调度,会将通用开源框架甩开 30%~50% 的吞吐差距,从而迫使企业只能使用绑定特定硬件的专用烟囱式引擎。为了回应这一挑战,vLLM 核心团队在 2026 年 10 月 21 日凌晨(Status #2112703311933747347)发布了全面追平 DeepInfer 的权威实测数据。
架构亮点与底层机制
- 严格对齐官方生产级拓扑与参数:
- 采用与 DeepSeek-V4.1-Flash 生产服务完全相同的配置:包含 131,072(131K)超长上下文窗口以及
nextn=3的投机采样(Speculative Decoding)策略;
- GB200 / GB300 NVLink 拓扑算子深度重组:
- 充分吸收 DeepInfer 与 SGLang 的前沿通信思想,在 NVIDIA GB200 与 GB300 的跨卡高速互联拓扑上,重构了多头潜在注意力(MLA)解包与 MoE 专家路由内核;
- 深度重叠全对全(All-to-All)集合通信与 GEMM 计算,消除了异构批处理调度下的通信气泡;
- 多模态与长程模型 Day-0 闪电适配:
- 同步推出对前沿视频生成模型 FastH3-Omni 与拥有 100 万 Token 上下文能力的轻量开源模型 Spark-X2.6-4B 的第一日零时差支持。
权威 Benchmark 与实测跑分对比
官方发布在 GB200 与 GB300 上的详尽对比数据(Status #2112703311933747347 配图):
- GB200 生产并发吞吐对比:
- 在常用生产并发区间(Batch Size 从 8 到 256),vLLM 的端到端 Token 吞吐量与 DeepSeek 专用 DeepInfer 的差距压缩至 6% 以内;
- 证明经过深度优化的通用开源框架完全能够承担最严苛的生产级 SLA 要求;
- GB300 极限性能释放:
- 单张 GPU 吞吐量突破 1,000,000 Tokens/s(百万 Token/秒);
- 面向单个客户端用户的峰值生成速度飙升至 826 Tokens/s,使得秒级输出万行代码成为现实;
- 商业化经济模型验证:
- 按照 DeepSeek 官方目前公布的非高峰期折扣定价折算,单张 GPU 每小时可产生 38.96 美元的净服务收入,为全球 AI Infra 云厂商提供了极佳的资本回报率模型。
开发者实战落地与开箱指南
- 官方公告与性能白皮书:详见
@vllm_project官方推文https://x.com/vllm_project/status/2112703311933747347; - 版本更新指引:开发者拉取最新版 vLLM 主干分支,即可直接调用针对 DeepSeek-V4.1-Flash 的高性能 MLA/MoE 融合算子;
- 企业部署选型建议:拥有自建 GPU 集群的企业无需推倒重来迁移到专有推理栈,继续采用开放、跨硬件且拥有最大生态支持的 vLLM 即可获得与自研引擎几乎无异的顶级吞吐。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察