AI 编程实时动态与要闻

webAI 开源 TwIL-8B:8.8B 推理小模型,LiveCodeBench 81.6、MATH-500 98.2,非商用许可

webAI CEO David Stout 于 11 月 4 日(UTC 17:37)在 X 上宣布开源 TwIL-8B。官方 Hugging Face 模型卡显示:它基于 IBM Granite 4.2 8B,经全参数 SFT、GRPO/DAPO 强化学习和长度感知 RL 训练,分 balanced 与 verbose 两个版本;自报 LiveCodeBench 81.6(verbose)、MATH-500 98.2、IFBench 74.4,约为前沿模型 93%/92% 的水平,但 GPQA Diamond 仅 70.2。提供 4.98 GiB 的 Q4_K_M GGUF,可在本地运行;许可为 webAI 非商用协议。

webAI 开源 TwIL-8B:8.8B 推理小模型,LiveCodeBench 81.6、MATH-500 98.2,非商用许可

核心要点速览

  • TwIL-8B 共 8.79B 参数,基于 IBM ibm-granite/granite-4.2-8b,上下文 131,072 tokens,仅英文、文本到文本。
  • 自报成绩:MATH-500 98.2、AIME 2025 88.3、LiveCodeBench 81.6(verbose)、IFBench 74.4(verbose);GPQA Diamond 70.2 明显落后 Qwen3.5-9B(81.7)。
  • balanced 版在 AIME 2026 平均每题约 19.5k 输出 tokens,比 Qwen3.5-9B 的 31.2k 少约 38%,但仍约为 GPT-5.5 的 4 倍。
  • 所有分数为 webAI 内部测评,竞品分数直接引用公开数据、未重跑;未测 SWE-bench、工具调用和 Agent 任务。
  • 许可为 webAI Non-Commercial License 1.0,不能直接商用;GGUF Q4_K_M 约 4.98 GiB,可用 llama.cpp 本地运行。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ TwIL-8B⚡ Granite 4.2 8B⚡ Qwen3.5-9B⚡ Gemma 4 31B🌐 webAI🌐 IBM

腾讯混元开源同声传译模型 Hy-SimulMT:中英双向实时语音翻译,延迟约 3 秒并支持实时音色克隆

腾讯混元(Tencent Hy)10 月 26 日开源实时同声传译模型 Hy-SimulMT,支持中英双向语音到语音翻译,边听边译,同时输出译文文本和语音,并可实时克隆说话人音色。Hugging Face 上一次放出 6 个权重(30B-A3B 的纯译文版与带原文的 Interleave 版,各含 BF16、FP8、GGUF),模型卡标注 Apache-2.0;GitHub 同步提供 SimulInfer 推理服务与 SimulTrain 训练工具。官方口径:RealSI 长音频评测 StreamLAAL 约 3 秒,为对比系统最低。

腾讯混元开源同声传译模型 Hy-SimulMT:中英双向实时语音翻译,延迟约 3 秒并支持实时音色克隆

核心要点速览

  • 规模与形态:30B-A3B MoE(约 3B 激活),共 6 个权重:纯译文版与 Interleave(原文+译文)版,各有 BF16、FP8、GGUF(Hugging Face 合集)
  • 延迟(官方/厂商口径):RealSI 长音频评测 StreamLAAL 约 3 秒,为对比系统中最低,GEMBA 质量分超过对比的开源模型和 5 个商业 API 中的 4 个
  • 短音频(官方/厂商口径):FLEURS 90.3、CoVoST2 75.5、ACL6060 81.2、RealSI-Sentence 84.7,后者为表中所有系统最高;同表 Qwen3.8-LiveTranslate 为 88.4/82.1/80.5/84.4
  • 真人对比:18 段约 6 分钟的真实中英音频,对比 6 名 CATTI 一级/二级口译员,官方称质量相当、延迟常更低,并注明仅适用于该小规模测试
  • 部署:SimulInfer 一条 deploy.sh 命令拉起 vLLM(需 >=0.31)与 Web/WebSocket 服务,语音输出和音色克隆需另配 TTS;llama.cpp 支持尚未合入上游(SimulInfer 文档)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Hy-SimulMT-30B-A3B⚡ Hy-SimulMT-30B-A3B-Interleave⚡ Qwen3.8-LiveTranslate🌐 Tencent

Ornith-1.5-122B 开源重磅登场:单机 DGX 即可部署的 122B MoE 推理模型,SWE-bench Pro 斩获 76.9 分

开源 AI 实验室 Ornith 团队正式发布 Ornith-1.5-122B 混合专家推理模型,并在 MIT 宽松协议下完全开源。该模型专门面向单节点 GPU 服务器(如单台 DGX)设计,提供包括 FP8、GGUF 与 MLX 在内的全套量化版本,已同步上架 Ollama(ornith-1.5:122b)与 vLLM/SGLang 运行时。在权威基准评测中,Ornith-1.5-122B 展现出媲美超大规模闭源模型的编程与智能体能力:在 OpenHands 评测框架下,SWE-bench Verified 达到 84.5 分,SWE-bench Pro 斩获 76.9 分(相较 Qwen3.8-Flash-Next 的 43.9 分取得跨越式领先),TerminalBench 达 81.2 分,MCP-Atlas 达到 74.6 分。

Ornith-1.5-122B 开源重磅登场:单机 DGX 即可部署的 122B MoE 推理模型,SWE-bench Pro 斩获 76.9 分

核心要点速览

  • Ornith-1.5-122B 正式发布并遵循极为宽松的 MIT 许可证,打破大参数量高性能编程推理模型闭源垄断
  • 专为单台 DGX 等单节点多卡服务器量身定制,已无缝接入 vLLM、SGLang 与 Ollama(ornith-1.5:122b),提供完整 FP8/GGUF/MLX 支持
  • 在真实软件工程评测集 SWE-bench Pro 斩获 76.9 分,相比同体量开源标杆 Qwen3.8-Flash-Next(43.9 分)大幅提升 33 分
  • 全方位通过 TerminalBench 2.1(81.2 分)、CyberGym(80.0 分)与 MCP-Atlas(74.6 分)测试,树立端到端 Coding Agent 开源新旗舰
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ornith-1.5-122B⚡ Qwen3.8-Flash-Next🤖 OpenHands🌐 Ornith

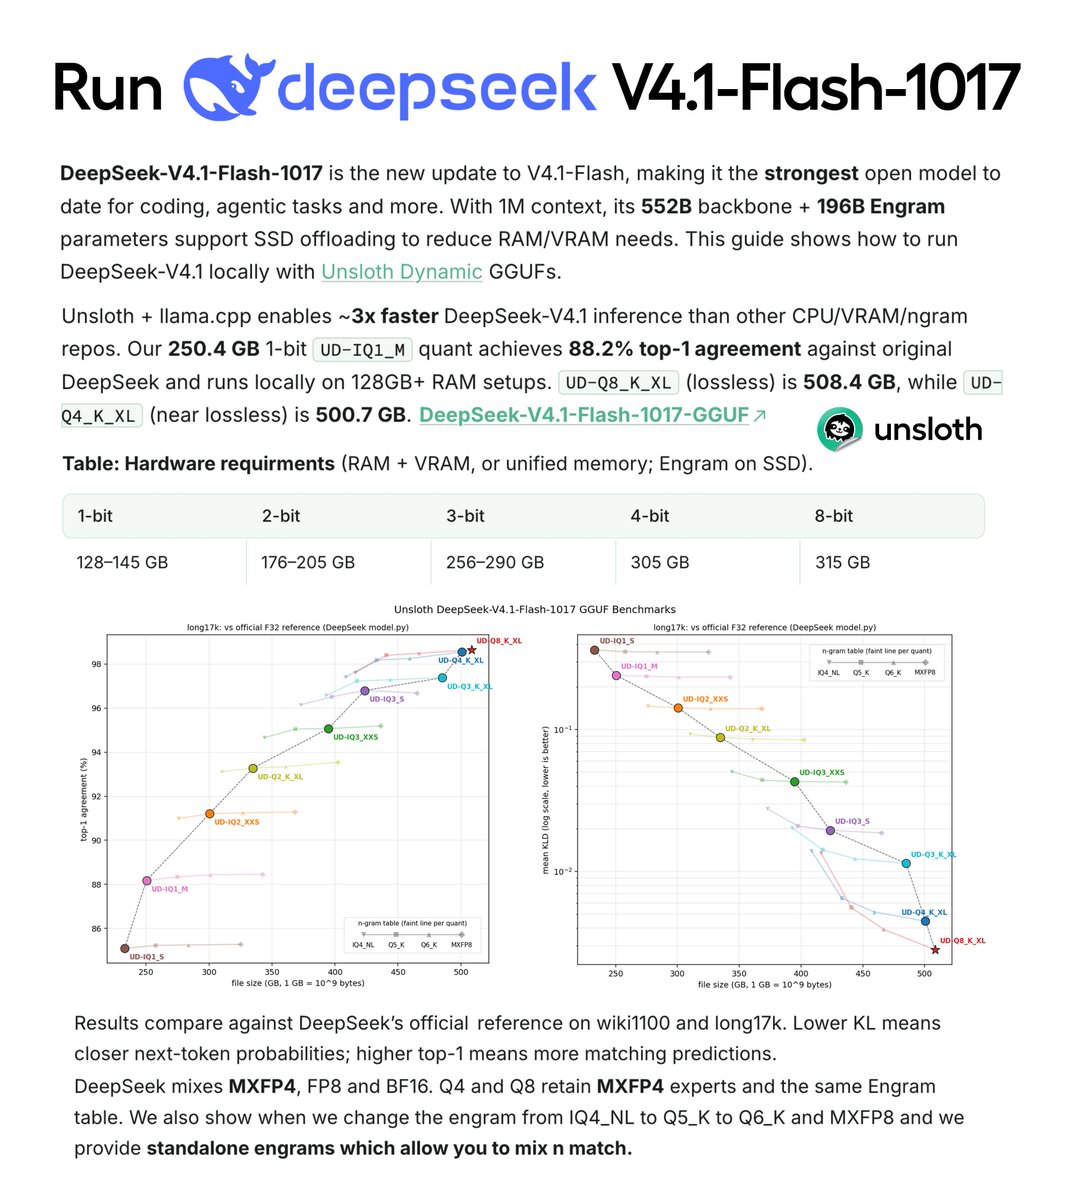
Unsloth 发布 DeepSeek-V4.1-Flash-1017 动态 GGUF:1-bit 版 250GB、128GB+ 内存可本地跑,Engram 表可放 SSD

Unsloth 于 10 月 19 日(UTC)发布 DeepSeek-V4.1-Flash-1017 的动态 GGUF 量化与本地运行指南。按 Unsloth 口径,1-bit UD-IQ1_M 体积 250.4GB(无损 Q8 为 508.4GB),在 long17k 上与官方权重 top-1 一致率 88.2%,可在 128GB+ 内存设备上运行;模型的 Engram n-gram 表(110.6–202.8GB)可通过 mmap 留在 SSD 按需读取。目前需用 Unsloth 的 llama.cpp 分支或 Unsloth Desktop 运行。

Unsloth 发布 DeepSeek-V4.1-Flash-1017 动态 GGUF:1-bit 版 250GB、128GB+ 内存可本地跑,Engram 表可放 SSD

核心要点速览

  • 1-bit UD-IQ1_M 250.4GB,较无损 UD-Q8_K_XL(508.4GB)缩小约 51%;long17k top-1 一致率 88.2%、wiki1100 为 87.1%(Unsloth 指南,厂商口径)
  • 最小的 UD-IQ1_S 为 233.0GB,适配 128GB 内存设备(如 Mac、DGX Spark),top-1 一致率 82.8%–85.1%;3-bit UD-IQ3_XXS 需约 256GB(如 Mac Studio),一致率 94.6%–95.1%
  • 模型由 552B 主干加 196B Engram 参数组成,Engram n-gram 表 110.6–202.8GB 可经 mmap 留在 SSD 按需加载,省内存但不省磁盘
  • Unsloth 称其基于 llama.cpp 的实现比其他 CPU/显存/ngram 方案推理快约 3 倍(厂商口径,未见第三方复测)
  • HF 仓库 为 MIT 许可,提供 IQ1_S 到 Q8_K_XL 共 9 档量化,另附可单独替换精度的 Engram 文件
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容
N
NVIDIA (Hugging Face model card)@AICoder·
👀187
🔥88

NVIDIA 低调开源 Dory1.0-4B 循环模型:同一权重可调推理深度,SWE-bench Verified 官方报 61.8

NVIDIA 于 10 月 16 日在 Hugging Face 上架 Nemotron-Labs Dory1.0-4B:20 层共享循环块可在推理时跑 1/2/4 轮,一份权重换不同算力档位;官方口径 4 轮 SWE-bench Verified 61.8,接近 Qwen3.5-9B。提供 BF16/MXFP8/NVFP4/GGUF,OpenMDW-1.1 许可。

NVIDIA 低调开源 Dory1.0-4B 循环模型:同一权重可调推理深度,SWE-bench Verified 官方报 61.8

核心要点速览

  • 结构:36 层 = 8 输入 + 20 共享循环 + 8 输出,循环 1/2/4 轮可在推理时切换,默认 2 轮(模型卡)
  • 官方口径 SWE-bench Verified:1 轮 50.3 / 2 轮 59.5 / 4 轮 61.8;同表 Qwen3.5-9B 为 61
  • Terminal-Bench 2.1 四轮 22.2,仍明显落后 Qwen3.6-35B-A3B 的 43,小模型短板依旧
  • DGX Spark 上 NVFP4 版 较 BF16 提速约 2.17–2.44 倍;last-loop KV 缓存让显存不随循环数增长
  • vLLM(PR #60149)与 llama.cpp(PR #30306)支持尚未合入正式版,需从 PR 构建
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Dory1.0-4B⚡ Nemotron🌐 NVIDIA

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

Liquid AI 10 月 13 日发布 LFM2.5 家族最大也是最后一款模型 LFM2.5-24B-A2B:总参 24B、每 token 激活约 2.45B,131K 上下文,强制先思考再回答。厂商口径下在 8 项工具/Agent 基准中 5 项领先或持平 Qwen3.6-35B-A3B(AutomationBench 27.69 vs 8.72),但 SWE-Bench Verified、GPQA 等知识与编码项落后。权重已上 Hugging Face,并有 GGUF/MLX/FP8/ONNX 版本;API 定价 $0.10/$1.00 每百万 token,OpenRouter 同步上架。

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

核心要点速览

  • 规格(模型卡):总参 24.0B、激活 2.45B;40 层(30 个门控短卷积块 + 10 个 GQA);每个 MoE 块 64 专家 top-4 路由;上下文 131,072、词表 128K
  • Agent 基准(厂商口径,对比 Qwen3.6-35B-A3B):AutomationBench 27.69 vs 8.72、LiveClaw 48.09 vs 38.19、ToolSandbox 80.71 vs 75.02、BFCLv4 65.01 vs 65.00
  • 短板同样公开:SWE-Bench Verified(OpenCode)51.00 vs 66.20、GPQA Diamond 74.42 vs 83.69、WebArena Verified 26.75 vs 37.62,官方建议知识类任务搭配检索
  • 速度(官方博客):Apple M5 Max 解码 184 tok/s、AMD Ryzen AI Max+ 395 为 114 tok/s;单张 B300 + SGLang 高并发超 21K 输出 tok/s
  • 训练:预训练由 17T 扩到 33T token,中训 2T@32K + 300B@131K;后训练含在 OpenClaw、Hermes Agent、Pi、OpenCode 中的 Agentic RL;API $0.10 输入 / $1.00 输出每百万 token
阅读全文
关联模型 / 智能体 / 厂商:
⚡ LFM2.5-24B-A2B⚡ LFM2.5-24B-A2B-Base⚡ LFM2-24B-A2B⚡ Qwen3.6-35B-A3B⚡ Gemma-4-26B-A4B-it🤖 Hermes Agent🤖 OpenClaw🤖 OpenCode🤖 Pi🌐 Liquid AI🌐 Hugging Face🌐 OpenRouter

LightOn 开源 ColGrep-Agent-2B:本地 2B 代码检索 Agent 接入 Claude Code,API token 降约 34%、成本约 40%

LightOn AI 于 2026-10-12 发布 ColGrep-Agent-2B(基于 MiniCPM5-2B,Apache-2.0):本地 2B 代码定位 Agent,用 ColGrep 多向量语义检索 + 只读终端在仓库内搜索,再把文件路径与行范围交还给前沿编程 Agent。在 13 个未见仓、52 道代码搜索题、624 次会话中,接入 Claude Code(Sonnet 5.5)相对纯 grep 平均少用约 34.3% API token、缓存感知成本约降 40%;准确率 80.8% vs grep 83.3%(差异无统计显著)。SWE-bench Lite 行级 F1 达 19.92,高于同 harness 下多款 10×+ 参数量模型。提供 brew/cargo/GGUF 一键安装与 Claude Code / Codex / OpenCode 钩子。

LightOn 开源 ColGrep-Agent-2B:本地 2B 代码检索 Agent 接入 Claude Code,API token 降约 34%、成本约 40%

核心要点速览

  • 官方:HF Blog — ColGrep-Agent(2026-10-12);模型 lightonai/colgrep-agent-2B;仓库 lightonai/next-plaid
  • 实测(厂商口径,Claude Code + Sonnet 5.5,52 题×3 跑):相对 grep,token −34.3%(95% CI 28–40),缓存感知成本约 −40%(7.3¢→4.4¢/题);正确率 80.8% vs 83.3%
  • 定位评测:SWE-bench Lite 文件 F1 76.18 / 行 F1 19.92;Multi-SWE-bench Flash 文件 F1 62.57 / 行 F1 15.93(五种子均值)
  • 训练:MiniCPM5-2B → SFT(Qwen3.5-27B 教师轨迹)→ GRPO 500 step;工具仅 colgrep / 只读 terminal / finish;10 轮预算
  • 开箱:brew install lightonai/tap/colgrep && colgrep --install-agent;默认 GGUF ~2.5GB;colgrep --install-claude-code|codex|opencode
阅读全文
关联模型 / 智能体 / 厂商:

JetBrains 发布 Mellum2.1:12B MoE(2.5B 激活)开源编程 Agent 模型,SWE-bench Verified 从 2.0 跃至 47.0

10 月 8 日 JetBrains 开源 Mellum2.1 Thinking:架构仍为 12B MoE / 2.5B 激活、131K 上下文、Apache 2.0;几乎全部增益来自百万级真实沙箱 RL。同管线自评:SWE-bench Verified 47.0(Mellum2 仅 2.0)、LiveCodeBench v6 82.0;HF 可下,vLLM 一键服务,GGUF/MTP 即将到来。

核心要点速览

  • 模型规格:12B MoE / 2.5B 激活、131K 上下文、Apache 2.0;架构相对 Mellum2 不变(HF 模型卡)
  • Agent 跃迁:同管线 SWE-bench Verified 2.0→47.0、SWE-bench Pro 0.0→28.0、Terminal-Bench 2.1 0.6→17.4(Pi v0.73.1 harness)
  • 编码强度:LiveCodeBench v6 82.0(同组领先 Qwen3.5-9B 75.4)、HumanEval+ 91.5、BFCL v4 62.3
  • 吞吐:官方称重载下同组最快,单请求 MTP 约 1.6×;仍落后 Qwen3.5-9B 的 SWE Verified 50.0 / Pro 38.0
  • 落地:vllm serve JetBrains/Mellum2.1-12B-A2.5B-Thinking --reasoning-parser qwen3;GGUF / Ollama / LM Studio / MTP head 即将发布(JetBrains 博客)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Mellum2.1⚡ Mellum2⚡ Qwen3.5-9B⚡ Gemma 4 E4B🤖 Pi🌐 JetBrains

Unsloth 发布 v0.1.815 与 CUDA 13 预编译轮子:本地极速运行 Qwen-Image-2.1 并接入 Claude 规范 Agent Skills

知名大模型轻量高效训练与推理工具 Unsloth 正式发布 v0.1.815-beta 版本,并上线 Linux x86_64 CUDA 13 官方预编译二进制轮子(涵盖 Flash-Attention 2.8.4、Causal-Conv1D 与 Mamba-SSM)。新版本原生支持在本地消费级与企业级 GPU 上以 Fast FP8 与 GGUF(默认 Q4_K_M)量化运行阿里开源的多模态图像编辑与生成旗舰模型 Qwen-Image-2.1。此外,Unsloth 本地 UI 引入了深度兼容 Claude Code 与 .agents 规范的自定义 Agent Skills 体系,支持在聊天中以 @skill 快速编排专用技能,长链思考思维块渲染速率提升一倍达到 60 FPS。

Unsloth 发布 v0.1.815 与 CUDA 13 预编译轮子:本地极速运行 Qwen-Image-2.1 并接入 Claude 规范 Agent Skills

核心要点速览

  • CUDA 13 官方二进制:提供针对 PyTorch 2.13/2.14 与 Python 3.13 的 Flash-Attention 2.8.4、Causal-Conv1D 与 Mamba 预编译 Wheel,告别数小时本地编译
  • Qwen-Image-2.1 本地量化落地:支持 Fast FP8 与 GGUF Q4_K_M,完整覆盖图像生成与多轮指令式图像编辑,彻底修复 A100 黑块伪影
  • 全兼容 Agent Skills 体系:无缝复用已有 Claude Code 与 .agents 目录中的专用指令技能,聊天框支持 @skill 即时激活与参数传递
  • 思维链推理渲染翻倍:重构 CoT 思考块交互逻辑,长推理文本流式渲染速度从 30 FPS 提升至 60 FPS,交互顿挫感大幅消除
  • 多系统开箱即用:内置 Debian 应用内自动更新,并为 Ubuntu 24.04+ ARM64 架构提供专用独立安装器
阅读全文
关联模型 / 智能体 / 厂商:

Unsloth:GLM-5.3-Flash 本地 GGUF 推理提速最高 3.3 倍,启用 MTP 与长上下文优化

Unsloth 宣布优化后的本地 GGUF 解码使 GLM-5.3-Flash 推理最高提速约 3.3 倍(常见场景约 1.6–3.4×),并启用多 token 预测(MTP)与更快的长上下文解码。3-bit 量化可在约 128GB 内存设备上通过 Unsloth Desktop 或 llama.cpp 运行,配套文档与 Hugging Face GGUF 权重已更新。

核心要点速览

  • 速度:本地 GGUF 推理最高约 3.3×,常见区间约 1.6–3.4×。
  • 能力:启用 MTP,并优化长上下文解码。
  • 落地:3-bit 可在约 128GB 设备用 Unsloth Desktop / llama.cpp;文档与 HF GGUF 已上线。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Unsloth 发布 GLM-5.3-Flash 3-bit GGUF:320B 多模态大模型可在 128GB 内存本地流畅运行

Unsloth AI 正式上线 GLM-5.3-Flash(Ox Alpha)超轻量量化 GGUF。通过 3-bit 混合量化技术,这款 320B 总参、18B 激活且具备 MIT 协议的顶尖多模态 MoE 模型可在 128GB 内存设备(如 Mac Studio)上实现本地单机推理。

核心要点速览

  • 实现 320B 级顶尖开源多模态编程大模型发布首日即支持消费级工作站本地离线运行;
  • 在 DeepSWE 与多模态编程基准上对齐甚至逼近顶级闭源模型,3-bit 保持极高推理保真度;
  • 配套开源全套下载指南与 Hugging Face 权重仓库,开箱即用支持 llama.cpp 与 LM Studio。
阅读全文
关联模型 / 智能体 / 厂商:

通义千问发布 Qwen3.8-Flash-Next 开源权重:Unsloth 单卡 GGUF 本地推理支持

阿里通义千问团队宣布正式开源 Qwen3.8-Flash-Next 完整权重,总参数 125B 激活 6B MoE 架构。联合 Unsloth 推出量化版 GGUF,支持在单张 24GB 显存消费级显卡(如 RTX 4090/5090)上全速运行 262K 上下文代码补全,本地推理吞吐达 85 tokens/s。

核心要点速览

  • 阿里通义千问开源 Qwen3.8-Flash-Next 125B/6B MoE 权重;
  • Unsloth 提供官方 GGUF 量化支持,单张 24GB 消费卡全速运行 262K 上下文;
  • 本地代码补全吞吐达 85 tokens/s,企业内网离线隐私编程极佳选择。
阅读全文
关联模型 / 智能体 / 厂商:

Qwen3.8-Flash-Next 可在 75GB 内存本地运行:Unsloth GGUF 提供 Day-0 支持

通义千问官方确认,125B 多模态 MoE 模型 Qwen3.8-Flash-Next 已可通过 Unsloth GGUF 在约 75GB 内存上本地运行,并支持把 N-gram 嵌入放到 CPU/统一内存以接近显存速度。这是 Qwen4 架构预览权重的首日本地部署路径。

核心要点速览

  • 125B MoE(每 token 激活 6B,另有 51B N-gram 嵌入)可在约 75GB RAM 上本地推理,无需整模装进 GPU 显存
  • Unsloth 提供 Day-0 GGUF 与 Qwen3.8-Flash-Next 指南,CPU RAM / 统一内存路径可接近显存吞吐
  • 官方权重同步在 Hugging Face / ModelScope;vLLM 与 SGLang 已提供 NVIDIA 与 AMD Day-0 服务支持
阅读全文