AI 编程实时动态与要闻

Flower Labs 发布 Endeavor 1.1:新增多模态与欧盟境内推理,可私有部署并开放思维链,自称比肩 OpenAI、Anthropic

联邦学习框架 Flower 背后的 Flower Labs 于 11 月 3 日发布 Endeavor 1.1,这是其今年第三个模型(继 4 月的英国主权 7B 模型 Lizzy、9 月的 Endeavor 1.0 之后)。新版本新增图像输入、可选欧盟境内 GPU 推理,支持 Flower 托管、私有云或本地部署,并承诺用户可查看完整思维链、拥有推理输出并用于训练自有模型。官方口径 GPQA 94.4、HumanEval 99.9、AIME 2026 99.9、MMMU-Pro 81.1,但对比对象是 GPT-5.6 Sol 与 Claude Fable 5 而非两家最新模型,且目前仅开放申请试用。

Flower Labs 发布 Endeavor 1.1:新增多模态与欧盟境内推理,可私有部署并开放思维链,自称比肩 OpenAI、Anthropic

核心要点速览

  • 官方口径:GPQA 从 1.0 的 92.0 升到 94.4(约少 30% 错误),HumanEval 从 98.2 升到 99.9,IFEval 94.5,MMMU-Pro 81.1。
  • 官方对比表中 GPT-5.6 Sol 为 GPQA 94.1、IFEval 95.9、MMMU-Pro 83.0,Claude Fable 5 为 GPQA 92.6;Endeavor 在 IFEval 和 MMMU-Pro 上并未领先。
  • 新增欧盟境内 GPU 推理并附 SLA,计划后续推出英国、中东、亚洲、非洲区域推理。
  • 卖点是可控:读取原始思维链、保留推理输出与轨迹,并可用来微调或训练自有模型。
  • 官方称模型基于成熟开源权重模型,经持续预训练、定向后训练与模型融合构建,未公开基座与参数规模;目前需申请访问。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Endeavor 1.1⚡ Endeavor 1.0⚡ GPT-5.6 Sol⚡ Claude Fable 5⚡ Kimi K3⚡ Nemotron 3 Ultra🌐 Flower Labs

OpenAI 披露利用 GPT-5.6 Sol 挖掘影响全球 70% 网站的 PHP 关键漏洞,开源检测工具并设 10 亿美元基金

OpenAI 官方宣布,网络安全研究机构 Calif 借助 GPT-5.6 Sol 成功发现了存在于 PHP 核心解释器中的关键高危漏洞,云安全巨头 Wiz 亦独立完成双重漏洞上报。鉴于全球约 70% 的互联网网站均运行在 PHP 之上,该漏洞具有重大潜在威胁。OpenAI 遵循负责任漏洞披露规范协助完成安全补丁升级,宣布设立 10 亿美元规模的 Daybreak 补贴基金以强化关键开源安全,并联合开源了基于 Codex 技能的自动化检测工具 openai/php2shell-checker,供全球站长一键自查。

OpenAI 披露利用 GPT-5.6 Sol 挖掘影响全球 70% 网站的 PHP 关键漏洞,开源检测工具并设 10 亿美元基金

核心要点速览

  • Calif 借助 OpenAI 前沿大模型 GPT-5.6 Sol 成功挖掘出 PHP 核心引擎的关键远程代码执行(RCE)高危漏洞
  • PHP 驱动着全球超过 70% 的 Web 站点,官方已与安全厂商协同完成热修复并向社区披露
  • OpenAI 宣布提供 10 亿美元规模的 Daybreak 补贴算力支持,专门用于全球关键开源基建的安全审计与防御
  • 在 GitHub 正式开源自动化检测工具 openai/php2shell-checker,支持开发者利用 Codex 技能快速排查系统风险
阅读全文

OpenAI「Patch the Planet」:GPT-5.6 Sol 协助发现 PHP 两个严重远程代码执行漏洞,PHP 8.5.12/8.4.27/8.3.36/8.2.35 紧急修复

10 月 21 日,PHP 官方发布安全公告,修复两个可被未认证远程代码执行的严重漏洞(CVE-2026-109618、CVE-2026-109619),所有提供 Web 请求的 PHP 部署都受影响,mod_php 风险最高。OpenAI 同日披露:安全公司 Calif 在其 Patch the Planet 计划中用 GPT-5.6 Sol 发现了漏洞,Wiz 也独立发现并报告;OpenAI 牵头约两个月的协同披露,并承诺投入 10 亿美元补贴 Daybreak 给资源有限的防御方。

OpenAI「Patch the Planet」:GPT-5.6 Sol 协助发现 PHP 两个严重远程代码执行漏洞,PHP 8.5.12/8.4.27/8.3.36/8.2.35 紧急修复

核心要点速览

  • 漏洞:CVE-2026-109618(OOM 处理导致内存破坏)与 CVE-2026-109619(请求间残留的全局状态),均可未认证 RCE(PHP 官方)
  • 修复:升级到 PHP 8.5.12、8.4.27、8.3.36 或 8.2.35;官方称没有完整缓解措施,升级是唯一安全选择
  • 范围:PHP-FPM、Apache mod_php、php-cgi、FrankenPHP、LiteSpeed 均受影响,mod_php 已有演示利用
  • AI 角色:Calif 用 GPT-5.6 Sol 发现漏洞,Wiz 独立报告;OpenAI 牵头约 2 个月协同披露(官方口径)
  • 投入:OpenAI 承诺 10 亿美元补贴 Daybreak 访问,并将推出检查 PHP 版本的 Codex skill
阅读全文

OpenAI 开源 MultiLangBench 并公布低资源语言编程进展:GPT-6 Astra 用 20 种语言从零写 SQLite 平均通过率 87.4%,GPT-6.1 Sol 迁移 COBOL 准确率最高 97.9%

OpenAI 10 月 19 日发文,称最新模型在 COBOL、Fortran、Visual Basic、OCaml 等训练语料稀少的「低资源语言」上大幅进步,并开源评测 MultiLangBench:让模型用 20 种语言各自从零写一个兼容 SQLite 的数据库引擎。GPT-6 Astra 平均测试通过率 87.4%(GPT-5.6 Sol 为 26.8%),20 种语言里 19 种超过 83%,COBOL 仍最难,为 72.1%。另一项 COBOL 迁移评测要求把程序迁到 C++、Java、Kotlin、Python 或 Rust 并做到输出逐字节一致,GPT-6.1 Sol 低推理档 86.6%(GPT-5.6 Sol 仅 5.4%),高推理档 97.9%。以上均为 OpenAI 自测口径。

OpenAI 开源 MultiLangBench 并公布低资源语言编程进展:GPT-6 Astra 用 20 种语言从零写 SQLite 平均通过率 87.4%,GPT-6.1 Sol 迁移 COBOL 准确率最高 97.9%

核心要点速览

  • MultiLangBench:GPT-6 Astra(max)20 种语言平均通过率 87.4%,GPT-5.6 Sol 为 26.8%;19 种语言超过 83%(官方口径)。
  • 分语言提升:COBOL 10.9%→72.1%、OCaml 25.6%→85.8%、Fortran 21.4%→83.5%、Visual Basic 27.5%→89.4%。
  • 低价档:GPT-6 Luna 平均 40.3%,每样本约 0.77 美元,比 GPT-5.6 Sol 的 3.48 美元低约 78%。
  • COBOL 迁移:GPT-6.1 Sol 低推理档 86.6%(GPT-5.6 Sol 5.4%),API 成本约为后者的 61%;高推理档 97.9%,接近饱和。
  • 评测集与各语言结果已在 GitHub openai/multilangbench 开源;COBOL 迁移评测未公开。
阅读全文
AD赞助内容

南加州大学与 UCLA 推出离散空间状态追踪基准 Grid-Bench:8,928 组可执行测试揭示大模型长链推演严重失真,64 步长轨迹开闭源断崖式分化

当前 LLM 能否在复杂连续空间操作中精确预测离散物理世界的演变?南加州大学(USC)、UCLA 与 CMU 联合发布 Grid-Bench(arXiv:2610.22312,GitHub: grid-bench/Grid-Bench)。该基准基于 8 种离散几何变换规则,测试 2D/3D/4D 网格在 0 至 64 步长事件链下的全状态精确预测。对 GPT-5.6 Sol、Claude 5 Sonnet、GLM-5、Kimi K2.5 等 6 款顶尖模型的评测表明:在 64 步长轨迹下,开源与中型模型完整状态精确率几乎归零,唯闭源旗舰维持断层领先。

南加州大学与 UCLA 推出离散空间状态追踪基准 Grid-Bench:8,928 组可执行测试揭示大模型长链推演严重失真,64 步长轨迹开闭源断崖式分化

核心要点速览

  • 南加州大学、UCLA 与 CMU 联合发布可执行多维空间推理基准 Grid-Bench(arXiv:2610.22312),跨越 2D/3D/4D 网格与 8 大几何规则
  • 涵盖 8,928 组可执行测试实例,评测历史步长从 T=0 延伸至极端复杂的 T=64 步连续离散世界演变
  • 在 T=16 步中程推演中,GPT-5.6 Sol(98.0% 单元准度)与 Claude 5 Sonnet(96.8%)保持领先,中型模型精确世界命中率跌至个位数
  • 在 T=64 步极限长链下,GLM-5 与 Kimi K2.5 完全精确世界命中率归零,证实长程离散空间推演必须外挂确定性状态机
阅读全文
关联模型 / 智能体 / 厂商:

揭秘单元测试奖励副作用!PreciseCoder 根治编程模型“过度修改与无病乱改”:平均改动行数从 15 行锐减至 3 行

基于单元测试通过与否的强化学习(Unit-Test RL)是当前后训练代码模型的标准范式,但研究发现仅靠测试通过率奖励会诱导模型‘胡乱扩大修改范围’甚至在原本正确的代码上产生幻觉式改写。研究团队提出 PreciseCoder,在单元测试奖励之上引入语义验证的局部化精准编辑奖励。在 4B、9B 与 27B 模型上将平均修改代码行数从 7–15 行压缩至仅 3 行,零样本迁移至仓库级修复解决更多 Issue,且将 9B 推理轨迹提供给 GPT-5.6 Sol 与 Qwen3.8-Max 可直接提升 4.6–12.4 个百分点的编辑精度。

揭秘单元测试奖励副作用!PreciseCoder 根治编程模型“过度修改与无病乱改”:平均改动行数从 15 行锐减至 3 行

核心要点速览

  • 揭示纯单元测试 RL 隐患:仅靠测试通过率奖励会诱导代码模型大面积过度编辑,甚至在正确代码上产生幻觉修改
  • 平均改动从 7–15 行压缩至 3 行:引入语义验证局部编辑奖励,在 4B/9B/27B 模型上实现外科手术式精准修复并泛化至仓库级任务
  • 9B 思维链跨代赋能旗舰模型:将 9B PreciseCoder 的推理轨迹喂给 GPT-5.6 Sol 与 Qwen3.8-Max,零训练直接提升 4.6–12.4 个百分点编辑精度
阅读全文
关联模型 / 智能体 / 厂商:

Theo 开源 tsc-rs:Opus 5.5 两周、约 2.4 万美元把 TypeScript 7 编译器移植到 Rust,类型检查比 Go 版快约 1.6 倍

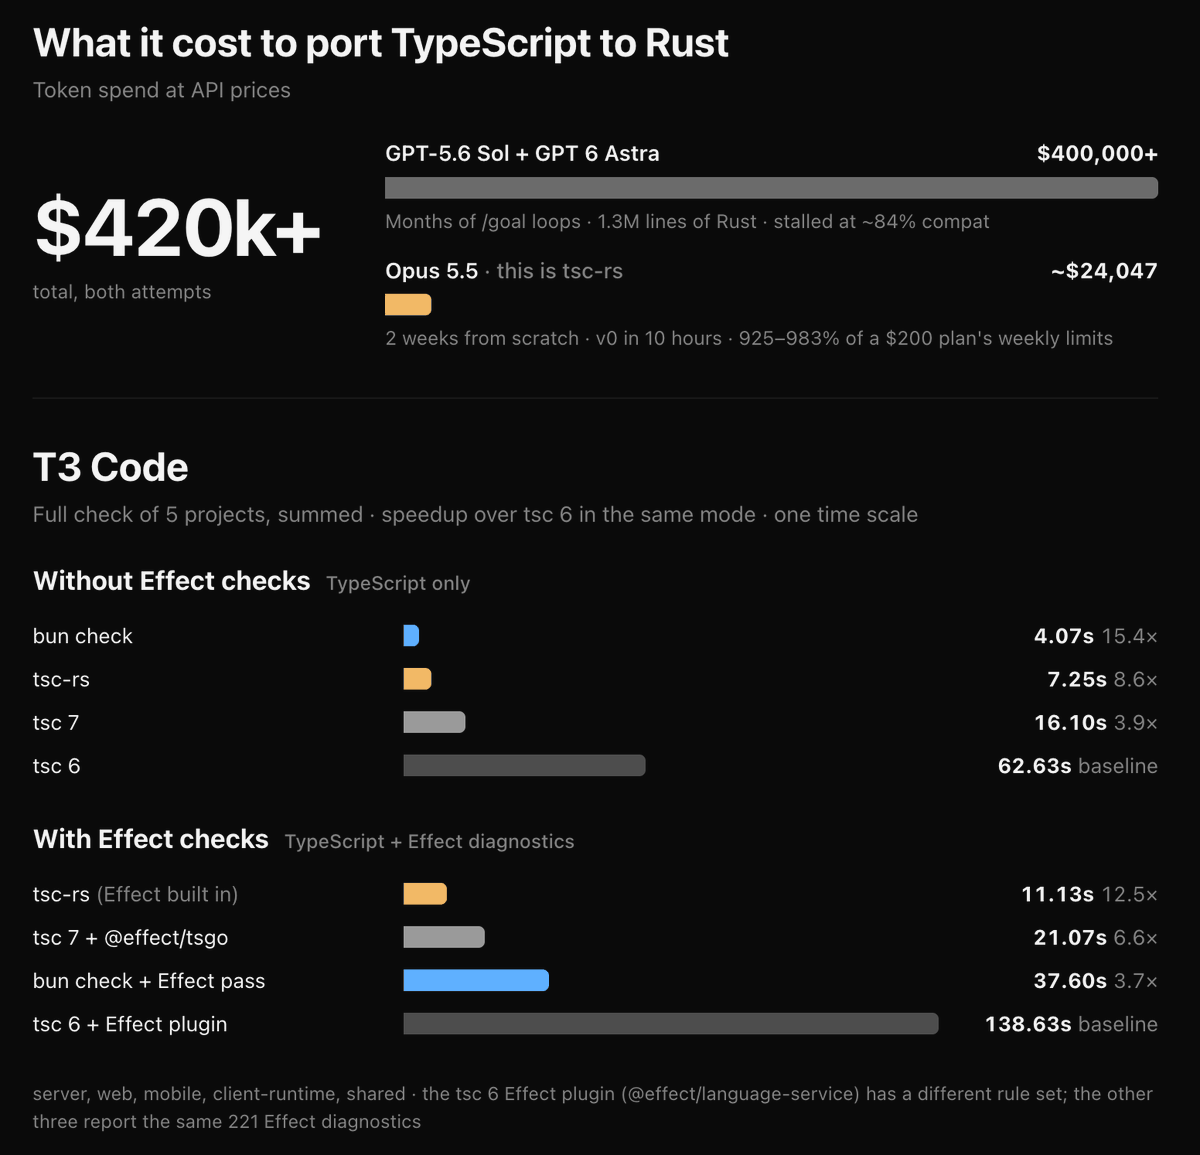
T3 创始人 Theo 开源 ts-rust(npm 包 tsc-rs),把微软 Go 原生版 TypeScript 编译器、类型检查器与 LSP 整体移植到 Rust。他此前用 GPT-5.6 Sol / GPT 6 Astra 烧掉逾 40 万美元 API 价 token、写出 130 万行 Rust 仍卡在约 84% 兼容;换 Claude Opus 5.5 从零重写,10 小时出 v0,两周约 24,047 美元完成。181,711 个移植自 Go 的测试全过,六个开源项目几何平均比 tsc 7 快 1.61 倍,内置 Effect 诊断并支持 WASM。

Theo 开源 tsc-rs:Opus 5.5 两周、约 2.4 万美元把 TypeScript 7 编译器移植到 Rust,类型检查比 Go 版快约 1.6 倍

核心要点速览

  • 成本对比:GPT-5.6 Sol / GPT 6 Astra 逾 40 万美元、约 84% 兼容即停滞;Opus 5.5 约 24,047 美元、2 周完成(README)
  • 正确性:181,711 个移植自 Go 的测试全部通过,TanStack Query core 与 Hono 诊断与 Go 版逐条一致
  • 速度:六个开源项目几何平均 11.4× tsc 6、1.61× tsc 7;VS Code(375 万行)4.20s vs tsc 7 的 6.84s;bun check 仍最快(20.9×)
  • T3 Code 实测:无 Effect 7.25s vs tsc 7 16.10s(2.22×);含 Effect 诊断 11.13s vs 21.07s(1.89×)
  • 早期版本:仅 Linux x64 / macOS arm64,已知 monorepo TS6059、tsc -b 无 references 读旧产物等问题
阅读全文

让代码文件变自律智能体!UIUC 等提出 HERMES 框架:动态激活开发基元,Qwen3-8B 逼平前沿大模型

赋予大语言模型终端控制权限的代码智能体(Coding Agents)在解决单步或局部 Bug 时已屡见不鲜,但在面对动辄数十万行代码的大型真实代码仓库(Monorepos)时,依然极度脆弱。传统的单一集中式 Agent 必须通过冗长的命令行输出在上下文窗口中反复‘重建’散落于源码、配置文件、测试套件与依赖关系中的项目状态,极易引发上下文爆炸、记忆遗忘与语义漂移。UIUC(伊利诺伊大学厄巴纳-香槟分校)研究团队在最新研究(arXiv:2610.07832)中提出了突破性的‘开发基元’(Dev-Primitives)概念与软件工程治理架构 HERMES。Dev-Primitives 将代码库中的每一个被动代码构件(如核心模块、配置或测试)转变为由常驻轻量 LLM 驱动的‘主动智能体’,拥有原生的自然语言推理、组件间协同通信与局部自修改能力。HERMES 依托依赖感知的动态激活机制与基于执行证据的缺陷定位管线,在四大权威软件工程基准上平均超越基准 Harness 12.4%;即便在底层仅挂载 Qwen3-8B 这种轻量级开源模型,HERMES 依然能在四大基准上逼平庞大的 GPT-5.6 Sol(差距仅 4.5%),并在 Terminal-Bench 4.0 上降低 26.2% 的推理成本,深刻实证了 Harness 架构工程对代码智能体的决定性价值。

核心要点速览

  • UIUC 提出模块化可执行开发基元(Dev-Primitives)概念与软件工程治理架构 HERMES,将代码资产拟人化为自律智能体
  • 依赖感知的动态激活与反向缺陷定位机制,彻底根除集中式 Agent 面对超大仓库时的上下文爆炸与语义漂移
  • 四大基准平均提升 12.4%,轻量 Qwen3-8B 构件综合表现逼近 GPT-5.6 Sol(差距仅 4.5%),Terminal-Bench 4.0 成本狂降 26.2%
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 联手 Ironclad 用强化学习训练 GPT-6 Astra 操作专业软件:合同工作流得分 55.0%(Sol 41.6%),单次耗时减半

OpenAI 公布首个“垂直 SaaS 共建”计算机操作研究:与合同平台 Ironclad 共同定义 11 个法务/采购/商务任务,在 Ironclad 托管环境里用 RL 训练 GPT-6 Astra。Astra 平均 rubric 得分 55.0%(GPT-5.6 Sol 41.6%),估算单次耗时 19.2 分钟 vs 37.0 分钟;内部模型已达 63.7%。OpenAI 同时开放软件公司申请合作。

OpenAI 联手 Ironclad 用强化学习训练 GPT-6 Astra 操作专业软件:合同工作流得分 55.0%(Sol 41.6%),单次耗时减半

核心要点速览

  • 11 个真实合同任务、每个 8–50 条评分标准;资深用户人工约需 30–40 分钟/任务(OpenAI 原文)
  • GPT-6 Astra(Max 推理)平均得分 55.0%,GPT-5.6 Sol(High 推理)41.6%,相对提升约 32%
  • 估算单次耗时 37.0 → 19.2 分钟(约 -48%);注意这是按模型速度模拟的时间,不是客户实测节省
  • 演示任务中 Astra 约 20 分钟满足 ~94% 标准,Sol 约 32 分钟满足 ~85%;内部研发模型已到 63.7%
  • 训练数据来自 SEC EDGAR 公开合同并去除个人信息,未用 OpenAI 或 Ironclad 客户数据
阅读全文

无痛升级全能多模态!新加坡国大开源 Omni-IO Skills:声明式图编排七大模态,Claude 与 GPT 输入支持率跃至 100%

随着通用智能体向复杂物理世界与全流程数字化工作流渗透,开发者期望智能体能够无缝处理文本、图像、音频、视频、结构化文档、3D 资产与程序代码等 7 大跨模态资产。然而,直接重新预训练或微调全模态底座模型成本极其高昂且极易损害核心推理能力;而简单外挂零散工具又导致中间资产格式混乱、跨轮次状态修改无法追溯。来自新加坡国立大学(NUS)与 S-Lab 联合团队推出了开源即插即用外壳框架 Omni-IO Skills(arXiv:2609.31847,社区近 300 赞):首创声明式执行图(Declare Execution Graphs)与持久化资产注册表(Asset Registry),打造包含 27 项层次化多模态技能的标准化接口,全方位覆盖 38 项代表性复杂跨模态任务。在权威评测 UniM-90 上,该外壳将 GPT-5.6 Sol 与 Claude Sonnet 5 的全模态输入支持率从原先的 40% 暴力提升至 100%,结构化达标率突破 99.78%,开辟了外壳级多模态能力重组的最高效路径。

无痛升级全能多模态!新加坡国大开源 Omni-IO Skills:声明式图编排七大模态,Claude 与 GPT 输入支持率跃至 100%

核心要点速览

  • 社区狂揽近 300 赞!首创无需改动大模型核心推理权重的外壳级全模态(Omni-Native)即插即用框架
  • 涵盖 27 个层次化 Skills,跨文本/图像/音频/视频/文档/3D/代码 7 大模态深度打通 38 项核心复杂任务
  • 驱动 GPT-5.6 Sol 与 Claude Sonnet 5 全模态输入支持率从约 40% 提升至 100%,语义质量分由 27 暴增至 77+
阅读全文
AD赞助内容

告别终端环境误毁!Mid-Harness 提出模型与沙箱边界动作扩展:前置验证机制使 TerminalBench 准确率提升 18%

终端智能体(Terminal Agents,如 Cline、OpenHands、Claude Code)依赖概率生成模型直接向 Bash 命令行下发指令,但具备生成有效动作的能力并不等同于能够可靠执行。在实际工程中,一条错误的误操作命令(如误装依赖版本、错误删除配置或破坏系统文件)便足以永久破坏沙箱环境,使后续规划全盘瘫痪。最新研究提出 Mid-Harness,首次将测试期计算(Test-Time Compute)聚焦在模型与 Harness 的交界处。通过在动作真正下发至系统前进行多候选采样与细粒度验证,在无需改动底座生成器与 Harness 的前提下拦截灾难性调用。在 TerminalBench-Lite 评测中,Mid-Harness 将 Pass@1 从 50.00% 跃升至 68.03%,且相比盲目生成整条长轨迹,在显著降低 Token 消耗的同时获得了更高的任务完成率。

告别终端环境误毁!Mid-Harness 提出模型与沙箱边界动作扩展:前置验证机制使 TerminalBench 准确率提升 18%

核心要点速览

  • 在模型与终端沙箱边界引入动作级验证,TerminalBench-Lite Pass@1 从 50.00% 跃升至 68.03%
  • 通过成对验证(Pairwise Verification)与知识蒸馏,同参数小模型亦可实现高信噪比动作筛选
  • 相较于整条长轨迹盲目重试,Mid-Harness 以减少超 35% 的 Token 开销达成更高任务成功率
阅读全文
关联模型 / 智能体 / 厂商:

跨越 7 大模态的全能 Agent 运行时!新国大开源 Omni-IO Skills:声明式执行图编排 27 项技能,顶级模型多模态支持率直拉 100%

通用智能体虽具备长程规划与工具调用能力,但在实际工程落地中,其生产力能力依然深度割裂在文本、图像、音频、视频、文档、3D 资产与代码这 7 大异构模态之间。直接微调端到端全模态底座成本极其高昂且极易出现灾难性遗忘,而简单外挂多个专用模型又缺乏跨模态依赖编排、中间产物复用与跨轮次协同能力。新加坡国立大学(NUS)NExT++ 实验室研究团队提出即插即用的全模态智能体底座增强运行时 Omni-IO Skills。该框架构建了层级化技能库、标准化多模态执行接口、依赖感知编排引擎与持久化资产注册表(Asset Registry)。工作流被建模为声明式执行图(Declare Execution Graphs),不仅原生支持无依赖动作并发调度,更能将多步生成的中间产物自动缓存供下游复用。在全新全模态基准 UniM-90 上,该运行时将 GPT-5.6 Sol 与 Claude Sonnet 5 的输入模态支持率从约 40% 直拉至 100%,语义质量综合得分实现近 3 倍爆发式跃升。

跨越 7 大模态的全能 Agent 运行时!新国大开源 Omni-IO Skills:声明式执行图编排 27 项技能,顶级模型多模态支持率直拉 100%

核心要点速览

  • 7 大模态即插即用统一运行时:无需重新训练或微调底座大模型,通过 Harness 级能力编排,无缝打通文本、图像、音频、视频、文档、3D 资产与代码 7 大模态。
  • 声明式执行图与持久资产注册表:以 Declare Execution Graphs 支持无依赖多模态任务并发调度,并通过 Persistent Asset Registry 实现中间多模态生成物跨轮次确定性复用。
  • 顶级商业模型全模态输入支持率直冲 100%:在严苛的 UniM-90 全模态基准上,将 GPT-5.6 Sol 与 Claude Sonnet 5 的输入支持率从不足 40% 彻底拉升至 100%,综合语义质量分暴增近 3 倍。
阅读全文

Code Arena WebDev:GPT-6 Astra (Max) 1800 分登顶,Claude Fable 5.1 居次 1758

LMSYS Arena 更新 Code Arena: WebDev 排行:OpenAI GPT-6 Astra (Max) 以 1800 分位列第一,Anthropic Claude Fable 5.1 (Max) 以 1758 分居次。匿名对战胜率显示 Astra 相对多数模型占优,对 GPT-5.6 Sol (xHigh) 胜率约 72.5%。

核心要点速览

  • WebDev 榜:GPT-6 Astra (Max) 1800 分第一,Claude Fable 5.1 (Max) 1758 分第二
  • 匿名对战胜率显示 Astra 对多数对手占优
  • 对 GPT-5.6 Sol (xHigh) 胜率约 72.5%
阅读全文

Agent Arena Image-to-WebDev:GPT-6 Astra (Max) 登顶 1733 分,Claude Fable 5.1 居次

Arena 更新 Image-to-WebDev 榜:GPT-6 Astra (Max) 以 1733 分登顶,领先 GPT-5.6 Sol (xHigh) 129 分;Claude Fable 5.1 (Max) 以 1710 分列第二。该榜评测模型从图像到网页开发的交付能力,对新近发布模型给出公开对比。

核心要点速览

  • GPT-6 Astra (Max) 以 1733 分登顶 Image-to-WebDev。
  • Claude Fable 5.1 (Max) 以 1710 分位列第二。
  • 榜单覆盖四款新近评测的模型发布。
阅读全文

OpenAI:10 月 14 日起 ChatGPT / Work / Codex 订阅端下线 GPT-5.5,建议改用 GPT-5.6 Sol 或 GPT-6 Astra

ChatGPT 官方宣布,自 2026 年 10 月 14 日起,GPT-5.5 将从 ChatGPT、ChatGPT Work 与各档 Codex 订阅中下线;Codex 用户需改用 GPT-5.6 Sol 或 GPT-6 Astra。OpenAI Developers 同步说明:经 OpenAI API Platform 以及用 API Key 鉴权的 Codex 会话仍可继续使用 GPT-5.5。

核心要点速览

  • 10 月 14 日起 GPT-5.5 退出 ChatGPT、ChatGPT Work 与各档 Codex 订阅。
  • Codex 订阅用户建议改用 GPT-5.6 Sol 或 GPT-6 Astra。
  • API Platform 与 API Key 鉴权的 Codex 会话仍可继续用 GPT-5.5。
阅读全文
关联模型 / 智能体 / 厂商: