AI 编程实时动态与要闻

World Labs 发布 Frameboy:优化版 Atlas 云端流式最高约 15 fps,浏览器实时探索世界模型

World Labs 于 2026-11-05 发布研究预览 Frameboy:高度优化的 Atlas 变体从云端 GPU 流式推到浏览器,官方口径最高约 15 fps,支持实时控镜;公开 Demo 与封闭测试 Viewfinder 叠加模式同步上线。CEO Fei-Fei Li 在 X 转发「Real time Atlas」。

World Labs 发布 Frameboy:优化版 Atlas 云端流式最高约 15 fps,浏览器实时探索世界模型

核心要点速览

  • 官方:World Labs 2026-11-05 发布 Frameboy 研究预览(博客 + X)
  • 厂商口径:优化版 Atlas 云端流式最高约 15 fps,浏览器实时控镜
  • 公开 Demo:frameboy.worldlabs.ai;Viewfinder 封闭测试可自建场景后叠加实时漫游
  • 能力:单图/文本生成场景 + 多视图新视角合成;承接 RTFM 形态、Atlas 规模
  • 官方注明需强云 GPU,相对本地渲染不便宜;无独立第三方画质/延迟榜
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Atlas⚡ RTFM🌐 World Labs

Hugging Face 发布 Ultimate MoE Training Handbook:约 50–80 万 GPU 小时实验沉淀为 Megatron-LM 训练手册

2026-11-05,Hugging Face 发布免费「The Ultimate MoE Training Handbook」。Thomas Wolf(联合创始人)称约 80 万 GPU 小时、约 7 万字与 55 幅交互图;作者 Nouamane Tazi 另称约 50 万 GPU 小时。手册面向 Megatron-LM,覆盖路由、专家规模、通信与调试,入口为官方 Space。

Hugging Face 发布 Ultimate MoE Training Handbook:约 50–80 万 GPU 小时实验沉淀为 Megatron-LM 训练手册

核心要点速览

  • 官方:Hugging Face Space「The Ultimate MoE Training Handbook」(2026-11-05)
  • Thomas Wolf(HF 联合创始人)X 口径:约 80 万 GPU 小时、约 7 万字、55 幅交互图
  • 作者 Nouamane Tazi 另称约 50 万 GPU 小时;以 Space 正文为准,不统一编造单一数字
  • 覆盖 Megatron-LM:路由/专家规模/all-to-all/aux loss 与 loss-free bias/升采样与服务
  • 免费开源;适合小团队按 runbook 逐项对照日志落地
阅读全文
关联模型 / 智能体 / 厂商:
⚡ DeepSeek-V4 (Next-Gen MoE)⚡ Nemotron 3 Super⚡ Nemotron 3 Ultra🌐 Hugging Face🌐 NVIDIA
C
CMU Infini-AI LabInfini-AI-Lab·
👀7
🔥87

CMU Infini-AI 连发 CompressionBench / ServerBench:编码 Agent 自主压模型与设计推理服务;Sonnet 5.5 达 vLLM 约 4.87×「美元/美元」

卡内基梅隆 Infini-AI Lab 于 arXiv(2026-11-04)发布孪生基准:CompressionBench 考编码 Agent 在存储限额内交付可验证压缩权重与推理代码(36 次提交 29 次通过,最优设计较 BF16 平均 PPL 仅高约 3.4%);ServerBench 考完整 LLM 服务系统设计,目标为延迟达标 token 价值 / GPU 美元。11 模型×3 部署中 Claude Sonnet 5.5 在 Gemma E4B 上达 2.97「美元/美元」,约为 vLLM 基线 4.87 倍;33 次运行 22 次通过验证。

核心要点速览

  • 官方:arXiv:2611.06858 CompressionBench + arXiv:2611.06841 ServerBench(CMU Infini-AI Lab)
  • CompressionBench:6 Agent × 6 设定,36 提交中 29 通过独立验证;最优设计平均 PPL 较 BF16 高约 3.4%
  • ServerBench:目标「美元/美元」= 延迟达标 token 价值 / GPU 成本;状态化回放真实编码会话
  • 厂商表口径:Claude Sonnet 5.5 在 Gemma E4B 达 2.97,约 vLLM 基线 4.87×;33 跑 22 验证通过
  • 代码:github.com/Infini-AI-Lab/Compression-Bench 与 Server-Bench
阅读全文
关联模型 / 智能体 / 厂商:

AMD 三季度数据中心营收 85 亿美元同比增 97%:Helios 机架已为 Anthropic、OpenAI 等运行模型,四季度指引约 170 亿美元

AMD 11 月 3 日公布 2026 年第三季度财报:总营收 133.77 亿美元,同比增长 45%;数据中心业务营收创纪录的 85.46 亿美元,同比增长 97%、环比增长 27%,主要来自 EPYC 服务器 CPU 和刚上市的 Instinct MI450 系列 GPU。公司称 Anthropic、Meta、微软、OpenAI 和 Oracle 云已在首批 Helios 机架级系统上运行模型和工作负载。AMD 给出四季度营收指引约 170 亿美元(上下浮动 3%),中值同比约增长 66%。

核心要点速览

  • 数据中心营收 85.46 亿美元,同比 +97%、环比 +27%,占总营收约 64%(一年前约 47%);部门经营利润 28.82 亿美元,利润率 34%
  • 首批 Helios 机架(Instinct MI450 系列 GPU + 第六代 EPYC)已为 Anthropic、Meta、微软、OpenAI 和 Oracle 云运行模型,MI455X 本季度开始量产出货
  • 总营收 133.77 亿美元(+45%),非 GAAP 毛利率 56%、每股收益 2.09 美元;GAAP 净利润 24.28 亿美元,含 10.97 亿美元客户认股权证公允价值变动
  • 四季度营收指引约 170 亿美元 ±3%,中值同比约 +66%、环比约 +27%,非 GAAP 毛利率约 55%
  • 同期还发布 ROCm 10(含 ROCm.AI)、Helion 机架级 Agent 系统参考架构,并宣布拟收购 World Labs 与 Taalas
阅读全文
AD赞助内容

Flower Labs 发布 Endeavor 1.1:新增多模态与欧盟境内推理,可私有部署并开放思维链,自称比肩 OpenAI、Anthropic

联邦学习框架 Flower 背后的 Flower Labs 于 11 月 3 日发布 Endeavor 1.1,这是其今年第三个模型(继 4 月的英国主权 7B 模型 Lizzy、9 月的 Endeavor 1.0 之后)。新版本新增图像输入、可选欧盟境内 GPU 推理,支持 Flower 托管、私有云或本地部署,并承诺用户可查看完整思维链、拥有推理输出并用于训练自有模型。官方口径 GPQA 94.4、HumanEval 99.9、AIME 2026 99.9、MMMU-Pro 81.1,但对比对象是 GPT-5.6 Sol 与 Claude Fable 5 而非两家最新模型,且目前仅开放申请试用。

Flower Labs 发布 Endeavor 1.1:新增多模态与欧盟境内推理,可私有部署并开放思维链,自称比肩 OpenAI、Anthropic

核心要点速览

  • 官方口径:GPQA 从 1.0 的 92.0 升到 94.4(约少 30% 错误),HumanEval 从 98.2 升到 99.9,IFEval 94.5,MMMU-Pro 81.1。
  • 官方对比表中 GPT-5.6 Sol 为 GPQA 94.1、IFEval 95.9、MMMU-Pro 83.0,Claude Fable 5 为 GPQA 92.6;Endeavor 在 IFEval 和 MMMU-Pro 上并未领先。
  • 新增欧盟境内 GPU 推理并附 SLA,计划后续推出英国、中东、亚洲、非洲区域推理。
  • 卖点是可控:读取原始思维链、保留推理输出与轨迹,并可用来微调或训练自有模型。
  • 官方称模型基于成熟开源权重模型,经持续预训练、定向后训练与模型融合构建,未公开基座与参数规模;目前需申请访问。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Endeavor 1.1⚡ Endeavor 1.0⚡ GPT-5.6 Sol⚡ Claude Fable 5⚡ Kimi K3⚡ Nemotron 3 Ultra🌐 Flower Labs

Anthropic 开源 FlashProve:用 zkSNARK 证明回答确实出自承诺的模型,400B Llama 4 Maverick 单张 H100 约 110 token/秒

Anthropic Frontier Red Team 11 月 2 日发布研究文章并开源 FlashProve(Apache 2.0):模型提供方先对权重做隐藏承诺,之后为每次回答生成零知识证明,用户不需要权重、在普通 CPU 上就能验证回答确实来自该模型,可用来识别中转站偷换模型或 token 流被篡改。官方口径:Llama 4 Maverick(400B MoE,4-bit)上单张 H100 约 110 token/秒,每个 1,024 token 请求的证明约 19 MB,GPU 时间约为 vLLM 推理的 70–95 倍。这是不再维护的研究原型,上下文只支持 1,024 token、只覆盖整数化模型的贪心解码。Anthropic 工程师 Steve Weis 在 X 上转发了这次发布。

Anthropic 开源 FlashProve:用 zkSNARK 证明回答确实出自承诺的模型,400B Llama 4 Maverick 单张 H100 约 110 token/秒

核心要点速览

  • 官方口径:Llama 4 Maverick(400B MoE,4-bit)单张 H100 证明速度约 110 token/秒(24 请求一批的 prefill),每个 1,024 token 请求证明约 19 MB。
  • 代价不小:GPU 时间约为 vLLM 推理的 70–95 倍;仓库性能页显示服务端需约 270 GB 内存,一次权重承诺约 39 分钟。
  • 验证不需要 GPU:C++ 验证器单线程约 21 秒验完一个证明;另有可证明正确的 Lean 验证器,安全性定理在 Lean 4 中给出证明。
  • 对比此前开源方案:VerInf 在同一模型上约 0.02 token/秒;商业方案 Attestable 在 Gemma 4 31B 上 53–77 token/秒,但未开源。
  • 限制:v0.16.0 为不再维护的研究原型,上下文 1,024 token,只覆盖整数化模型的贪心解码,不隐藏模型架构。
阅读全文
关联模型 / 智能体 / 厂商:

韩国 2027 年预算 AI 与芯片投入翻倍至 21.3 万亿韩元:4.7 万亿砸向国家级前沿模型,采购 1 万张 Vera Rubin GPU

韩国总统李在明 11 月 2 日在国会发表 2027 年预算施政演说:总预算 820.9 万亿韩元(+12.8%),其中半导体、物理 AI、AI 数据中心三大项目及 AI 投入合计 21.3 万亿韩元(约 160 亿美元),比 2026 年的 10.8 万亿几乎翻倍。企划财政部官方预算文件显示,4.7 万亿韩元用于打造「全球顶级性能」的国家独立 AI 模型,包括采购 1 万张 Vera Rubin GPU。预算仍需国会通过。

韩国 2027 年预算 AI 与芯片投入翻倍至 21.3 万亿韩元:4.7 万亿砸向国家级前沿模型,采购 1 万张 Vera Rubin GPU

核心要点速览

  • 三大项目及 AI 投入从 10.8 万亿增至 21.3 万亿韩元,增幅 97.2%;总预算 820.9 万亿韩元,同比 +12.8%(官方预算文件)。
  • 前沿 AI 模型专项 4.7 万亿韩元:3.9 万亿采购 1 万张 Vera Rubin GPU、0.8 万亿购买训练数据、250 亿韩元引进 20 名海外顶尖研究者。
  • 模型研发期间先投入政府已有的约 7000 张 GPU,并租用产学研约 8000 张;入选企业通过公开评选产生,政府以出资方式参与、分享收益。
  • 「全民 AI」新增 0.25 万亿韩元,基于国产模型提供公共 AI 智能体,可代办身份证明、KTX 订票、护照补办等;AI 教育 2.1 万亿覆盖 390 万人。
  • 另拨 700 亿韩元开发专用 AI 安全模型,500 亿韩元为 1 万家中小企业补贴 AI 安全方案订阅费;物理 AI 预算从 0.9 万亿增至 3.1 万亿。
阅读全文

a16z「Rack Spread」图表:5 月以来 token 均价降 67%,token 总花费反涨 122%–160%,GPU 租金同期上涨

a16z 10 月 30 日发布的 Charts of the Week(作者 Moses Sternstein)讨论了「Rack Spread」:GPU 租金在涨,token 价格在跌。a16z 官方 X 账号 10 月 31 日总结:5 月以来 token 均价下降 67%,token 花费增长超过 120%;按文章的粗算,用 Ramp 数据得出约 122%,用 Ornn 混合单价乘 OpenRouter 用量得出约 160%。另一条帖子给出 7 月中以来 B300 租金涨 106%、B200 涨 66%、H100 涨 17%。a16z 同时强调这些指数样本小且有偏差,不能代表真实总需求。

a16z「Rack Spread」图表:5 月以来 token 均价降 67%,token 总花费反涨 122%–160%,GPU 租金同期上涨

核心要点速览

  • 价格与花费:5 月以来 token 均价降 67%,token 花费涨超 120%(a16z 官方 X 帖,a16z 口径)
  • 两种粗算:Ramp 的 token 花费数据约 +122%;Ornn 混合单价 × OpenRouter 用量约 +160%(Charts of the Week,作者自称是粗算而非严谨方法)
  • GPU 租金:7 月中以来 B300 +106%、B200 +66%、H100 +17%,同期 token 均价 -58%(a16z 帖子)
  • 人均 AI 支出:亚特兰大联储调查的均值超过每员工 1,000 美元,Ramp 的中位数是每月 15.70 美元(每年 188 美元)
  • 热度:两条帖子约 371 和 492 赞、3.8 万和 9.6 万浏览(截至 18:15 SGT)
阅读全文

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

NVIDIA 官方博客 10 月 30 日披露,Breakthrough Listen 与 SETI 研究所已把 Agent 接入北加州艾伦望远镜阵列(ATA,42 面 6 米天线)的日常地外文明搜索:研究员用一句自然语言请求,Agent 就能转动天线、校准聚焦、纠正数据错误并对实时数据流跑 AI 模型。底层由 Holoscan 的 DAQIRI 库把传感器数据直接送进 GPU 显存,SETI 研究所的 CyberEther 做信号处理,Web 编排器 Nexus 充当 Agent harness,在 RTX PRO 6000 Blackwell 上本地处理最高 2.4 Tbps。系统已完成首次蟹状星云脉冲星的实时 AI 检测;团队正在评估 Nemotron 等开放模型。@NVIDIAAI 10 月 31 日万圣节帖约 274 赞。

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

核心要点速览

  • 吞吐:在 NVIDIA RTX PRO 6000 Blackwell GPU 上最高处理 2.4 Tbps 射电数据,推理在望远镜旁本地运行(NVIDIA 博客,厂商口径)
  • 三层架构:DAQIRI 把传感器数据直送 GPU 显存,CyberEther 用 cuFFT/cuBLAS 做信号处理,Nexus 作为 Agent harness 管理仪器状态、算力和流水线
  • 能力:一句自然语言即可转动 ATA 的 42 面 6 米天线、校准聚焦、修正数据错误并出图;官方称把人类数周到数年的工作压缩到数小时
  • 里程碑:完成蟹状星云脉冲星的首次实时 AI 检测;官方未公布误报率等量化指标,也没有发现地外信号
  • 下一步:评估 Nemotron 等开放模型,用于数据本地性要求高、甚至未来可能在月球背面离线运行的天文台
阅读全文
关联模型 / 智能体 / 厂商:

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

扩散智能 DiffuSpace(成员来自推出 Dream 7B 的港大 NLP 实验室)10 月 28 日发布首个模型 Clover-35B-A3B-Preview:基于 Qwen3.6-35B-A3B 初始化的 MoE 扩散语言模型,总参 35B、激活约 3B、128K 上下文,按块并行去噪生成。官方口径下 SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、GPQA Diamond 83.8,单张 GB300 上 Agent 场景生成速度 680 tokens/s。权重 Apache 2.0,已上 Hugging Face、ModelScope 和 GitHub,支持 SGLang 与 llama.cpp。

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

核心要点速览

  • 35B 总参、约 3B 激活的 MoE 扩散模型,由 Qwen3.6-35B-A3B 初始化,128K 上下文,支持思考模式
  • 官方称六项 Agent 评测全部第一:SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、τ³ Overall 65.3,超过 LLaDA2.2 flash、Mercury 2.5 和 Qwen3.6-35B-A3B
  • 速度(官方口径):单张 GB300、BF16、batch=1 下 Agent 场景 680 tokens/s;单张 H200 上 515 tokens/s,高于 DFlash2 加速 Qwen 的 365 tokens/s
  • INT4 量化后可在 16GB 显存的 RTX 5070 Ti 上运行,MATH-500 生成速度 101.8 tokens/s
  • Hugging Face 权重 Apache 2.0,BF16 约 69GB,官方推荐用 SGLang 部署
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Clover-35B-A3B-Preview⚡ Qwen3.6-35B-A3B⚡ Dream 7B⚡ LLaDA2.2 flash⚡ Mercury 2.5🌐 DiffuSpace🌐 HKU NLP🌐 Alibaba Qwen🌐 NVIDIA
AD赞助内容

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

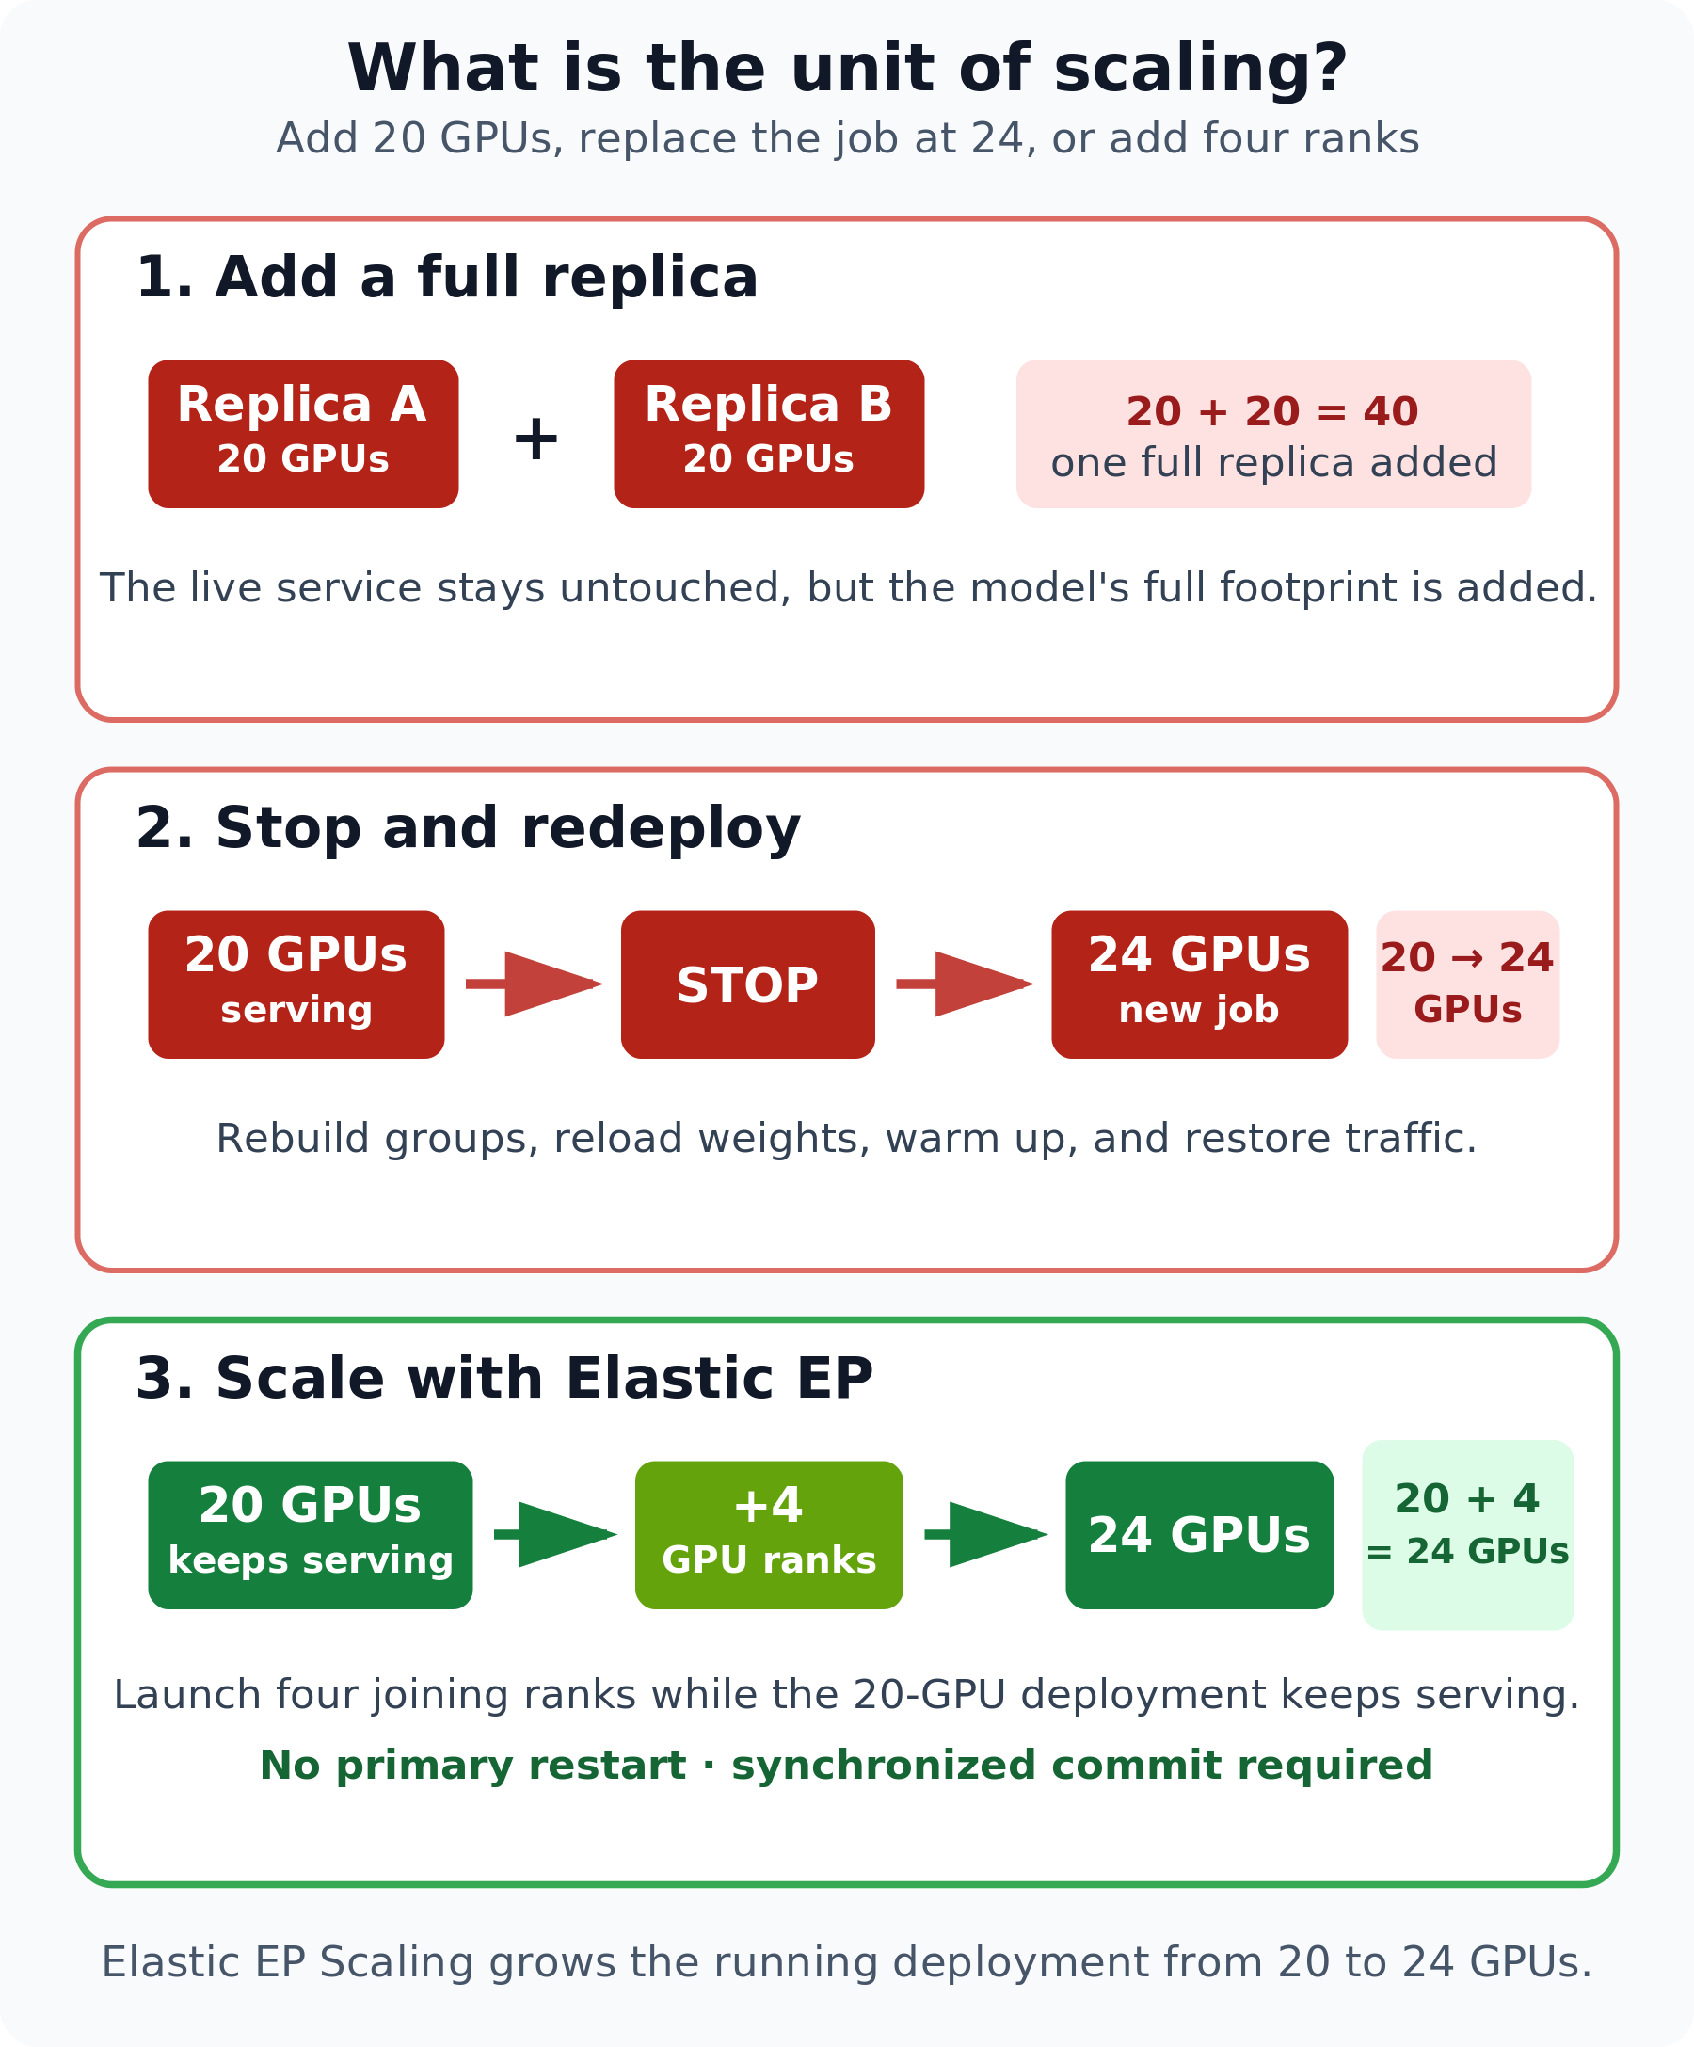
LMSYS 团队联合 NVIDIA Dynamo 团队在官方技术博客与 X(@lmsysorg)正式宣布,高性能大模型推理框架 SGLang 推出弹性专家并行(Elastic EP)与 NIXL(Near-Instant Cross-Node Link)动态伸缩后端。针对超大 MoE 架构(如 DeepSeek-V3/V4)在传统静态专家并行下因单卡硬件故障导致全集群崩溃重启、以及业务高峰期无法在线扩容的严重痛点,Elastic EP 实现了专家-GPU 映射解耦。依托 NVIDIA NIXL 高性能通信原语与 Mooncake 调度器,SGLang 首次实现在完全不中断在线推理请求的前提下,将运行中的 MoE 集群动态扩容(如从 20 卡无感扩展至 24 卡),并支持单节点故障的秒级自动降级容错。

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

核心要点速览

  • LMSYS 与 NVIDIA Dynamo 团队联手发布 SGLang Elastic EP,正式支持 MoE 模型在线动态扩缩容
  • 彻底破解静态专家并行(Static EP)在单节点硬件故障时全集群宕机的致命痛点,支持秒级自动容错降级
  • 集成 NVIDIA NIXL 高性能跨节点通信原语(--moe-a2a-backend nixl),支持 RDMA 与 NVLink 原生零拷贝调度
  • 实现零停机在线扩容(Live Scale-Up),集群可在持续处理生产推理请求的同时从 20 卡在线平滑扩容至 24 卡
阅读全文

VS Code 1.143 发布:基于 Copilot SDK 的 harness 成为新会话默认,新增多模型对比与本地运行 MAI Code 1.1 Flash

微软发布 Visual Studio Code 1.143:基于 Copilot SDK 的 Copilot harness 成为新会话默认,可在编辑器和 Agents 窗口间切换;Agents 窗口新增 Compare Models 预览,可让多个模型并行做同一任务并由 Judge 模型打分;实验性支持在本地 NVIDIA GPU 上运行 MAI Code 1.1 Flash,大型对话打开速度也显著提升。

VS Code 1.143 发布:基于 Copilot SDK 的 harness 成为新会话默认,新增多模型对比与本地运行 MAI Code 1.1 Flash

核心要点速览

  • 默认 harness:新会话默认使用基于 Copilot SDK 的 Copilot harness,会话可在后台运行,并在编辑器与 Agents 窗口间切换
  • Compare Models(预览):一次提示让 2 个以上模型并行尝试,可混用 Copilot、Claude、Codex harness,再由 Judge 模型给出时间和 token 用量评分,可选 Synthesize 合并方案
  • 本地模型(实验):可下载 MAI Code 1.1 Flash 在本机运行,标注 On-device 且不消耗 AI credits;要求 NVIDIA GPU 显存 96 GB 以上
  • 性能(官方口径):约 1,150 次请求的大型对话冷启动打开时间从 35.6 秒降到 9.0 秒,窗口无响应时间从 28.3 秒降到 0.6 秒
  • 其它:编辑器诊断高亮上限从 500 提到 5,000 条;Windows 安装包可选装 GitHub Copilot CLI
阅读全文

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

欧洲前沿 AI 巨头 Mistral AI 与 NVIDIA 在 GTC Berlin 宣布达成工业工程 AI 深度战略合作,全面加速物理 AI、计算机辅助工程(CAE)与芯片设计(EDA)的智能化变革。合作将 Mistral 旗舰模型与 NVIDIA CUDA-X、Warp 物理引擎以及 Omniverse 实时数字孪生进行全链路打通。官方博客同时公布了备受瞩目的下一代旗舰模型 Mistral Large 4 的核心技术参数:总参数量接近 1 万亿(1T),激活参数为 490 亿(49B MoE),在 3800 张 Grace Blackwell GPU 集群上训练完成,模型权重定于 10 月底正式开源发布,并将联合 Nemotron 联盟共建工业基座。

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

核心要点速览

  • Mistral AI 与 NVIDIA 官宣战略合作,将大模型能力全面注入计算机辅助工程(CAE)、物理仿真与半导体芯片设计(EDA)
  • 深度融合 NVIDIA Warp、CUDA-X 物理加速库与 Omniverse 数字孪生平台,构建工程仿真领域的开源智能体评测与基准
  • 首次正式公开 Mistral Large 4 核心规格:约 1 万亿总参、49B 稀疏激活 MoE 架构,在 3800 张 Grace Blackwell 算力集群完成预训练
  • Mistral Large 4 官方权重定于 2026 年 10 月底全量开源发布,并宣布双方加入 Nemotron 联盟向 2030 年 1 GW 绿色算力推进
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

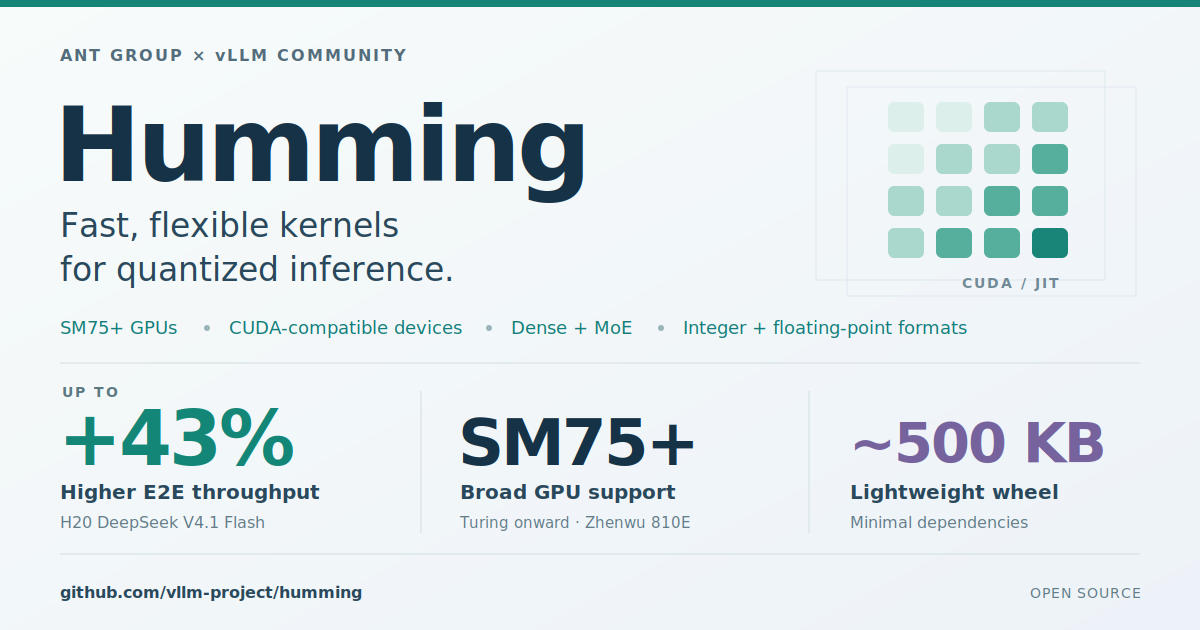
vLLM 官方联合蚂蚁集团正式开源底层高性能量化推理算子库 Humming(humming-kernels)。该算子库专为大规模混合专家(MoE)与低精度密集模型的高并发服务而设计,全面覆盖 WnA16、W8A8、W4A8 与 W4A4 多种量化精度,横跨 INT1~INT8 与 FP4~FP8 数据格式,并原生适配从 NVIDIA Turing 到 Blackwell 架构及平头哥真武 810E 芯片。实测显示,Humming 算子在小 Batch 下比 cuBLAS 快 3~4 倍,在大 Batch 下比 Marlin 快 2 倍;在 8 张 H20 GPU 上运行 DeepSeek-V4.1-Flash,64 并发下整机端到端吞吐暴增 43.3%,首字时延(TTFT)大幅降低 32%,现已作为默认引擎整合至 vLLM v0.29.0+ 中。

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

核心要点速览

  • vLLM 与蚂蚁集团联合开源 Humming 高性能算子库(Apache 2.0),现已原生内置于 vLLM 0.29.0+ 核心代码中
  • 全方位打通 WnA16、W8A8、W4A8 与 W4A4 低比特精度,算子即时编译耗时仅需 1.82 秒(相比 CUTLASS 的 23.35 秒提速 12 倍)
  • 在 8 卡 H20 集群部署 DeepSeek-V4.1-Flash 实测:64 并发下吞吐从 442 提升至 634 tokens/s(净增 +43.3%)
  • 首字生成时延(TTFT)缩减 25%~32%,在下一代 B300 架构上 MoE 核心算子实现最高 5 倍极限加速
阅读全文

vLLM 与蚂蚁集团开源量化推理内核库 Humming:一套内核覆盖多种量化格式和 Turing 以来全部 NVIDIA GPU,DeepSeek-V4.1-Flash 端到端吞吐提升 14%–43%

10 月 21 日,vLLM 社区与蚂蚁集团开源 Humming(Apache 2.0),一个用 JIT 编译按需生成 GEMM 内核的量化推理库,支持 Turing 起所有 NVIDIA 架构及平头哥真武 810E,覆盖 INT1–INT8、FP4–FP8 等权重/激活组合和稠密、MoE 两类负载。官方微基准中部分场景比 vLLM Marlin、FlashInfer、DeepGEMM 快 2–5 倍;在 8 张 H20 上跑 DeepSeek-V4.1-Flash,MoE 从 Marlin W4A16 换成 Humming W4A8 后吞吐提升 14%–43%。vLLM 0.29.0 起已内置。

vLLM 与蚂蚁集团开源量化推理内核库 Humming:一套内核覆盖多种量化格式和 Turing 以来全部 NVIDIA GPU,DeepSeek-V4.1-Flash 端到端吞吐提升 14%–43%

核心要点速览

  • 一套 JIT 内核框架替代按格式各写一个内核:支持 WNA16、W8A8、W4A8、W4A4,INT1–INT8 与 FP4–FP8 权重,稠密与 MoE
  • 硬件:Turing(SM75)起全部 NVIDIA GPU,含 Blackwell SM100/103/120/121,以及平头哥真武 810E
  • 端到端:8×H20、TP=8 跑 DeepSeek-V4.1-Flash,Humming W4A8 比 Marlin W4A16 吞吐高 14%–43%,平均 TTFT 降 25%–32%;并发 64 时输出 442→634 tok/s
  • 微基准(vLLM 社区测):H200 W4A8-MXFP4 约为 DeepGEMM W8A8 的 4.5 倍,B300 MoE Grouped 路径约为 Marlin 的 5 倍;单个 W4A16 内核编译 1.82 秒,CUTLASS 为 23.35 秒
  • 使用:pip install humming-kernels(wheel 约 500 KB);vLLM 0.29.0 起内置,用 --linear-backend humming --moe-backend humming 启用
阅读全文
关联模型 / 智能体 / 厂商: