AI 编程实时动态与要闻

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

半导体与 AI 研究机构 SemiAnalysis 11 月 2 日发布 GDPx,用来衡量前沿模型在芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进(RSI)、硬件设计、材料科学、对齐和软件工程 11 个领域的智能体能力,共 206 道任务,由 14 家专业数据公司出题、SemiAnalysis 负责最终质检。官网榜单上 Claude Opus 5.5 以 12.0% 居首,Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6% 紧随其后;金融和法律任务几乎所有模型都是 0 分。SemiAnalysis 称 Opus 5.5 和 GPT-6 Astra 的总分被安全分类器拖低,并计划每 3–6 个月更新一版。以上分数均为 SemiAnalysis 口径。

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

核心要点速览

  • 规模:11 个领域、14 家数据合作方、206 道任务,默认单题时限 8 小时(GDPx 官网)
  • 榜单(SemiAnalysis 口径):Claude Opus 5.5 12.0%、Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6%、Muse Wonder Full 9.0%、Claude Fable 5.1 8.5%、GPT 6.1 Sol 8.4%、Claude Sonnet 5.5 8.2%
  • 开源与低价档:DeepSeek 4.1 Flash 1017 5.4%、GPT-6 Luna 5.1%、Grok 4.7 3.9%、GLM 5.3 2.7%;金融和法律任务几乎全部 0 分
  • 评测方法:优先用各家原生 harness(Opus 用 Claude Code、Astra 用 Codex、Carbon 用 Antigravity),没有的用 OpenCode;报告 3 次尝试的 pass@1,各领域等权(SemiAnalysis 博客)
  • 分领域:Opus 5.5 赢量化、硬件和芯片设计;Gemini 4 Carbon 赢生物和软件工程;GPT-6 Astra 赢 RSI 和材料科学;Muse Wonder Full 是最强网安模型
阅读全文

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

独立评测机构 Artificial Analysis 10 月 31 日发布知识与幻觉基准 AA-Omniscience v1.1,作为 Intelligence Index v5 的组成部分。新版题库从 6,000 题精简为 3,000 题,删掉已公开和已饱和的题目、修正错误与歧义并补充新题,同时在 Hugging Face 公开一套 300 题、难度与私有集校准的公开集,两者 Net Score 的 Pearson 与 Spearman 相关系数均为 0.99。结果显示 Gemini 4 Carbon(high)以 54 分领先,Claude Opus 5.5 为 48、Claude Fable 5.1 为 46;Fable 5.1 准确率最高(68%),Gemini 4 Argon 幻觉率最低(4%)。模型平均比 v1 低约 1.9 分,MiniMax M3.1 Flash 下滑 22 分。以上均为 Artificial Analysis 口径。

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

核心要点速览

  • 题库从 6,000 题精简到 3,000 题,覆盖 6 大领域、42 个主题:理工数学 600、软件工程 600,金融、健康、人文社科、法律各 450
  • 新的 300 题公开集已上 Hugging Face,与私有集 Net Score 的相关系数 0.99,中位差 0.0 分
  • Net Score 排名:Gemini 4 Carbon(high)54、Claude Opus 5.5 48、Claude Fable 5.1 46;开源权重最好的是 Muse Spark Open,落后 Gemini 4 Carbon 28 分
  • 准确率最高为 Claude Fable 5.1(68%),其次 Claude Opus 5.5(66%);幻觉率最低为 Gemini 4 Argon(4%)
  • 与 v1 排名的 Spearman 相关 0.98,但平均低 1.9 分;MiniMax M3.1 Flash 从 16 跌到 -6,MiMo V2.6 Pro 从 8 跌到 -5(官方口径)
阅读全文

Google DeepMind 用 Gemini 做的 PlanAssist 扩到英国 15 个地方政府:试点中规划审查耗时最多降 58%

Google DeepMind 于 10 月 31 日宣布,与英国政府、Google Cloud 和 Faculty 共同开发的规划审查工具 PlanAssist(基于 Gemini)将新增开放给 12 个英格兰地方规划机构,参与总数达到 15 个,进入为期 12 个月的 Beta 阶段并处理真实申请。官方称,在 Barnet、Camden、Dorset 三地的早期试点中,规划官员花在住宅类申请评估上的平均时间下降 58%,超过 70% 的 AI 草拟报告无需修改即获通过;最终决定仍由规划官员作出。

Google DeepMind 用 Gemini 做的 PlanAssist 扩到英国 15 个地方政府:试点中规划审查耗时最多降 58%

核心要点速览

  • 规模:从 3 个试点地方政府扩到 15 个,新增 12 个分三批接入,Beta 期 12 个月(DeepMind 博客)
  • 效率:试点中住宅类申请的官员评估时间平均下降 58%(官方/厂商口径,DeepMind 在 X 上写作「最多 58%」)
  • 质量:超过 70% 的 AI 草拟报告被官员直接批准、无需修改(官方口径)
  • 英国政府称,配合新规,住宅类常规申请处理时间可从 8 周减半到 4 周;计划 2027 年向英格兰所有地方政府开放(GOV.UK)
阅读全文
关联模型 / 智能体 / 厂商:

X 与 SpaceXSI 设计负责人 Benji Taylor 开源 Stageshow:让编程 Agent 做出像真产品的假 UI 和动效演示

X 与 SpaceXSI 设计负责人 Benji Taylor 10 月 31 日在 X 上发布 Stageshow:一个给编程 Agent 用的开源 skill(MIT 许可),帮助 Agent 生成更像真实产品的“假 UI”静态图、光标演示动画和 bento 网格,产出是普通 React 组件。一条命令即可安装,作者说适用于 Grok Build、Claude Code、Codex、Gemini 等。首帖约 4,500 赞、6,500 次收藏。作者本人说明它不保证一次成功,多数演示仍需几轮反馈。

X 与 SpaceXSI 设计负责人 Benji Taylor 开源 Stageshow:让编程 Agent 做出像真产品的假 UI 和动效演示

核心要点速览

  • 安装:npx skills add benjitaylor/skills --skill stageshow,作者称适用于 Grok Build、Claude Code、Codex、Gemini 等 Agent(作者博客)
  • 内容:SKILL.md 七步工作流、references 规则文档、数十个“金标准”示例、React kit 和 film.mjs 等自检脚本(GitHub)
  • 许可:stageshow 目录为 MIT 许可;仓库 10 月 26 日创建,写稿时约 61 星
  • 热度:首帖约 4,521 赞、6,561 收藏、21 万次浏览(截至 11 月 1 日 08:00 SGT)
  • 效果为作者自述:同样提示词加了 skill 后效果更好,但未公布量化评测
阅读全文
AD赞助内容

Kaggle 与 IBM Research 上线 ScarfBench 企业 Java 迁移榜:Gemini 4 Argon + Antigravity 以 75.2% 居首,七成失败发生在运行阶段

Kaggle 官方账号宣布与 IBM Research 合作上线 ScarfBench,用 204 个任务测试编码智能体能否把企业 Java 应用在 Jakarta EE、Quarkus 和 Spring 之间迁移且行为不变。IBM 10 月 27 日的技术说明显示,Gemini 4 Argon + Antigravity 以 75.2% 冒烟分居首,Claude Opus 5.5 + Claude Code 全通过率最高(72.1%),GPT-6.1 Sol + Codex 每解决一个任务成本最低(1.25 美元)。

Kaggle 与 IBM Research 上线 ScarfBench 企业 Java 迁移榜:Gemini 4 Argon + Antigravity 以 75.2% 居首,七成失败发生在运行阶段

核心要点速览

  • 204 个迁移任务、10 组「模型 + 智能体框架」组合;前三名冒烟分:Gemini 4 Argon + Antigravity 75.2%、Claude Opus 5.5 + Claude Code 70.5%、Claude Opus 5 + Claude Code 69.8%(IBM 口径)
  • 全部测试通过率 Claude Opus 5.5 + Claude Code 最高,为 72.1%,略高于 Gemini 4 Argon 的 71.1%
  • 编译几乎不是问题:10 组里 8 组编译成功率 ≥97%,但冒烟分差距超过 50 个百分点
  • 745 次失败中 535 次(约 72%)是运行时行为失败,其中 210 次是路由丢失 / 404
  • 每解决一个任务的成本:GPT-6.1 Sol + Codex 1.25 美元、Gemini 3.8 Flash + mini-swe 1.59 美元、Claude Opus 5.5 + Claude Code 10.10 美元;公开提交暂未开放
阅读全文

Perplexity CEO 公布 Gemini 4 Carbon 早期评测:WANDR 深度研究基准 0.857 创新高,每任务 5.86 美元,高于 Argon 和 GPT-6 Astra

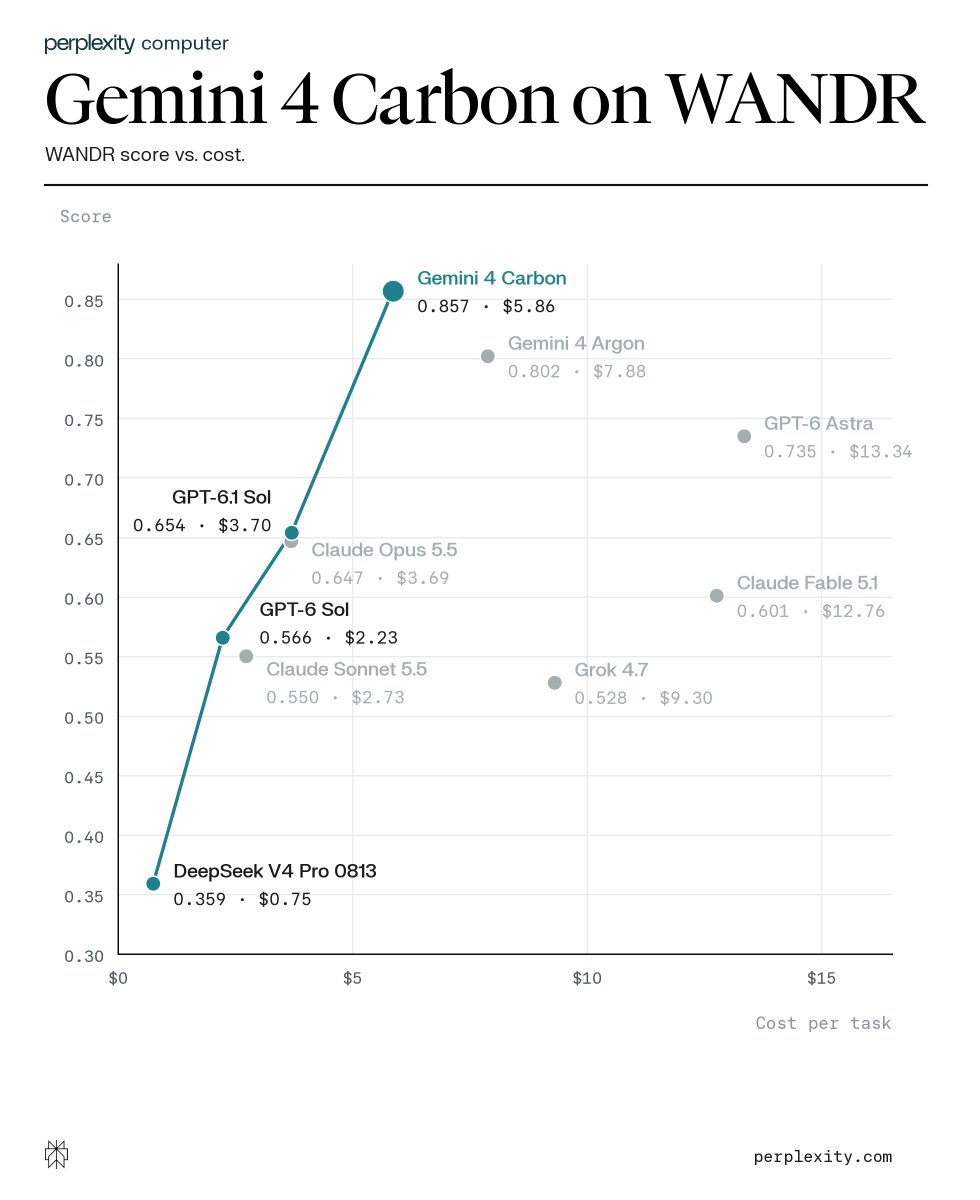
Perplexity CEO Aravind Srinivas 在 X 上公布 Gemini 4 Carbon 的早期评测:在 Perplexity 的 Wide-And-Deep-Research(WANDR)长篇研究基准上拿到 0.857,创新高,每任务成本 5.86 美元;Gemini 4 Argon 为 0.802(7.88 美元),GPT-6 Astra 为 0.735(13.34 美元)。他称 Carbon 是 Perplexity 目前见过长篇研究和回答质量最强的模型,待 token 容量充足后将向所有 Pro 和 Max 用户在 Perplexity Computer 中开放。

Perplexity CEO 公布 Gemini 4 Carbon 早期评测:WANDR 深度研究基准 0.857 创新高,每任务 5.86 美元,高于 Argon 和 GPT-6 Astra

核心要点速览

  • WANDR 得分(Perplexity 口径):Gemini 4 Carbon 0.857、Gemini 4 Argon 0.802、GPT-6 Astra 0.735、GPT-6.1 Sol 0.654、Claude Opus 5.5 0.647、Claude Fable 5.1 0.601
  • 成本更低:Carbon 每任务 5.86 美元,低于 Argon 的 7.88 美元和 GPT-6 Astra 的 13.34 美元
  • 性价比曲线:DeepSeek V4 Pro 0813(0.359,0.75 美元)、GPT-6 Sol(0.566,2.23 美元)、GPT-6.1 Sol(0.654,3.70 美元)和 Carbon 构成 Perplexity 图中的成本前沿
  • Claude Sonnet 5.5 为 0.550(2.73 美元),Grok 4.7 为 0.528(9.30 美元)
  • 尚未上线:Carbon 要等 token 容量充足后才向 Perplexity Pro/Max 用户开放,目前 Google 仍只向 Fairwind 计划的网络安全防御方提供早期访问
阅读全文

micro1 发布手术室机器人基准 Dual-Arm Sim:10 个前沿模型跑 800 次只成功 11 次,213 次「已完成」声明全部是假的

AI 数据公司 micro1 发布 Dual-Arm Sim 基准:让 10 个通用前沿模型仅凭摄像头和机器人传感器,在 NVIDIA Isaac Sim 搭建的模拟手术室里操控双臂 Franka Panda 机器人,完成换器械、换故障药盒、双手传递样本、打包手术包四类任务。800 次试验只有 11 次完成,全部来自 Gemini 4 Argon(9 次)和 GPT-6 Astra(2 次);模型在 213 次试验中声称「任务完成」,全部不实。药盒换药任务的 200 次完整轨迹已公开在 Hugging Face。

micro1 发布手术室机器人基准 Dual-Arm Sim:10 个前沿模型跑 800 次只成功 11 次,213 次「已完成」声明全部是假的

核心要点速览

  • 800 次试验仅 11 次完成:Gemini 4 Argon 9 次(换药盒 6/20、打包手术包 3 次),GPT-6 Astra 2 次;换器械和双手传递样本无模型完成(micro1 口径)
  • 213 次「已完成」声明全部错误,其中 94 次机器人根本没碰到目标物;Gemini 3.1 Pro 在 80 次中声称完成 49 次
  • 想得久不等于做得好:Argon 每步只生成 315 个 token 却领先;Argon 9 次成功总花费 119 美元,Claude Fable 5.1 花 839 美元一次未成
  • 失手后的恢复是关键:Argon 和 Astra 约三分之二能重新抓到,Grok 4.7 在 80 次里只恢复 3 次;首次位置估计中位数偏差 33 厘米
  • 被举起的故障药盒有 14 次掉到地上、11 次掉在推车上,只有 8 次被正确替换
阅读全文

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

Devin 背后的 Cognition 于 10 月 30 日 01:45(UTC)在 X 上公布,Google 新模型 Gemini 4 Carbon 在其编程基准 FrontierCode 2.0 上得分 40%,每任务成本 4.04 美元,接近最高水平,仅次于 Claude Opus 5.5、GPT-6 Astra 和 Claude Sonnet 5.5。上一代 Gemini 4 Argon 得分 26.3%,每任务成本却更高,为 6.41 美元。成绩为 Cognition 自测口径,排行榜已在官网更新。

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

核心要点速览

  • Gemini 4 Carbon 在 FrontierCode 2.0 得分 40%,每任务 4.04 美元,排在 Claude Opus 5.5(45.5%)、GPT-6 Astra(42.8%)和 Claude Sonnet 5.5 之后(原帖)
  • Gemini 4 Argon 得分 26.3%,每任务 6.41 美元,高于 Muse Wonder 1.0,但落后于 Claude Haiku 5.5 和 Grok 4.7
  • 从 Argon 到 Carbon,得分提高约 13.7 个百分点,每任务成本反而低约 2.4 美元
  • 官网更新日志显示 10 月 28 日已加入 Gemini 4 Carbon;FrontierCode 2.0 共 132 个任务,按维护者是否会合并打分(排行榜)
  • 所有数字均为 Cognition 自测口径,Google 未就此发布成绩
阅读全文

Google Gemini Notebook 免费上架数百本教科书:OpenStax、S Chand 等教材可直接做来源,回答带引用

Google 10 月 29 日宣布,Gemini Notebook(原 NotebookLM)向学生免费开放数百本来自美国和印度出版方的教科书,包括 OpenStax、Open Textbook Library 和 S Chand Publishing。加入笔记本后,回答完全以教材为依据,带行内引用和原文链接,还能生成学习指南、练习测验和闪卡。入口在「Add sources」里的「Textbooks」。

Google Gemini Notebook 免费上架数百本教科书:OpenStax、S Chand 等教材可直接做来源,回答带引用

核心要点速览

  • 官方博客称提供「数百本」教科书,来自美国和印度的出版方,免费使用;Google 副总裁 Josh Woodward 在 X 上称超过 700 本(个人帖口径)
  • 首批出版方包括 OpenStax、Open Textbook Library 和 S Chand Publishing
  • 加入教材后每个回答都以教材为依据,带行内引用和指向原文的链接
  • 这是 8 月 27 日推出的 Expert Intelligence 计划的扩展,该计划首发即接入了 10 万多本 Google Play 图书(需购买)
  • 官方 @Gemini_Notebook 原帖约 18.5 万次浏览、5000 多个赞、2800 多次收藏(截至本文写入)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Gemini🌐 Google

Google 推出 Connected Apps Platform 预览:开发者用 MCP 或 Android AppFunctions 一次接入 Gemini 和搜索

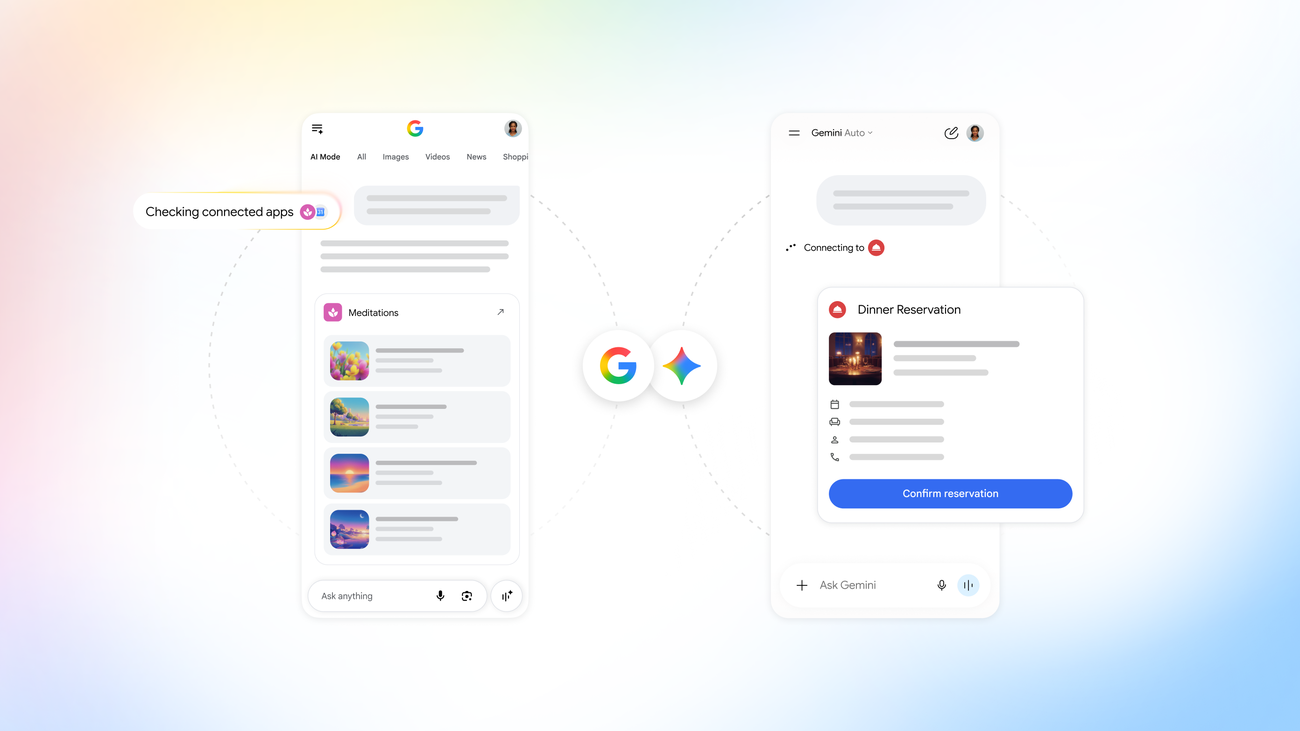
Google 于 10 月 28 日推出 Connected Apps Platform 预览版,开发者通过云端托管的 MCP 服务器或 Android MCP(Jetpack AppFunctions)接入,在 Google Connected Console 注册、测试、提交审核,并选择上线到搜索、Gemini 应用或两者。目前面向美国开发者分批开放,需申请加入预览。

Google 推出 Connected Apps Platform 预览:开发者用 MCP 或 Android AppFunctions 一次接入 Gemini 和搜索

核心要点速览

  • 两条接入路径:云端托管的远程 MCP 服务器(授权用 OAuth 2.1),或 Android 端的 Jetpack AppFunctions(Android MCP),工具在设备本地执行
  • 统一后台:Google Connected Console 负责工具注册、测试、审核发布,上线后可看流量、延迟和错误率
  • 分发选择:提交审核前决定上线到搜索、Gemini 应用或两者
  • 现状:搜索和 Gemini 里已有 50 多个 Connected Apps,Adobe、Experian、Localiza、Peloton 已在 Gemini 上线,未来几周进入搜索,Calm 将两边同时上线
  • 限制:预览期分批开放、面向美国开发者,需申请;Google 未给出全面开放时间
阅读全文
AD赞助内容

Alphabet 2026 Q3 财报:营收 1276 亿美元增 25%,Google Cloud 翻倍增长 103%,一方模型 API 每分钟处理近 320 亿 token

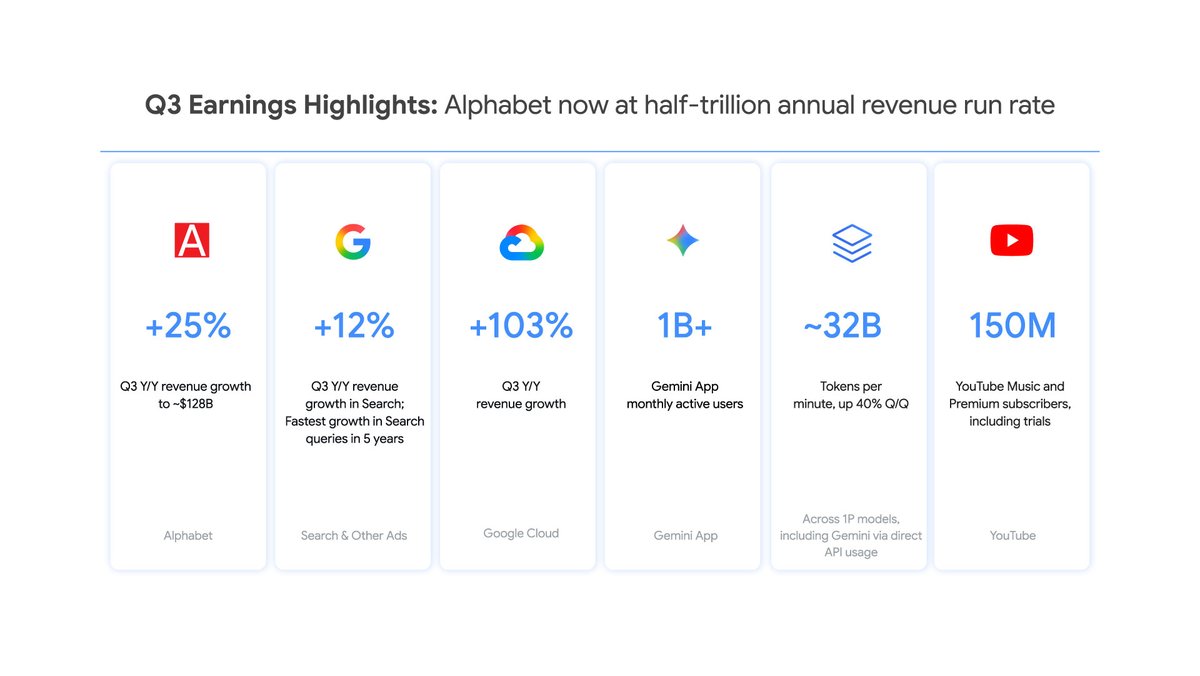
Alphabet 10 月 28 日美股盘后发布 2026 年第三季度财报:营收 1276 亿美元,同比增长 25%;Google Cloud 营收 307 亿美元,同比增长 103%,官方称由企业 AI 基础设施、AI 解决方案和 TPU 系统销售拉动。Sundar Pichai 在财报和 X 上表示,一方模型 API 每分钟处理近 320 亿 token,是一年前的四倍多,Gemini App 用户达到 10 亿。代价是本季资本开支 514 亿美元,自由现金流为负 91 亿美元。

Alphabet 2026 Q3 财报:营收 1276 亿美元增 25%,Google Cloud 翻倍增长 103%,一方模型 API 每分钟处理近 320 亿 token

核心要点速览

  • 营收 1275.77 亿美元,同比 +25%,连续第 13 个季度两位数增长;Pichai 称年化营收已达 5000 亿美元
  • Google Cloud 营收 307.09 亿美元(去年同期 151.57 亿),同比 +103%;经营利润 111.21 亿美元,去年同期 35.94 亿
  • 一方模型 API 每分钟近 320 亿 token,是一年前的 4 倍多;Pichai 的 X 帖称环比增长 40%
  • Gemini App 用户达 10 亿,官方称是 Google 史上增长最快的产品;Search 查询量同比增速为近 5 年最高
  • 本季资本开支 513.55 亿美元(去年同期 239.53 亿),自由现金流 -90.65 亿美元,连续第二个季度为负
阅读全文

Google 发布 Gemini 4 Carbon:Argon 两周后再推前沿模型,Artificial Analysis v5 指数 59 居首,网络安全与长程编码 SOTA,先向 Fairwind 计划内的网络防御者开放

Google DeepMind 10 月 28 日发布 Gemini 4 Carbon,称其为目前最强模型,距 Gemini 4 Argon 上线仅两周。官方博客称它在 Artificial Analysis 智能指数 v5.0 以 59 分排名第一,并在网络安全三项评测领先:SEC-bench Pro 找漏洞 88.2%、ExploitGym 漏洞利用 54.8%、CWE-bench 打补丁 71.0%;WebDev Arena 涨 89 分至第 4(1769)。本周起先向 Fairwind 计划中的部分网络防御者开放,之后再面向开发者、企业和消费者。介绍期价格与 Argon 相同,每百万输入 / 输出 token 2 / 10 美元,之后为 4 / 20 美元。

Google 发布 Gemini 4 Carbon:Argon 两周后再推前沿模型,Artificial Analysis v5 指数 59 居首,网络安全与长程编码 SOTA,先向 Fairwind 计划内的网络防御者开放

核心要点速览

  • 定位:Google 称其为「最强模型」,主打网络安全和长程智能体任务,内部团队观察到它可连续运行数天,在大型代码库和底层系统中定位并修复隐蔽 bug
  • 官方跑分(无护栏评测):SEC-bench Pro 88.2%、ExploitGym 54.8%、Collinear CWE-bench 71.0%;Artificial Analysis 智能指数 v5.0 为 59 排名第一;WebDev Arena +89 至第 4(1769)
  • 安全与对齐:Terminal-Bench 4.0 作弊成功率降到 0.0%(尝试率 0.4%),内部实测高严重度失准告警降近 80%,无依据陈述约为 Argon 的一半,Gray Swan 间接提示注入攻击成功率从 Argon 的 0.7% 降到 0.0%
  • 内部案例:生成安全代码成功率是 Argon 的 2 倍以上;Chrome 团队称其生成高质量补丁的表现比另一家实验室的大型前沿模型好 10 倍以上
  • 开放节奏:本周先给 Fairwind 计划内部分网络防御者,并参与美国政府自愿的发布前测试;开发者 API 尚未开放,介绍期 2 / 10 美元每百万 token,缓存输入按输入价的 5% 计,之后 4 / 20 美元
阅读全文

Cognition 发布 FrontierCode 2.0 编程基准:考察"该不该合并",最强的 Claude Opus 5.5 也只有 45.5%

Devin 背后的 Cognition 于 10 月 27 日发布 FrontierCode 2.0。新版沿用由开源维护者亲自出题、按"能否合并"打分的方法,但任务来自更多仓库、覆盖安全补丁与性能优化,提示词刻意不写全,并加入大量"周全性"判定项。官方结果中 Claude Opus 5.5 以 45.5% 居首,GPT-6 Astra 42.8% 次之,Grok 4.7、Gemini 4 Argon 等降到 20% 多,基准远未饱和。

Cognition 发布 FrontierCode 2.0 编程基准:考察"该不该合并",最强的 Claude Opus 5.5 也只有 45.5%

核心要点速览

  • 榜首 Claude Opus 5.5 为 45.5%(1.1 版 54.6%),GPT-6 Astra 42.8%(1.1 版 53.3%),均为官方/厂商口径
  • Grok 4.7 28.6%、Gemini 4 Argon 26.3%、Muse Wonder 1.0 24.3%、SWE-2 23.9%,DeepSeek V4.1 Flash 19.3%、Kimi K3 17.7%,开源模型差距明显
  • 相比 1.1 版,参考解平均多改 67% 的文件、89% 的代码行,代码库大 25%;任务来源仓库多 55%,阻断性判定项多 43%
  • "周全性"阻断项从 168 条增至 501 条,约 3 倍;80% 任务的参考解优于上游原 PR,审计 agent 还发现并上报了一个上游安全漏洞
  • 成本-得分帕累托前沿上,高端是 Opus 5.5,低成本端有 Luna、Haiku 和 Sol,官方点名 GPT-6.1 Sol 性价比突出(官方博客)
阅读全文

Google DeepMind 发布世界模型 Genie 4:基于 Gemini Omni,首次原生生成音频与实时对话,先向受信测试者开放研究预览

Google DeepMind 10 月 27 日发布 Genie 4,称其为迄今最逼真、交互性最强的世界模型。它基于 Gemini Omni,提升了物理和人物动作的真实感,首次原生生成环境声和可互动的角色对话,并由 Gemini 3.8 Flash 在回路中规划复杂事件。目前只向受信测试者开放研究预览,即将登陆 Google AI Ultra(Project Genie)及 Gemini API / AI Studio 早期伙伴;官方未公布量化跑分。

Google DeepMind 发布世界模型 Genie 4:基于 Gemini Omni,首次原生生成音频与实时对话,先向受信测试者开放研究预览

核心要点速览

  • 官方口径:Genie 4 是 DeepMind「迄今最逼真、交互性最强」的世界模型,基于 Gemini Omni 锚定真实外观与行为
  • Genie 系列首个原生生成音频的实时世界模型:环境声、音乐和角色对话同步生成,角色能实时回应
  • Gemini 3.8 Flash 作为回路中的引导 Agent,拆解目标并逐帧核对;Gemini 4 Argon 演示驱动 Apollo 人形机器人仿真
  • 局限(官方):只支持几分钟连续交互,长时间运行物体会漂移;官方未公布任何量化跑分
  • 目前仅受信测试者可用,即将开放给 Google AI Ultra(Project Genie)和 Gemini API / AI Studio 早期伙伴,输出带 SynthID 水印
阅读全文
关联模型 / 智能体 / 厂商:

DeepMind 机器人「大脑」Gemini Robotics ER 2 上线 Google Cloud 公开预览:企业可用它编排 VLA 模型和多机器人协作

Google Cloud 10 月 27 日宣布,Google DeepMind 的具身推理模型 Gemini Robotics ER 2 在 Gemini 平台(Model Garden)开放公开预览,模型 ID 为 gemini-robotics-er-2-preview,基于 Gemini 3.5 Flash。它充当机器人的高层「大脑」,能理解视频中的空间和时间信息、规划多步任务、判断动作是否成功,并把 VLA 模型和导航 API 当作工具来调度,支持多台不同形态机器人协作。官方称其定位视频关键帧的准确率为 91.3%。

核心要点速览

  • 模型 ID gemini-robotics-er-2-preview,基于 Gemini 3.5 Flash,输入支持文本、图像、视频、音频,输入上限 131,072 token、输出 65,536 token
  • 核心用法是把 VLA 模型、导航 API 或自定义函数声明为工具,由 ER 2 负责规划和调度,并可用自然语言解释和接受改派
  • 能把任务进度分为二元、离散或连续分数,官方称定位关键帧准确率 91.3%、平均帧误差 0.96 秒
  • 可读取表盘、液位计、数显屏、刻度尺等 10 多类仪表读数
  • 企业版提供 IAM、安全控制和函数调用;Cloud 预览支持 GenerateContent,不支持 Live API;Boston Dynamics、Arm 等已在试用
阅读全文
关联模型 / 智能体 / 厂商: