
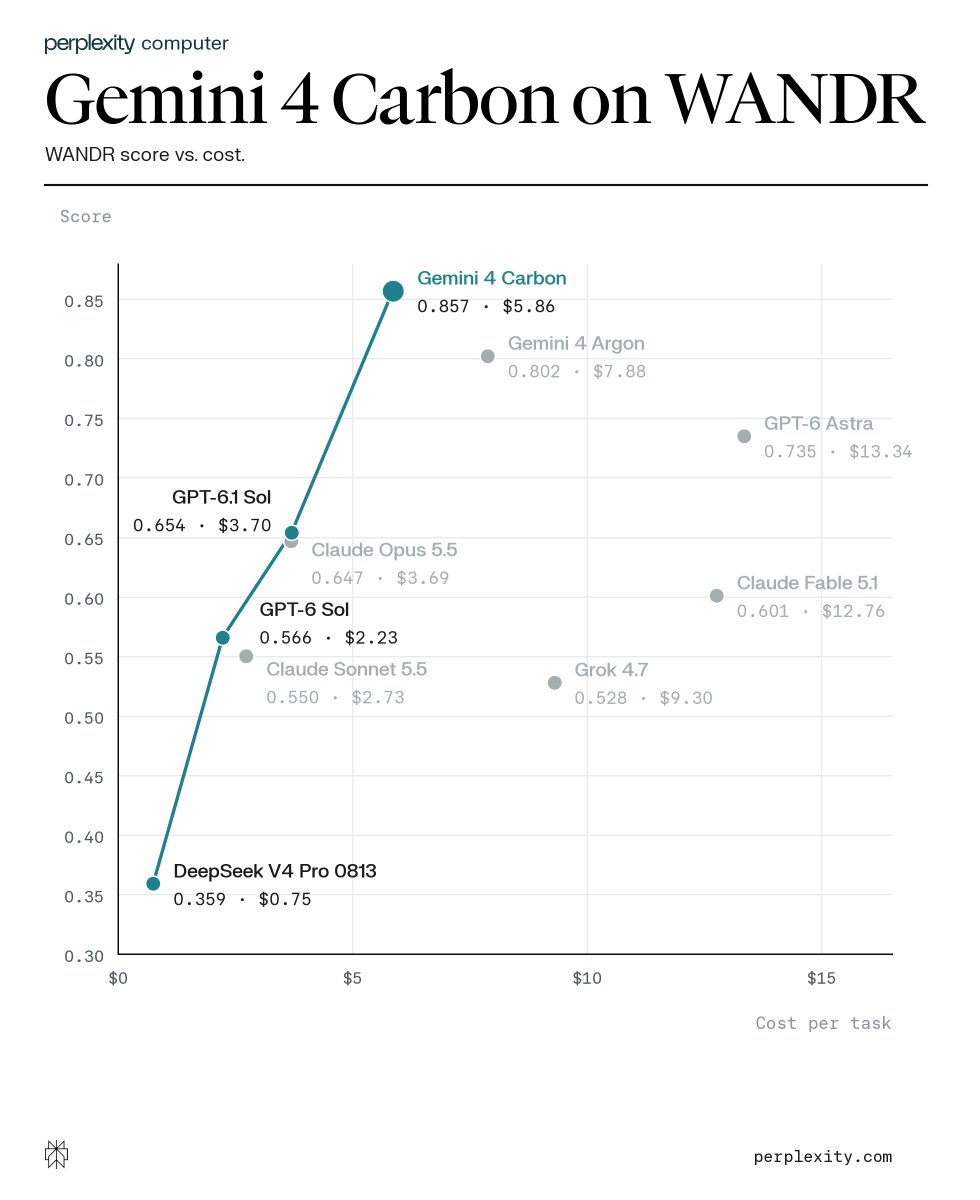
Perplexity CEO Aravind Srinivas 在 X 上公布 Gemini 4 Carbon 的早期评测:在 Perplexity 的 Wide-And-Deep-Research(WANDR)长篇研究基准上拿到 0.857,创新高,每任务成本 5.86 美元;Gemini 4 Argon 为 0.802(7.88 美元),GPT-6 Astra 为 0.735(13.34 美元)。他称 Carbon 是 Perplexity 目前见过长篇研究和回答质量最强的模型,待 token 容量充足后将向所有 Pro 和 Max 用户在 Perplexity Computer 中开放。
核心要点速览
- ✓WANDR 得分(Perplexity 口径):Gemini 4 Carbon 0.857、Gemini 4 Argon 0.802、GPT-6 Astra 0.735、GPT-6.1 Sol 0.654、Claude Opus 5.5 0.647、Claude Fable 5.1 0.601
- ✓成本更低:Carbon 每任务 5.86 美元,低于 Argon 的 7.88 美元和 GPT-6 Astra 的 13.34 美元
- ✓性价比曲线:DeepSeek V4 Pro 0813(0.359,0.75 美元)、GPT-6 Sol(0.566,2.23 美元)、GPT-6.1 Sol(0.654,3.70 美元)和 Carbon 构成 Perplexity 图中的成本前沿
- ✓Claude Sonnet 5.5 为 0.550(2.73 美元),Grok 4.7 为 0.528(9.30 美元)
- ✓尚未上线:Carbon 要等 token 容量充足后才向 Perplexity Pro/Max 用户开放,目前 Google 仍只向 Fairwind 计划的网络安全防御方提供早期访问
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
Gemini 4 Carbon 10 月 28 日发布后,Google 只向 Fairwind 计划中的网络安全防御方开放早期访问,外界能看到的多是厂商自测成绩。继 Cognition 公布 FrontierCode 2.0 成绩之后,Perplexity 也拿出了自家评测,关注的是长篇研究和回答质量,这正是 Perplexity Computer 的核心场景。
架构亮点与底层机制
这份评测来自 Perplexity CEO Aravind Srinivas 本人在 X 上的帖子,配图为 Perplexity Computer 出品的「WANDR 得分与每任务成本」散点图。WANDR 全称 Wide-And-Deep-Research,按名字看同时考察研究的广度和深度;帖子没有公开题目构成和打分细则,以下数字均为 Perplexity 口径,尚无第三方复现。
权威 Benchmark 与实测跑分对比
Perplexity 图中的数字:Gemini 4 Carbon 0.857(每任务 5.86 美元),Gemini 4 Argon 0.802(7.88 美元),GPT-6 Astra 0.735(13.34 美元),GPT-6.1 Sol 0.654(3.70 美元),Claude Opus 5.5 0.647(3.69 美元),Claude Fable 5.1 0.601(12.76 美元),GPT-6 Sol 0.566(2.23 美元),Claude Sonnet 5.5 0.550(2.73 美元),Grok 4.7 0.528(9.30 美元),DeepSeek V4 Pro 0813 0.359(0.75 美元)。Carbon 不仅分数最高,成本也低于 Argon 和 Astra。
开发者实战落地与开箱指南
做研究型 agent 的团队可以把这组数据当作 Carbon 的又一个独立厂商参考,和 Cognition 的编程成绩一起看。不过 Carbon 目前仍未全面开放,Perplexity 也说要等 token 容量充足才上线 Pro/Max;在拿到访问权限前,GPT-6.1 Sol 和 Claude Opus 5.5 在这张图上以约 3.7 美元的成本拿到 0.65 左右,是现阶段更容易用上的选择。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察