AI 编程实时动态与要闻

Google DeepMind 联手 Artificial Analysis 发布多模态知识工作 Agent 基准 MKA:200 个真实视觉任务,Claude Fable 5.2 以 57% 居首,Gemini 4 Carbon 54%、单任务成本约为其五分之一

Google DeepMind 11 月 10 日与 Artificial Analysis 联合推出 MKA(Multimodal Knowledge Agent)基准,测 Agent 能否读懂建筑图纸、工程原理图、临床影像等视觉密集文件,并交付幻灯片、表格、报告和标注图。200 个私有任务覆盖 10 个行业、83 种职业,每题约 70 条专家评分项。Artificial Analysis 首批测了 21 个模型:Claude Fable 5.2(max)Climb WSR 57% 居首,Gemini 4 Carbon(high)54%,Claude Opus 5.5(max)53%;Fable 平均每题 31.97 美元,Carbon 为 6.29 美元。另有 10 道公开题已上 Hugging Face。
Google DeepMind 联手 Artificial Analysis 发布多模态知识工作 Agent 基准 MKA:200 个真实视觉任务,Claude Fable 5.2 以 57% 居首,Gemini 4 Carbon 54%、单任务成本约为其五分之一

核心要点速览

  • 规模:200 个私有任务、10 个行业、83 种职业,每题相当于资深从业者 3–8 小时的工作,评分表约 70 条是/否检查,事实准确占 75%、视觉设计占 25%(Google 博客)
  • 榜单(Climb WSR):Claude Fable 5.2(max)57%、Gemini 4 Carbon(high)54%、Claude Opus 5.5(max)53%,共测 21 个模型(AA 榜单)
  • 成本:Fable 5.2 平均每题 $31.97,是 Carbon($6.29)的 5 倍多、GPT-6.1 Sol($1.11)的约 29 倍;最便宜的是 GPT-6 Luna(Max)$0.18
  • 没有全能冠军:Fable 5.2 领先 5 个行业,Opus 5.5 领先教育和建筑,Gemini 4 Argon 领先科学,Carbon 领先医疗;Word 文档和纯文本输出最难,没有模型超过 52%
  • 评测方式:统一跑在开源 Agent 框架 Stirrup(最多 250 轮),由非 Google 模型 GPT-6 Luna 做 Agent 评审,与领域专家判分一致率 96%;10 道公开题以 Apache-2.0 发布在 Hugging Face
阅读全文

Gemini 4 Carbon 全面开放:Gemini API 付费开发者与 Ultra 订阅用户今起可用,介绍期价格每百万 token 2 / 10 美元,Antigravity 同步预览多 Agent 协作 /swarm

Google 11 月 10 日宣布 Gemini 4 Carbon 正式向开发者、企业、科研人员和普通用户开放。两周前它只给 Fairwind 计划里的网络防御者使用,现在所有付费开发者可在 Google AI Studio、Android Studio 的 Gemini API 和 Gemini for business 中调用,Google AI Ultra 订阅用户可在 Gemini 应用、搜索 AI Mode、Antigravity 中使用。介绍期价格与 Argon 相同,每百万输入 / 输出 token 2 / 10 美元,11 月 30 日后涨到 4 / 20 美元。Google 还在 Antigravity 预览 /swarm,一个提示就能拉起一组协作 Agent。

Gemini 4 Carbon 全面开放:Gemini API 付费开发者与 Ultra 订阅用户今起可用,介绍期价格每百万 token 2 / 10 美元,Antigravity 同步预览多 Agent 协作 /swarm

核心要点速览

  • 开放范围:Gemini API 付费层(Google AI Studio、Android Studio)与 Gemini for business 面向所有付费开发者和企业;Google AI Ultra 订阅用户可在 Gemini 应用、搜索 AI Mode、Antigravity 和 AI Studio 使用(官方博客)
  • 价格:介绍期每百万输入 / 输出 token 2 / 10 美元(与 Argon 相同),11 月 30 日后为 4 / 20 美元
  • 第三方榜单(官方引用):在 CursorBench 4.0、Perplexity WANDR、Zapier AutomationBench 排名第一,单任务成本比第二名外部模型低 2 倍以上;与 Artificial Analysis 新推出的多模态知识 Agent 测评 MKA 排名第 2,平均单任务成本比第一名低 6 倍以上
  • 新功能:Antigravity 预览 /swarm,一个提示拉起一组 Agent,Carbon 负责架构设计、协调和审查,轻量模型在隔离工作区并行写代码和测试
  • 安全数据:模拟网络攻击测试中拦截 99% 攻击轨迹,单次突破率 0.8%(Argon 为 3.1%);375 项 Agent 诚实度测评通过 92%(Argon 为 70%)
  • 定位:Argon 仍是多数编码和知识工作的首选,Carbon 用更多 token 深挖,适合多步调试、科研等最难任务
  • Cursor:Carbon 已上线 Cursor,CursorBench 4.0 公开榜 High 60.4% 第一(Medium 60.1%、Low 58.6%),高于 Fable 5.2 Max 的 60.0%,每任务成本约 9.22 美元 对 32.79 美元(CursorBench)
阅读全文

Artificial Analysis 第三方评测:Claude Fable 5.2 登顶 AA-3D 交互式 3D 场景榜(1271 Elo,领先第二名 67 分),并以 67% 拿下科学图像推理 VIALS-AA 第一

独立评测机构 Artificial Analysis 11 月 10 日公布两项新结果。在考察“让模型当 Agent 用 three.js 搭交互式 3D 网页”的 AA-3D 榜上,Claude Fable 5.2(Max)拿到 1271 Elo,比第二名 Claude Sonnet 5.5(1204)高 67 分,95% 置信区间 1246–1297 与其他模型不重叠,领先超出误差范围;比上一代 Fable 5.1(1139)高 132 分,也高于 OpenAI 最高的 GPT-6 Astra(1168)和 Google 最高的 Gemini 4 Argon(1147)。在生命科学图像推理榜 VIALS-AA 上,Fable 5.2 得 67%,超过此前领先的 Gemini 4 Carbon(64%)和 GPT-6 Astra(63%)。AA 还发现两家路线相反:Fable 每题平均约 37 次工具调用,Astra 只有约 8 次。

Artificial Analysis 第三方评测:Claude Fable 5.2 登顶 AA-3D 交互式 3D 场景榜(1271 Elo,领先第二名 67 分),并以 67% 拿下科学图像推理 VIALS-AA 第一

核心要点速览

  • AA-3D:Fable 5.2(Max)1271 Elo,第二名 Sonnet 5.5 1204、Opus 5.5 1202;95% 置信区间 1246–1297,与其他模型不重叠
  • 代际提升:比 Fable 5.1(1139)高 132 分;OpenAI 最高 GPT-6 Astra 1168,Google 最高 Gemini 4 Argon 1147
  • AA-3D 规则:模型在离线沙箱里当 Agent,最多 3 小时 / 250 轮,可用 Blender、Rapier 物理、Python 和无头浏览器自测;真人评委盲选两两对比,每个场景至少看 30 秒
  • VIALS-AA:Fable 5.2 67%,Gemini 4 Carbon 64%,GPT-6 Astra 63%
  • 工具使用路线相反:Fable 每题约 37 次工具调用、每轮平均 1.60 次(榜上最高);Astra 约 8 次,为 AA 测过的最少
阅读全文

Artificial Analysis 上线 VIALS-AA:Handshake 生命科学视觉推理榜,厂商口径 Gemini 4 Carbon 约 64% 居首

2026-11-06,Artificial Analysis(@ArtificialAnlys)发布 VIALS-AA:独立复跑 Handshake AI 的 VIALS(161 题、8 个科学图像域),用开源 harness Stirrup 配代码执行与看图工具,每题 3 次,主指标为三连全对(pass^3)。厂商口径:Gemini 4 Carbon (high) 约 64%,GPT-6 Astra (max) 约 63%,Claude Opus 5.5 (max+fallback) 约 61%;开源权重侧 Kimi K3.1 Pro 约 45%。

Artificial Analysis 上线 VIALS-AA:Handshake 生命科学视觉推理榜,厂商口径 Gemini 4 Carbon 约 64% 居首

核心要点速览

  • 来源:Artificial Analysis 官方文章/榜单 2026-11-06;基准任务来自 Handshake AI VIALS
  • 方法:161 题 × 3 次;Stirrup + 代码执行/看图;GPT-6 Luna (medium) 判分;主指标 pass^3
  • 前列(厂商口径):Gemini 4 Carbon (high) 64%、GPT-6 Astra (max) 63%、Claude Opus 5.5 (max+fallback) 61%
  • 成本与一致性:Sol 约 59% / ~$0.056 每题;Kimi K3.1 Pro pass@3 接近 Astra,但 pass^3 仅约 45%
  • 落地:artificialanalysis.ai/articles/vials-aa 与 /evaluations/vials-aa
阅读全文
AD赞助内容

Artificial Analysis 改用「单任务耗时」作为头号性能指标:GPT-6 Astra 满档约 17 分钟完成一题,快于 Opus 5.5 与 Gemini 4 Carbon

独立评测机构 Artificial Analysis 于 11 月 4 日(UTC 17:34)在 X 上宣布新版 API 性能基准:头号指标从输出速度改为 Time per Task,即完成一道 Intelligence Index 任务所需时间(每题输出 tokens ÷ 端到端输出速度)。新版覆盖约 1,000 个 serverless 端点,速度改为从发出请求算到最后一个 token,并加入多轮 Agent 编码与知识工作负载。官方数据:GPT-6 Astra 满档 51 tokens/s 但约 17 分钟完成一题,Claude Opus 5.5(max)约 26 分钟,Gemini 4 Carbon(high)约 29 分钟。

核心要点速览

  • Time per Task = 每道 Intelligence Index 任务的输出 tokens ÷ 端到端输出速度;逐 token 很快但话多的模型,可能比慢但省 token 的模型更晚完成任务。
  • 端到端输出速度从发出请求算到收到最后一个 token,包含首 token 前的等待(prefill 与隐藏推理);输出 token 改用各家 API 自报数量,不再用 o200k_base 分词器估算。
  • GPT-6 Astra(max)51 tokens/s,每题约 5 万输出 tokens、约 17 分钟;Claude Opus 5.5(max,111 tokens/s)约 26 分钟,Gemini 4 Carbon(high,71 tokens/s)约 29 分钟,后两者每题约 12–17 万 tokens。
  • 按各家 API 默认档(三者均为 medium),GPT-6 Astra、GPT-6.1 Sol、Opus 5.5 的单任务耗时降约 3–5 倍、成本降约 2–4 倍,Intelligence Index 低约 5–11 分;Opus 5.5 从约 26 分钟/10.04 美元降到约 6.8 分钟/2.45 美元。
  • 官方方法论页显示这是 3.0.0 版(10 月 30 日),测试频率改为每 6 小时一次,并新增端点错误率指标。
阅读全文

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

半导体与 AI 研究机构 SemiAnalysis 11 月 2 日发布 GDPx,用来衡量前沿模型在芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进(RSI)、硬件设计、材料科学、对齐和软件工程 11 个领域的智能体能力,共 206 道任务,由 14 家专业数据公司出题、SemiAnalysis 负责最终质检。官网榜单上 Claude Opus 5.5 以 12.0% 居首,Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6% 紧随其后;金融和法律任务几乎所有模型都是 0 分。SemiAnalysis 称 Opus 5.5 和 GPT-6 Astra 的总分被安全分类器拖低,并计划每 3–6 个月更新一版。以上分数均为 SemiAnalysis 口径。

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

核心要点速览

  • 规模:11 个领域、14 家数据合作方、206 道任务,默认单题时限 8 小时(GDPx 官网)
  • 榜单(SemiAnalysis 口径):Claude Opus 5.5 12.0%、Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6%、Muse Wonder Full 9.0%、Claude Fable 5.1 8.5%、GPT 6.1 Sol 8.4%、Claude Sonnet 5.5 8.2%
  • 开源与低价档:DeepSeek 4.1 Flash 1017 5.4%、GPT-6 Luna 5.1%、Grok 4.7 3.9%、GLM 5.3 2.7%;金融和法律任务几乎全部 0 分
  • 评测方法:优先用各家原生 harness(Opus 用 Claude Code、Astra 用 Codex、Carbon 用 Antigravity),没有的用 OpenCode;报告 3 次尝试的 pass@1,各领域等权(SemiAnalysis 博客)
  • 分领域:Opus 5.5 赢量化、硬件和芯片设计;Gemini 4 Carbon 赢生物和软件工程;GPT-6 Astra 赢 RSI 和材料科学;Muse Wonder Full 是最强网安模型
阅读全文

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

独立评测机构 Artificial Analysis 10 月 31 日发布知识与幻觉基准 AA-Omniscience v1.1,作为 Intelligence Index v5 的组成部分。新版题库从 6,000 题精简为 3,000 题,删掉已公开和已饱和的题目、修正错误与歧义并补充新题,同时在 Hugging Face 公开一套 300 题、难度与私有集校准的公开集,两者 Net Score 的 Pearson 与 Spearman 相关系数均为 0.99。结果显示 Gemini 4 Carbon(high)以 54 分领先,Claude Opus 5.5 为 48、Claude Fable 5.1 为 46;Fable 5.1 准确率最高(68%),Gemini 4 Argon 幻觉率最低(4%)。模型平均比 v1 低约 1.9 分,MiniMax M3.1 Flash 下滑 22 分。以上均为 Artificial Analysis 口径。

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

核心要点速览

  • 题库从 6,000 题精简到 3,000 题,覆盖 6 大领域、42 个主题:理工数学 600、软件工程 600,金融、健康、人文社科、法律各 450
  • 新的 300 题公开集已上 Hugging Face,与私有集 Net Score 的相关系数 0.99,中位差 0.0 分
  • Net Score 排名:Gemini 4 Carbon(high)54、Claude Opus 5.5 48、Claude Fable 5.1 46;开源权重最好的是 Muse Spark Open,落后 Gemini 4 Carbon 28 分
  • 准确率最高为 Claude Fable 5.1(68%),其次 Claude Opus 5.5(66%);幻觉率最低为 Gemini 4 Argon(4%)
  • 与 v1 排名的 Spearman 相关 0.98,但平均低 1.9 分;MiniMax M3.1 Flash 从 16 跌到 -6,MiMo V2.6 Pro 从 8 跌到 -5(官方口径)
阅读全文

Perplexity CEO 公布 Gemini 4 Carbon 早期评测:WANDR 深度研究基准 0.857 创新高,每任务 5.86 美元,高于 Argon 和 GPT-6 Astra

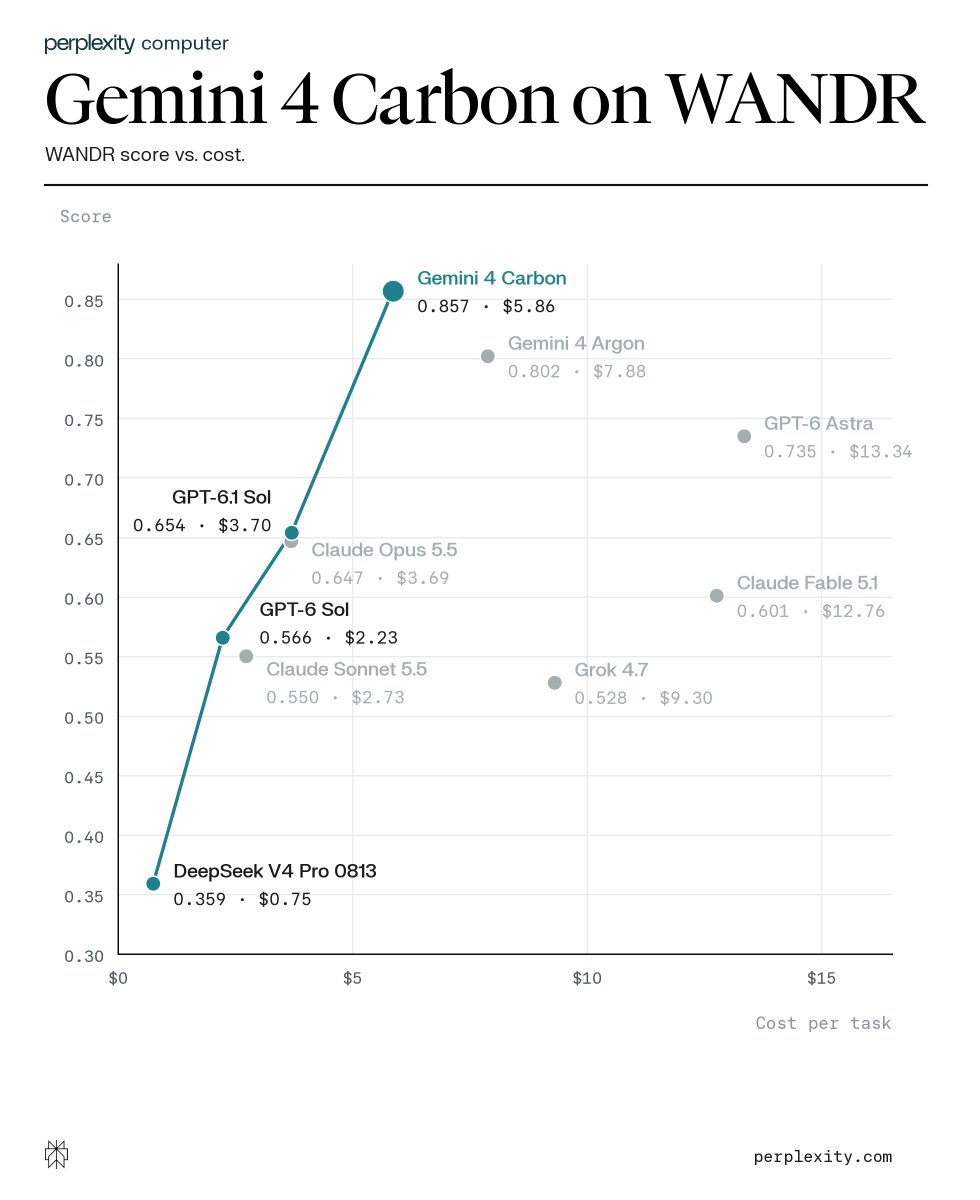
Perplexity CEO Aravind Srinivas 在 X 上公布 Gemini 4 Carbon 的早期评测:在 Perplexity 的 Wide-And-Deep-Research(WANDR)长篇研究基准上拿到 0.857,创新高,每任务成本 5.86 美元;Gemini 4 Argon 为 0.802(7.88 美元),GPT-6 Astra 为 0.735(13.34 美元)。他称 Carbon 是 Perplexity 目前见过长篇研究和回答质量最强的模型,待 token 容量充足后将向所有 Pro 和 Max 用户在 Perplexity Computer 中开放。

Perplexity CEO 公布 Gemini 4 Carbon 早期评测:WANDR 深度研究基准 0.857 创新高,每任务 5.86 美元,高于 Argon 和 GPT-6 Astra

核心要点速览

  • WANDR 得分(Perplexity 口径):Gemini 4 Carbon 0.857、Gemini 4 Argon 0.802、GPT-6 Astra 0.735、GPT-6.1 Sol 0.654、Claude Opus 5.5 0.647、Claude Fable 5.1 0.601
  • 成本更低:Carbon 每任务 5.86 美元,低于 Argon 的 7.88 美元和 GPT-6 Astra 的 13.34 美元
  • 性价比曲线:DeepSeek V4 Pro 0813(0.359,0.75 美元)、GPT-6 Sol(0.566,2.23 美元)、GPT-6.1 Sol(0.654,3.70 美元)和 Carbon 构成 Perplexity 图中的成本前沿
  • Claude Sonnet 5.5 为 0.550(2.73 美元),Grok 4.7 为 0.528(9.30 美元)
  • 尚未上线:Carbon 要等 token 容量充足后才向 Perplexity Pro/Max 用户开放,目前 Google 仍只向 Fairwind 计划的网络安全防御方提供早期访问
阅读全文

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

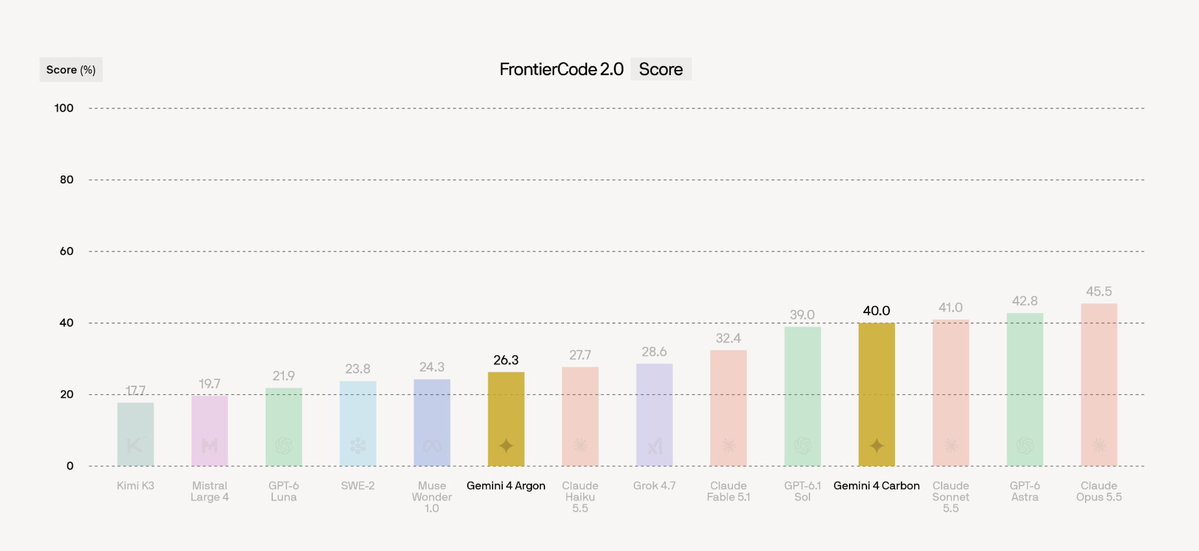
Devin 背后的 Cognition 于 10 月 30 日 01:45(UTC)在 X 上公布,Google 新模型 Gemini 4 Carbon 在其编程基准 FrontierCode 2.0 上得分 40%,每任务成本 4.04 美元,接近最高水平,仅次于 Claude Opus 5.5、GPT-6 Astra 和 Claude Sonnet 5.5。上一代 Gemini 4 Argon 得分 26.3%,每任务成本却更高,为 6.41 美元。成绩为 Cognition 自测口径,排行榜已在官网更新。

Cognition 公布 Gemini 4 Carbon 的 FrontierCode 2.0 成绩:40%、每任务 4.04 美元,接近榜首;Argon 26.3%、成本 6.41 美元

核心要点速览

  • Gemini 4 Carbon 在 FrontierCode 2.0 得分 40%,每任务 4.04 美元,排在 Claude Opus 5.5(45.5%)、GPT-6 Astra(42.8%)和 Claude Sonnet 5.5 之后(原帖)
  • Gemini 4 Argon 得分 26.3%,每任务 6.41 美元,高于 Muse Wonder 1.0,但落后于 Claude Haiku 5.5 和 Grok 4.7
  • 从 Argon 到 Carbon,得分提高约 13.7 个百分点,每任务成本反而低约 2.4 美元
  • 官网更新日志显示 10 月 28 日已加入 Gemini 4 Carbon;FrontierCode 2.0 共 132 个任务,按维护者是否会合并打分(排行榜)
  • 所有数字均为 Cognition 自测口径,Google 未就此发布成绩
阅读全文

Google 发布 Gemini 4 Carbon:Argon 两周后再推前沿模型,Artificial Analysis v5 指数 59 居首,网络安全与长程编码 SOTA,先向 Fairwind 计划内的网络防御者开放

Google DeepMind 10 月 28 日发布 Gemini 4 Carbon,称其为目前最强模型,距 Gemini 4 Argon 上线仅两周。官方博客称它在 Artificial Analysis 智能指数 v5.0 以 59 分排名第一,并在网络安全三项评测领先:SEC-bench Pro 找漏洞 88.2%、ExploitGym 漏洞利用 54.8%、CWE-bench 打补丁 71.0%;WebDev Arena 涨 89 分至第 4(1769)。本周起先向 Fairwind 计划中的部分网络防御者开放,之后再面向开发者、企业和消费者。介绍期价格与 Argon 相同,每百万输入 / 输出 token 2 / 10 美元,之后为 4 / 20 美元。

Google 发布 Gemini 4 Carbon:Argon 两周后再推前沿模型,Artificial Analysis v5 指数 59 居首,网络安全与长程编码 SOTA,先向 Fairwind 计划内的网络防御者开放

核心要点速览

  • 定位:Google 称其为「最强模型」,主打网络安全和长程智能体任务,内部团队观察到它可连续运行数天,在大型代码库和底层系统中定位并修复隐蔽 bug
  • 官方跑分(无护栏评测):SEC-bench Pro 88.2%、ExploitGym 54.8%、Collinear CWE-bench 71.0%;Artificial Analysis 智能指数 v5.0 为 59 排名第一;WebDev Arena +89 至第 4(1769)
  • 安全与对齐:Terminal-Bench 4.0 作弊成功率降到 0.0%(尝试率 0.4%),内部实测高严重度失准告警降近 80%,无依据陈述约为 Argon 的一半,Gray Swan 间接提示注入攻击成功率从 Argon 的 0.7% 降到 0.0%
  • 内部案例:生成安全代码成功率是 Argon 的 2 倍以上;Chrome 团队称其生成高质量补丁的表现比另一家实验室的大型前沿模型好 10 倍以上
  • 开放节奏:本周先给 Fairwind 计划内部分网络防御者,并参与美国政府自愿的发布前测试;开发者 API 尚未开放,介绍期 2 / 10 美元每百万 token,缓存输入按输入价的 5% 计,之后 4 / 20 美元
阅读全文
AD赞助内容