AI 编程实时动态与要闻

谷歌 Project Suncatcher 太空 TPU 首次在轨完成 AI 推理:Gemma 4 从轨道写回一首俳句,2027 年发射双星测试分布式计算

谷歌 CEO Sundar Pichai 和 Google Research 宣布,10 月 1 日发射的 Project Suncatcher 原型卫星完成调试后,地面上行提示词,星上 TPU 运行 Gemma 4 开源模型,在掠过挪威斯瓦尔巴群岛时回传了一首俳句,这是数据中心级 TPU 首次在轨完成 AI 推理。下一步测试热应力和辐射下的表现,2027 年发射两颗互联卫星验证跨星分布式计算。

谷歌 Project Suncatcher 太空 TPU 首次在轨完成 AI 推理:Gemma 4 从轨道写回一首俳句,2027 年发射双星测试分布式计算

核心要点速览

  • 卫星 10 月 1 日随 SpaceX Transporter-18 拼车任务发射,与 Planet 合作打造,约 3 周调试后完成首次在轨推理(官方口径)。
  • 据 TechCrunch,卫星搭载 4 颗 TPU、发电上限约 1 kW,受功率限制一次只能开 1 颗 TPU、约 20 分钟。
  • Sundar Pichai 的公告帖约 2.6 万赞、397 万浏览;Google 官方账号称「我们的 TPU 从太空打回了电话」。
  • 论文的地面质子束测试显示,高带宽内存在累计 2 krad(Si) 后才出现异常,约为 750 rad(Si) 最低要求的 3 倍(据 The Register 引述)。
  • 2027 年计划发射两颗互联卫星,验证星间光链路和跨卫星分布式 AI 计算。
阅读全文

Google Suncatcher 太空 TPU 首次在轨推理:卫星上的 Gemma 4 写出第一首俳句

Google CEO Sundar Pichai 于 10 月 30 日在 X 上宣布 Project Suncatcher 的「hello world」里程碑:团队向轨道上的原型卫星发送指令、启动 TPU、运行提示词,并在地面收到第一条完整回复——一首俳句。据 TechCrunch,回复由星上预装的 Gemma 4 生成。

Google Suncatcher 太空 TPU 首次在轨推理:卫星上的 Gemma 4 写出第一首俳句

核心要点速览

  • 原型卫星 10 月 1 日随 SpaceX Transporter-18 发射,约 3 周调试后完成首次在轨推理(调试时长据 TechCrunch)
  • 据 TechCrunch,星上运行的是 Google DeepMind 的 Gemma 4,首个提示词是写一首关于太空的俳句
  • TechCrunch 称卫星最高发电约 1 kW,TPU 每次只能开机约 20 分钟;TPU 数量各方说法不一(Google 此前 X 帖称 4 颗,TechCrunch 称 1 颗)
  • 下一步计划 2027 年再发射 2 颗卫星,验证更高功率与星间光链路;官方未公布任何吞吐或跑分数据
阅读全文
关联模型 / 智能体 / 厂商:

Google Gemma 团队:用 Gemini 4 Argon 为 vLLM 提交 Gemma 4 优化 PR,官方称 gemma-4-E2B-it 在 A100 上提速 2.85 倍

Google 官方账号 @googlegemma 10 月 26 日发帖称,借助 Gemini 4 Argon 完成的一组 vLLM 优化,让 gemma-4-E2B-it 在单张 A100 上的吞吐从约 37,900 提升到 108,000+ tokens/秒,约 2.85 倍,且输出 token 100% 一致。对应 PR 由 Google DeepMind 的 Luciano Martins 提交,大部分仍在评审中。

Google Gemma 团队:用 Gemini 4 Argon 为 vLLM 提交 Gemma 4 优化 PR,官方称 gemma-4-E2B-it 在 A100 上提速 2.85 倍

核心要点速览

  • 官方称 gemma-4-E2B-it 在 A100 上吞吐约 2.85 倍(约 37.9K 到 108K+ tokens/秒),输出 token 100% 一致
  • PR 作者为 Google DeepMind 的 Luciano Martins,覆盖融合 Triton 内核、MTP 投机解码、KV 共享快速预填充等
  • 2.85 倍是 Google 对整组优化的说法;单个 PR #60674 自测预填充最高 1.90 倍、解码约 1.06 倍
  • 截至 10 月 27 日,链接中 10 个 PR 仅 3 个已合并,其余仍在评审
  • 这是用前沿编码模型做推理内核性能工程的公开案例,结果尚待 vLLM 社区复现
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 开源 Nemotron 3.5 Bolt E4B 4GB:基于 Gemma 4 E4B 后训练的本地小模型,主打语音助手、角色与机器人对话和工具调用

2026-10-23(UTC 15:41,SGT 23:41),NVIDIA AI 官方账号 @NVIDIAAI 宣布 Nemotron 3.5 Bolt E4B 4GB 上线,定位是能对话、能调用工具的本地小模型,用于本地助手、互动角色和机器人。Hugging Face 官方模型卡显示:它由 Gemma-4-E4B-it 后训练而来,总参数 8B(有效 4B),Q4_K_M 量化,输入输出各支持最多 64K token,可开关思考模式,并提供 DFlash 推测解码草稿模型和 BF16 版本;权重、数据和训练配方开放,许可证为 OpenMDW-1.1,可商用。模型卡跑分中,4GB 量化版 MultiChallenge 55.60(Gemma4 E4B-it 同量化 39.36、Qwen3.5 4B 52.23),但 Tau2-Bench 52.32、BFCL-v3 67.31 低于 Qwen3.5 4B。

NVIDIA 开源 Nemotron 3.5 Bolt E4B 4GB:基于 Gemma 4 E4B 后训练的本地小模型,主打语音助手、角色与机器人对话和工具调用

核心要点速览

  • NVIDIA 官方发布 Nemotron 3.5 Bolt E4B 4GB,面向本地助手、互动角色和机器人
  • 基于 Gemma-4-E4B-it 后训练,总参数 8B(有效 4B),Q4_K_M 量化,64K 上下文,可开关思考模式
  • 权重、数据、训练配方开放,OpenMDW-1.1 许可可商用,附 DFlash 推测解码草稿模型
  • 模型卡跑分:MultiChallenge 55.60 领先同级,但 Tau2-Bench 和 BFCL-v3 不及 Qwen3.5 4B
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Bolt E4B⚡ Gemma 4 E4B🌐 NVIDIA🌐 Google
AD赞助内容

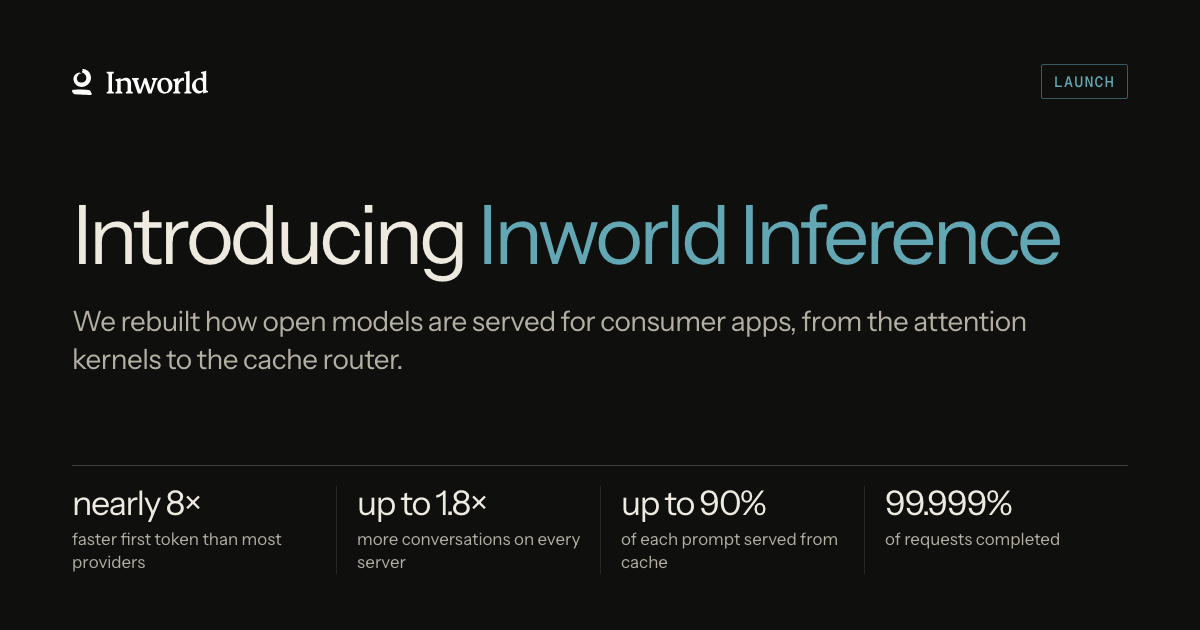
Inworld Inference 全面开放:专为消费级 AI 打造的开源模型推理 API,Gemma 4 26B p95 首 token 比 OpenRouter 中位供应商快 7.8 倍

Inworld AI 于 2026-10-14 向所有开发者开放 Inworld Inference,定位为面向消费级应用(陪伴、家教、语音、互动小说)的推理服务。它不铺海量模型,而是为 Gemma 4、GLM 5.3 Flash、DeepSeek、MiMo 等开源模型逐个定制推理构建:草稿-验证(投机)解码、改写的 split-KV 验证注意力、KV 感知路由和按评测把关的低精度权重。官方口径:Gemma 4 26B p95 首 token 0.31 秒,比 OpenRouter 中位供应商快 7.8 倍;最高 90% 提示命中缓存;GLM 5.3 Flash 30 天 2000 万+请求成功率 99.999%。API 兼容 OpenAI SDK,按请求选 Flex/Default/Priority/Fast 四档。

Inworld Inference 全面开放:专为消费级 AI 打造的开源模型推理 API,Gemma 4 26B p95 首 token 比 OpenRouter 中位供应商快 7.8 倍

核心要点速览

  • Gemma 4 26B 首 token:p50 0.17 秒 / p95 0.31 秒,较 OpenRouter 中位供应商快 3.6 倍 / 7.8 倍(官方博客,厂商口径,非同负载对比)
  • 价格:Gemma 4 26B 输入 $0.07、缓存 $0.035、输出 $0.34 每百万 token,比不训练用户数据的供应商中位价低近 40%
  • 改写验证注意力 kernel 后单层快 3.4–7.5 倍,注意力占解码步比例 27.5%→16.5%,p50 TTFT 154→117 ms,评测分数不变
  • KV 感知路由:GLM 5.3 Flash 缓存命中 25%→47%,DeepSeek V4.1 Flash 11%→33%;MiMo 2.6 Pro 缓存输入便宜 99%
  • 可靠性:GLM 5.3 Flash 30 天 2000 万+请求仅 98 次失败(约 4.8/百万);service_tier 支持 Flex/Default/Priority/Fast 四档
阅读全文
关联模型 / 智能体 / 厂商:

GUI-Decisions 开源:用「槽位读概率」替代坐标 JSON 解码,Computer-Use 单步提速约 3×(31B / 2B)

作者 Logesh Kumar Umapathi 于 2026-10-10 在 Hugging Face 博客发布 GUI-Decisions:把 computer-use 的 action/坐标写成固定槽位,从下一 token 分布一次性读出,而不是自回归解码 JSON。基于 Gemma 4 31B 的 LoRA/合并权重在 RTX PRO 6000 + vLLM 上,槽位读中位约 146–158 ms/步,相对原生生 JSON 约 472–546 ms 约 3.5×;相对带思考解码可快约 20–25×。ScreenSpot 点击命中约 0.87;开源 31B/2B 权重、GitHub 与 Spaces Demo。

GUI-Decisions 开源:用「槽位读概率」替代坐标 JSON 解码,Computer-Use 单步提速约 3×(31B / 2B)

核心要点速览

  • 官方:HF Blog(2026-10-10);代码 infinitylogesh/gui-decisions;Demo Spaces
  • 延迟(厂商口径,RTX PRO 6000,冷截图):槽位读 ~146 ms vs 原生 JSON 472–546 ms(约 3.5×);带 thinking 2.6–3.1 s(约 20–25×)
  • 精度:ScreenSpot 点击命中约 0.869(合并 31B);held-out AGUVIS computer-use 约 0.65;RefCOCO val 框 IoU 0.770
  • 机制:256 bin「字节」标签读坐标;动作决定后再读所需槽;type/answer 仍需基座解码——槽位只加速 grounding
  • 开箱:vllm serve infinitylogesh/GUI-Decisions-31B --max-logprobs 300 --api-server-count 8 + SlotModel.decide(img, instruction)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GUI-Decisions-31B⚡ GUI-Decisions-2B⚡ Gemma-4-31B🤖 computer-use🤖 GUI agent🌐 Hugging Face🌐 Google

AI 自己设计的开源 AI 芯片 openTPU 走红:RTL/ISA/编译器全栈开源,Kintex-7 FPGA 卡跑 Qwen3.5、Gemma 4 与 35B MoE,小模型解码 85.8 tok/s

开源项目 FeSens/openTPU(Apache-2.0)在 Hacker News 登上首页(250+ 分、300+ 评论):作者沿用此前用 AI 设计 RISC-V 核的 auto-arch-tournament 方法,让 AI 代理迭代设计一颗推理加速器,单仓库包含 SystemVerilog RTL、ISA、逐位精确模拟器、内核语言编译器与 Profiler。在 Kintex-7 xc7k480t PCIe 卡上以真实权重运行 Qwen3、Qwen3.5、Gemma 4、Phi-4-mini 等模型,输出与模拟器逐 token 一致;LFM2.5-230M 4-bit 解码 85.8 tok/s,Qwen3.5-35B-A3B 借主机专家卸载跑到 3.95 tok/s。

AI 自己设计的开源 AI 芯片 openTPU 走红:RTL/ISA/编译器全栈开源,Kintex-7 FPGA 卡跑 Qwen3.5、Gemma 4 与 35B MoE,小模型解码 85.8 tok/s

核心要点速览

  • 全栈 1 仓库:SystemVerilog RTL + 8×32-bit 指令 ISA + Python 逐位精确模拟器 + @ol.jit 内核编译器 + Lens Profiler,Apache-2.0(GitHub)
  • 实测解码(设备侧,4-bit/int8 头):LFM2.5-230M 85.8 tok/s、Qwen3-0.6B 31.3 tok/s、Qwen3.5-2B 12.09 tok/s、Gemma 4 E2B 12.14 tok/s(2026-09-29 至 10-01 实测)
  • 带宽利用:DDR3-1066 峰值 17.1 GB/s,解码时达 82–94%;设计时钟 133.33 MHz,四列脉动阵列
  • MoE 卸载:Qwen3.5-35B-A3B 3.95 tok/s(每 token 经 PCIe 拉取 153 MB 专家权重,命中率 62%),LFM2.5-8B-A1B 10.6 tok/s(offload 文档)
  • 4-bit 量化(FP4 + 两级块缩放,4.25 bit/权重)比 int8 解码快 40–45%,困惑度代价逐模型公开
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen3.5⚡ Gemma 4⚡ LFM2.5⚡ Phi-4 Mini

Google DeepMind 发布 EmbeddingGemma 2:740M 开源多模态嵌入模型,文本/代码/图像/音频/视频同一向量空间,MTEB Code 提升近 10 分

Google DeepMind 于 2026-10-06 发布 EmbeddingGemma 2:基于 Gemma 4 架构、740M 参数、Apache 2.0 许可,把文本、代码、图像、音频、视频映射到同一 768 维向量空间,上下文 8K,MTEB Code 从 68.76 提升到 78.68,量化后在 Pixel 11 Pro 上纯文本仅需约 191MB 内存。Hugging Face Transformers v5.19.0 已原生支持。

Google DeepMind 发布 EmbeddingGemma 2:740M 开源多模态嵌入模型,文本/代码/图像/音频/视频同一向量空间,MTEB Code 提升近 10 分

核心要点速览

  • 规模:740M 参数,模块化拆分为 270M 文本主干 + 170M 视觉编码器 + 300M 音频编码器,可按需加载(官方博客)
  • 代码检索:MTEB Code 68.76 → 78.68(+9.92 分),官方称在 1B 以下多模态嵌入模型中 MTEB Code、MAEB 领先
  • 存储:Matryoshka 表示学习,768 维可截断到 512/256/128 维,本地向量库最多省 6 倍存储
  • 端侧:量化后 Pixel 11 Pro 纯文本约 191MB、全多模态约 567MB 内存;8K 上下文(一代的 4 倍),可一次处理 5.5 分钟音频、29 张图或 58 帧视频
  • 生态:Apache 2.0,权重在 Hugging Face 与 Kaggle;Transformers v5.19.0 已加入支持,官方列出 sentence-transformers、vLLM、llama.cpp、SGLang、Ollama、MLX 等
阅读全文
关联模型 / 智能体 / 厂商:
⚡ EmbeddingGemma 2⚡ Gemma 4🌐 Google DeepMind🌐 Google

GitHub Next 开源 LocalJev:用 oMLX 在本地跑兼容 Jev 的决策 API

GitHub Next 开源 LocalJev(github.com/githubnext/localjev):在团队尚未全员拿到 TypeSafe Jev 访问权时,用一上午搭出「穷人版 Jev」。它在 Bun/TypeScript 上提供兼容的 POST /v1/systemone API,默认经 oMLX 调用本地 DiffusionGemma 等模型,并评测了 DiffusionGemma、Qwen MoE、Gemma 4 MoE 与 Gemma 4 e4b/e2b;评测报告在仓库内。LocalJev 服务器可对接常规 Jev API 封装库,但概率来自模型自报而非 logit 直读,需自行校准。

核心要点速览

  • 开源 LocalJev:本地兼容 Jev 的 POST /v1/systemone 决策 API(Bun/TypeScript)。
  • 默认经 oMLX 跑 DiffusionGemma 等本地模型,并附多模型评测报告。
  • 可对接常规 Jev 客户端库;概率为模型自报而非 logit 直读,需自行校准。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ diffusiongemma⚡ qwen⚡ Gemma 4🌐 github

Together 9 月下调 H100 专属推理:5.49 美元/时降至 3.99 美元/时

Together AI 宣布 9 月把 H100 Dedicated Inference 从每小时 5.49 美元降至 3.99 美元,新旧部署自动生效。可部署 Gemma 4、Qwen3/3.5、gpt-oss、Llama、Nemotron 3.5 Lightning,或自带 LoRA 跑微调模型。对需要稳定吞吐、不愿与共享端点抢容量的编码智能体与微调产物,专属推理的小时价下调直接压低 7×24 托管成本。

核心要点速览

  • H100 专属推理 9 月从 5.49 美元/时降至 3.99 美元/时,新旧部署自动降价。
  • 可部署 Gemma 4、Qwen3/3.5、gpt-oss、Llama、Nemotron 3.5 Lightning,或自带 LoRA。
  • 适合需要隔离容量的生产推理与微调模型托管,无需迁端点即可享受新价。
阅读全文
AD赞助内容

Cohere 开源 24 亿参数视觉语言模型 North Micro Vision:Apache 2.0 赋能文档理解与多轮图文交互

Cohere 宣布在 Hugging Face 开源其最小的视觉语言模型 North Micro Vision。该模型仅 24 亿参数,采用 Apache 2.0 协议,支持原生分辨率视觉处理、图文多轮对话、空间推理定位与多语言图像理解,在文档理解与视觉问答评测中超越同级别 3B 模型。

核心要点速览

  • North Micro Vision 仅 24 亿参数,以宽松的 Apache 2.0 协议在 Hugging Face 完整开源权重。
  • 专为复杂企业级文档理解、报表解析与多轮图文对话定制,支持空间推理与精准定位。
  • 端侧轻量化设计,极适合边缘设备、本地开发工具与私有化视觉 Agent 部署。
阅读全文
关联模型 / 智能体 / 厂商: