AI 编程实时动态与要闻

Together AI 发布 Together Compiler:智能体持续优化线上推理,最高提速 2.6 倍

Together AI 11 月 4 日发布 Together Compiler(TKCC),用一群 AI 智能体配合常驻推理引擎,按真实流量、模型和硬件持续重写推理内核,并提出「多态推理」(Polymorphic Inference)思路。官方称 24 小时内在 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等模型上最高提升 2.6 倍 TPS,客户负载最高快 50%,目前已在生产中服务每天数万亿 token。

核心要点速览

  • Together Compiler 把推理优化从传统编译问题改成「智能体搜索」问题:智能体提出内核改动,常驻引擎验证速度和正确性,只有通过的改动才上线
  • 官方称 24 小时内在 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 上最高 2.6 倍 TPS,客户负载最高快 50%
  • InferenceX 低延迟 batch size 1 设置下:MiniMax M3.1-Flash 1111 TPS、DeepSeek v4.1-Flash 1205 TPS(公司自报),SemiAnalysis 称已复核其中一项结果
  • 常驻引擎热加载候选前向计算,上线时间 9 秒(对比重启引擎 467 秒),实验吞吐比基线智能体优化系统高 252 倍
  • 已在 Together 生产环境服务每天数万亿 token,Together 已有 40 多个模型由智能体优化
阅读全文

Ricursive 开源 Ripple-65B Preview:从零预训练的 65B 稠密模型,TerminalBench 2.1 80.5,Apache 2.0

Ricursive Intelligence 于 11 月 4 日(UTC 18:24)发布首个模型 Ripple-65B Preview,并在 Hugging Face 以 Apache 2.0 开源指令版(BF16、NVFP4)和基座版。官方模型卡显示:65B 稠密 Transformer、12T token 预训练、最长 1M 上下文,自报 TerminalBench 2.1 80.5、SWE-bench Pro v2.0 Hard 79.1、DeepSWE 1.1 44.3,在编码 Agent 任务上超过参数大得多的美国开源模型;可在 DGX Spark 等本地硬件运行。CEO Anna Goldie 称成本约为此前同类 SOTA 的十分之一。

Ricursive 开源 Ripple-65B Preview:从零预训练的 65B 稠密模型,TerminalBench 2.1 80.5,Apache 2.0

核心要点速览

  • Ripple-65B Preview 为 65B 稠密模型,80 层、d_model 5120 的“窄而深”结构,从 Olmo 3 基线改为类 Gemma 3N 架构。
  • 预训练 12T token(8K 序列),后训练含中训练、长上下文、SFT 与混合领域 RL,支持最长 1M 上下文。
  • 自报 TerminalBench 2.1 80.5,高于 Reflection Beam 501B(80.1)、Muse Spark Open 816B(76.4);但 SWE-bench Verified 76.5、DeepSWE 1.1 44.3 并非全面领先。
  • 官方称核心团队从 1 人扩到 5 人,代码计算效率相对 Olmo 3 提升 16 倍;2×B200 上约 250 tok/s。
  • Hugging Face 提供 BF16、NVFP4、基座版和 DFlash2 投机解码模型,许可均为 Apache 2.0。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ripple-65B Preview⚡ Reflection Beam 501B⚡ Muse Spark Open⚡ Nemotron 3 Ultra🌐 Ricursive Intelligence🌐 NVIDIA

OpenAI 公布 ChatGPT 与 Codex 用于硬件工程的进展:GPT-6 Astra 一周内设计出 Codex 设备,携手 Mazda 做空气动力学研究

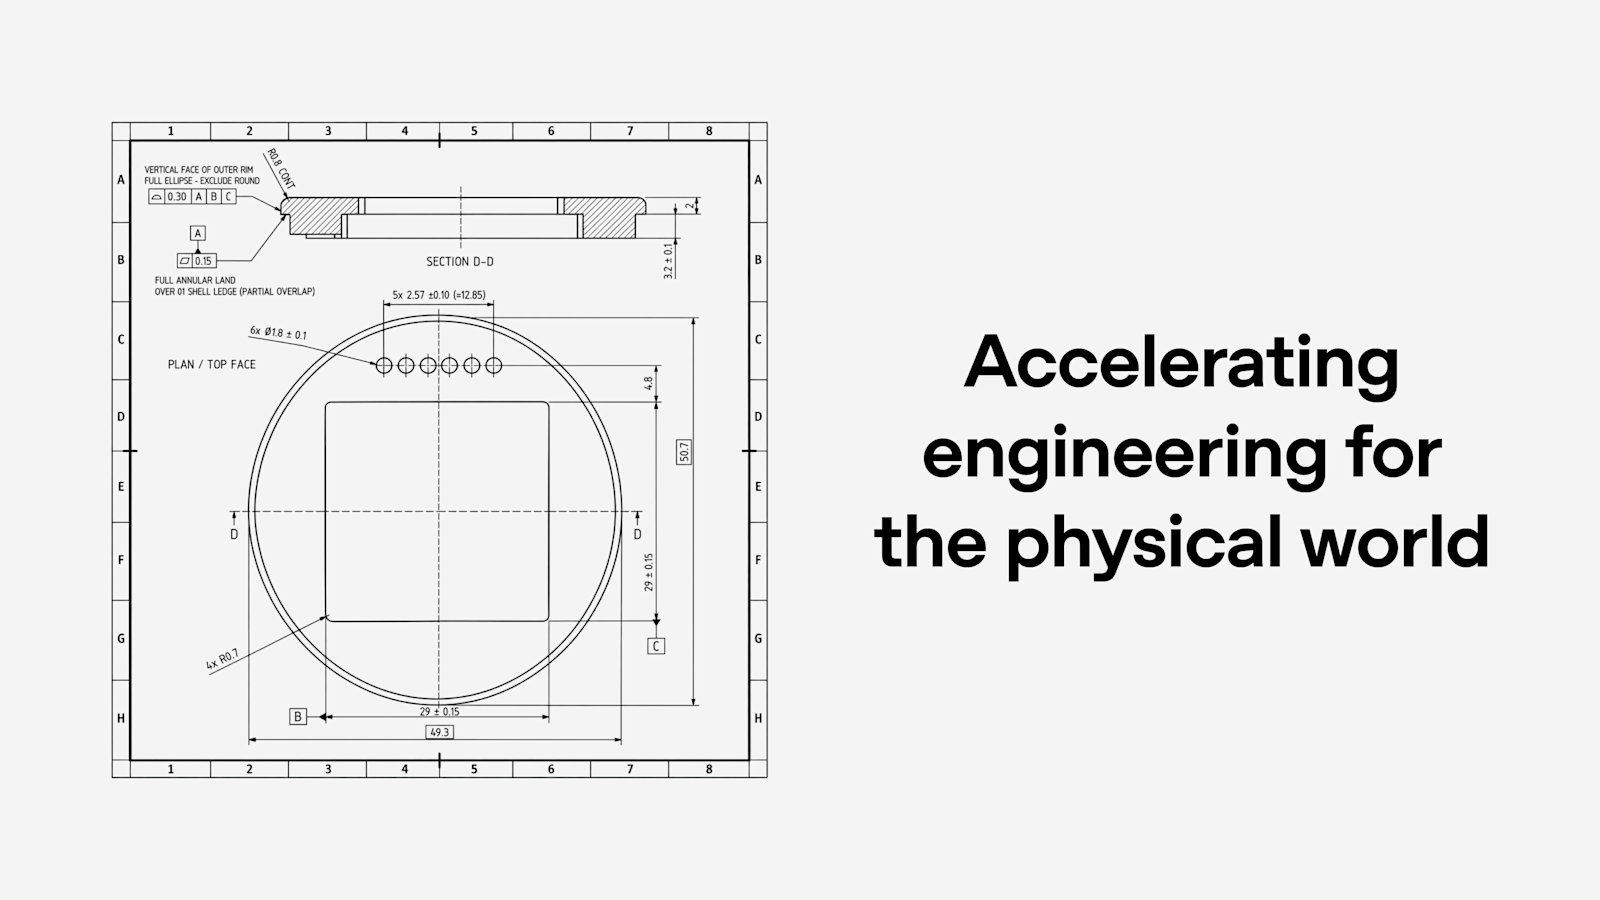
11 月 3 日,OpenAI 发布《Accelerating engineering for the physical world》,介绍其模型在机械设计、电子设计和仿真上的进展。两名员工用 GPT-6 Astra 在不到一周内设计出一台用来和 Codex 对话的设备(外壳、PCB、固件和软件),合同制造商不到一个月做出小批量原型,但量产前仍需多轮人工评审。OpenAI 硬件团队的模型 token 用量自 2 月以来增长 23 倍;在 BenchCAD 2.0 上,一个更新的内部模型平均得分 0.875,GPT-6 Astra 最高推理档为 0.594(官方口径)。OpenAI 还扩大与 Chip Ganassi Racing 的合作,并宣布与 Mazda 开展新的研究合作。

OpenAI 公布 ChatGPT 与 Codex 用于硬件工程的进展:GPT-6 Astra 一周内设计出 Codex 设备,携手 Mazda 做空气动力学研究

核心要点速览

  • GPT-6 Astra 在「无人工直接编辑」的测试里完成外观、外壳结构、元器件选型与 PCB 布局、UI 和固件;两名员工业余时间不到一周完成设计,原型不到一个月做出,见 OpenAI 博客。
  • 官方承认短板:Astra 没有稳定考虑制造商的产能限制、公差和装配细节,量产前仍需多轮评审迭代。
  • OpenAI 硬件与基础设施团队用 Codex/ChatGPT 做 CAD 建模、2D 工程图、仿真与 FEA、设计评审,token 用量自 2 月起增长 23 倍(官方口径)。
  • BenchCAD 2.0(重建 3D 零件与装配体、识别电路板连接):更新的内部模型 0.875,GPT-6 Astra 最高推理档 0.594(官方口径,内部模型未命名、未发布)。
  • 合作方:Chip Ganassi Racing 测试把 3D 扫描转成可编辑 CAD 和 2D 图纸;Mazda 与 OpenAI 研究团队用气流和结构仿真探索车型设计,结果「未来几个月」公布。
阅读全文

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

半导体与 AI 研究机构 SemiAnalysis 11 月 2 日发布 GDPx,用来衡量前沿模型在芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进(RSI)、硬件设计、材料科学、对齐和软件工程 11 个领域的智能体能力,共 206 道任务,由 14 家专业数据公司出题、SemiAnalysis 负责最终质检。官网榜单上 Claude Opus 5.5 以 12.0% 居首,Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6% 紧随其后;金融和法律任务几乎所有模型都是 0 分。SemiAnalysis 称 Opus 5.5 和 GPT-6 Astra 的总分被安全分类器拖低,并计划每 3–6 个月更新一版。以上分数均为 SemiAnalysis 口径。

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

核心要点速览

  • 规模:11 个领域、14 家数据合作方、206 道任务,默认单题时限 8 小时(GDPx 官网)
  • 榜单(SemiAnalysis 口径):Claude Opus 5.5 12.0%、Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6%、Muse Wonder Full 9.0%、Claude Fable 5.1 8.5%、GPT 6.1 Sol 8.4%、Claude Sonnet 5.5 8.2%
  • 开源与低价档:DeepSeek 4.1 Flash 1017 5.4%、GPT-6 Luna 5.1%、Grok 4.7 3.9%、GLM 5.3 2.7%;金融和法律任务几乎全部 0 分
  • 评测方法:优先用各家原生 harness(Opus 用 Claude Code、Astra 用 Codex、Carbon 用 Antigravity),没有的用 OpenCode;报告 3 次尝试的 pass@1,各领域等权(SemiAnalysis 博客)
  • 分领域:Opus 5.5 赢量化、硬件和芯片设计;Gemini 4 Carbon 赢生物和软件工程;GPT-6 Astra 赢 RSI 和材料科学;Muse Wonder Full 是最强网安模型
阅读全文
AD赞助内容

X 热议:Matt Pocock 发帖描绘理想的「agent 编程语言」——像 Rust 一样快、像 Go 一样少设计空间、类型校验最严格,点名 Bend,Chris Lattner 回帖推荐 Mojo

TypeScript 教育者 Matt Pocock(@mattpocockuk,Total TypeScript、AI Hero 作者)在 UTC 2026-10-25 17:23 发帖(原帖)称,下一个伟大的「agent 编程语言」应当像 Rust 一样快、像 Go 一样设计空间小、拥有有史以来最严格的类型/校验系统,并说 Bend 是「有意思的首次尝试」。抓取时约 3,130 赞、84 转发、264 回复、786 收藏、22 万浏览,进入 X 热门话题。Mojo 作者 Chris Lattner 回帖(回帖)推荐 Mojo,并建议把「能面向所有硬件」加进清单。这是观点讨论,不是已证实的结论。

核心要点速览

  • 主帖:原帖,UTC 10-25 17:23 发布,抓取时约 3,130 赞、84 转发、264 回复、786 收藏、22 万浏览
  • 三条标准:速度对标 Rust、设计空间小到像 Go(同一件事写法少)、类型/校验系统要「有史以来最严格」,思路是让编译器替人拦住 agent 写错的代码
  • Chris Lattner 回帖推荐 Mojo,称其具备线性类型、符号约束等高级类型特性,并提议加上「能面向所有硬件」(回帖,抓取时约 40 赞)
  • Bend 作者 Victor Taelin(@VictorTaelin)也在回复串中参与讨论,称 Bend 拦下了 agent 对应用的破坏性修改是「按设计工作」
  • 讨论没有给出任何跑分或对比实验,Bend、Mojo 是否适合 agent 编程目前只是个人观点
阅读全文
关联模型 / 智能体 / 厂商:

Google Cloud 开源 TorchTPU:PyTorch 原生直通谷歌 TPU 芯片,vLLM 与 SGLang 宣布首发适配

Google Cloud 官方正式宣布开源 TorchTPU 核心加速框架,首次实现 PyTorch 框架原生、无编译壁垒地直接运行在 Google TPU(TPU v5p 与最新 TPU v6e)芯片之上。传统基于 PyTorch/XLA 的方案因复杂的计算图编译开销和动态形状限制,严重制约了 PyTorch 开发者在 TPU 上的创新步伐。TorchTPU 彻底打通了原生 PyTorch Eager 模式与自定义 Triton/C++ 硬件内核;主流高性能大模型推理引擎 vLLM 与 SGLang 同步官宣提供首发适配。同时,Google Cloud 宣布在其 Model Garden 引入 OpenAI 旗舰模型与 Codex,成为首个集齐全部三大顶级闭源模型的超算云平台。

Google Cloud 开源 TorchTPU:PyTorch 原生直通谷歌 TPU 芯片,vLLM 与 SGLang 宣布首发适配

核心要点速览

  • Google Cloud 官方开源 TorchTPU,支持 PyTorch 原生、免转译直接运行在 TPU v5p 与 TPU v6e 芯片
  • 彻底消除 PyTorch/XLA 传统图编译开销,原生支持 PyTorch Eager 动态模式与自定义 Triton/C++ 算子加速
  • vLLM 与 SGLang 同步发布专为 TorchTPU 深度优化的官方版本,实现高并发大模型推理吞吐量翻倍
  • OpenAI 旗舰模型与 Codex 正式登陆 Google Cloud Model Garden,打造最全面的跨厂商大模型生态
阅读全文

NVIDIA 官宣 OpenShell 智能体安全参考架构:硬件级隔离安全护栏,终结 Agent 越权操作隐患

在 GTC Berlin 大会上,NVIDIA 官方正式发布 OpenShell 智能体安全参考架构与全新的 Agent Knowledge Foundation 套件。针对自主 AI 智能体(Autonomous Agents)在拥有系统写权限、数据库查询与终端执行能力后,极易因提示词注入或失控执行产生越权访问机密数据、发起破坏性命令的行业痛点,OpenShell 基于硬件级隔离信任根(Hardware-Isolated Security)构建了严密的运行时安全边界。系统能够以纳秒级开销实时监控并拦截智能体跨越授权边界的工具调用与数据交互,成为企业级安全可靠智能体调度的基石标准。

NVIDIA 官宣 OpenShell 智能体安全参考架构:硬件级隔离安全护栏,终结 Agent 越权操作隐患

核心要点速览

  • NVIDIA 在 GTC Berlin 峰会重磅发布 OpenShell 参考架构,以硬件级安全隔离为自主智能体划定不可逾越的运行边界
  • 提供全生命周期运行时动态拦截机制,在智能体试图访问非授权数据库、外发敏感 Token 或执行越权脚本时实现硬核阻断
  • 无缝整合 NVIDIA Agent Toolkit 与全新的 Agent Knowledge Foundation,打通企业知识库安全鉴权与合规审计链路
  • 彻底破解企业在生产环境部署高权限 Coding Agent 与自动化运维智能体(SRE)的安全合规合流难题
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 在 GTC 柏林发布 OpenShell 参考架构:用 Vera Rubin、Vera CPU 与 BlueField-4 Sentry 给 AI Agent 加硬件级安全边界

10 月 21 日 GTC 柏林,NVIDIA 发布 OpenShell 参考架构:以开源 OpenShell 安全运行时为基础,把 Vera Rubin 推理、Vera CPU 上的 Agent 编排与 BlueField-4 上的 NVIDIA Sentry 硅级策略执行拼成全栈,用于在企业与边缘侧构建、隔离、观测并强制约束 Agent。官方称现已可用,并列出 Anthropic、OpenAI、Meta、Microsoft、ServiceNow 等合作方;开源仓库为 Apache 2.0。

NVIDIA 在 GTC 柏林发布 OpenShell 参考架构:用 Vera Rubin、Vera CPU 与 BlueField-4 Sentry 给 AI Agent 加硬件级安全边界

核心要点速览

  • 全栈:Vera Rubin 跑模型推理,Vera CPU 跑 Agent harness/工具调用,BlueField-4 + Sentry 在硅上做策略执行与越界隔离(官方口径)
  • 厂商口径:Vera Rubin NVL72 对 Agent 负载每兆瓦吞吐约 30 倍于前代;Sentry 可在毫秒级隔离越界 Agent,并称可把 Agent 容量提升约 20%
  • 运行时层:默认拒绝、进程外强制;沙箱无直连网络,系统调用经内核过滤,凭证仅注入到策略允许的请求
  • 已声明支持 Claude Code、Codex、GitHub Copilot CLI、OpenCode、OpenClaw、LangChain Deep Agents 等;可 Docker/Podman/Kubernetes(Helm)
  • 上手:curl 安装脚本 + openshell sandbox create;文档 docs.nvidia.com/openshell;GitHub NVIDIA/OpenShell(Apache 2.0)、PyPI openshell
阅读全文

端侧算子自动生成首个统一基准:EdgeKernelBench 联合 LEKA 智能体攻克异构硬件代码生成

多所顶尖高校与科研机构在 arXiv:2610.24648 中正式发布首个面向异构端侧硬件的大模型底层算子生成统一基准 EdgeKernelBench 与分层智能体架构 LEKA。针对当前学术界算子生成评测过度局限于云端高性能服务器 GPU,而在端侧设备上面临硬件高度异构、底层软件栈严重碎片化(CUDA、OpenCL、TileLang、Triton)以及极度严苛资源约束的行业痛点,EdgeKernelBench 建立了包含 331 项经典任务与 650 个实例的统一中间表示(IR)部署管线。配合分层算子生成智能体 LEKA 解耦复杂编译决策,使大模型端侧算子生成性能取得跨越式突破。

端侧算子自动生成首个统一基准:EdgeKernelBench 联合 LEKA 智能体攻克异构硬件代码生成

核心要点速览

  • 研究团队在 arXiv:2610.24648 中开源首个端侧异构算子生成统一基准 EdgeKernelBench,填补端侧 AI 编译大模型评测空白
  • 涵盖 CPU/LLVM、GPU/CUDA 与 GPU/OpenCL 等跨平台硬件栈,设立 331 项经典计算范式与 650 个实测实例
  • 提出分层端侧算子生成智能体 LEKA(Layered Edge Kernel Agent),沿 IR 中间表示层级化解耦决策,攻克传统单次生成仅 25.5% 性能达标的瓶颈
  • 为移动端芯片、嵌入式 NPU 与机器人端侧加速器的底层高性能算子自动化编译铺平了产业落地道路
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

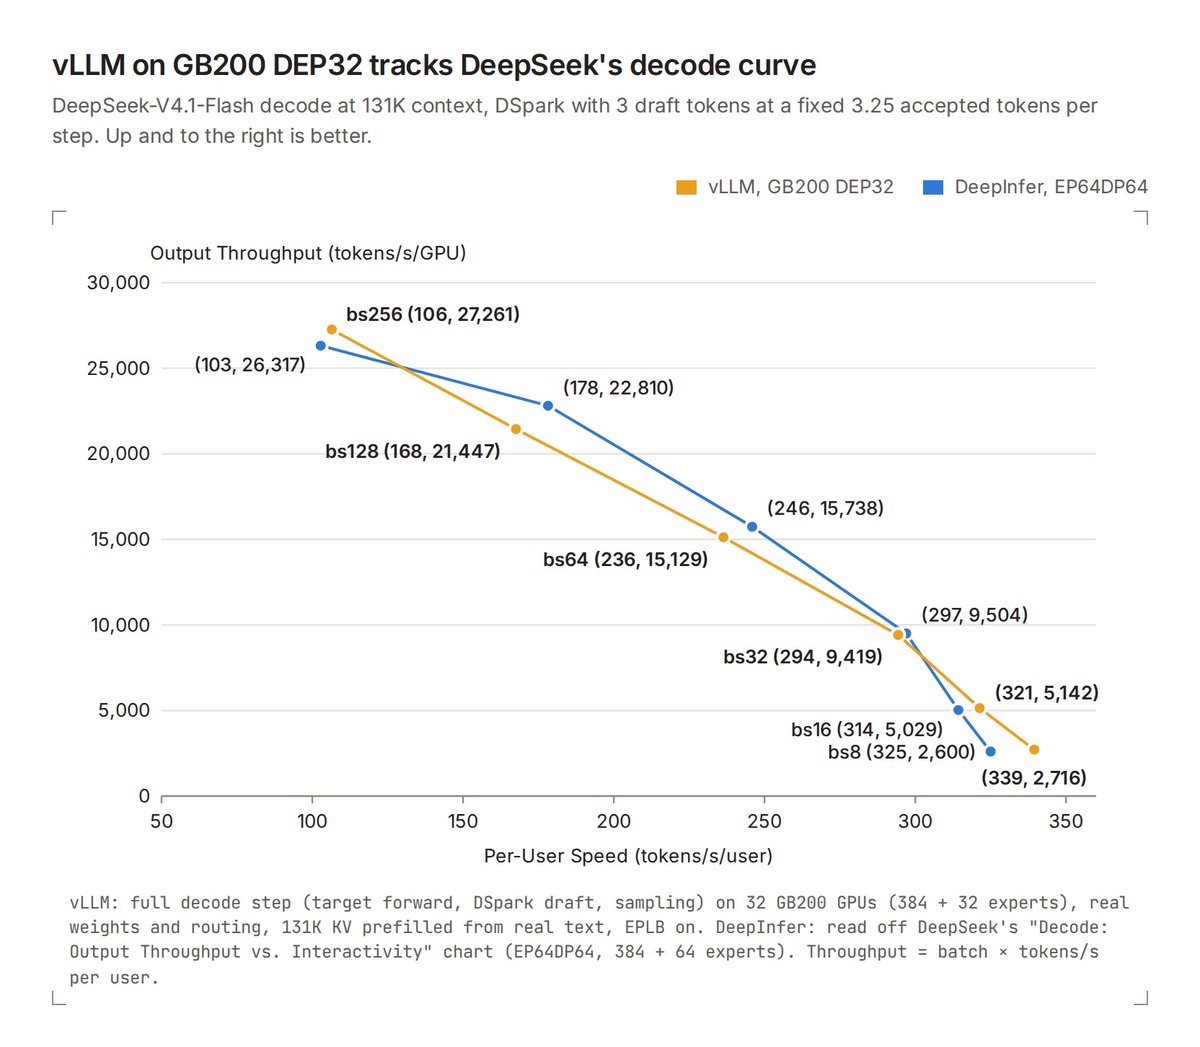
在 DeepSeek 宣布开源其生产级推理引擎 DeepInfer 数小时后,vLLM 官方项目团队正式公布了针对 DeepSeek-V4.1-Flash 的实测重磅性能对标数据。采用 DeepSeek 官方完全相同的测试拓扑(131K 超长上下文、nextn=3 投机采样),vLLM 在 NVIDIA GB200 NVL 架构上针对 Batch Size 8~256 的全并发区间,将与 DeepInfer 的端到端吞吐差距压缩至 6% 以内;在下一代 GB300 架构上,单 GPU 吞吐量突破 1,000,000 Token/秒,单用户峰值输出达 826 Token/秒,折合单 GPU 每小时营收达 38.96 美元。同时宣布 FastH3-Omni 与 Spark-X2.6-4B 首发支持。

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

核心要点速览

  • vLLM 团队迅速公布实测对标数据,在 NVIDIA GB200 上运行 DeepSeek-V4.1-Flash 吞吐已追平至仅落后 DeepInfer 6%
  • 在下一代 NVIDIA GB300 硬件架构上,vLLM 实现单张 GPU 吞吐达 100 万 Token/秒,单用户峰值输出 826 Token/秒
  • 按 DeepSeek 线上非高峰期官方定价测算,单台 GPU 每小时可产生高达 38.96 美元的云端推理收益,经济效益惊人
  • 同步宣布对多模态视频大模型 FastH3-Omni 与拥有 100 万上下文的 4B 模型 Spark-X2.6-4B(Apache 2.0)提供 Day-0 首日原生支持
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Eagle 发布 EAGLE-4 推测解码草稿模型:一个 drafter 按批量与硬件自适应,官方称 Qwen3.8-27B 单请求 961.6 tok/s

10 月 20 日,推理加速公司 Eagle 发布 EAGLE-4,这是 EAGLE 推测解码系列的第四代。它用一个草稿模型按批量、硬件和负载动态调整推测树,同时保持目标模型输出分布不变。官方口径下,Qwen3.8-27B 在 4 张 B300 上单请求达 961.6 tokens/s。代码以 eagle-harness v0.1.0 发布,支持 SGLang、vLLM 和实验性的 TokenSpeed。注意:多数转发称其“开源”,但官方许可证是源码可用(source-available)许可,并非 OSI 开源。

Eagle 发布 EAGLE-4 推测解码草稿模型:一个 drafter 按批量与硬件自适应,官方称 Qwen3.8-27B 单请求 961.6 tok/s

核心要点速览

  • 官方/厂商口径:Qwen3.8-27B + TokenSpeed,BF16、4× B300、TP4、单请求、T=0 下达 961.6 tokens/s(论文图 1(a))
  • 仓库实测表:vLLM 4× B300 单并发 241.6→722.8 tok/s(2.99×),并发 8 为 1.70×;SGLang 并发 8 为 1.91×、并发 64 降到 1.35×
  • AMD 也有数:SGLang 单卡 MI355X 并发 8 为 2.07×、并发 32 为 1.56×(ROCm 7.2)
  • 架构:滑动窗口草稿层 + 低秩候选头 + 只追加草稿缓存;harness 先离线标定验证延迟,再按“收益/成本”决定树的宽深
  • 许可:Eagle 4 Source-Available License,非商用免费;商用仅限 12 个月总营收不超过 2000 万美元且不构成竞品,超出需另签授权
阅读全文
关联模型 / 智能体 / 厂商:

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

半导体分析机构 SemiAnalysis 发布最新评测:Inferact(vLLM 核心团队)联合 Google 正式提交了首份基于 Google TPUv7 的 Kimi K3 2.8T 巨型 MoE 模型推理基准。在单芯片时租仅 1.21 美元(相比 GB300 2.31 美元、B300 2.26 美元、GB200 1.86 美元)下,借助 TorchTPU vLLM 大核与 TPU-Sync KVCache 卸载库,TPUv7 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X。

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

核心要点速览

  • Inferact(vLLM 核心团队)联合 Google 提交首份 Google TPUv7 Kimi K3 2.8T 巨型 MoE 推理基准
  • TPUv7 单芯片时租仅 1.21 美元,显著低于 GB300(2.31 美元)、B300(2.26 美元)与 GB200(1.86 美元)
  • 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X
  • 基于 TorchTPU vLLM 大核与 TPU-Sync KVCache 库,标志着 vLLM 在 Google TPU 架构上取得生产级重大突破
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 给 METR 评估团队「类员工」访问权限:6 人进驻内部系统,Anthropic 无权否决其发布风险评估

Anthropic 于 10 月 15 日(美西时间)宣布,已为非营利评估机构 METR 的 6 名员工开通「类员工」权限:公司设备、办公位,以及大致与自家风险评估团队相当的内部工具和系统访问。METR 将公开其对 Anthropic 风险水平、事件与做法的分析,Anthropic 不能否决发布,只能按预先约定的类别要求删改。Anthropic 同时公布三档评估方访问分级,并披露 SecureBio、Accenture、Faculty 等合作进展。

Anthropic 给 METR 评估团队「类员工」访问权限:6 人进驻内部系统,Anthropic 无权否决其发布风险评估

核心要点速览

  • METR 6 名员工获公司设备、办公位与大致等同 Anthropic 风险评估团队的内部访问(官方口径)
  • Anthropic 无权否决 METR 发布,只能在客户数据、律师-客户特权信息、模型架构等预设类别内要求删改
  • 评估方访问分三档:第 1 档需批准才能发布,第 2 档可自主发布,第 3 档(即 METR)再加类员工访问
  • SecureBio 正在审阅 8 月风险报告的化学与生物武器章节;与 Accenture、Faculty 推进红队与对齐评估合作,并与 Hugging Face 等早期接触
  • 官方推文发布约 3 天内浏览约 53.7 万次、点赞约 3,800
阅读全文

AMD 发布 Helion Agentic AI 机架蓝图:OCP 开放规格、CPU 专用最高 32768 核,企业一体机混搭 MI350P,伙伴机预计 2026 年 11 月上市

AMD 于 2026-10-12(OCP Global Summit 期间)官宣 AMD Helion:面向 Agentic AI 的开放机架蓝图,基于 Open Compute Project 规格,承接 Helios 的开放平台思路。超大规模可部署 6th Gen EPYC 的 CPU-only 机架(最高约 32768 核)专跑 Agent 执行并外接推理;企业侧可把 EPYC、Instinct MI350P 与通算节点打成一体机。软硬件开放,含将 Agent 模型调用导向前沿/开源模型的集成 token router;规格拟贡献给 OCP,伙伴配置计划 2026 年 11 月可用。

核心要点速览

  • 官方:AMD Newsroom Helion / GlobeNewswire 通稿(2026-10-12)
  • 两种示例配置:CPU-only(6th Gen EPYC,最高约 32768 核,超大规模 Agent 执行)vs 一体机(EPYC + Instinct MI350P + 通算,企业侧)
  • 架构要点:OCP 规格蓝图、液冷/风冷可选、开放软件、集成 token router 路由前沿与开源模型调用
  • 落地节奏:规格拟贡献 OCP;Cisco / Dell / 鸿海 / HPE / Lenovo / QCT / Supermicro / Wiwynn 表态支持;伙伴机计划 2026-11 可用(厂商口径)
  • 定位差异:Helios 偏训练/大规模推理;Helion 强调 Agent 执行与推理的灵活配比,勿把二者当成同一产品线 SKU
阅读全文

大模型强化学习显存骤降 45.7%!LoGRA 论文与开源库发布:首创低秩梯度草图攻克 27B 单节点训练瓶颈

强化学习后训练(RL Post-Training,如 PPO、DPO 与 RLVR)是激发大语言模型复杂推理与泛化能力的核心引擎。然而,大模型强化学习对 GPU 显存的吞吐需求极其苛刻:除了模型本身的权重与激活值外,训练节点必须同时维护庞大的全尺寸梯度缓冲区与 Adam 优化器一阶、二阶矩状态,导致 27B 甚至更大参数规模的开源模型在单台标准 8 卡 GPU 节点上频频遭遇 OOM(内存溢出)崩溃。在最新发表的研究成果(arXiv:2610.06647)中,研究团队发布了轻量级强化学习缩放框架 LoGRA(代码已合入开源 Molt 库:github.com/skzhang1/labs-molt)。LoGRA 彻底推翻了保存稠密全尺寸梯度的传统做法,创新性地提出了‘低秩梯度草图(Low-Rank Gradient Sketches)’机制:在反向传播过程中将有用梯度信号直接投影并累积至低维紧凑草图中,不仅大幅缩减了显存占用,更让多卡间的策略同步通信开销急剧下降。为防止压缩梯度导致的参数突变,团队配套设计了‘预测 KL 步长控制(Predicted-KL Step Control)’,在更新前动态预估策略偏离程度并平滑校正步长。实验表明,LoGRA 在主流推理基准上将平均训练显存降低高达 45.7% 且精度毫无衰减,并首次在单台 8-GPU 节点上稳定训练 27B 模型超过 1,100 步,彻底打破了大模型强化学习的高显存硬件壁垒。

大模型强化学习显存骤降 45.7%!LoGRA 论文与开源库发布:首创低秩梯度草图攻克 27B 单节点训练瓶颈

核心要点速览

  • 开源 LoGRA 框架发布,首创低秩梯度草图(Low-Rank Gradient Sketches)机制,强化学习显存骤降 45.7%
  • 突破单机 8 卡 GPU 硬件壁垒,成功实现 27B 参数大模型连续 1,100+ 步稳定强化学习后训练
  • 独创预测 KL 步长控制杜绝策略坍塌,数学与代码推理基准跑分达到全量 AdamW 统计无损水平
阅读全文