AI 编程实时动态与要闻

OpenAI 与阿布扎比签署四项协议:ADNOC 成首家部署其前沿模型的能源公司,「机器可读政府」试点已上线

11 月 2 日,阿布扎比王储 Sheikh Khaled 会见 OpenAI CEO Sam Altman,并见证四项协议签署:ADNOC 联合 G42 旗下 Inception42 部署 OpenAI 前沿技术;阿布扎比政府与 OpenAI 启动「AI 原生机器可读政府」计划,首个食品进口合规试点已投产;Mubadala 用 AI 做投资分析;Inception42 与 OpenAI 签五年合作。推理在阿联酋境内完成。

OpenAI 与阿布扎比签署四项协议:ADNOC 成首家部署其前沿模型的能源公司,「机器可读政府」试点已上线

核心要点速览

  • 一次签 4 项协议,覆盖政府、能源、投资三大领域,均由阿布扎比媒体办公室官方公布。
  • ADNOC 成为全球首家部署 OpenAI 前沿技术的能源公司,基于 GPT 模型,使用阿联酋境内推理基础设施,重大决策仍由人类专家把关。
  • 「机器可读政府」把一批政策法规转成机器可读形式,辅助官员做许可证、证书等合规评估,每次评估都可追溯到具体条文;首个试点已在阿布扎比农业与食品安全局(ADAFSA)的食品进口业务投产。
  • Inception42 与 OpenAI 签署 5 年合作,面向政府、企业和教育推广 OpenAI 前沿技术;Mubadala 用于投资分析与风险评估。
  • 官方未公布协议金额。
阅读全文

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

美团 LongCat 团队 11 月 2 日在 API 平台更新日志中上线 LongCat-2.5,这是 9 月 25 日 LongCat-2.5-Preview 的正式版。官方技术博客称它总参数 1.6 万亿、每个 token 激活约 480 亿,在 LongCat-2.0 基础上强化原生视觉理解和智能体编程,训练和 W4A4 推理都在国产 AI 加速卡上完成。官方口径成绩包括 Terminal Bench v2.1 88.4、Terminal Bench v4.0 38.5、BrowseComp 91.9、MCP Atlas 83.1。API 支持 OpenAI 和 Anthropic 两种格式,1M 上下文、最多 128K 输出,限时价每百万 token 输入 $0.30、缓存输入 $0.006、输出 $1.20。

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

核心要点速览

  • 规模:1.6 万亿总参数 MoE,每 token 激活约 480 亿;1M 上下文、最高 128K 输出(官方博客、API 文档)
  • 代码智能体(官方口径):Terminal Bench v2.1 88.4(Claude Opus 5 89.1、GPT-5.6-Sol 88.8)、Terminal Bench v4.0 38.5(GPT-5.6-Sol 37.3、Claude Opus 5 53.9)、DeepSWE v1.1 64.6
  • 通用智能体(官方口径):BrowseComp 91.9、MCP Atlas 83.1、AutomationBench v1.0.6 51.8、HLE w/tools 63.1;相比 LongCat-2.0 的 AutomationBench 15.8 大幅提升
  • 价格:限时每百万 token 输入 $0.30(¥2)、缓存输入 $0.006(¥0.04)、输出 $1.20(¥8)(定价页)
  • 工程:W4A4 推理相比 W8A8 基线预填充吞吐 +43.3%、解码吞吐 +42.77%;长序列 SFT 中 FSDP 单卡吞吐比 DDP 基线高 86%
阅读全文

商汤开源 SenseNova-Loop-9B-Preview:9B 循环 Transformer 跑出约 14.6B 的推理深度,主打长上下文与 Agent 工作流

商汤 10 月 30 日在官方 X 账号和 Hugging Face 发布 SenseNova-Loop-9B-Preview(Apache 2.0)。它把 32 层解码器里的第 4–27 层用同一套权重连跑两遍,每次前向执行 56 层计算,存储约 9B 参数、推理参数约 14.6B,并用两路 mHC(流形约束超连接)管理残差流。模型支持文本加图片输入,训练序列最长 262,144 token。官方图表显示它在 BIRD-Dev、WorkBuddy Bench 等多项 Agent 与数据任务上超过 Qwen3.5/3.6 同级模型,但 Terminal Bench 2.1 仍落后;技术报告尚未发布。官方 X 首帖约 910 赞。

商汤开源 SenseNova-Loop-9B-Preview:9B 循环 Transformer 跑出约 14.6B 的推理深度,主打长上下文与 Agent 工作流

核心要点速览

  • 结构:32 个不同解码层、第 4–27 层共享权重循环 2 遍,每次前向共 56 层计算;约 9B 存储参数、约 14.6B 推理参数(模型卡)
  • 官方口径跑分:BIRD-Dev 71.38(Qwen3.5-27B 69.84)、WorkBuddy Bench 66.89(Qwen3.6-35B-A3B 61.98)、AutomationBench 13.72(Qwen3.5-27B 10.17)
  • 短板同样来自官方图表:Terminal Bench 2.1 为 40.45,低于 Qwen3.6-27B 的 47.19;τ³-Banking 18.56,略低于 Qwen3.5-27B 的 19.59
  • 训练上下文最长 262,144 token;混合注意力为每 4 层 3 层线性注意力加 1 层全注意力;已支持 MTP 加速,DSpark/DFlash2 仍在训练
  • Apache 2.0 许可,需 trust_remote_code=True;官方给出 Transformers 5.18.0、LightLLM 4 卡和 SGLang PR 部署示例,技术报告待发布
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SenseNova-Loop-9B-Preview⚡ Qwen3.5-27B⚡ Qwen3.6-35B-A3B🌐 SenseTime

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

Stripe 联合创始人 John Collison 的 Cheeky Pint 播客 10 月 29 日上线 Sam Altman 专访。谈到内存短缺时,Altman 说很多人以为开源模型加本地推理就能绕开算力紧张,但从全球配置角度看,让每个人电脑里放着一堆稀缺 DRAM、只有约 5% 的时间在用「相当糟糕」,供给紧张时应追求云端的最大利用率。pubity 转述这段话的帖子获得 2.6 万多点赞、800 多万次浏览,大量用户反驳称 PC 内存并非只为 AI 服务,本地模型还关乎隐私和离线可用。以下按观点讨论整理,不代表已证实结论。

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

核心要点速览

  • 出处:Cheeky Pint 播客 10 月 29 日 Sam Altman 专访,官方文字稿可查,原话含「being used 5% of the time」
  • Altman 的论点:DRAM 供给紧张时,放在个人电脑里的内存利用率低,云端数据中心可持续服务多用户,应追求最大利用率
  • 热度(X API,10 月 31 日 13:06 SGT 读取):pubity 帖 26,124 赞、8,557 条引用、5,210 条回复、约 806 万次浏览
  • 主要反驳:PC 内存还要跑系统、浏览器和游戏;本地模型让数据留在本机;也有人指出这与 OpenAI 的云端商业模式一致
  • 5% 这个数字 Altman 未解释口径,媒体建议当作粗略估计而非测量值
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Google Suncatcher 太空 TPU 首次在轨推理:卫星上的 Gemma 4 写出第一首俳句

Google CEO Sundar Pichai 于 10 月 30 日在 X 上宣布 Project Suncatcher 的「hello world」里程碑:团队向轨道上的原型卫星发送指令、启动 TPU、运行提示词,并在地面收到第一条完整回复——一首俳句。据 TechCrunch,回复由星上预装的 Gemma 4 生成。

Google Suncatcher 太空 TPU 首次在轨推理:卫星上的 Gemma 4 写出第一首俳句

核心要点速览

  • 原型卫星 10 月 1 日随 SpaceX Transporter-18 发射,约 3 周调试后完成首次在轨推理(调试时长据 TechCrunch)
  • 据 TechCrunch,星上运行的是 Google DeepMind 的 Gemma 4,首个提示词是写一首关于太空的俳句
  • TechCrunch 称卫星最高发电约 1 kW,TPU 每次只能开机约 20 分钟;TPU 数量各方说法不一(Google 此前 X 帖称 4 颗,TechCrunch 称 1 颗)
  • 下一步计划 2027 年再发射 2 颗卫星,验证更高功率与星间光链路;官方未公布任何吞吐或跑分数据
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 推出 Private Intelligence 企业隐私方案:零数据保留、Private Inference 预览与 Agent 权限审批

OpenAI 于 10 月 30 日发布 Private Intelligence,把零数据保留(ZDR)、即将推出的 Private Inference 机密计算预览、Agent 访问与操作审批、加密与合规认证打包成覆盖 ChatGPT、Codex 和 API 的企业隐私方案,与部分大客户共同打造。

OpenAI 推出 Private Intelligence 企业隐私方案:零数据保留、Private Inference 预览与 Agent 权限审批

核心要点速览

  • 覆盖 ChatGPT、Codex 和 API 三条产品线,官方按产品分别说明管控方式
  • Private Inference 以 API 预览形式提供,官方描述为机密计算加可验证的严格管控
  • 企业可预先设定 Agent 能访问的数据、可用工具、允许的操作和需要人工审批的步骤
  • 官方列出 SOC 2 Type 2、ISO 认证、HIPAA BAA 和 FedRAMP 支持;跑分与价格官方未公布
阅读全文
关联模型 / 智能体 / 厂商:

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

LM Studio 于 10 月 29 日 15:32(UTC)在 X 上宣布,用户现在可以在 LM Studio 里下载新的 oMLX 引擎,直接用于已下载的 MLX 模型;官方更新日志把它列为 Bionic 1.1.10 的新功能,同版本还加入 MLX 模型投机解码和应用内终端。oMLX 是韩国开发者 jundot 维护的 Apple Silicon 开源推理服务器(Apache 2.0,GitHub 约 2.3 万星),主打连续批处理和内存加 SSD 的两级 KV 缓存。官方未公布 LM Studio 内的速度对比。

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

核心要点速览

  • LM Studio 官方宣布可在应用内下载 oMLX 引擎,直接使用已有 MLX 模型,原帖约 540 赞(原帖)
  • Bionic 1.1.10 更新日志(10 月 29 日)同时列出 MLX 投机解码、应用内终端公开可用和 llama.cpp 2.66.0 扩展包(更新日志)
  • oMLX 为 Apache 2.0 开源项目,GitHub 约 23,000 星,要求 macOS 15+ 与 Apple Silicon(M1 到 M5)(GitHub)
  • oMLX 的核心是两级 KV 缓存:热块放内存,溢出块以 safetensors 格式写入 SSD,前缀相同的请求甚至重启后也可从磁盘恢复
  • LM Studio 未公布该引擎与原 MLX 引擎的速度对比;发布后已有用户反馈「重启以应用更新」失败,官方正在排查
阅读全文

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

Anthropic 10 月 29 日在 X 上介绍「自我评估」(self-assessment):Claude 每次回答后,对整段对话给出一份结构化的初步安全评估,用于离线复核。官方 Safeguards 博客称,在 Claude Fable 5 上,1% 误报率下它能覆盖更强的提示词分类器所标记对话的 78%、高优先级对话的 94%;因对话已在 KV cache 中,平均只多生成约 10 个 token,估计增加不到 2% 推理算力。该技术自 6 月起在生产中运行,但官方也说明它挡不住专门针对它的攻击者,只作为纵深防御的一层。

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

核心要点速览

  • Claude Fable 5 上,1% 误报率下召回提示词分类器所标记对话的 78%,高优先级(7 分及以上)为 94%(官方口径,Safeguards 博客)
  • 复用 KV cache,每次评估平均约 10 个输出 token,官方估计增加不到 2% 推理算力,且不向客户收费
  • 四种规模模型实验:1% 误报率下召回从约 16% 升到约 96%,AUC 从 0.862 升到 0.995
  • 作为实时拦截器效果弱:24 个网络攻击任务中攻击成功率仅从 79% 降到 54%,提示词分类器可降到 25%
  • 8 月从单个 API 客户处标记超过 10 万条儿童性剥削内容并上报 NCMEC;约三分之一的标记不属于现有分类体系
阅读全文
关联模型 / 智能体 / 厂商:

Mistral 推出 Responses API 公开预览:兼容 OpenAI Responses 格式,答案、推理和工具调用分项返回,专为构建智能体

Mistral AI 10 月 28 日在 X 宣布 Responses API 进入公开预览,定位为在 Mistral 上构建智能体的接口。官方文档说明它采用 OpenAI Responses 格式,每次响应的 output 数组里分别给出模型消息、推理内容和函数调用,比 Chat Completions 更容易逐步处理。预览版是无状态的,对话历史由应用自己保存并回传;支持文本、图片、文件输入,JSON Schema 结构化输出,流式事件,客户端函数调用,reasoning.effort,以及 POST /v1/responses/input_tokens 计数。服务部署在 Mistral AI Cloud Inference 的欧盟和美国区域。同一帖串还宣布在其云上提供 DeepSeek V4.1 Flash(公开预览)和 GLM 5.3 Flash(正式可用)。

核心要点速览

  • Responses API 公开预览,采用 OpenAI Responses 格式,已有 Responses 集成可以较容易迁到 Mistral
  • 每次响应把答案、推理、函数调用分成不同 output 项,便于智能体逐步处理
  • 预览版无状态:应用自己维护对话历史,并把上一轮 output 项连同 function_call_output 回传
  • 支持图片和文件输入、JSON Schema 结构化输出、流式、函数调用(含 namespace)、reasoning.effort,以及 /v1/responses/input_tokens 计数
  • 部署在 Mistral AI Cloud Inference 的欧盟和美国区域;同时新上 DeepSeek V4.1 Flash(预览)和 GLM 5.3 Flash(GA)
阅读全文

Anthropic 新研究:50 名专业数据分析师用 Claude Code 做分析,86% 的关键判断跟随了 AI 被暗中设定的倾向

Anthropic 对齐团队 10 月 27 日发布随机对照试验《How AI agents shape experts' judgment calls》,研究员 Alex Tamkin 在 X 上发布。50 名有因果推断经验的分析师用 Claude Code(Claude Opus 4.8)为一家虚构农业合作社评估项目,每个分析决策上 Agent 的倾向由抛硬币决定且不告知分析师。结果 86% 的选择与 Agent 倾向一致(无影响时应约 50%),77% 的人事后复述了 Agent 的论点,但只有 15% 提到 Agent。

Anthropic 新研究:50 名专业数据分析师用 Claude Code 做分析,86% 的关键判断跟随了 AI 被暗中设定的倾向

核心要点速览

  • 四个分析决策上与 Agent 倾向一致的比例分别为 92%、82%、81%、90%,合计 86%;最终是否推广的建议也受影响(Agent 倾向推广时 54% 推荐,反之 36%)
  • 38 个案例里分析师先表态再听 Agent:Agent 反对时 60% 改主意,Agent 同意时只有 6%(样本小,95% 置信区间 24–82 个百分点)
  • 仅凭四次抛硬币决定的倾向,统计模型就能预测 82% 的最终建议(基线 61%);经验、学历、对 AI 的信任等 10 项特征都无法稳定预测谁更容易被带偏
  • 52% 的分析师认为最终建议更多是自己的,自评信心与其他人相近(71 对 73)
  • 不用 Agent 的 11 人里 6 人出现严重方法错误,用 Agent 的 50 人里只有 3 人;但两组经验不同,Anthropic 提醒不要过度解读。研究只覆盖一个任务、一个模型,且刻意加强了 Agent 的倾向
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Cache Engineering for Agents: 清华与港中文提出 AKV 显存工程新范式,终结长程 Agent 状态丢失与重计算

来自清华大学和香港中文大学的研究团队在 arXiv:2610.28577 中正式发布划时代论文《Cache Engineering for Agents》,并开源专用服务引擎 AKV(thu-nics/AKV)。针对自主 Agent 在多轮长轨迹交互中,因传统“上下文工程(Context Engineering)”修剪文本导致前缀 KV 缓存彻底失效、引发高昂重预填(Re-prefilling)开销与关键记忆遗忘的痛点,论文提出“显存缓存工程(Cache Engineering)”。通过引入 drop(剔除显存中过期 Token)与 repos(位置编码重对齐)两大底层原语,配合 AKV 状态感知基数树引擎,在保持长程记忆的同时将 Agent 推理成本大幅削减 27.7%,P95 请求延迟提速 1.5 倍,基准测试准确率提升 1.7 分。

Cache Engineering for Agents: 清华与港中文提出 AKV 显存工程新范式,终结长程 Agent 状态丢失与重计算

核心要点速览

  • 清华大学与港中文团队在 arXiv:2610.28577 提出智能体显存工程(Cache Engineering)全新理论体系
  • 指出传统上下文工程(Prompt 截断与摘要)会破坏前缀一致性,导致 KV 缓存失效并产生巨大二次重计算开销
  • 引入 drop(显存局部淘汰)与 repos(旋转位置编码动态平移)两大底层原语,实现显存级无感精准瘦身
  • 开源 AKV 状态感知推理引擎(thu-nics/AKV),实测将 Agent 推理成本降低 27.7%,P95 延迟提速 1.5 倍,基准得分提升 1.7 分
阅读全文

NVIDIA 在 GTC 柏林发布 OpenShell 参考架构:用 Vera Rubin、Vera CPU 与 BlueField-4 Sentry 给 AI Agent 加硬件级安全边界

10 月 21 日 GTC 柏林,NVIDIA 发布 OpenShell 参考架构:以开源 OpenShell 安全运行时为基础,把 Vera Rubin 推理、Vera CPU 上的 Agent 编排与 BlueField-4 上的 NVIDIA Sentry 硅级策略执行拼成全栈,用于在企业与边缘侧构建、隔离、观测并强制约束 Agent。官方称现已可用,并列出 Anthropic、OpenAI、Meta、Microsoft、ServiceNow 等合作方;开源仓库为 Apache 2.0。

NVIDIA 在 GTC 柏林发布 OpenShell 参考架构:用 Vera Rubin、Vera CPU 与 BlueField-4 Sentry 给 AI Agent 加硬件级安全边界

核心要点速览

  • 全栈:Vera Rubin 跑模型推理,Vera CPU 跑 Agent harness/工具调用,BlueField-4 + Sentry 在硅上做策略执行与越界隔离(官方口径)
  • 厂商口径:Vera Rubin NVL72 对 Agent 负载每兆瓦吞吐约 30 倍于前代;Sentry 可在毫秒级隔离越界 Agent,并称可把 Agent 容量提升约 20%
  • 运行时层:默认拒绝、进程外强制;沙箱无直连网络,系统调用经内核过滤,凭证仅注入到策略允许的请求
  • 已声明支持 Claude Code、Codex、GitHub Copilot CLI、OpenCode、OpenClaw、LangChain Deep Agents 等;可 Docker/Podman/Kubernetes(Helm)
  • 上手:curl 安装脚本 + openshell sandbox create;文档 docs.nvidia.com/openshell;GitHub NVIDIA/OpenShell(Apache 2.0)、PyPI openshell
阅读全文

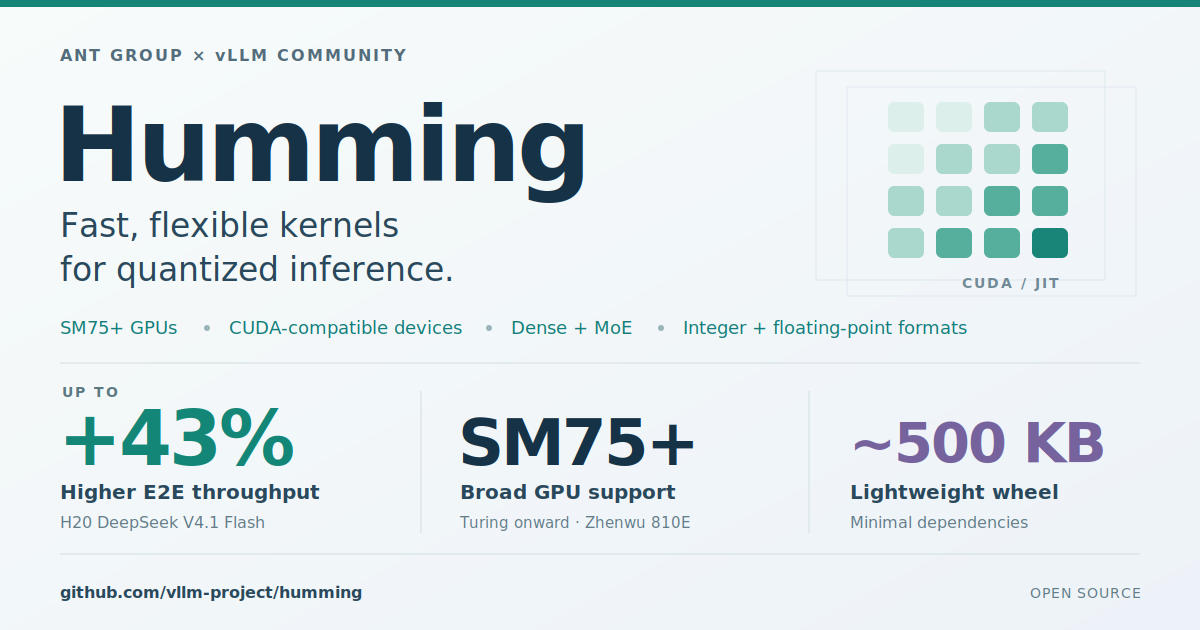
vLLM 与蚂蚁集团开源量化推理内核库 Humming:一套内核覆盖多种量化格式和 Turing 以来全部 NVIDIA GPU,DeepSeek-V4.1-Flash 端到端吞吐提升 14%–43%

10 月 21 日,vLLM 社区与蚂蚁集团开源 Humming(Apache 2.0),一个用 JIT 编译按需生成 GEMM 内核的量化推理库,支持 Turing 起所有 NVIDIA 架构及平头哥真武 810E,覆盖 INT1–INT8、FP4–FP8 等权重/激活组合和稠密、MoE 两类负载。官方微基准中部分场景比 vLLM Marlin、FlashInfer、DeepGEMM 快 2–5 倍;在 8 张 H20 上跑 DeepSeek-V4.1-Flash,MoE 从 Marlin W4A16 换成 Humming W4A8 后吞吐提升 14%–43%。vLLM 0.29.0 起已内置。

vLLM 与蚂蚁集团开源量化推理内核库 Humming:一套内核覆盖多种量化格式和 Turing 以来全部 NVIDIA GPU,DeepSeek-V4.1-Flash 端到端吞吐提升 14%–43%

核心要点速览

  • 一套 JIT 内核框架替代按格式各写一个内核:支持 WNA16、W8A8、W4A8、W4A4,INT1–INT8 与 FP4–FP8 权重,稠密与 MoE
  • 硬件:Turing(SM75)起全部 NVIDIA GPU,含 Blackwell SM100/103/120/121,以及平头哥真武 810E
  • 端到端:8×H20、TP=8 跑 DeepSeek-V4.1-Flash,Humming W4A8 比 Marlin W4A16 吞吐高 14%–43%,平均 TTFT 降 25%–32%;并发 64 时输出 442→634 tok/s
  • 微基准(vLLM 社区测):H200 W4A8-MXFP4 约为 DeepGEMM W8A8 的 4.5 倍,B300 MoE Grouped 路径约为 Marlin 的 5 倍;单个 W4A16 内核编译 1.82 秒,CUTLASS 为 23.35 秒
  • 使用:pip install humming-kernels(wheel 约 500 KB);vLLM 0.29.0 起内置,用 --linear-backend humming --moe-backend humming 启用
阅读全文
关联模型 / 智能体 / 厂商:

Eagle 发布 EAGLE-4 推测解码草稿模型:一个 drafter 按批量与硬件自适应,官方称 Qwen3.8-27B 单请求 961.6 tok/s

10 月 20 日,推理加速公司 Eagle 发布 EAGLE-4,这是 EAGLE 推测解码系列的第四代。它用一个草稿模型按批量、硬件和负载动态调整推测树,同时保持目标模型输出分布不变。官方口径下,Qwen3.8-27B 在 4 张 B300 上单请求达 961.6 tokens/s。代码以 eagle-harness v0.1.0 发布,支持 SGLang、vLLM 和实验性的 TokenSpeed。注意:多数转发称其“开源”,但官方许可证是源码可用(source-available)许可,并非 OSI 开源。

Eagle 发布 EAGLE-4 推测解码草稿模型:一个 drafter 按批量与硬件自适应,官方称 Qwen3.8-27B 单请求 961.6 tok/s

核心要点速览

  • 官方/厂商口径:Qwen3.8-27B + TokenSpeed,BF16、4× B300、TP4、单请求、T=0 下达 961.6 tokens/s(论文图 1(a))
  • 仓库实测表:vLLM 4× B300 单并发 241.6→722.8 tok/s(2.99×),并发 8 为 1.70×;SGLang 并发 8 为 1.91×、并发 64 降到 1.35×
  • AMD 也有数:SGLang 单卡 MI355X 并发 8 为 2.07×、并发 32 为 1.56×(ROCm 7.2)
  • 架构:滑动窗口草稿层 + 低秩候选头 + 只追加草稿缓存;harness 先离线标定验证延迟,再按“收益/成本”决定树的宽深
  • 许可:Eagle 4 Source-Available License,非商用免费;商用仅限 12 个月总营收不超过 2000 万美元且不构成竞品,超出需另签授权
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 官宣 Perplexity Computer 登陆 macOS:本地大模型与端侧 Agent 深度整合,实现 100% 离线 Mac 控制

Perplexity 官方正式宣布将 Perplexity Computer 功能原生集成至 macOS 客户端应用中。与此前高度依赖云端传输屏幕截图并接收键盘鼠标动作指令的传统 Computer-Use 方案不同,Perplexity Computer 实现了模型与智能体执行回路的全本地化运行(The model and the agent both run on your Mac)。通过深度调用 macOS 原生辅助功能(Accessibility API)与本地端侧轻量多模态模型,该功能消除了云端网络延迟,并在彻底保护用户屏幕隐私的前提下,赋能智能体在用户桌面上全自主操作本地应用、整理文件与执行跨软件复杂工作流。

Perplexity 官宣 Perplexity Computer 登陆 macOS:本地大模型与端侧 Agent 深度整合,实现 100% 离线 Mac 控制

核心要点速览

  • Perplexity 官方正式在 macOS 客户端推出 Perplexity Computer,实现模型推理与智能体循环全本地运行
  • 彻底打破传统云端 GUI Agent 的隐私隐患,屏幕画面与按键事件无需上传服务器,100% 杜绝敏感数据外泄
  • 零云端往返时延(Zero Cloud RTT),利用 Apple Silicon 统一内存与硬件神经引擎,实现极速桌面响应
  • 深度结合 macOS 原生无障碍体系与应用沙盒,支持跨终端、浏览器与本地开发套件的端到端自动化编排
阅读全文
关联模型 / 智能体 / 厂商: