AI 编程实时动态与要闻

LeCun 与 Balestriero 新论文把「柏拉图表征假说」证明为定理:1.09 亿参数文本 JEPA 与视觉模型的对齐度超过 72B 大模型

Randall Balestriero 与 Yann LeCun 10 月 29 日在 arXiv 发布论文《Proving and Improving the Platonic Representation Hypothesis with JEPAs》(2610.39302),署名单位为 Brown University、NYU 和 AMI Labs。论文证明:只要正样本对是同一场景的两次观测(「好视角」),分别在不同模态上训练的 JEPA 会学到只差一个旋转的相同表征;而 next-token prediction 相当于「坏视角」的 JEPA,所以语言模型只能靠堆规模才与视觉对齐。作者称,好视角达到同等对齐只需 next-token 的 1/42 训练样本,109M 文本 JEPA 在 DINOv2 对齐上得 0.184,高于 Qwen2.5-72B 的 0.154(论文作者口径)。代码与在线 Demo 已开放;Balestriero 的发布帖约 1,054 赞、7.2 万浏览。

LeCun 与 Balestriero 新论文把「柏拉图表征假说」证明为定理:1.09 亿参数文本 JEPA 与视觉模型的对齐度超过 72B 大模型

核心要点速览

  • 论文:arXiv 2610.39302,2026-10-29 提交,作者 Randall Balestriero、Yann LeCun(Brown University / NYU / AMI Labs)
  • 在 PRH 原有基准上,109M 文本 JEPA 与 DINOv2 的对齐分为 0.184,Qwen2.5-72B 为 0.154、Llama-3-70B 为 0.151;与 CLIP 图像编码器对齐为 0.23,此前最好为 0.21(作者口径)
  • 好视角只需 next-token prediction 1/42 的训练样本即可达到相同对齐;作者预先登记对齐缩放律的预测,再训练 85 个新 run,预测误差与换随机种子相当
  • 只用一个旋转把独立训练的编码器拼成图像描述器,COCO 上 CIDEr 0.838;在无配对基准上 ImageNet-100 top-5 为 64%,此前 8B 以内语言模型最高 56%
  • 代码 galilai-group/prh-proof 与 在线 Demo 已开放;Balestriero 发布帖 约 1,054 赞、180 转发
阅读全文
关联模型 / 智能体 / 厂商:

破解智能体自我进化瓶颈!通用递归自我提升框架 RSI-Anything 开源:代码修复率升至 31.2%

让人工智能智能体在与环境的持续交互中实现‘递归自我提升(Recursive Self-Improvement, RSI)’是实现通用人工智能的核心圣杯。然而,传统的智能体自演化范式长期受困于两大致命死穴:外部真实环境的反馈(Ground-Truth Feedback)通常极度稀缺且获取成本高昂;同时,伴随策略权重的持续迭代演化,充当模拟器的世界模型(World Models)极易因数据分布漂移而发生预测崩溃,引发灾难性的策略畸变。香港科技大学、上海人工智能实验室、北京大学与香港中文大学联合科研团队在最新力作(arXiv:2610.13912)中正式开源了领域通用的递归自我提升框架 RSI-Anything(代码仓库:github.com/Gen-Verse/RSI-Anything)。基于前沿联合嵌入预测架构 JEPA-Anything 构建,RSI-Anything 确立了‘提议 -> 预测 -> 筛选 -> 评估 -> 学习 -> 保留(Propose-Predict-Select-Evaluate-Learn-Retain)’的六阶段自我演进闭环。系统引入严格的组件与兼容性校验门禁,实现了策略模型与世界模型的动态协同适应。在跨越代码修复、GUI 桌面导航、实验室实验规划以及复杂化学反应优化的广泛实验中,RSI-Anything 展现出惊人的跨领域进化力:自动化代码修复成功率从静态验证器基线的 26.3% 跨越式跃升至 31.2%(提升近 5 个百分点);GUI 任务完成所需操作步数大幅缩减 39.4%;实验室规划得分经 5 轮迭代从 21.80% 暴增至 46.01%(翻倍以上);化学反应产率高达 96.15%,全面碾压传统贝叶斯优化,代码与训练管线已全量开源。

破解智能体自我进化瓶颈!通用递归自我提升框架 RSI-Anything 开源:代码修复率升至 31.2%

核心要点速览

  • 通用递归自我提升框架 RSI-Anything 正式开源,破解大模型智能体真实反馈匮乏与世界模型漂移瓶颈
  • 确立六阶段自演化闭环(P-P-S-E-L-R),代码修复率从 26.3% 跨越至 31.2%,GUI 操作步数精简 39.4%
  • 经 5 轮自迭代实验规划得分翻倍(21.80% 飙升至 46.01%),化学反应产率达 96.15% 碾压贝叶斯优化
阅读全文
A
AMI Labs / H-JEPA@kevinghst/H-JEPA·
👀146
🔥88

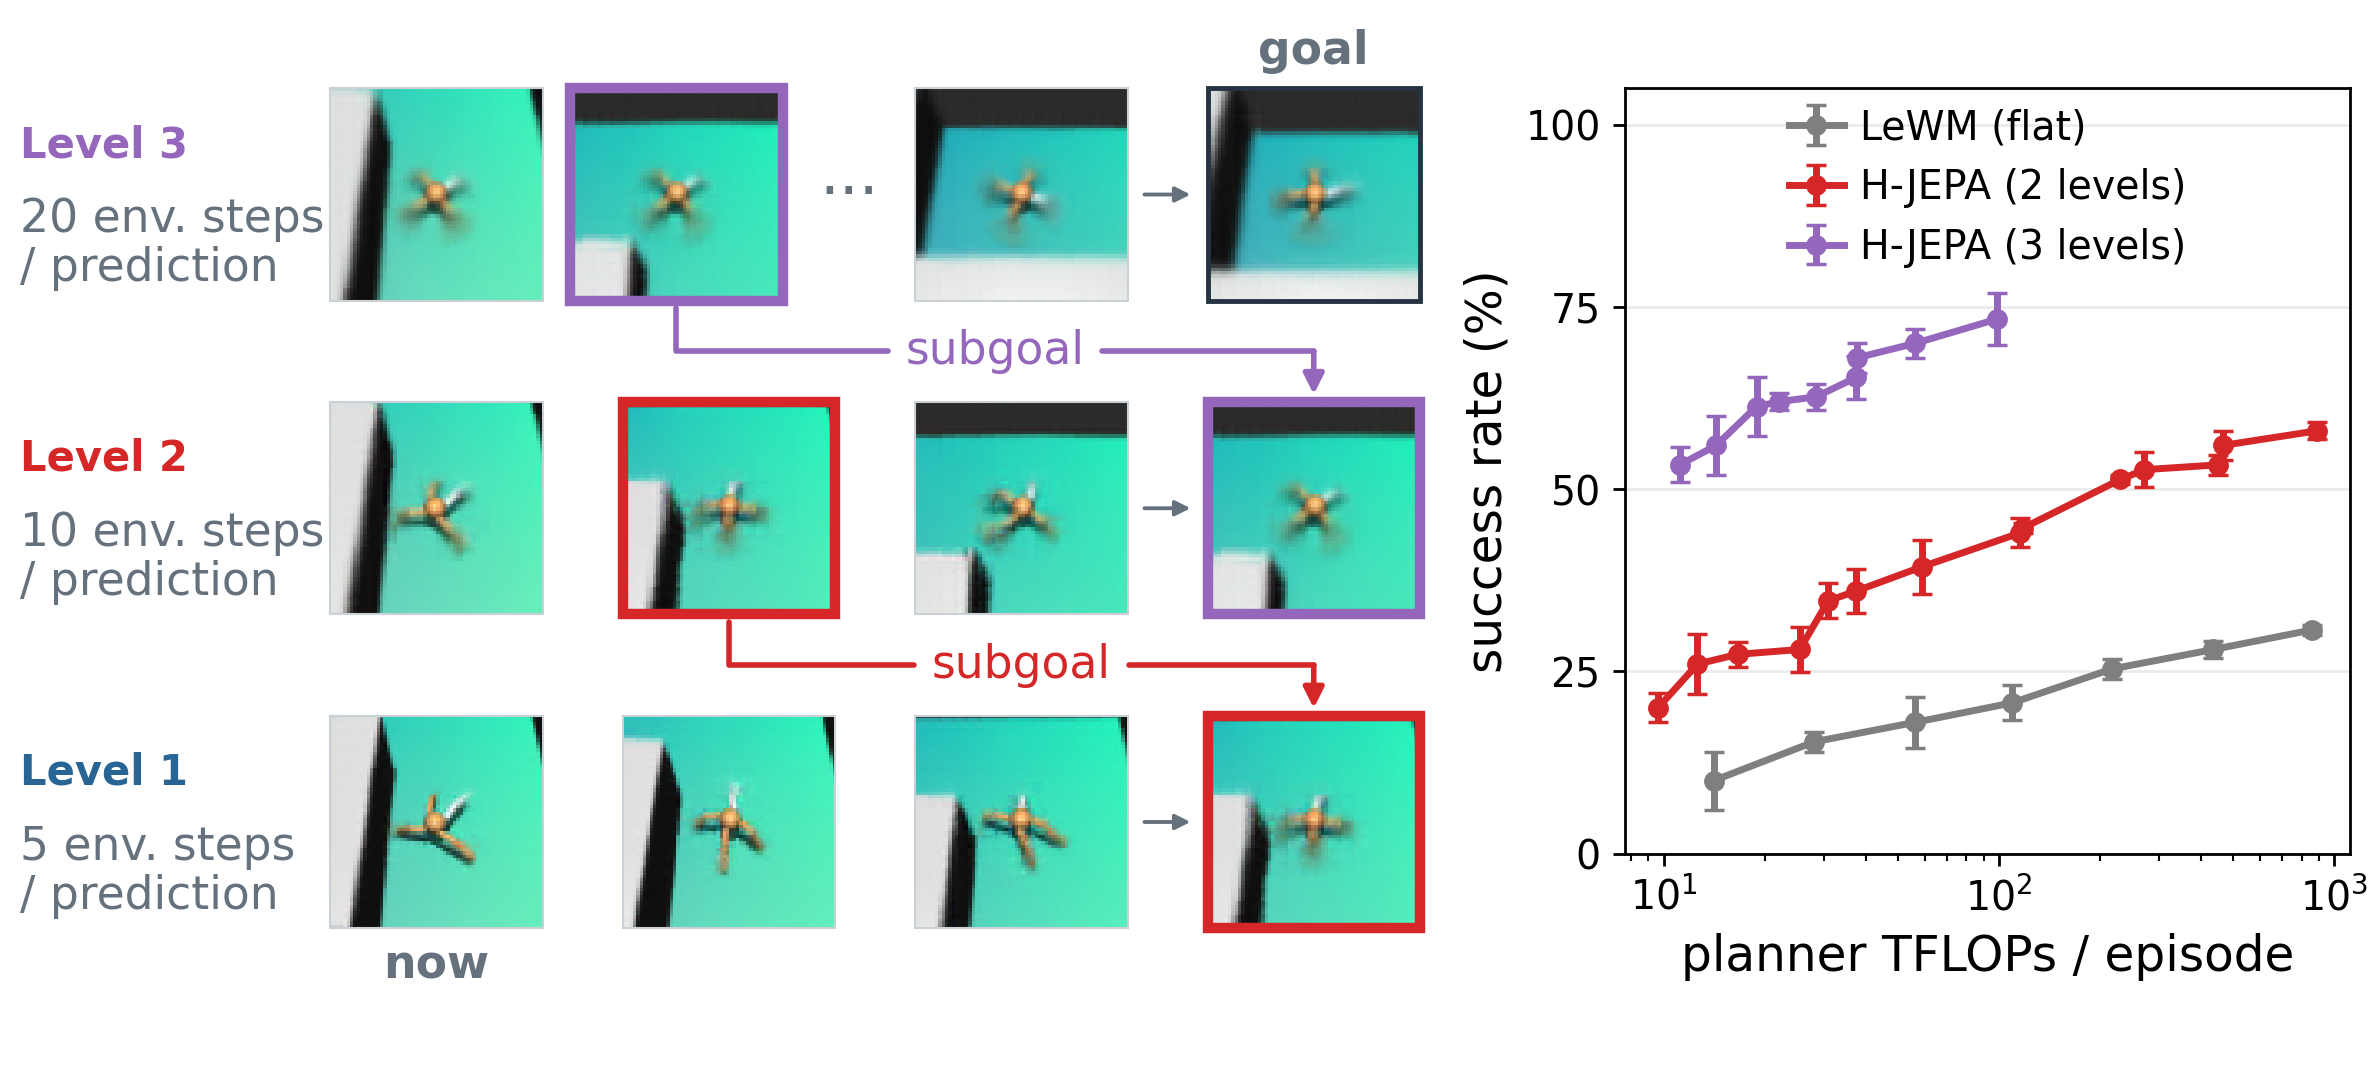
LeCun 的 AMI Labs 开源 H-JEPA:分层世界模型在 Visual AntMaze 上把规划成功率从 18% 提到 73%

Yann LeCun 参与创立的 Advanced Machine Intelligence(AMI Labs)联合 NYU、INRIA Paris、Brown 发布 H-JEPA(arXiv 2610.06805),一次端到端训练多层动作条件 JEPA 世界模型,每层在自己的潜空间里预测更远的未来,规划时自上而下下发子目标。论文口径:三层模型在 Visual AntMaze 成功率 73.3%,单层 LeWM 为 18.0%,规划算力反而更低。训练与评测代码(MIT 协议)以及 93 个 checkpoint 已在 GitHub / Hugging Face 公开。

LeCun 的 AMI Labs 开源 H-JEPA:分层世界模型在 Visual AntMaze 上把规划成功率从 18% 提到 73%

核心要点速览

  • Visual AntMaze:三层 H-JEPA 成功率 73.3%±3.5,单层 LeWM 18.0%±3.5(论文口径,三个种子),且规划 FLOPs 更低(arXiv 2610.06805)
  • FourRoom Distractors:三层 H-JEPA 96.0%,单层 LeWM 40.7%;AntMaze 上接近同深度 HWM(共享潜空间的分层基线)的 2 倍
  • 子目标跟踪代价单调性 0.89–1.00,全程目标代价仅 0.48–0.75,说明分层把长任务拆成了更好优化的子问题
  • 反例:Push-T 三层模型因短 episode 只能用到 LeWM 58% 的训练样本而失效;真实机器人 DROID 必须加逆动力学损失,否则表征坍缩、得分为 0
  • 开源 MIT 代码 + Hugging Face 93 个 checkpoint(约 12.4 GB,覆盖 AntMaze/FourRoom/Cube/Push-T/DROID)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ H-JEPA⚡ LeWorldModel (LeWM)⚡ V-JEPA 2🌐 AMI Labs🌐 NYU🌐 INRIA🌐 Brown University