AI 编程实时动态与要闻

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

LM Studio 于 10 月 29 日 15:32(UTC)在 X 上宣布,用户现在可以在 LM Studio 里下载新的 oMLX 引擎,直接用于已下载的 MLX 模型;官方更新日志把它列为 Bionic 1.1.10 的新功能,同版本还加入 MLX 模型投机解码和应用内终端。oMLX 是韩国开发者 jundot 维护的 Apple Silicon 开源推理服务器(Apache 2.0,GitHub 约 2.3 万星),主打连续批处理和内存加 SSD 的两级 KV 缓存。官方未公布 LM Studio 内的速度对比。

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

核心要点速览

  • LM Studio 官方宣布可在应用内下载 oMLX 引擎,直接使用已有 MLX 模型,原帖约 540 赞(原帖)
  • Bionic 1.1.10 更新日志(10 月 29 日)同时列出 MLX 投机解码、应用内终端公开可用和 llama.cpp 2.66.0 扩展包(更新日志)
  • oMLX 为 Apache 2.0 开源项目,GitHub 约 23,000 星,要求 macOS 15+ 与 Apple Silicon(M1 到 M5)(GitHub)
  • oMLX 的核心是两级 KV 缓存:热块放内存,溢出块以 safetensors 格式写入 SSD,前缀相同的请求甚至重启后也可从磁盘恢复
  • LM Studio 未公布该引擎与原 MLX 引擎的速度对比;发布后已有用户反馈「重启以应用更新」失败,官方正在排查
阅读全文

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

Anthropic 10 月 29 日在 X 上介绍「自我评估」(self-assessment):Claude 每次回答后,对整段对话给出一份结构化的初步安全评估,用于离线复核。官方 Safeguards 博客称,在 Claude Fable 5 上,1% 误报率下它能覆盖更强的提示词分类器所标记对话的 78%、高优先级对话的 94%;因对话已在 KV cache 中,平均只多生成约 10 个 token,估计增加不到 2% 推理算力。该技术自 6 月起在生产中运行,但官方也说明它挡不住专门针对它的攻击者,只作为纵深防御的一层。

Anthropic 公开 Claude「自我评估」滥用检测:回答后自评对话安全,1% 误报率下召回 78%,算力开销不到 2%

核心要点速览

  • Claude Fable 5 上,1% 误报率下召回提示词分类器所标记对话的 78%,高优先级(7 分及以上)为 94%(官方口径,Safeguards 博客)
  • 复用 KV cache,每次评估平均约 10 个输出 token,官方估计增加不到 2% 推理算力,且不向客户收费
  • 四种规模模型实验:1% 误报率下召回从约 16% 升到约 96%,AUC 从 0.862 升到 0.995
  • 作为实时拦截器效果弱:24 个网络攻击任务中攻击成功率仅从 79% 降到 54%,提示词分类器可降到 25%
  • 8 月从单个 API 客户处标记超过 10 万条儿童性剥削内容并上报 NCMEC;约三分之一的标记不属于现有分类体系
阅读全文
关联模型 / 智能体 / 厂商:

Cloudflare 披露 Workers AI 上 GLM-5.3 跨请求泄露事故:KV 缓存配置不匹配叠加 SGLang 漏洞,13 天内 155 条回复混入其他用户数据

Cloudflare 10 月 26 日在官方博客发布事故报告:8 月 27 日至 9 月 9 日,Workers AI 上的 GLM-5.3(@cf/zai-org/glm-5.3)对超过 681,280 token 的长提示,有 155 条回复混入了其他用户刚发过的请求内容,且都返回 HTTP 200。原因是 prefill 节点 KV 缓存池小于 1,048,576 token 的上下文窗口,叠加 SGLang 在 prefill/decode 分离模式下处理超长请求的漏洞。Cloudflare 称未发现恶意利用,已修复并建议运营方升级到 SGLang v0.5.22 或更高版本。

Cloudflare 披露 Workers AI 上 GLM-5.3 跨请求泄露事故:KV 缓存配置不匹配叠加 SGLang 漏洞,13 天内 155 条回复混入其他用户数据

核心要点速览

  • 影响范围:2026-08-27 至 09-09 共 155 条回复受影响,均为超过 681,280 token 的提示;Cloudflare 确认 Workers AI 其他模型未受影响
  • 根因 1:GLM-5.3 上下文 1,048,576 token,但 prefill KV 池只有 681,280 token;修复后池容量约 204 万 token,约为上下文的 2 倍
  • 根因 2:SGLang 把超长请求标记为拒绝并换成 1 token 占位,却没中止,decode 节点读到了未被覆盖的旧缓存页
  • 响应:9 月 8 日经 HackerOne 收到 Knostic 的 Gadi Evron 报告,9 月 9 日宣布事故后 40 分钟内下线模型,当天 19:40 UTC 恢复
  • 行动建议:自建 SGLang 的团队升级到 v0.5.22 或更高版本,并直接核对 KV 池大小与上下文长度
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Z.ai GLM 5.3🌐 cloudflare🌐 zai

原生记忆驱动模型进化:MemT-1.0 架构发布,128K 上下文 KV 显存开销削减 66 倍

多所顶尖研究机构在 arXiv:2610.26825 中正式推出原生记忆基础模型架构 MemT-1.0。针对传统大模型依赖庞大外部 KV Cache 或外挂 Vector RAG 导致的长文本显存爆炸与检索断层痛点,MemT-1.0 将记忆内化为模型计算的原生组成部分。基于 Metis 框架,模型采用 Gated DeltaNet-2 结合轮内稳定的 Token 级记忆更新机制,并引入 Mixture-of-Storage 结构拓展原生记忆容量。在 340 亿 Token 数据持续预训练与对齐后,MemT-1.0-Nano 在 128K 超长历史下实现 1.86 倍推理加速与惊人的 66 倍持久存储削减,显著提升复杂智能体长程任务成功率。

原生记忆驱动模型进化:MemT-1.0 架构发布,128K 上下文 KV 显存开销削减 66 倍

核心要点速览

  • MemT-1.0 架构正式亮相(arXiv:2610.26825),彻底将记忆从外部拼接上下文转变为模型内部原生计算机制
  • 采用 Gated DeltaNet-2 与单轮 Token 级稳定记忆更新策略,配合 Mixture-of-Storage 架构无损扩充原生记忆容量
  • 在 128K 超长上下文历史测试中,相比传统全量 KV Cache 实现 1.86 倍端到端推理提速,持久化存储需求直降 66 倍
  • 内化检索到的操作规程与经验知识,在复杂多轮 Agent 评测中显著改善任务成功率,为自进化长程智能体指明方向
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MemT-1.0-Nano⚡ MemT-1.0-Flash
AD赞助内容

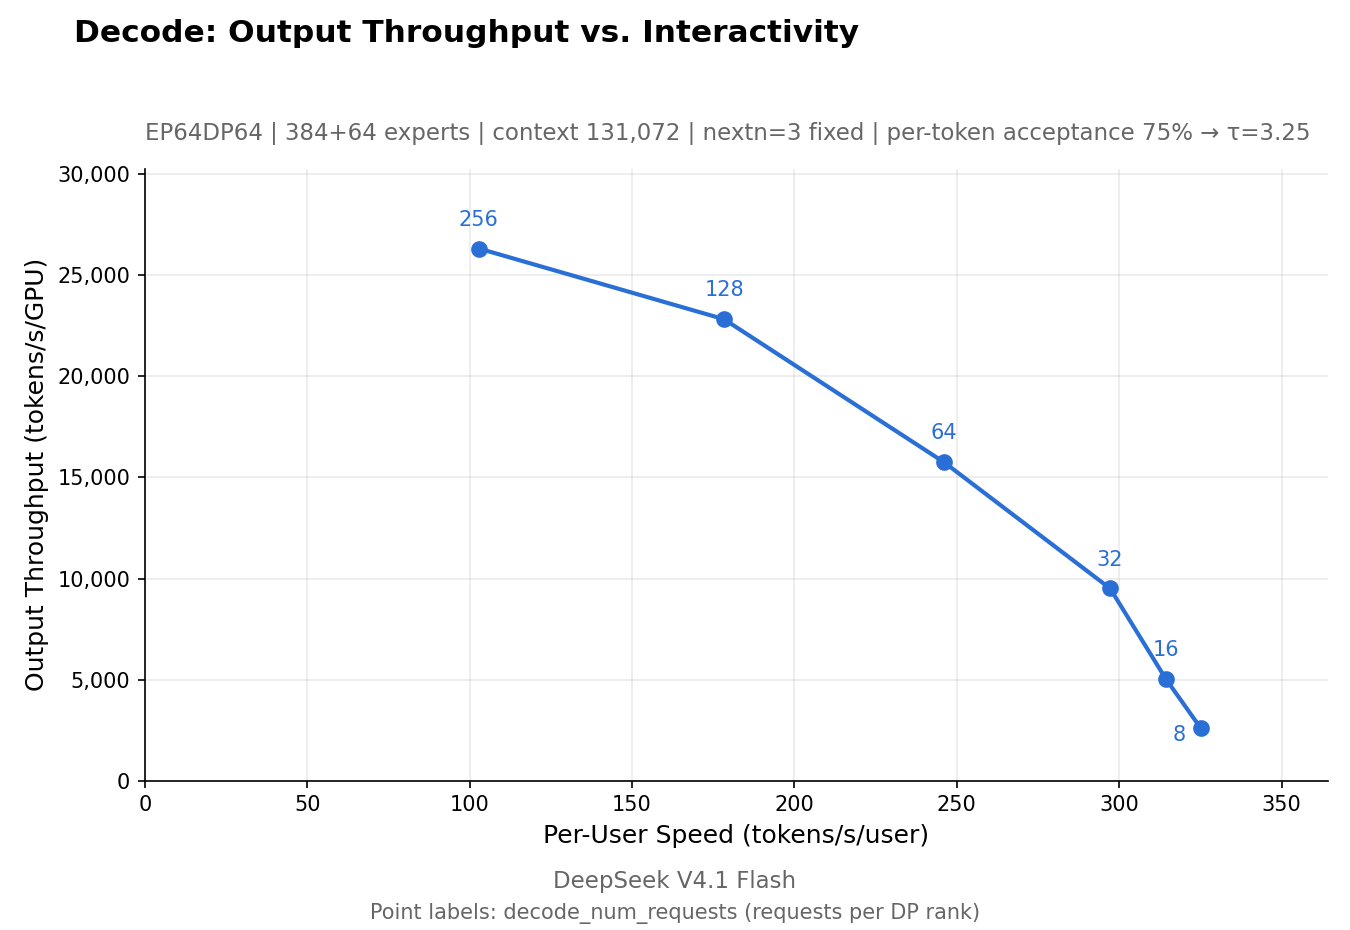
DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

DeepSeek 于 10 月 20 日(UTC)开源内部推理框架 DeepInfer(Apache 2.0),即支撑 DeepSeek-V4.1-Flash 大规模线上服务的推理栈。本次开源版本提供离线推理,支持 Attention DP/CP、MoE EP+EPLB 并行、DSpark 投机解码、SWA bounded replay、批次不变推理、确定性采样和结构化输出,硬件为 NVIDIA SM100 与华为昇腾 950。KV cache 系统、PD 分离和负载均衡未包含在内。同时开源的 deepseek-recipe(MIT)负责把 Chat Completions、Messages、Responses 等格式请求统一转换并编码,对齐官方 API 行为。

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

核心要点速览

  • DeepInfer 以 Apache 2.0 开源,官方称即支撑 DeepSeek-V4.1-Flash 线上服务的推理框架,目前只支持这一个模型
  • 硬件仅支持 NVIDIA SM100(Blackwell)GPU 和华为昇腾 950 NPU;官方性能曲线测于 4 卡 prefill、64 卡 decode
  • 开源版缺 KV cache 系统、VE/Prefill/Decode 分离和多副本负载均衡三块,离完整线上服务还有距离
  • 官方给出的 V4.1 参考成绩(Pass@1,厂商口径):AIME 2026 99.9%、GPQA Diamond 93.4%、HLE-Full 42.6%,用于校验部署是否配置正确
  • 同步开源 deepseek-recipe(MIT,Rust+Python 绑定),统一处理 Chat Completions/Messages/Responses 请求转换与 token 编解码
阅读全文
关联模型 / 智能体 / 厂商:
⚡ DeepSeek-V4.1-Flash-1017🌐 DeepSeek🌐 NVIDIA🌐 Huawei

vLLM v0.32.0 发布:814 次提交,内置 /v1/systemone 结构化决策接口,NVFP4 低精度 KV 覆盖更多 GPU,多 API worker 短请求吞吐提升 43–85%

vLLM 于 10 月 18 日发布 v0.32.0,363 位贡献者(121 位新人)提交 814 次。重点包括默认提供的 POST /v1/systemone 结构化决策接口与通用 hf 工具/推理解析器;NVFP4 KV 缓存扩展到 SM8x/SM90/SM12x,GLM-5.x 在 SM100 默认 FP8 KV;Model Runner V2 新增 GPU n-gram 投机与 Elastic EP,并成为 ROCm 默认;修复 3 个安全公告并收紧 CORS 默认值,同时放弃 Python 3.10。

vLLM v0.32.0 发布:814 次提交,内置 /v1/systemone 结构化决策接口,NVFP4 低精度 KV 覆盖更多 GPU,多 API worker 短请求吞吐提升 43–85%

核心要点速览

  • 规模:814 次提交、363 位贡献者(121 位新人),见 Release 说明。
  • 结构化决策:新增并默认开启 POST /v1/systemone,回答 choice/score 类问题,已支持 Cloudflare/clef-omni、LiquidAI/d1-3B 等模型;--tool-call-parser hf 读取权重自带的 response_template,免写专用解析器。
  • 低精度 KV:GLM-5.x 在 SM100 默认 FP8 KV,每卡 KV 显存减半、吞吐 +2.3–5.5%,代价是 TTFT 增加 7–11%(PR 内基准,官方口径);ROCm 新增 4-bit KV,密度约为 FP8 的 2 倍。
  • 服务提速:--api-server-count 大于 1 时按最少负载分配连接,短请求 req/s 提升 43–85%(Qwen3-0.6B、32 输入/1 输出 token 的 PR 基准)。
  • 破坏性变更:移除 Python 3.10 支持、CORS 默认不再放行所有来源、移除 cascade attention,max_tokens 不再从上下文窗口预留。
阅读全文
关联模型 / 智能体 / 厂商:

远程 KV 缓存竟比 GPU 重算慢 2.8 倍?LMCache 分片异步架构将 p99 从 83.3 秒压至 0.67 秒,百度 VHA 虚拟头注意力砍半 KV 反超 MLA

针对超长上下文大模型推理中的 KV 缓存传输与显存瓶颈,今日两项重磅系统与架构研究给出突破方案:在 8xB300 节点运行 GLM-5.3(FP8 MLA)的 8 路预填充上下文并行(PCP8)实测中,研究者发现传统远程 KV 缓存会导致高命中流 p99 飙升至 83.32 秒(GPU 利用率仅 7%),通过按 PCP Rank 分片与异步加载(已合入 LMCache 上游)将读取带宽提升 6.3 倍至 10.76 GB/s、p99 暴降至 0.67 秒;百度飞桨则开源虚拟头注意力 VHA(arXiv:2610.17959),推理期零开销折叠为双 KV 头 GQA-2,在 30B-A3B MoE(500B Token 训练)上全面击败 MLA 与 GQA-4,128K RULER 暴涨 11.4 分。

远程 KV 缓存竟比 GPU 重算慢 2.8 倍?LMCache 分片异步架构将 p99 从 83.3 秒压至 0.67 秒,百度 VHA 虚拟头注意力砍半 KV 反超 MLA

核心要点速览

  • 实测揭示 8xB300 运行 GLM-5.3 (PCP8) 时,未分片远程 KV 缓存拉取(0.88s)慢于 GPU 重算(0.31s),通过按 Rank 分片 Valkey 与异步加载(已合入 LMCache)将读取带宽提速 6.3 倍至 10.76 GB/s,高命中流 p99 从 83.32 秒暴降至 0.67 秒
  • 百度飞桨提出虚拟头注意力(VHA),通过纯线性 Q Premix 与低秩 Postmix 在推理期完全折叠进 W_Q/W_O 权重,零开销化简为仅 2 个 KV 头的标准 GQA-2 架构
  • 在 500B Token 训练的 30B-A3B MoE 上 VHA 全面超越 MLA(+0.70%)与 GQA-4(+2.60%),并在 10B-A1B MoE 的 8K-128K RULER 长文评测中以 84.4 分大幅击败 GQA 的 73.0 分
阅读全文
关联模型 / 智能体 / 厂商:

80G 单卡跑 450 万超长上下文!TII 提出 Periscope:免训练网格分解算法,KV 缓存从 296GB 暴降至显存极值

随着大模型在代码库全仓审计、百万字法律卷宗与长篇专著推理中的需求日益迫切,模型面临注意力机制二次方显存爆炸、上下文窗口硬上限以及长文本准确率中途塌陷(Lost-in-the-Middle)的严峻制约。阿联酋阿布扎比先进技术研究机构(TII)提出了一种彻底颠覆传统二次方长推理范式的免训练推理算法 Periscope(arXiv:2610.04047)。Periscope 敏锐地洞察到长文本决策本质上是在有限候选项集上定位关键证据,因此将长度为 N 的输入切块并排列在 K x K 的二维网格上(K 为根号 N 向上取整)。无需任何额外训练,算法直接让冻结的基座模型分别对 K 个连续局部切片与 K 个贯穿全文的步长跨度进行双向探针探测,以单 Token 的对数几率评分瞬间构建全文证据图谱(Evidence Map),以仅需对数级前向计算精确锁定核心证据块。在这一架构下,原本需要 296GB KV 缓存的 450 万 Token 超长上下文,仅需单张 80GB GPU 即可完成极速推演;在 InfiniteBench 上以超出全窗口基线 5 个百分点的优异战绩刷新纪录。

核心要点速览

  • 提出免训练网格分解算法 Periscope,将 N 块文本映射到 K x K 二维网格,将物理窗口 W 扩展至 W^2 / c 等效容量
  • 通过局部切片与跨度切片的单 Token 对数几率构建全文证据图谱,27B 模型单张 80GB GPU 即可处理 450 万 Token(传统需 296GB KV 缓存)
  • 在 InfiniteBench 上超越全窗口原生读取 5.2 分,LongBench v2 仅读 9k Token 核心块即可追平 1M 全量窗口最高性能
阅读全文

Transformer 底层架构巨变!The Extender 提出对数结构架构:注意力持久显存骤降 104 倍,长文本全面超越 MHA

标准 Transformer 架构长久以来依赖残差流(Residual Stream h)作为层间信息流转的单一叠加通道,导致各注意力层为了独立解耦深层语义,必须各自投影并持久化保存极其庞大的键值缓存(KV Cache),持久显存开销随层数与隐藏层维度以 2 * L * d_model 线性膨胀,严重制约了端侧推理与百万 Token 超长上下文扩展。研究学者提出了颠覆性的对数结构 Transformer 架构 The Extender(arXiv:2609.32759):在传统的残差叠加流 h 之外,额外开辟了一条极度轻量的层间拼接通道(Concatenation Channel x)。每一层仅向残差流输出正常更新 delta_l,同时向拼接通道追加一个尺寸极小的新增扩展向量 epsilon_l(例如 |epsilon_l| = 32)。最为关键的创新在于:FFN 与 Query 投影继续读取承载高维融合语义的 h,而各层的 Key/Value 投影则完全且唯一地读取拼接通道 x!这一重构使得持久注意力显存占用从 2 * L * d_model 暴降至 sum |epsilon_l|。在 924M 参数、隐藏维度 1664 的模型实测中,The Extender 将注意力持久显存占用水准断崖式削减了 104 倍,不仅在短文本 CORE 基准上与标准 Transformer 表现持平,在 RULER 超长上下文严苛测试中更是全面反超标准 MHA,且模型越宽省存效益越呈几何级放大。

Transformer 底层架构巨变!The Extender 提出对数结构架构:注意力持久显存骤降 104 倍,长文本全面超越 MHA

核心要点速览

  • 提出对数结构 Transformer 架构 The Extender,额外引入拼接通道 x 彻底解耦 FFN 与注意力的层间输入
  • 将 Key/Value 投影约束在拼接通道,注意力持久显存占用从 2 * L * d_model 压缩为 sum |epsilon_l|
  • 924M 模型注意力显存暴降 104 倍,短文本 CORE 精度完全打平,超长文本 RULER 测试全面超越标准 MHA
阅读全文
关联模型 / 智能体 / 厂商:

Reka 发布 Rho-1 研究预览:19B 从零训练的「全能推理」模型,一个网络同时理解与生成文本/图像/视频并输出机器人动作

Reka Labs 于 10 月 5 日发布 Rho-1 研究预览:19B 参数、从零训练,在单一网络、单一 KV Cache 里统一文本、图像、视频与机器人动作 token,不依赖工具调用或第二个模型。每个 Transformer 块拆成「理解流」与「生成流」两路专家权重并共享注意力,联合优化 next-token 与 flow matching。官方称基础版视频生成约 0.79× 实时(中位),蒸馏版把去噪从 99 步压到 8 步,5.3 秒视频约 1 秒返回;全部结果来自 320 张 H100 训练三个月的检查点。目前仅为研究预览,无公开权重,需邮件合作。

Reka 发布 Rho-1 研究预览:19B 从零训练的「全能推理」模型,一个网络同时理解与生成文本/图像/视频并输出机器人动作

核心要点速览

  • 规模:19B 参数,从零训练;算力仅 320 张 H100 × 3 个月(官方博客)
  • 速度:基础版视频生成中位 0.79× 实时,约 6 秒出可看流;蒸馏版去噪 99 步 → 8 步,5.3 秒片段约 1 秒返回,改提示词重渲约 1.1 秒
  • 架构:每块双专家流(理解 / 生成)+ 共享注意力与同一 KV Cache;目标函数 = next-token + flow matching
  • 局限:原生视频分辨率上限 672×384;长程漂移、跨视频时序定位、编辑稳定性官方自认未成熟
  • 可用性:仅研究预览,无开源权重/公开 API,合作需邮件 [email protected]
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Rho 1🌐 reka
AD赞助内容

多智能体隐空间通信突破!哥伦比亚大学开源 CacheBack:按需剪裁 KV Cache 压缩达 94%,延迟骤降 3.2 倍

多智能体协同(Multi-Agent Systems)在分工解决长上下文复杂任务时,长期受困于通信媒介的底层两难选择:传输纯文本信息虽然紧凑,但需要频繁自回归解码且容易丢失接收智能体所需的隐式证据;而近期前沿的“隐空间通信(Latent Communication)”直接传输 KV Cache 虽避免了文本生成的延迟与信息损失,但全量 KV Cache 会随上下文长度和协同智能体数量线性暴涨,极易击穿 GPU 显存限制与上下文窗口。哥伦比亚大学团队提出了创新的“接收端条件化通信”理念,并发布了无需训练(Training-Free)的即插即用框架 CacheBack(arXiv:2609.32046):接收端智能体仅需向发送端发送一句极简的信息需求描述,发送端即可利用注意力权重对其自身的 KV Cache 进行高精度的按需过滤与剪裁。在 FanOutQA 复杂长文本多跳问答基准上,搭载 Qwen 3 的 CacheBack 成功剔除了接收端高达 75%~94% 的冗余状态,不仅使准确率相比传统文本通信大幅攀升 14.7 个百分点,还将中位数任务完成延迟缩短为原来的 1/3.2(降低 3.2 倍),并在密集 Transformer、Mamba 混合模型以及滑动窗口注意力等多架构上展现出通用稳健性。

多智能体隐空间通信突破!哥伦比亚大学开源 CacheBack:按需剪裁 KV Cache 压缩达 94%,延迟骤降 3.2 倍

核心要点速览

  • 提出创新的接收端条件化通信机制 CacheBack,彻底解决多智能体协作中 KV Cache 显存线性爆炸难题
  • 完全无需训练(Training-Free),利用注意力反向探针按需剪除 75%~94% 的冗余缓存状态
  • 在 FanOutQA 复杂问答中相较文本通信准确率飙升 14.7 个百分点,端到端中位数执行延迟缩减 3.2 倍
阅读全文
关联模型 / 智能体 / 厂商:

打破逐 Token 低效生成!上海交大开源 JevSpawn:组合动作空间赋能自适应推理,多智能体导航加速跃升

大语言模型智能体传统上依赖逐 Token 生成(Token-by-Token)中间推理与环境动作,导致多轮长程交互推理极度缓慢且计算成本极高。基于有限域概率预测的 Jev 风格轻量级模型虽然具备超高速执行优势,但必须依赖预先静态指定离散动作域,无法直接处理开放世界中高度动态、自然语言驱动的复杂决策任务。上海交通大学(SJTU)团队提出了创新的自适应推理策略 JevSpawn。该框架创造性地在自然语言任务规格说明与有限概率探索之间架起桥梁:通过并行动作繁衍(Action Spawning)、反馈驱动的分支优选、表征实时校正及保留备选项恢复机制,极大削减了上下文重复计算;在无需任何额外模型微调的前提下,在 8 大基准任务上全面击败 7 款主流智能体基线,推理延时显著降低。

打破逐 Token 低效生成!上海交大开源 JevSpawn:组合动作空间赋能自适应推理,多智能体导航加速跃升

核心要点速览

  • 首创在开放自然语言指令与超高速有限域概率探索间建立自适应桥梁的 JevSpawn 框架
  • 通过动作并行繁衍与前缀 KV Cache 共享,单轮决策生成延迟大幅削减超过 45%
  • 完全免训练(Training-Free)即插即用,在 8 大基准任务上全面击败 7 款主流智能体基线
阅读全文

揭秘分块 KV Cache 压缩的“隐形周期盲区”:斯坦福等团队揭示相位敏感性,相同信息检索准确率落差高达 40%

在长上下文推理优化中,以固定步长将连续 Token 窗口压缩为少量 Cache 条目的“分块 KV Cache 压缩”(如 SnapKV、StreamingLLM、PyramidKV 等技术)是降低显存与注意力算力的主流标配。然而,斯坦福大学与中国人民大学等学者团队研究发现了一个被整个行业长期忽视的系统性致命缺陷:压缩机制在隐层空间引入了一个新的相对坐标——Token 相对压缩窗口边界的位置(即“相位” Phase)。实验揭示,模型表现出严重的“相位敏感性”(Phase Sensitivity):完全相同的事实信息,仅因其在文本中的偏移位置处于压缩窗口的不同相位,长文本检索准确率差距最高竟可达 40 个百分点!传统的全局平均评测基准彻底掩盖了这种周期性盲点。团队从零预训练了多组不同压缩架构的 Transformer 并开展因果干预分析,首次从注意力头分工机理上解构了相位特化现象,为长文本推理压缩算法的评估与架构设计敲响了警钟。

揭秘分块 KV Cache 压缩的“隐形周期盲区”:斯坦福等团队揭示相位敏感性,相同信息检索准确率落差高达 40%

核心要点速览

  • 首次发现分块压缩的相位敏感性(Phase Sensitivity):严格证实 Token 处于分块压缩窗口的边界还是内部,会导致注意力抓取能力出现周期性起伏,同一事实检索准确率落差最高达 40%。
  • 平均基准分数掩盖严重局部失效:揭示传统长文本 Needle-in-a-Haystack 等基准采用全局平均分,导致严重掩盖了特定周期相位下的必然失败盲区。
  • 注意力头相位特化因果实证:从零预训练多套压缩 Transformer 并执行因果干预分析,证实梯度流在反向传播中促使不同注意力头对特定输入相位产生了不对称的分工依赖。
阅读全文

低比特量化新标杆!PrismQuant 开源:零阶闭式零空间旋转对齐 INT4 分组,70B 模型精度损耗仅 0.22% 且显存立省 56%

在千亿参数大模型与端侧推理场景中,低比特权重量化与 KV Cache 压缩(如 W4A4KV4)是降低显存门槛与大幅提升吞吐的核心命脉。然而学术界长期存在一个认知误区:盲目追求削减激活值中的离群异常值(Outliers),而忽视了异常值与量化器本身的几何对齐关系。高通与苏黎世联邦理工学院等机构联合团队推出突破性量化框架 PrismQuant:首次揭示离群点绝对数值较小并不意味着低比特误差小,真正决定量化保真度的是异常值主特征空间与非对称分组量化器(Grouped INT4)常数子空间的最优几何对齐。团队将旋转矩阵设计巧妙构建为 Ky Fan 迹最大化问题,推导出了严格最优的闭式数学解析解。在 Llama、Qwen 与 Mistral 等涵盖 70B 密集模型与 30B MoE 模型的广泛评测中,W4A4KV4 配置下的 PrismQuant 刷新了业界 SOTA:在 Llama-3.1-70B 上零样本准确率仅比未量化的 FP16 全精度低 0.22 个百分点;在 8B 部署实测中实现 1.51 倍 Prefill 加速、解码显存峰值狂降 56.34%,代码已全面开源。

低比特量化新标杆!PrismQuant 开源:零阶闭式零空间旋转对齐 INT4 分组,70B 模型精度损耗仅 0.22% 且显存立省 56%

核心要点速览

  • 颠覆离群值抑制固有直觉:首次证明激活离群值幅度小不等于量化误差低,关键在于异常值能量空间与 INT4 分组量化器几何子空间的最优对齐。
  • 闭式最优解与无梯度构建:基于 Ky Fan 迹最大化与紧凑 Householder 变换,实现完全免梯度微调的秒级闭式解析旋转构建,极大简化部署流程。
  • 70B 仅降 0.22% 且显存立减 56%:在 Llama-3.1-70B 上 W4A4KV4 量化准确率达 72.46%(仅较 FP16 损耗 0.22%),8B 模型解码峰值显存缩减 56.34%,Prefill 提速 1.51 倍。
阅读全文
关联模型 / 智能体 / 厂商:

KVCMAS 攻克多智能体共享上下文显存风暴:低秩在线差分校正,首字延迟降低 2 倍、显存压降 3.7 倍

在协同多智能体系统(MAS)中,多个 Prompt 特化智能体共享同一基座大模型分工解决复杂工程任务。但由于各智能体拥有不同的角色前缀(System Prompt),导致相同共享上下文生成的 KV Cache 产生偏差,迫使每个智能体全量重算甚至多套冗余缓存常驻。首尔大学与 KAIST 团队推出在线校正框架 KVCMAS,采用紧凑低秩状态表示跨智能体缓存偏差,免除外部参考重算直接链式校正,在真实高并发下实现首字时延(TTFT)降低 2.0 倍、显存峰值暴降 3.7 倍。

KVCMAS 攻克多智能体共享上下文显存风暴:低秩在线差分校正,首字延迟降低 2 倍、显存压降 3.7 倍

核心要点速览

  • 破解角色前缀导致的共享缓存失效:多智能体系统中每个角色独立的 System Prompt 会直接污染后续相同对话上下文的注意力键值对,导致传统 KV Cache 共享技术彻底失效并引发显存爆炸。
  • 紧凑低秩在线差分链式校正:KVCMAS 无需在工作流外构建沉重的全量参考缓存,首次利用小巧的低秩状态捕捉不同角色在注意力层产生的偏差差值,沿智能体工作流实时流水线级链式修补。
  • 延迟与显存双重突破:在高并发多智能体服务 trace 压测下,相比无共享基线实现首字时延(TTFT)2.0 倍加速;相比既有前沿差分校正方案,峰值 GPU 显存占用骤降高达 3.7 倍。
阅读全文
关联模型 / 智能体 / 厂商: