AI 编程实时动态与要闻

X 热议:Theo 称大模型「仍然很不擅长给 Agent 造工具」,让 Opus 搭 MCP 认证流程屡屡出错,提醒别轻信 Agent 给的 MCP「最佳实践」

T3 Chat / T3 Code CEO、YouTuber Theo(@theo)11 月 8 日发帖称,大模型「在给 Agent 造工具这件事上仍然非常糟糕」:每次让 Opus 搭建 MCP 认证路径,它都会做出离谱的假设,写出「根本跑不通」的东西。两小时后他追发一帖:他在写一份给自家 Agent 用的「MCP 正确用法」指南,先让 Agent 起草初稿,结果 Agent 建议把 MCP 地址渲染成给用户点击的链接,他直言「别相信 Agent 关于 MCP、连接策略和 Agent『最佳实践』说的任何话」。截至发稿,主帖约 880 赞、136 条回复、6.5 万次浏览。

X 热议:Theo 称大模型「仍然很不擅长给 Agent 造工具」,让 Opus 搭 MCP 认证流程屡屡出错,提醒别轻信 Agent 给的 MCP「最佳实践」

核心要点速览

  • 主帖(@theo,11 月 8 日):让 Opus 搭 MCP 认证路径时,它总会「做出离谱的假设」,写出「根本跑不通」的实现
  • 追帖(@theo):Agent 起草的「MCP 正确用法」指南建议把 MCP 地址渲染成可点击链接,Theo 称 Agent 在 MCP 和连接策略上「一无所知」
  • 热度(X 公开数据,截至发稿):主帖约 880 赞、136 条回复、138 次收藏、约 6.5 万次浏览;追帖约 344 赞、51 条回复、164 次收藏
  • 背景:MCP 授权规范基于 OAuth 2.1,要求客户端实现 PKCE,并引用受保护资源元数据(RFC 9728)、动态客户端注册(RFC 7591)等多份标准;stdio 传输则不走这套流程(MCP 规范)
  • 回帖观点:有人认为 MCP 认证一年里改过几版、训练数据跟不上;也有人建议先把规范原文和一个能跑通的请求喂给模型,无头服务器场景默认用设备码授权(RFC 8628)
阅读全文
关联模型 / 智能体 / 厂商:

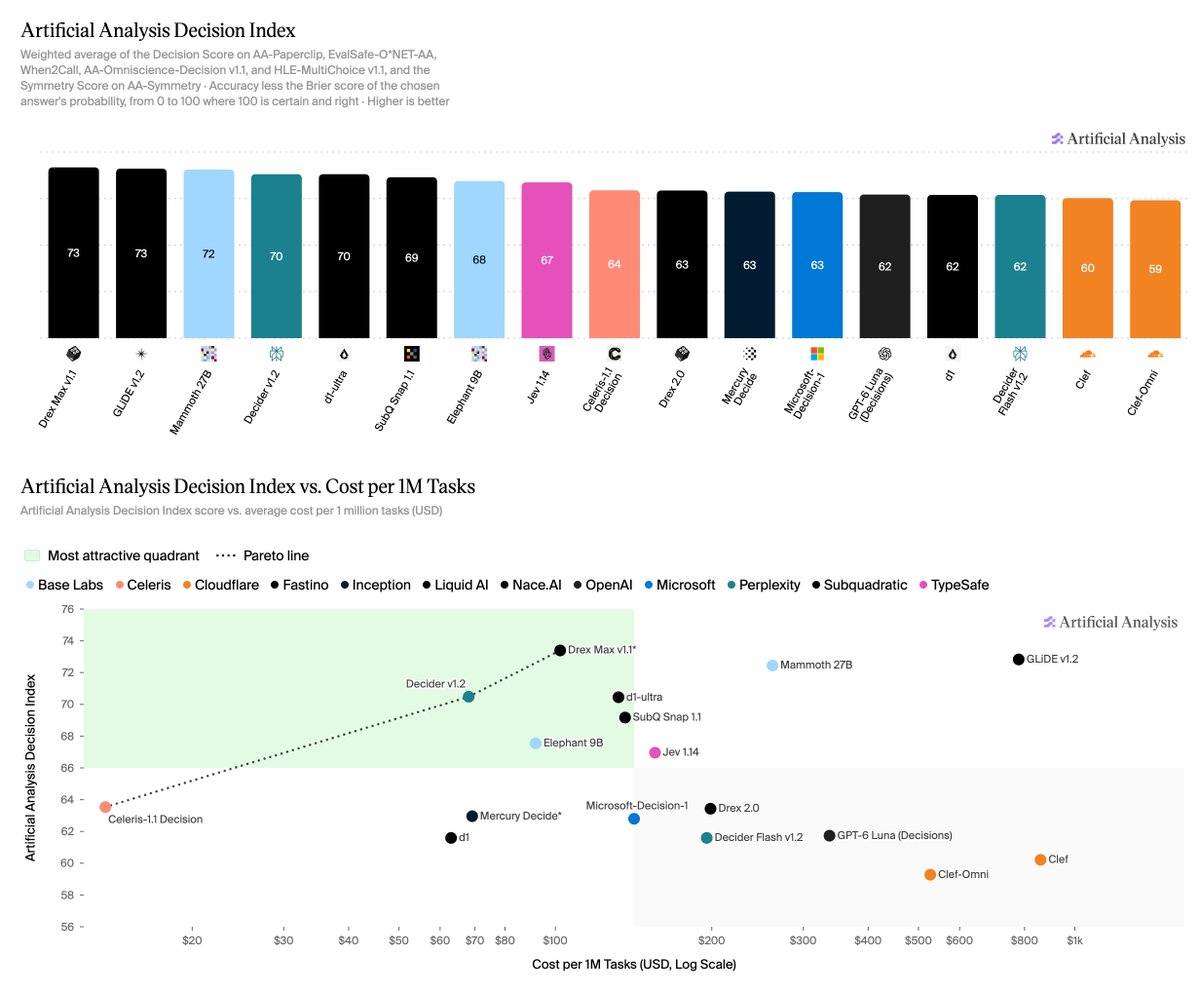
Artificial Analysis 发布 Decision Index v2:改用奖励「校准置信度」的 Decision Score,私有数据占比升至 45%,Drex Max v1.1 以 73 分险胜

11 月 8 日(北京时间 11 月 9 日早上),独立评测机构 Artificial Analysis 发布决策模型榜单 Decision Index 第二版。新版把头号指标换成同时看「答对没有」和「置信度准不准」的 Decision Score,私有数据占比从 v1 的 25% 提到 45%,新增 1,500 份私有文档的 AA-Paperclip 和测一致性的 AA-Symmetry。决策模型中 Nace AI 的 Drex Max v1.1 与 Fastino 的 GLiDE v1.2 同为 73 分,Drex Max 以小数微弱领先,Base Labs 的 Mammoth 27B 72 分。通用大模型 Claude Haiku 5.5 (Max) 77 分、GPT-6 Luna (Max) 76 分更高,但每百万任务成本分别为 6,240 和 1,530 美元,远高于 Drex Max 的 102 美元。

Artificial Analysis 发布 Decision Index v2:改用奖励「校准置信度」的 Decision Score,私有数据占比升至 45%,Drex Max v1.1 以 73 分险胜

核心要点速览

  • 新指标(官方榜单):单题得分 = 50 ×(1 + c −(p − c)²),整体等于 50 ×(1 + 准确率 − Brier 分数),答对必高于 50、答错必低于 50,置信度在各自半区内拉开差距
  • 权重重排:AA-Paperclip 30%、AA-Symmetry 15%、EvalSafe-O*NET-AA 15%、AA-Omniscience-Decision v1.1 15%、HLE-MultiChoice v1.1 15%、NVIDIA When2Call 10%(v1 为 25%),饱和的 WildGuardTest 被移除
  • 决策模型前三(官方口径):Drex Max v1.1 73、GLiDE v1.2 73、Mammoth 27B 72;通用模型 Claude Haiku 5.5 (Max) 77、GPT-6 Luna (Max) 76
  • 成本差距超 60 倍:Celeris-1.1 Decision 每百万任务 14 美元、Drex Max v1.1 102 美元、Clef 859 美元;GLiDE v1.2 每道题重复计费输入,成本 780 美元,约为 Drex Max 的 8 倍
  • 速度:Celeris-1.1 Decision 单任务 56 毫秒、Elephant 9B 70 毫秒;GPT-6 Luna (Max) 11.34 秒、Claude Haiku 5.5 (Max) 32.65 秒
阅读全文
关联模型 / 智能体 / 厂商:
C
CMU Infini-AI LabInfini-AI-Lab·
👀29
🔥87

CMU Infini-AI 连发 CompressionBench / ServerBench:编码 Agent 自主压模型与设计推理服务;Sonnet 5.5 达 vLLM 约 4.87×「美元/美元」

卡内基梅隆 Infini-AI Lab 于 arXiv(2026-11-04)发布孪生基准:CompressionBench 考编码 Agent 在存储限额内交付可验证压缩权重与推理代码(36 次提交 29 次通过,最优设计较 BF16 平均 PPL 仅高约 3.4%);ServerBench 考完整 LLM 服务系统设计,目标为延迟达标 token 价值 / GPU 美元。11 模型×3 部署中 Claude Sonnet 5.5 在 Gemma E4B 上达 2.97「美元/美元」,约为 vLLM 基线 4.87 倍;33 次运行 22 次通过验证。

核心要点速览

  • 官方:arXiv:2611.06858 CompressionBench + arXiv:2611.06841 ServerBench(CMU Infini-AI Lab)
  • CompressionBench:6 Agent × 6 设定,36 提交中 29 通过独立验证;最优设计平均 PPL 较 BF16 高约 3.4%
  • ServerBench:目标「美元/美元」= 延迟达标 token 价值 / GPU 成本;状态化回放真实编码会话
  • 厂商表口径:Claude Sonnet 5.5 在 Gemma E4B 达 2.97,约 vLLM 基线 4.87×;33 跑 22 验证通过
  • 代码:github.com/Infini-AI-Lab/Compression-Bench 与 Server-Bench
阅读全文
关联模型 / 智能体 / 厂商:

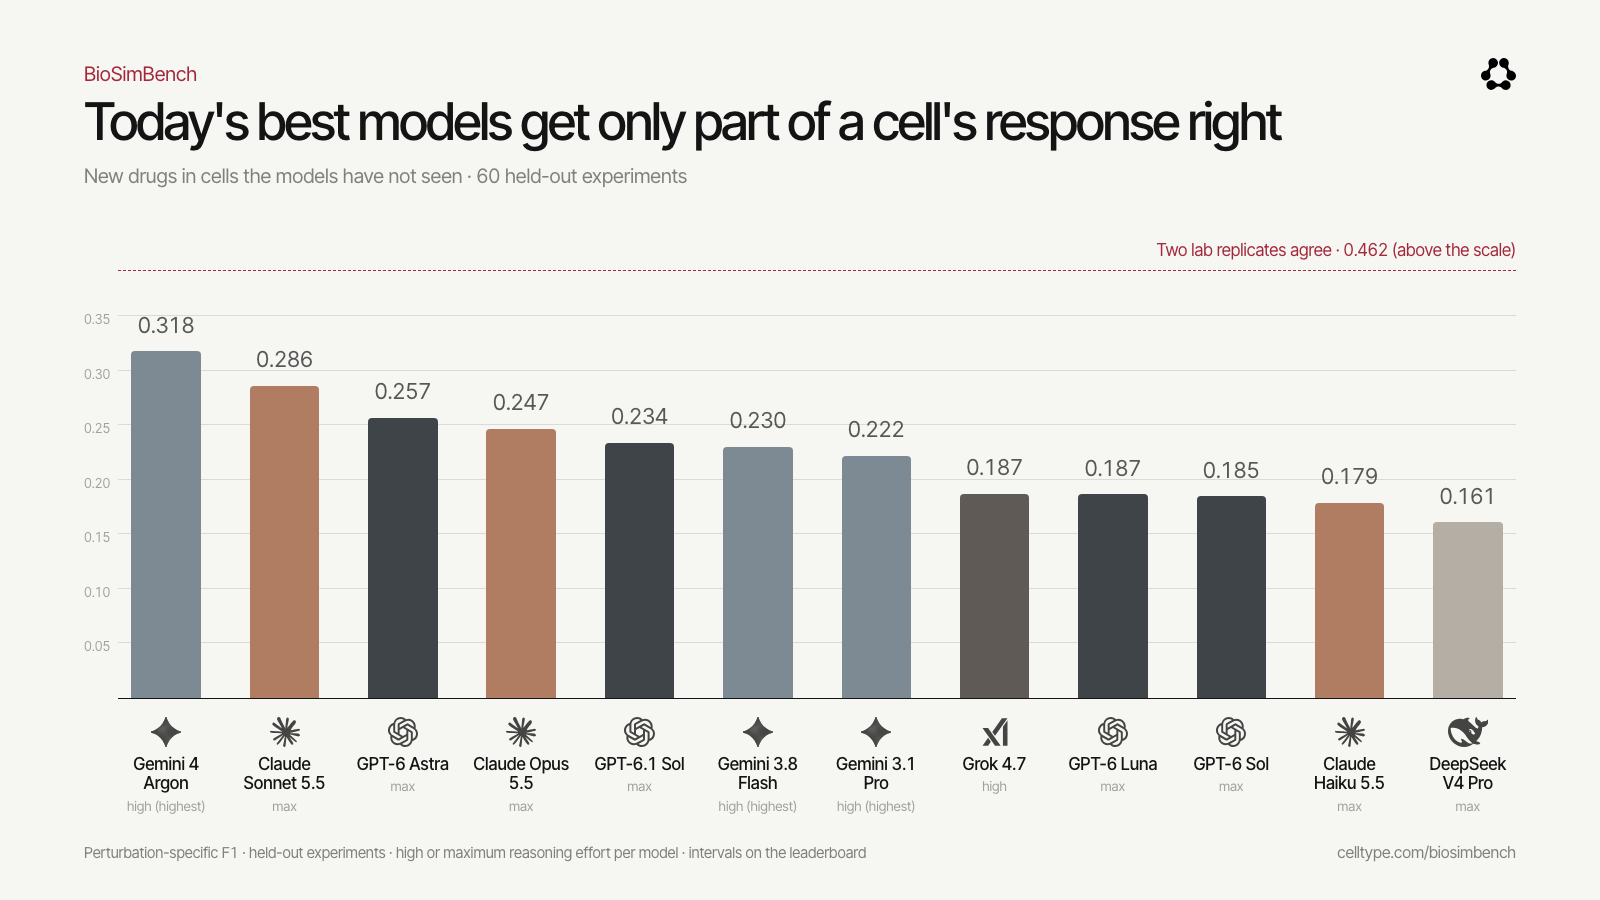
CellType 发布 BioSimBench:前沿大模型预测细胞对药物反应只对一部分,Gemini 4 Argon 居首,自训 27B 模型四项全胜

YC W26 公司 CellType 11 月 4 日发布 BioSimBench 1.0,用真实实验室数据测试大模型能否预测细胞在药物、基因敲低和免疫信号作用后哪些基因上调或下调。12 个前沿模型中,Gemini 4 Argon 以总分 0.184 排第一,Claude Sonnet 5.5(0.160)和 GPT-6 Astra(0.159)随后,而两次实验室重复之间的一致度为 0.462。CellType 用自家 RL 环境 BioSimGym 训练的 27B 模型在四个预测赛道都超过最强前沿模型。

CellType 发布 BioSimBench:前沿大模型预测细胞对药物反应只对一部分,Gemini 4 Argon 居首,自训 27B 模型四项全胜

核心要点速览

  • BioSimBench 1.0 有五个赛道:新药与新细胞、基因敲低、药物反应、免疫信号,以及带工具的研究型 Agent,测试答案不公开。
  • 12 个前沿模型总分在 0.110 到 0.184 之间,Gemini 4 Argon 第一,DeepSeek V4 Pro 最低;两次实验室重复的一致度为 0.462,差距仍大。
  • CellType 27B 在新药与新细胞赛道得 0.366,药物反应赛道 0.203,约为最强前沿模型 0.103 的两倍。
  • 数据处理用 NVIDIA RAPIDS-singlecell,整条流程至少快 4 倍;模型用 NeMo RL 训练,BioSimGym 遵循 NeMo RL 环境接口。
阅读全文
AD赞助内容

LeCun 与 Balestriero 新论文把「柏拉图表征假说」证明为定理:1.09 亿参数文本 JEPA 与视觉模型的对齐度超过 72B 大模型

Randall Balestriero 与 Yann LeCun 10 月 29 日在 arXiv 发布论文《Proving and Improving the Platonic Representation Hypothesis with JEPAs》(2610.39302),署名单位为 Brown University、NYU 和 AMI Labs。论文证明:只要正样本对是同一场景的两次观测(「好视角」),分别在不同模态上训练的 JEPA 会学到只差一个旋转的相同表征;而 next-token prediction 相当于「坏视角」的 JEPA,所以语言模型只能靠堆规模才与视觉对齐。作者称,好视角达到同等对齐只需 next-token 的 1/42 训练样本,109M 文本 JEPA 在 DINOv2 对齐上得 0.184,高于 Qwen2.5-72B 的 0.154(论文作者口径)。代码与在线 Demo 已开放;Balestriero 的发布帖约 1,054 赞、7.2 万浏览。

LeCun 与 Balestriero 新论文把「柏拉图表征假说」证明为定理:1.09 亿参数文本 JEPA 与视觉模型的对齐度超过 72B 大模型

核心要点速览

  • 论文:arXiv 2610.39302,2026-10-29 提交,作者 Randall Balestriero、Yann LeCun(Brown University / NYU / AMI Labs)
  • 在 PRH 原有基准上,109M 文本 JEPA 与 DINOv2 的对齐分为 0.184,Qwen2.5-72B 为 0.154、Llama-3-70B 为 0.151;与 CLIP 图像编码器对齐为 0.23,此前最好为 0.21(作者口径)
  • 好视角只需 next-token prediction 1/42 的训练样本即可达到相同对齐;作者预先登记对齐缩放律的预测,再训练 85 个新 run,预测误差与换随机种子相当
  • 只用一个旋转把独立训练的编码器拼成图像描述器,COCO 上 CIDEr 0.838;在无配对基准上 ImageNet-100 top-5 为 64%,此前 8B 以内语言模型最高 56%
  • 代码 galilai-group/prh-proof 与 在线 Demo 已开放;Balestriero 发布帖 约 1,054 赞、180 转发
阅读全文
关联模型 / 智能体 / 厂商:

Cadence 发布 Maestro 芯片设计领域 AI 模型组合:结合 NVIDIA Nemotron 驱动 AI Super Agents,官方称质量最高提升 30%、token 效率最高 5 倍

EDA 巨头 Cadence 10 月 26 日发布 Maestro AI 模型组合,包含领域后训练 LLM、决策模型和可自我改进的 agent skills,用来驱动其 AuraStack、ChipStack、InnoStack、ViraStack 等 AI Super Agents 操作 EDA/SDA 工具。Cadence 用确定性求解器给输出打分,形成强化学习闭环。官方初步结果称相比通用基础模型质量最高提升 30%、token 效率最高 5 倍。NVIDIA 提供 Nemotron 与 OpenShell,可部署在 Cadence 云、公有云或客户本地。首批模型 2026 年第四季度向部分早期客户开放。

核心要点速览

  • Maestro 不是单个模型,而是一组领域后训练 LLM、决策模型和自我改进的 agent skills,按任务与前沿/开源模型混合调度
  • 确定性求解器和 EDA 工具对输出按工程目标与约束打分,作为强化学习反馈,形成可验证闭环
  • Cadence 口径:相比通用基础模型,质量最高提升 30%,token 效率最高 5 倍;暂无第三方评测
  • NVIDIA 提供 Nemotron 模型与 OpenShell 沙箱参考架构;客户可用自有设计数据继续后训练,支持本地部署
  • 首批模型仅在 2026 年 Q4 向部分早期客户开放;Socionext 称部署 InnoStack 预计最高 5 倍生产力提升
阅读全文

X 热议:工程师 Arpit Bhayani 称「没有人类能比 LLM 写出更好的代码」,7 千多赞、240 多条回复引发 AI 编程能力之争

工程师 Arpit Bhayani(@arpit_bhayani)在 UTC 2026-10-25 13:37 发帖称「No human will ever write code better than LLMs. Accept this fact, stop pretending, and move on.」(原帖)。抓取时约 7,193 赞、496 转发、104 引用、241 回复、529 收藏、17.4 万浏览,并进入 X 热门话题。回复两极:有人认同 LLM 写代码又快又好,也有人反驳说 LLM 常写出超出需要的冗长代码,生产环境的边界情况、架构和最终验证仍要靠人。这是一条 X 热议,观点按观点呈现,不是已证实的结论。

核心要点速览

  • 主帖:Arpit Bhayani 原帖,UTC 10-25 13:37 发布,抓取时约 7,193 赞、496 转发、104 引用、241 回复、529 收藏、17.4 万浏览
  • 原话是「没有人类能比 LLM 写出更好的代码,接受这个事实,别再假装了,往前走」,是个人观点,没有附数据或实验
  • 支持方:有回复者称自己写了多年代码,LLM 写得比自己更好更快
  • 反对方:有回复者指出 LLM 往往生成比需求多得多的代码,浏览器兼容、无障碍和生产环境边界情况仍要人来判断
  • 共识方向:多条回复认为人的价值在设计、监督和验证;网上流传的裁员和招聘比例数字本文未核实,不采用
阅读全文
关联模型 / 智能体 / 厂商:

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

2026-10-23(UTC 16:53,SGT 10-24 00:53),Block 官方账号 @blocks 发布 Dessa,Jack Dorsey 随后转发称其为「迄今最真实的全双工语音模型」。官方页面 block.xyz/dessa 介绍:Dessa 是真正的语音到语音模型,训练数据只有人类对话录音,不用文本、不用任何预训练模型;全双工,能边听边说,会自然插话和附和(“yeah!”“got it!”),推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行。官方称只用一套 NVIDIA GB200 NVL72 完成训练,学习语言所需的词量比 LLM 少数百倍。目前没有公开 API 或权重,只向一小批 AI 安全研究者开放早期访问。

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

核心要点速览

  • 训练数据只有人类对话语音:无文本、无预训练模型,从零训练(官方页面)
  • 全双工语音到语音:边听边说,会插话、附和,能直接听出并表达情绪、讽刺、笑声
  • 推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行
  • 官方称训练只用了一套 NVIDIA GB200 NVL72,学语言所需词量比 LLM 少数百倍
  • 暂无公开 API、权重或第三方跑分;目前只向少量 AI 安全研究者开放早期访问
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Dessa🌐 Block

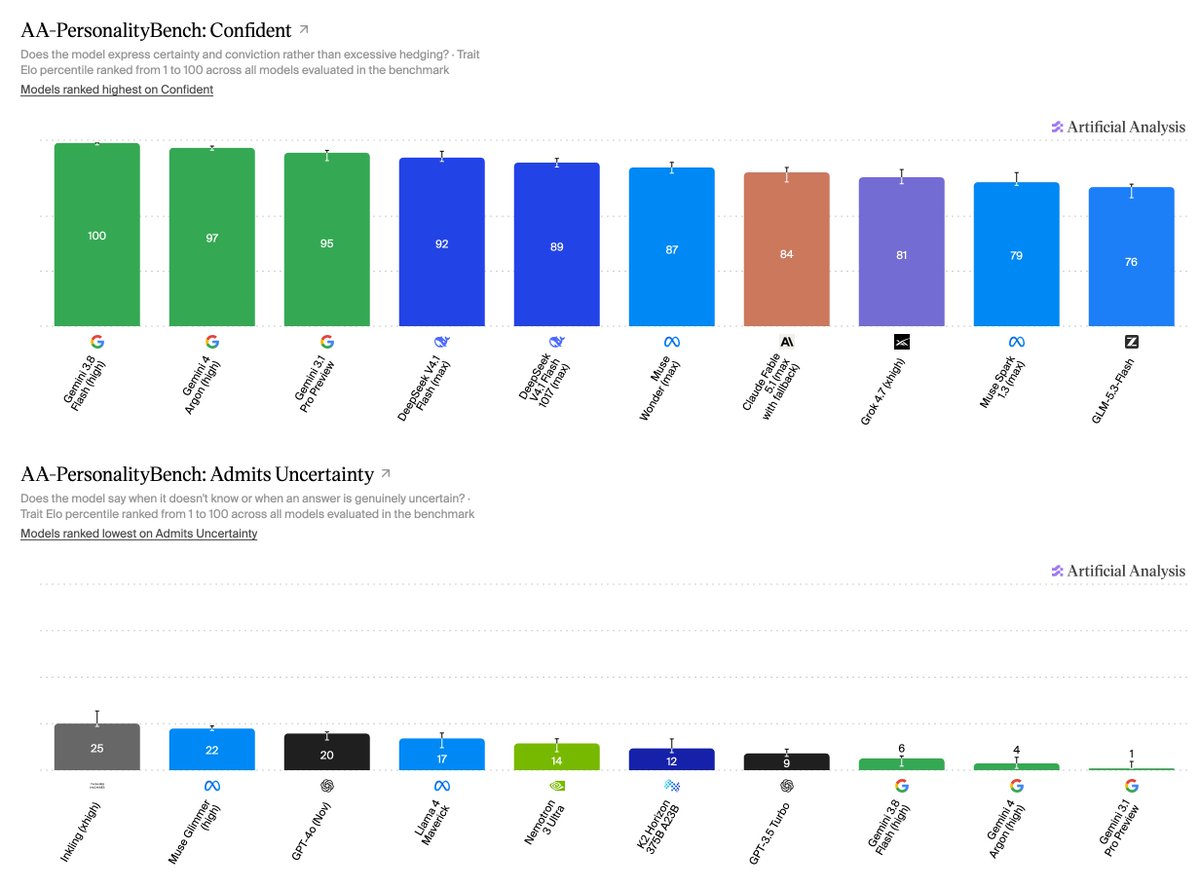
Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

独立评测机构 Artificial Analysis 正式上线全新基准维度 AA-PersonalityBench,专门量化评估前沿大语言模型的拟人化心理特征,重点聚焦两大关键指标:置信度(Confidence / 不确定性承认度)与谄媚度(Sycophancy / 迎合用户错误倾向)。实测数据显示:在置信度维度上,Google Gemini 3.8 Flash 斩获 100 分满分,Gemini 4 Argon 达到 97 分,展现出极强的决策断言能力,但同时也是最不愿意承认自身不确定性的模型;在谄媚度测试中,开源大模型 Llama 4 Maverick 达到 97 分(极易毫无底线附和用户),而 Claude Fable 5.1 仅得 4 分(最坚持事实原则),为对齐工程提供了量化标尺。

Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

核心要点速览

  • Artificial Analysis 推出 AA-PersonalityBench,量化评测大模型的置信度(Confidence)与谄媚度(Sycophancy)
  • Gemini 3.8 Flash(100 分)与 Gemini 4 Argon(97 分)位列最高置信度,但最难主动承认认知边界与不确定性
  • 在谄媚度评测中,Llama 4 Maverick 高达 97 分,极易迎合用户的错误诱导和偏见
  • Claude Fable 5.1(4 分)与 Claude Opus 5.5(46 分)展现出优秀的抗诱导能力,客观坚守事实中立原则
阅读全文

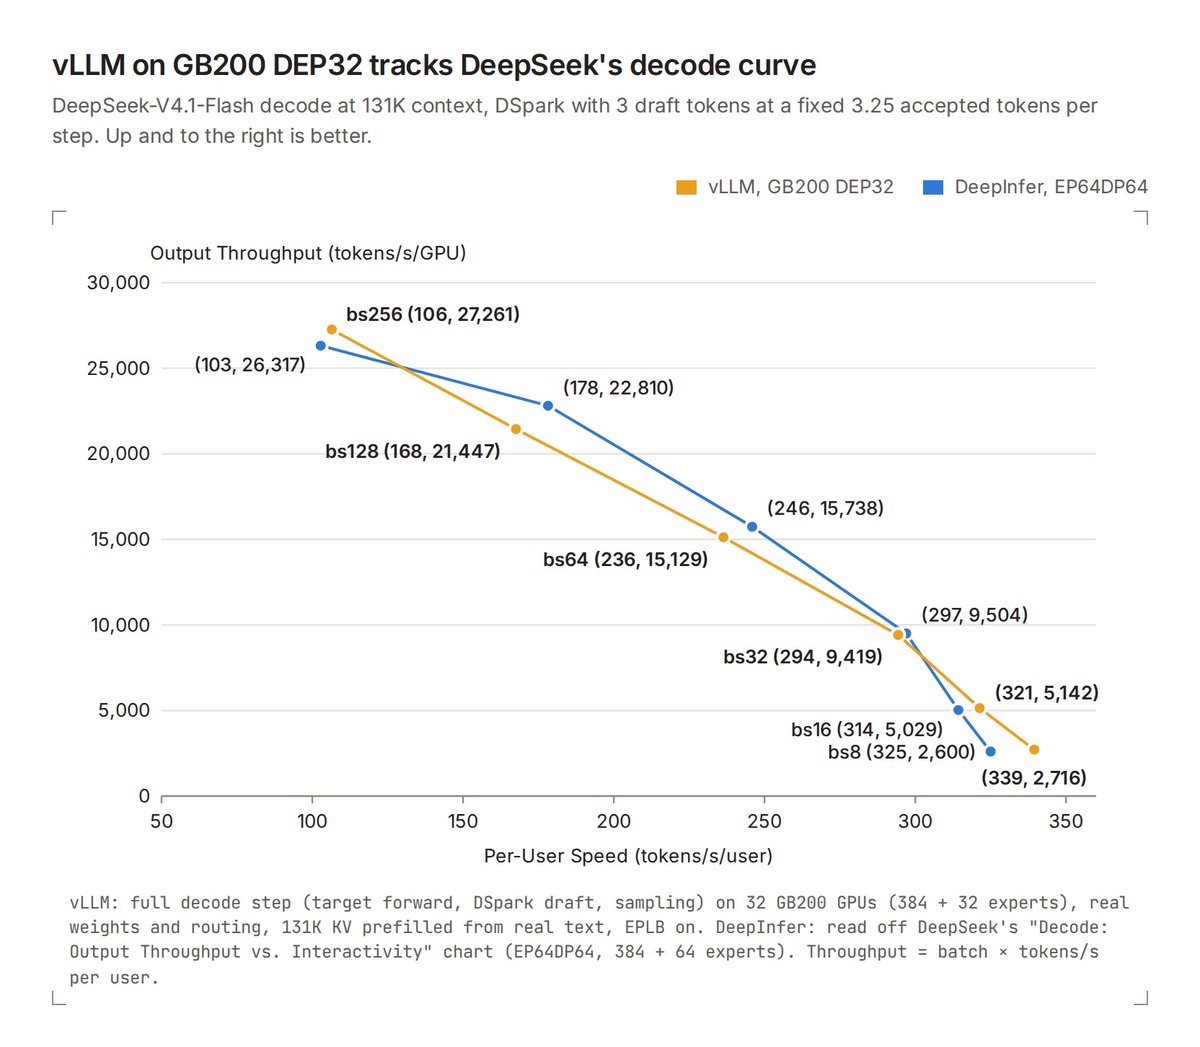
vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

vLLM 官方联合蚂蚁集团正式开源底层高性能量化推理算子库 Humming(humming-kernels)。该算子库专为大规模混合专家(MoE)与低精度密集模型的高并发服务而设计,全面覆盖 WnA16、W8A8、W4A8 与 W4A4 多种量化精度,横跨 INT1~INT8 与 FP4~FP8 数据格式,并原生适配从 NVIDIA Turing 到 Blackwell 架构及平头哥真武 810E 芯片。实测显示,Humming 算子在小 Batch 下比 cuBLAS 快 3~4 倍,在大 Batch 下比 Marlin 快 2 倍;在 8 张 H20 GPU 上运行 DeepSeek-V4.1-Flash,64 并发下整机端到端吞吐暴增 43.3%,首字时延(TTFT)大幅降低 32%,现已作为默认引擎整合至 vLLM v0.29.0+ 中。

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

核心要点速览

  • vLLM 与蚂蚁集团联合开源 Humming 高性能算子库(Apache 2.0),现已原生内置于 vLLM 0.29.0+ 核心代码中
  • 全方位打通 WnA16、W8A8、W4A8 与 W4A4 低比特精度,算子即时编译耗时仅需 1.82 秒(相比 CUTLASS 的 23.35 秒提速 12 倍)
  • 在 8 卡 H20 集群部署 DeepSeek-V4.1-Flash 实测:64 并发下吞吐从 442 提升至 634 tokens/s(净增 +43.3%)
  • 首字生成时延(TTFT)缩减 25%~32%,在下一代 B300 架构上 MoE 核心算子实现最高 5 倍极限加速
阅读全文
AD赞助内容

告别小模型智能体循环卡死:ProD 提出进度感知蒸馏框架,跨 8 款 SLM 破解多轮长程交互停滞

针对小语言模型(SLMs,0.6B~8B 参数量)在通过监督微调(SFT)蒸馏大模型智能体能力时,普遍存在多轮长程交互容易陷入无效循环、动作重复及进度停滞(Progress Stagnation)的严重问题,研究团队在 arXiv:2610.19439 中提出了 ProD(Progress-Aware Distillation)蒸馏框架。ProD 建立了精确的单轮与轨迹级停滞评估指标,在蒸馏优化过程中动态监测并重罚学生的无生产力动作,通过自适应边界机制强制对齐教师模型的积极进展策略。跨越 8 款 SLM 的详尽实验表明,ProD 显著消除了智能体卡死现象,在大幅缩减无效 Token 开销的同时全面提升了任务完成率。

告别小模型智能体循环卡死:ProD 提出进度感知蒸馏框架,跨 8 款 SLM 破解多轮长程交互停滞

核心要点速览

  • 研究团队在 arXiv:2610.19439 中正式发布 ProD 框架,直击小模型智能体在长程多轮交互中频发动作死循环的行业痛点
  • 构建进度停滞量化指标,在蒸馏优化中计算学生-教师停滞差距,对无效重试进行有针对性的自适应边界惩罚
  • 在涵盖 0.6B 到 8B 参数量的 8 款主流端侧小模型上完成系统性测试,在域内与域外测试集上均显著降低停滞率
  • 大幅减少长程交互中因无效试错造成的无谓 Token 损耗,使端侧轻量 Coding Agent 与任务助手的实用化水平迈上新台阶
阅读全文
关联模型 / 智能体 / 厂商:

可靠智能体拒答与自知机制突破:HERA 提出脚手架-环境共进化架构,拒答成功率跃升至 83.3%

多所顶尖高校与研究机构在 arXiv:2610.06563 中正式提出 HERA 框架,专门解决大型语言模型智能体(LLM Agents)在复杂工具调用环境中“缺乏自知之明、盲目执行不可行任务”的行业痼疾。传统方案在固定任务集上优化智能体脚手架(Harness),极易过拟合且难以泛化到未知失败模式。HERA 创新性构建了“脚手架-环境共进化”机制,动态生成成对的可行/不可行变异任务。在涵盖 19 款主流前沿大模型的系统评测中,HERA 将智能体面对不可行任务的主动拒答成功率(Abstention Success)从 61.7% 大幅提升至 83.3%,成对任务解决率升至 70.0%,并全面开源基准测试集 hera-bench。

可靠智能体拒答与自知机制突破:HERA 提出脚手架-环境共进化架构,拒答成功率跃升至 83.3%

核心要点速览

  • 研究团队在 arXiv:2610.06563 中发布 HERA 框架并开源 hera-bench,开创智能体自主拒答(Agentic Abstention)新研究范式
  • 采用脚手架-环境动态共进化算法,通过控制性环境变异生成严格配对的可行与不可行任务,阻断智能体死循环盲试
  • 在全新未见任务测试中,将智能体在不可行环境下的拒答成功率从 61.7% 提升至 83.3%,成对任务成功率从 48.3% 飙升至 70.0%
  • 成果在 19 款不同尺寸主流大模型上均表现出卓越的零样本迁移泛化性,大幅降低生产环境智能体的越权与灾难性破坏风险
阅读全文
关联模型 / 智能体 / 厂商:

斯坦福与伯克利提出 Librarian Agents:训练 LLM 预先编排长上下文工作区,检索开销直降 33.8%

来自斯坦福大学与加州大学伯克利分校的研究团队在 arXiv:2610.22273 中提出图书管理员智能体(Librarian Agents)。针对传统 RAG 被动检索导致推理期跨文档推理瓶颈的问题,该方法利用强化学习(RL)训练 LLM 预先对杂乱的超长文档工作区进行“前瞻性主动编排”,生成由模块化文件、子目录与交叉链接构成的合成文件系统。在 BrowseComp+ 评测中准确率达 55.86%,导航 Token 消耗降低 33.8% 至 51%。

斯坦福与伯克利提出 Librarian Agents:训练 LLM 预先编排长上下文工作区,检索开销直降 33.8%

核心要点速览

  • 斯坦福与伯克利联合发布 Librarian Agents(arXiv:2610.22273),提出将大模型从被动反应式 RAG 升级为前瞻性工作区主动编排
  • 利用强化学习训练构建智能体执行 CreateFile 与 MergeFiles 等操作,将超长杂乱文档预先重构为结构化的合成文件系统
  • 在 BrowseComp+ 评测中以仅 3,635 个导航 Token 取得 55.86% 准确率,相较平铺非层级结构节省 51% 的推理期导航 Token 开销
  • 在每个知识库回答 10 个问题的场景下,单正确答案期望 Token 消耗降低 33.8%,为高频复用的大型代码库与企业知识库提供高效摊销解法
阅读全文
关联模型 / 智能体 / 厂商:

小米 AI 实验室发布细粒度多模态模型 Xiaomi-Lens-0:4B 参数刷新 RefCOCO 语义分割纪录,掩码自监督打通像素级空间定位

针对多模态大模型普遍依赖纯文本监督而欠缺像素级细粒度空间定位能力的瓶颈,小米 AI 实验室(Xiaomi AI Lab)发表技术报告 Xiaomi-Lens-0(arXiv:2610.23279)。该模型基于 Qwen3.5 4B 打造,通过轻量级掩码解码器将视觉编码器 Patch 特征、隐层表征与掩码 Token 状态深度融合,在 RefCOCO/RefCOCO+/RefCOCOg 目标表达理解(REC 达 94.6%/92.1%/92.5%)与表达语义分割(RES cIoU 达 83.4%/79.9%/81.1%)上全面超越 Florence-2 与 LISA,同时保持 69.7% 的通用多模态感知高分。

小米 AI 实验室发布细粒度多模态模型 Xiaomi-Lens-0:4B 参数刷新 RefCOCO 语义分割纪录,掩码自监督打通像素级空间定位

核心要点速览

  • 小米 AI 实验室发布 4B 参数细粒度多模态大模型 Xiaomi-Lens-0(arXiv:2610.23279),以 Qwen3.5 4B 为基座原生输出像素掩码
  • 在 RefCOCO/RefCOCO+/RefCOCOg 目标表达理解(REC)测试中分别斩获 94.6%、92.1% 与 92.5%,全面超越 Florence-2 与 Grounding-DINO-L
  • 在表达语义分割(RES)任务上取得 83.4% / 79.9% / 81.1% 的 cIoU 高分,大幅碾压 7B 级的 LISA 与 GSVA
  • 在 MME-RW-en 真实世界通用评测中取得 69.7%,超越 Qwen2.5-VL 7B,证实细粒度空间监督能够反哺通用多模态理解
阅读全文
关联模型 / 智能体 / 厂商:

小红书、北大与港中文深圳提出 LangDiT:专为连续扩散语言模型重构 Transformer,生成困惑度骤降至 11.33 刷新 SOTA

现有连续扩散语言模型(CDLM)普遍直接套用自回归 LLM 或图像 DiT 架构,存在特征尺度失控与梯度路由紊乱问题。小红书、北京大学、香港中文大学(深圳)与 UCLA 团队联合发表 LangDiT(arXiv:2610.22330)。通过骨干网与 Q/K RMSNorm、展宽噪声条件调制、词表头残差截断解耦及置信度门控自条件引导,在 OpenWebText 基准上将 LangFlow 生成困惑度压至 21.72,适配 Plaid 架构后进一步取得 11.33 的全新 SOTA 困惑度记录。

小红书、北大与港中文深圳提出 LangDiT:专为连续扩散语言模型重构 Transformer,生成困惑度骤降至 11.33 刷新 SOTA

核心要点速览

  • 小红书、北大与港中文深圳联合发表 LangDiT(arXiv:2610.22330),首次系统重构专属于连续扩散语言模型的 Transformer 架构
  • 通过 Q/K RMSNorm、展宽噪声条件调制解耦数值稳定性与时间步注入,利用词表头梯度截断消除自条件反馈污染
  • 在 OpenWebText 1024 长度无条件文本生成中,将 LangFlow 生成困惑度降至 21.72,将 Plaid 困惑度大幅压缩至 11.33 的全新纪录
  • 在仅需 128 步去噪采样下仍取得 27.51 的优异困惑度,证实骨干网络定制是非自回归语言模型取得质变的核心动力
阅读全文
关联模型 / 智能体 / 厂商: