

YC W26 公司 CellType 11 月 4 日发布 BioSimBench 1.0,用真实实验室数据测试大模型能否预测细胞在药物、基因敲低和免疫信号作用后哪些基因上调或下调。12 个前沿模型中,Gemini 4 Argon 以总分 0.184 排第一,Claude Sonnet 5.5(0.160)和 GPT-6 Astra(0.159)随后,而两次实验室重复之间的一致度为 0.462。CellType 用自家 RL 环境 BioSimGym 训练的 27B 模型在四个预测赛道都超过最强前沿模型。
核心要点速览
- ✓BioSimBench 1.0 有五个赛道:新药与新细胞、基因敲低、药物反应、免疫信号,以及带工具的研究型 Agent,测试答案不公开。
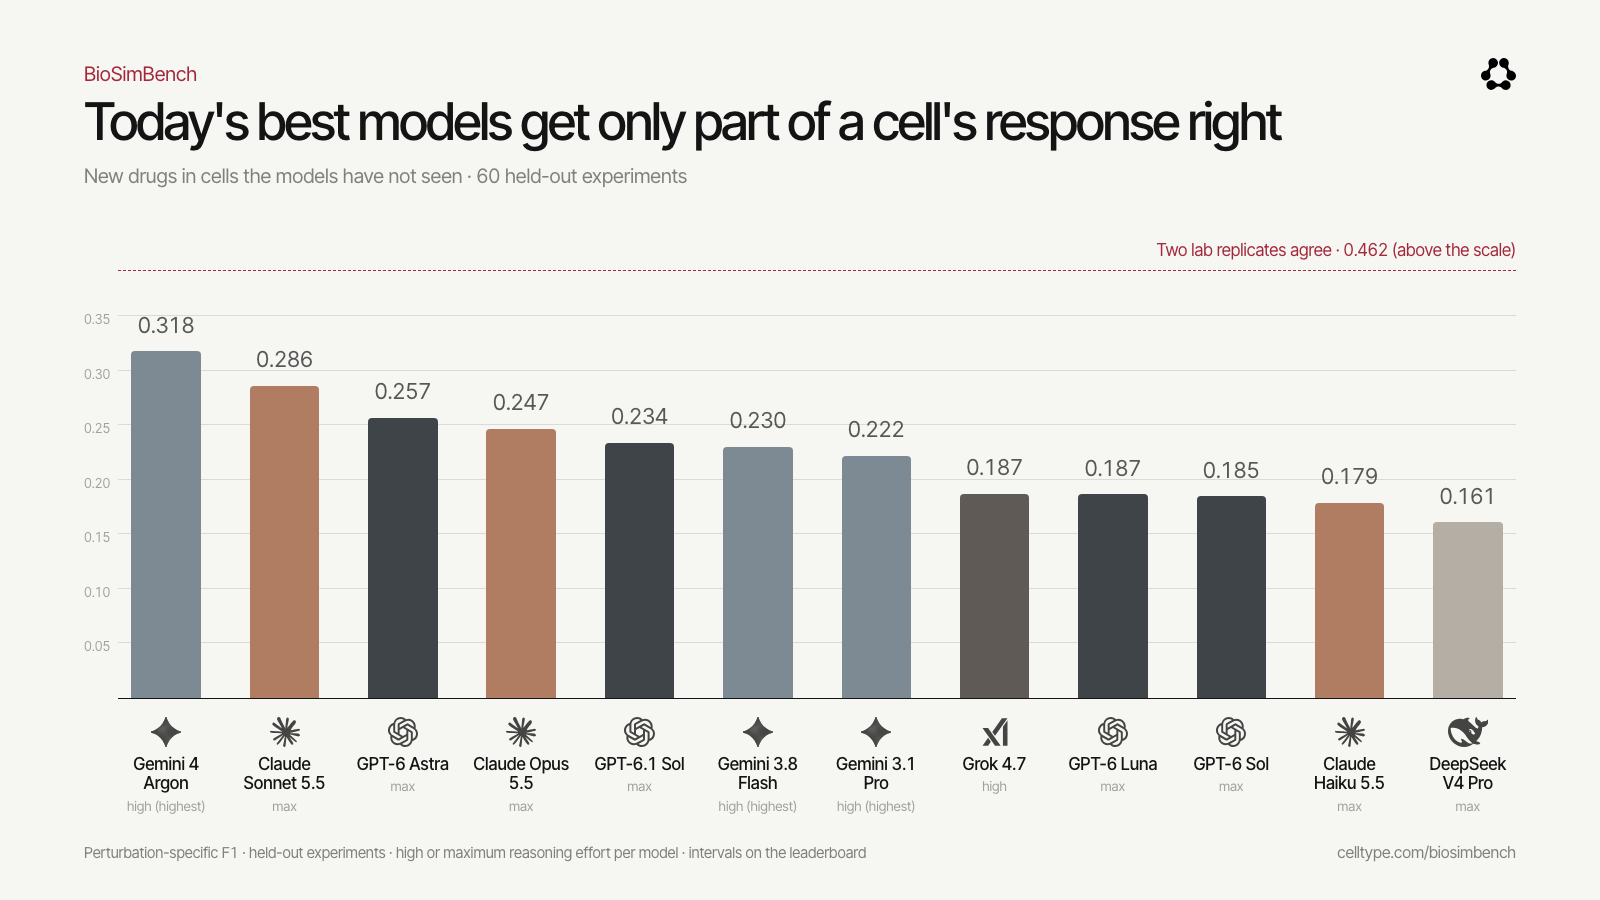
- ✓12 个前沿模型总分在 0.110 到 0.184 之间,Gemini 4 Argon 第一,DeepSeek V4 Pro 最低;两次实验室重复的一致度为 0.462,差距仍大。
- ✓CellType 27B 在新药与新细胞赛道得 0.366,药物反应赛道 0.203,约为最强前沿模型 0.103 的两倍。
- ✓数据处理用 NVIDIA RAPIDS-singlecell,整条流程至少快 4 倍;模型用 NeMo RL 训练,BioSimGym 遵循 NeMo RL 环境接口。
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
药物、基因和细胞环境的组合远多于实验室能做完的实验。大模型写生物学文章很流畅,但能不能准确说出某个细胞被处理后哪些基因上调、哪些下调,一直缺少用真实实验数据打分的公开测试。CellType 由 Cell2Sentence 的耶鲁团队创立,11 月 4 日发布 BioSimBench 1.0 来回答这个问题。
架构亮点与底层机制
模型拿到细胞的基线表达和一种干预(药物、CRISPRi 敲低或免疫信号),列出上调和下调的基因,再与实验测量对比,指标是去掉普遍响应基因后的 F1。五个赛道分别留出新药、新细胞系、新敲低基因或新供体,测试答案只保留在 CellType 的评分服务器上。BioSimGym 是对应的 RL 训练环境。
权威 Benchmark 与实测跑分对比
官方榜单总分:Gemini 4 Argon 0.184、Claude Sonnet 5.5 0.160、GPT-6 Astra 0.159,Gemini 3.1 Pro、GPT-6.1 Sol、Gemini 3.8 Flash 并列 0.153,Claude Opus 5.5 0.145,DeepSeek V4 Pro 0.110。实验室重复一致度为 0.462。CellType 27B(9 次回答投票)在四个预测赛道分别得 0.366、0.216、0.203、0.267,均高于最强前沿模型;这些是 CellType 自己的评测结果。
开发者实战落地与开箱指南
BioSimBench 公开,研究者可以在官网提交模型参与评测,或申请在 BioSimGym 中训练。做 AI for Science 的团队可以把它当作检验模型生物推理是否落到实验结果上的参考;BioSimGym 环境本身是 CellType 向药企授权的商业产品。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察