AI 编程实时动态与要闻

METR 评估:Anthropic 在可验证任务上的能力进展约达历史速率 2 倍,AECI 自 2025 年 10 月起约 1.9× 加速

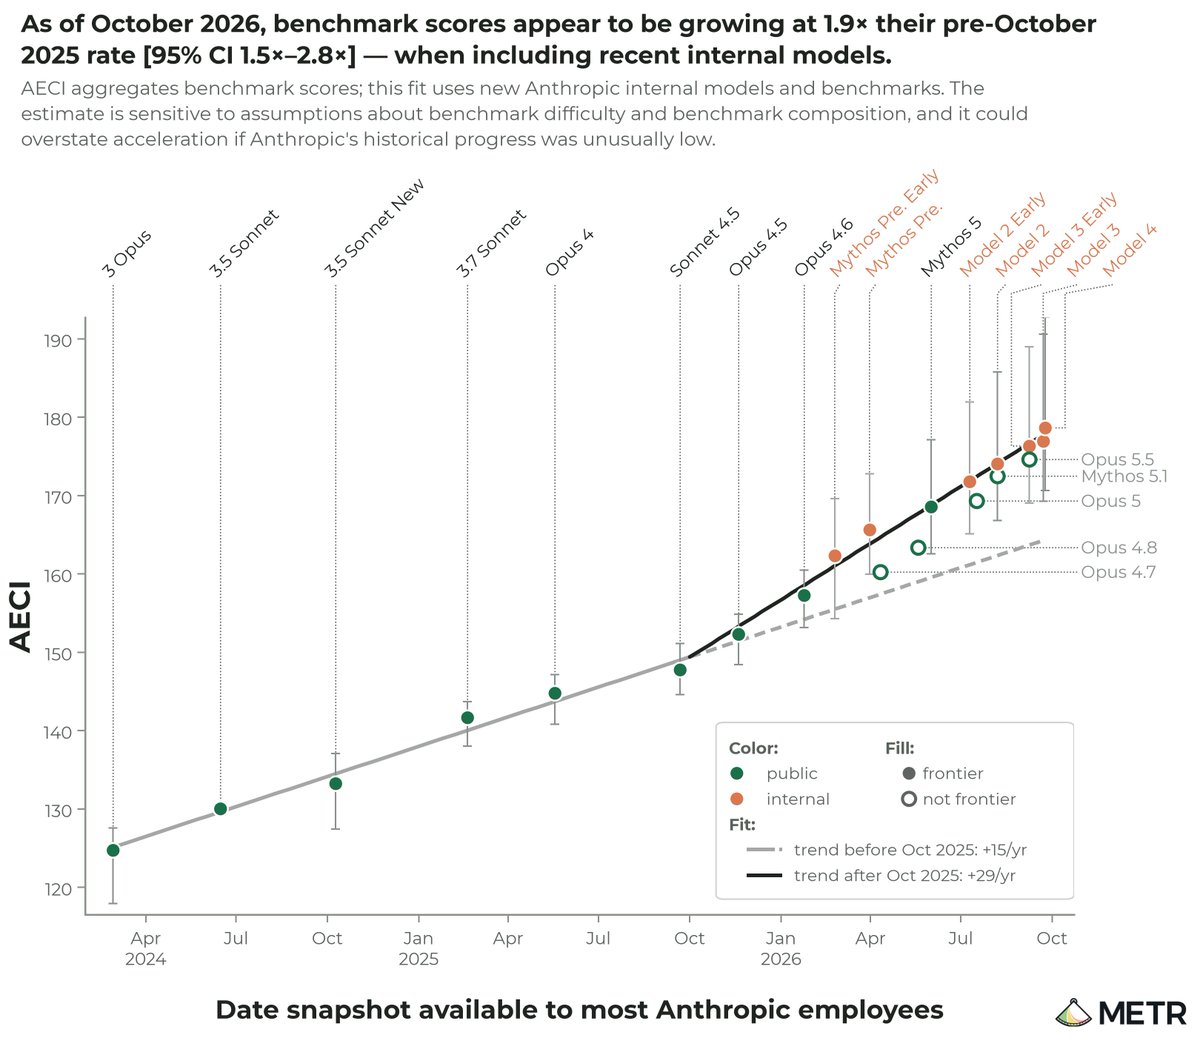
独立评估机构 METR 于 11 月 5 日发布对 Anthropic 的高权限评估报告(2026 年 8 月 12 日–10 月 29 日):截至 2026 年 10 月,Anthropic 在可验证任务上的模型能力进展很可能约为 2024 年 3 月至 2025 年 10 月历史速率的两倍;自 2025 年 10 月起 AECI 增长约 1.9×(95% CI 1.5–2.8)。多数当前加速归因于 AI 辅助研发,非训练算力增速;Anthropic 对多处关键证据做了脱敏。
METR 评估:Anthropic 在可验证任务上的能力进展约达历史速率 2 倍,AECI 自 2025 年 10 月起约 1.9× 加速

核心要点速览

  • 主观结论:可验证任务能力进展约 2× 历史速率(不确定性高,真实值可能约 1.3×–3×;METR 口径)
  • AECI:自 2025-10 起增长约 1.9× [95% CI 1.5–2.8],约等于一年内完成两年历史进度(含内部未发布模型)
  • 归因:置信排除「训练算力增速」;当前多数加速归因于 AI 辅助研发(约 80% 主观猜测),非完全自主贡献
  • 风险:未见未来 12 个月明确瓶颈,存在进一步加速风险;关键证据大量被 Anthropic 脱敏
  • 过程:与 10 月 15 日「类员工访问」评估不同;算力分配核验部分被 Anthropic 中途取消
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis 改用「单任务耗时」作为头号性能指标:GPT-6 Astra 满档约 17 分钟完成一题,快于 Opus 5.5 与 Gemini 4 Carbon

独立评测机构 Artificial Analysis 于 11 月 4 日(UTC 17:34)在 X 上宣布新版 API 性能基准:头号指标从输出速度改为 Time per Task,即完成一道 Intelligence Index 任务所需时间(每题输出 tokens ÷ 端到端输出速度)。新版覆盖约 1,000 个 serverless 端点,速度改为从发出请求算到最后一个 token,并加入多轮 Agent 编码与知识工作负载。官方数据:GPT-6 Astra 满档 51 tokens/s 但约 17 分钟完成一题,Claude Opus 5.5(max)约 26 分钟,Gemini 4 Carbon(high)约 29 分钟。

核心要点速览

  • Time per Task = 每道 Intelligence Index 任务的输出 tokens ÷ 端到端输出速度;逐 token 很快但话多的模型,可能比慢但省 token 的模型更晚完成任务。
  • 端到端输出速度从发出请求算到收到最后一个 token,包含首 token 前的等待(prefill 与隐藏推理);输出 token 改用各家 API 自报数量,不再用 o200k_base 分词器估算。
  • GPT-6 Astra(max)51 tokens/s,每题约 5 万输出 tokens、约 17 分钟;Claude Opus 5.5(max,111 tokens/s)约 26 分钟,Gemini 4 Carbon(high,71 tokens/s)约 29 分钟,后两者每题约 12–17 万 tokens。
  • 按各家 API 默认档(三者均为 medium),GPT-6 Astra、GPT-6.1 Sol、Opus 5.5 的单任务耗时降约 3–5 倍、成本降约 2–4 倍,Intelligence Index 低约 5–11 分;Opus 5.5 从约 26 分钟/10.04 美元降到约 6.8 分钟/2.45 美元。
  • 官方方法论页显示这是 3.0.0 版(10 月 30 日),测试频率改为每 6 小时一次,并新增端点错误率指标。
阅读全文

Axiom 用 AI 智能体集群把整部 Stacks Project 形式化为 Lean:约 1600 万行,称史上最大的可复用形式化数学库

Axiom 于 11 月 4 日(X 官方账号 UTC 17:13 发帖,帖子浏览超 200 万)发布整部 Stacks Project 的 Lean 形式化。这部约 7500 页的代数几何开源参考书由 Johan de Jong 于 2005 年发起,形式化后约 1600 万行代码,官方称是迄今最大的一体化、可复用形式化数学库。工作由分层协调的 AI 智能体集群完成,过程中发现了原文数十处需要局部修正的命题,并给出反例。成果开源,可在 stacks.axiommath.ai 对照原文浏览。

Axiom 用 AI 智能体集群把整部 Stacks Project 形式化为 Lean:约 1600 万行,称史上最大的可复用形式化数学库

核心要点速览

  • 规模:约 7500 页原文、约 1600 万行 Lean 代码,官方称是最大的一体化可复用形式化数学库(厂商自述)。
  • 方法:分层 AI 智能体集群并行翻译命题、在 Mathlib 中查找已有抽象、构造证明,并用多智能体审计和与原文的语义交叉检查保证命题忠实。
  • 发现:系统找出原文数十处需修正的命题,包括缺失假设、正特征下的边界情况,并为错误处构造了显式反例。
  • 保留 Stacks 永久标签结构,每个 Lean 声明都能对应回原文;stacks.axiommath.ai 提供对照阅读和依赖图。
  • 这是 Axiom 继 10 月 27 日发布有限单群分类(CFSG)形式化之后的又一大型发布;按 de Jong 的要求,修正内容不直接提交到上游仓库。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Flask 作者 Armin Ronacher 称 Opus 5.5 智能体两周内可无人工重写整个 CPython,评论区争论「价值到底在不在测试集」

Flask 作者 Armin Ronacher(@mitsuhiko)11 月 1 日发帖称,他确信现在用一个 Opus 5.5 智能体,只对着测试集、无人工介入,大约两周就能重写整个 CPython,甚至做到 ABI 兼容、去掉 GIL、带 JIT 并在各项指标上更快。帖子约 1,637 赞、9.8 万浏览、162 条回复。随后他补充:重写不一定需要现成测试集,让智能体先自建测试更适合移植。antirez 表示赞同,Mario Zechner 和 Meta 工程师 Kevin Newton 则提出反对。这是个人判断,并无实际重写结果。

核心要点速览

  • 原帖:@mitsuhiko 11 月 1 日,11:52 UTC 发布,约 1,637 赞、269 收藏、162 条回复、9.8 万浏览(抓取时)
  • 他的原话要点:只给测试集、无人工输入,约两周重写 CPython,「可能」做到含 ABI 的完全兼容、无 GIL、带 JIT,并称「完全疯狂」;这是预测,没有给出实验
  • 后续帖(14:07 UTC,约 212 赞):不必依赖现成测试集,很多旧测试不适合「爬坡」优化;他说几周前让智能体重写 Excel 公式引擎时,测试集是它从零自建的
  • antirez(Redis 作者)赞同先让智能体建一套庞大的测试再开始移植;Mario Zechner 反对,认为问题在信任,现成的测试和一致性套件才让他放心
  • Meta 工程师 Kevin Newton 批评:成功的 Python JIT 极少,难在复杂度和兼容性,认为「无需人工就能做出好 JIT」是错误的;也有人指出 PEP 703 下无 GIL 构建本就与标准 ABI 不兼容
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

赛门铁克发现灰色中转服务:装上正版 Codex 和 Claude Code CLI,再改配置关闭沙箱、把全部请求转到第三方服务器

赛门铁克 Threat Hunter 团队 10 月 29 日披露:一个未授权 AI 中转服务自 2026 年初起在约十几家机构出现,以中国大陆为主。用户先用 npm 装正版 Codex 或 Claude Code,再运行中转商给的一行脚本,脚本改写 ~/.codex/config.toml 或 ~/.claude/settings.json,把 base_url 指向中转域名、换成中转 key,并把沙箱设为 danger-full-access、关闭遥测。官方强调这不是 CLI 漏洞,目前也没发现运营方滥用权限。

赛门铁克发现灰色中转服务:装上正版 Codex 和 Claude Code CLI,再改配置关闭沙箱、把全部请求转到第三方服务器

核心要点速览

  • 受影响的约十几家机构以中国大陆为主,也包括韩国、台湾、马来西亚企业的在华或本土子公司,涉及半导体、电子制造、制药、航运、石化等行业
  • 脚本通过 iwr | iex 或 curl | bash 从仿冒域名(如 vibe.aiok[.]me)拉取,先装正版 CLI 再改配置,看起来像正常安装步骤
  • Codex 沙箱被设为 danger-full-access 并开启网络访问,同时设置 DISABLE_TELEMETRY=1、DISABLE_ERROR_REPORTING=1
  • 中转发的 Claude Code key 前缀为 sk-ant-oat01-(订阅 OAuth token 格式),赛门铁克认为这与拼车转售订阅额度相符,但不能证明
  • 官方称这不是 Codex 或 Claude Code 的漏洞,目前没有证据显示运营方滥用了权限,风险属于潜在风险
阅读全文

FrontierCS 2 基准发布:让 Agent 在论文原仓库里重写被删掉的核心贡献并打败作者代码,Claude Opus 5.5 通过率 58% 居首,16 题无人通过

UC Berkeley、Princeton 等团队发布 FrontierCS 2(arXiv 2610.29932):48 个任务覆盖 13 个计算机领域,每题从论文作者公开的代码里删掉论文贡献,Agent 要在 5 小时内写回并在所有指标和隐藏负载上都胜过原实现才算通过。12 个 Agent 中 Claude Opus 5.5(Claude Code)通过率 58% 第一,其余都低于一半,16 个任务没有任何运行通过。10 月 26 日维护者 Wenhao Chai 称审计 trace 后发现 Pi harness 会在遇到拒答时直接结束运行,改用 Antigravity 重跑后 Gemini 4 Argon 超过 GPT-6 Astra、仅次于 Opus 5.5。

核心要点速览

  • 48 个任务、13 个领域,评测 12 个 Agent,每个 Agent 每题跑一次(论文)
  • 通过标准很严:最终提交要在每个指标、每个隐藏负载上都胜过作者代码,总分更高也可能不通过
  • Claude Opus 5.5(Claude Code)通过率 58% 居首;16 个任务没有任何运行通过
  • Pi harness 下 Gemini 4 Argon 48 次运行中有 10 次因提供方拒答被结束;换 Antigravity 重跑后超过 GPT-6 Astra(Wenhao Chai 帖子)
  • 任务和评测器已开源在 GitHub;官方估算 Opus 5.5 跑完 48 题约需 1,000 美元 API 费、300 美元 GPU、100 美元 CPU
阅读全文

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

权威独立 AI 基准测试机构 Artificial Analysis 正式发布针对 Cognition 旗下最新编程智能体 Devin Fusion 的全面实测报告。Devin Fusion 采用了革命性的“异构双模型并行协同架构”:由旗舰级的 Claude Opus 5.5(Max)担任总架构师与核心决策大脑,配合轻量极速的 GPT-6 Luna(High)作为并行子智能体执行具体检索与代码试跑。在 Coding Agent Index 综合大考中,Devin Fusion 斩获 68.1 分的高分,位居全球最顶级智能体梯队;而在经济性方面,单任务综合调用成本从 Claude Code Opus 单模型的 13.04 美元骤降至 9.01 美元(成本节省达 31%),单任务平均耗时由 65 分钟缩短至 55 分钟。

Artificial Analysis 实测 Devin Fusion 双模型异构智能体:综合得分为 68.1,任务成本立降 31%

核心要点速览

  • Artificial Analysis 发布 Devin Fusion 权威评测(Status #2112773422698606736),以 68.1 分稳居全球 Coding Agent 前三甲
  • 首创异构双模型协同:由 Claude Opus 5.5 主导架构规划,配合 GPT-6 Luna 承担轻量高并发子任务与终端执行
  • 单任务端到端开销从纯 Opus 5.5 的 13.04 美元骤降至 9.01 美元,实现 31% 的显著降本与 15% 的执行提速
  • 在 DeepSWE v1.1 软件工程实测中达成 72.6% 解决率(远超 Opus 5.5 单模的 68.4%),在 SWE-Atlas-QnA 取得 69.6% 胜率
阅读全文

ChatGPT 官宣上线 Locked Chats 锁定对话功能:支持面容/指纹生物解锁,彻底隔离记忆库与敏感对话

OpenAI 官方正式面向全球用户推出 ChatGPT“Locked Chats(锁定对话)”安全隐私功能,全面覆盖 Free、Plus、Team、Enterprise 与 Edu 全线计划。用户现在可以使用数字 PIN 码、Face ID 或 Touch ID 生物识别对特定会话实施硬件级加锁。尤为关键的是,被锁定的对话在设计上完全与 ChatGPT 全局跨会话记忆库物理隔离,用户在其中交流的商业核心机密、敏感个人健康信息或高危代码审计内容均不会沉淀到长期记忆中,亦不会污染常规对话的上下文联想,为企业与个人隐私保护树立了新的安全标杆。

ChatGPT 官宣上线 Locked Chats 锁定对话功能:支持面容/指纹生物解锁,彻底隔离记忆库与敏感对话

核心要点速览

  • OpenAI 官方正式推出 Locked Chats,全面开放给 Free、Plus、Team、Enterprise 及 Edu 全版本用户使用
  • 支持 PIN 码、Face ID 与 Touch ID 本地生物识别认证,会话列表默认折叠隐藏,防范物理窥屏与设备借用风险
  • 彻底隔离长期记忆库(Memory Isolation):锁定对话内的任何提问、文档与上下文均不会写入用户个性化记忆模型
  • 有效解决企业员工在公共终端或共享账户上开展私密代码审计、敏感财务咨询与法务核查的数据污染与越权隐患
阅读全文
关联模型 / 智能体 / 厂商:

游戏世界模型空间一致性突破:ActionRoPE 将控制转化为世界坐标,重访漂移大幅降低 66%

来自多所高校的研究团队在 arXiv:2610.25861 中提出突破性世界模型动作接口 ActionRoPE 与坐标条件噪声调度算法(CNS)。针对俯视角与等距视角游戏世界模型中,传统将动作作为特征条件注入容易导致空间混淆、无法对齐世界坐标以及玩家返回旧场景时产生严重画面漂移(Revisit Drift)的行业痛点,ActionRoPE 创新性将动作驱动的相机位移直接转换为世界坐标旋转位置编码(RoPE),赋予相同空间物理位置恒定的位置地址。实测显示,该方法在保持动作遵循精度的同时,将重访漂移大幅削减 66%,并无缝泛化至 1.3B 到 33B 参数量的各大视频生成底座。

游戏世界模型空间一致性突破:ActionRoPE 将控制转化为世界坐标,重访漂移大幅降低 66%

核心要点速览

  • 研究团队推出 ActionRoPE 接口与 CNS 调度机制(arXiv:2610.25861),攻克俯视角与等距游戏世界模型空间不一致痼疾
  • 创新提出参数无关动作接口,将玩家运动相机位移直接映射为世界坐标 RoPE,确保同一物理坐标跨时间步持有唯一空间地址
  • 提出坐标条件噪声调度(CNS),区分已知观察区域与待合成区域,使重访漂移(Revisit Drift)相较最强基线大幅削减 66%
  • 具备极佳跨模型泛化性,在从 1.3B 到 33B 参数的多款主流视频扩散骨干网络上均实现即插即用
阅读全文
关联模型 / 智能体 / 厂商:

真实世界 3D 资产生成大考:BlenderWorld 首发 223 项工业基准,GPT-6 Astra 斩获 79.9 分领跑

多所顶尖研究机构在 arXiv:2610.23986 中正式发布首个面向真实世界参考的视觉智能体 3D 创作评测基准 BlenderWorld。基准涵盖程序化建模、着色材质编写、空间布局与灯光模拟等 223 项真实工业级任务,接入 Blender 软件全自动沙盒环境。实测显示 GPT-6 Astra 以 79.9 分综合得分问鼎全球榜首(完美完成率达 42.2%),Opus-5 斩获 73.0 分,而开源模型 DeepSeek-V4.1-Flash 斩获 65.7 分超越众多大尺寸基线。

真实世界 3D 资产生成大考:BlenderWorld 首发 223 项工业基准,GPT-6 Astra 斩获 79.9 分领跑

核心要点速览

  • 多所顶尖机构发布首个面向真实世界 3D 资产创作的工业评测基准 BlenderWorld(arXiv:2610.23986),涵盖 223 项全自动 Blender 任务
  • GPT-6-Astra 以 79.9 分与 42.2% 完美率强势领跑全球榜首,Opus-5 斩获 73.0 分位居第二
  • 开源旗舰 DeepSeek-V4.1-Flash 斩获 65.7 分登顶开源第一,并在多模态子任务中以 65.5 分追平商业旗舰 GPT-5.6-Sol
  • 揭示截然不同的 Agent 求解流派:GPT 倾向于前瞻性规划(39.9K Token),而 DeepSeek 依靠高频工具迭代检查(单任务 168 次工具调用)
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容
A
Anthropicgithub.com·
👀67
🔥82

Claude Code 2.1.304:新增 /auto-mode-setup 引导式配置 auto mode;Pro/Max 恢复旧会话前提示 5 小时额度消耗

Anthropic 于 10 月 19 日(UTC)发布 Claude Code v2.1.304:新增 /auto-mode-setup,读取项目与近期会话来教 auto mode 认识你的环境,并扩展到 Bedrock、Vertex、Foundry、Claude apps gateway 与关闭遥测的会话;新增 /claude-api managed-agents-secure,对照官方安全指南只读检查 Managed Agents 配置;Pro/Max 恢复闲置会话前若会明显占用 5 小时额度会先提示。同版修复 claude --worktree 退出时可能不问就删除分支导致丢 commit 等 40 余项问题。

核心要点速览

  • 新增 /auto-mode-setup:读取项目与近期会话为 auto mode 建立环境认知,覆盖 Bedrock、Vertex、Foundry、Claude apps gateway 等 5 类此前不支持的会话(v2.1.304 Release)
  • 新增 /claude-api managed-agents-secure:把 Managed Agents 配置与官方安全指南逐项对照,只读、不改配置
  • Pro/Max 计划恢复闲置会话前,若会明显占用 5 小时用量额度,会提示「仍然恢复」或「新开会话并按需回查旧会话」
  • Mods 的 tool.check 新增 decider: "person" 与 e.isReadOnly,可强制只有人工权限对话框能批准某类调用
  • 修复 40 余项问题,包括 claude --worktree 在 HEAD 游离时退出可能不问就删除 worktree 与分支、CLAUDE_CODE_AUTO_COMPACT_WINDOW=200k 被静默设成 100K
阅读全文
关联模型 / 智能体 / 厂商:

同济与腾讯提出 3D 世界模型视角解耦表征 GeoState:分离相机畸变与场景演变,Waymo 跨帧预测零尺度漂移

现有 3D 世界模型多直接采用几何基础模型(GFM)特征作为状态,但视角依赖性导致相机运动与场景演变相互纠缠,长链路外推极易发生尺度漂移崩溃。同济大学与腾讯团队发表 GeoState(arXiv:2610.22343,项目主页上线)。该框架利用场景 Tokenizer 将多视角几何特征聚合为视角解耦的世界状态,自回归模型仅推演绝对场景状态,在 Waymo 自动驾驶长程深度预测中全程保持单一上下文尺度,且零样本泛化至 KITTI 与 nuScenes。

同济与腾讯提出 3D 世界模型视角解耦表征 GeoState:分离相机畸变与场景演变,Waymo 跨帧预测零尺度漂移

核心要点速览

  • 同济大学与腾讯团队提出 3D 世界模型视角解耦表征 GeoState(arXiv:2610.22343),根本性解决 GFM 特征视点依赖造成的长程尺度漂移
  • 通过场景 Tokenizer 将环视几何特征聚合为视角解耦状态,自回归模型推演物理演化,几何解码器按需响应目标相机光线查询
  • 在 Waymo 自动驾驶长程深度预测(t+0.2s 至 t+2.0s)中全程维持单一上下文尺度,全面超越 DINO-Foresight 与 VGGT-World
  • 展现出强大的跨传感器泛化能力,零样本无缝迁移至 KITTI 与 nuScenes 复杂路况
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 给 METR 评估团队「类员工」访问权限:6 人进驻内部系统,Anthropic 无权否决其发布风险评估

Anthropic 于 10 月 15 日(美西时间)宣布,已为非营利评估机构 METR 的 6 名员工开通「类员工」权限:公司设备、办公位,以及大致与自家风险评估团队相当的内部工具和系统访问。METR 将公开其对 Anthropic 风险水平、事件与做法的分析,Anthropic 不能否决发布,只能按预先约定的类别要求删改。Anthropic 同时公布三档评估方访问分级,并披露 SecureBio、Accenture、Faculty 等合作进展。

Anthropic 给 METR 评估团队「类员工」访问权限:6 人进驻内部系统,Anthropic 无权否决其发布风险评估

核心要点速览

  • METR 6 名员工获公司设备、办公位与大致等同 Anthropic 风险评估团队的内部访问(官方口径)
  • Anthropic 无权否决 METR 发布,只能在客户数据、律师-客户特权信息、模型架构等预设类别内要求删改
  • 评估方访问分三档:第 1 档需批准才能发布,第 2 档可自主发布,第 3 档(即 METR)再加类员工访问
  • SecureBio 正在审阅 8 月风险报告的化学与生物武器章节;与 Accenture、Faculty 推进红队与对齐评估合作,并与 Hugging Face 等早期接触
  • 官方推文发布约 3 天内浏览约 53.7 万次、点赞约 3,800
阅读全文

浙大 InfiniSplat v2 高赞登顶(118 赞):前馈 3D 高斯渲染感知误差骤降 32.9%,以色列理工 H-DDCM 哈达玛码本实现单卡准实时视频压缩

针对前馈式 3D 高斯泼溅(3DGS)在大视角跨越下渲染质量骤降以及免训练扩散生成式压缩显存算力开销过大的痛点,今日两项重磅视觉与图形学成果给出突破:浙江大学周晓巍、鲍虎军、彭思达团队开源 InfiniSplat v2(arXiv:2610.20341,HF 118 赞),通过冻结几何分支解耦几何与属性预测并引入大角度目标视图监督,在 6 大三维数据集上将平均 LPIPS 与 DISTS 误差分别大幅降低 25.8% 与 32.9%;以色列理工学院推出 H-DDCM(arXiv:2610.18125),用隐式随机哈达玛(Hadamard)字典替代稠密高斯码本,将计算与显存降至 O(d log d) 与 O(d),结合周期性 KV 缓存前缀重编码实现单 GPU 准实时流式生成视频压缩。

浙大 InfiniSplat v2 高赞登顶(118 赞):前馈 3D 高斯渲染感知误差骤降 32.9%,以色列理工 H-DDCM 哈达玛码本实现单卡准实时视频压缩

核心要点速览

  • 浙江大学开源 InfiniSplat v2(HF 118 赞):通过冻结几何分支解耦几何与属性预测并结合大角度视图监督,在 6 大三维数据集上将有位姿前馈平均 LPIPS 与 DISTS 分别降低 25.8% 与 32.9%
  • 在无位姿(Pose-Free)设定下 InfiniSplat v2 同样以平均 LPIPS 0.3026 / DISTS 0.1341 击败 WorldMirror 2.0(0.3757 / 0.1935)与 AnySplat
  • 以色列理工提出 H-DDCM:用隐式快速哈达玛变换字典将免训练扩散压缩的计算与显存降至 O(d log d) 与 O(d),结合周期性 KV 缓存前缀重编码实现单 GPU 准实时长视频压缩
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 公开内部就业报告:初级技术岗招聘占比从 27% 降到 9%,8 月 Agent 工时已是员工的 6 倍

Anthropic 经济研究团队 10 月 16 日发布《How employment is changing at Anthropic》,用内部人事、Agent 遥测、代码提交、日历和招聘评估数据,描述一家深度使用 AI 的公司如何变化:初级技术岗在技术招聘中的占比从 27% 降至 9%;员工发起的交互式 Agent 工时在 8 月达到员工工时的 6 倍;工程师人均代码提交是半年前的 5 倍;而 Claude 会话约 80% 的时间在等人回复,人的注意力成了瓶颈。

Anthropic 公开内部就业报告:初级技术岗招聘占比从 27% 降到 9%,8 月 Agent 工时已是员工的 6 倍

核心要点速览

  • 初级技术岗占技术招聘比例 27% → 9%;技术部门内初级员工占比自 2025 年初 21% → 14%(官方口径)
  • 2026 年 3 月 Agent 总工时首次超过人类;到 8 月,仅员工发起的交互式 Agent 工时就是员工的 6 倍
  • 工程师人均代码提交是半年前的 5 倍;对比 192 名采用者与 74 名未采用者,Agent 写的代码删改/回滚率与人写的无差异
  • Claude 交互会话约 80% 时间在等人;「元工作」(写规格、监控 Agent 流水线)占比从 10% 升到 22%
  • 员工预计 2030 年 AI 能做自己 75% 的工作,其他美国人为 28%;公司以预警系统和内部转岗应对
阅读全文
关联模型 / 智能体 / 厂商: