
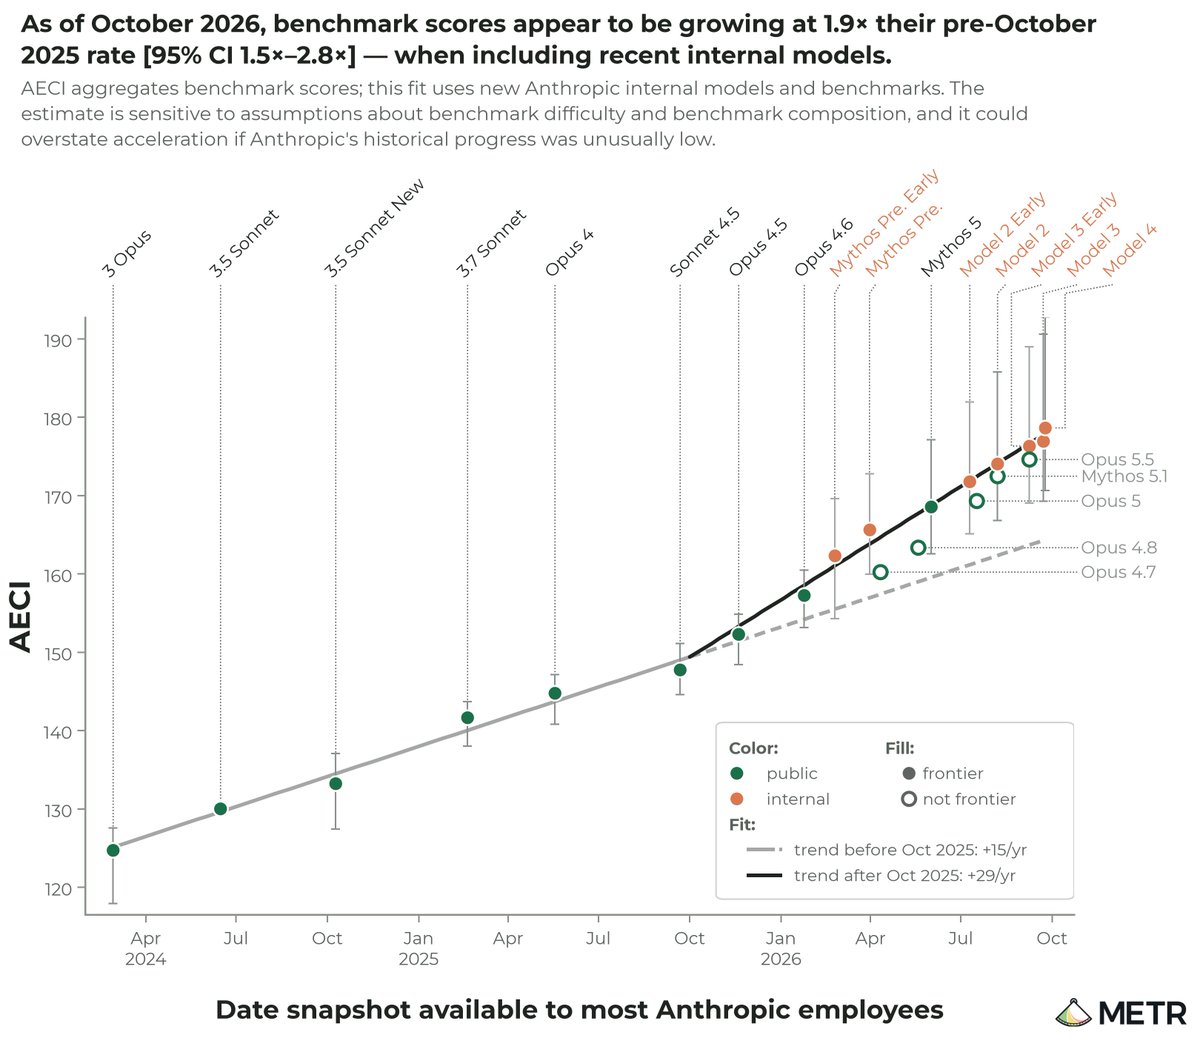
独立评估机构 METR 于 11 月 5 日发布对 Anthropic 的高权限评估报告(2026 年 8 月 12 日–10 月 29 日):截至 2026 年 10 月,Anthropic 在可验证任务上的模型能力进展很可能约为 2024 年 3 月至 2025 年 10 月历史速率的两倍;自 2025 年 10 月起 AECI 增长约 1.9×(95% CI 1.5–2.8)。多数当前加速归因于 AI 辅助研发,非训练算力增速;Anthropic 对多处关键证据做了脱敏。
核心要点速览
- ✓主观结论:可验证任务能力进展约 2× 历史速率(不确定性高,真实值可能约 1.3×–3×;METR 口径)
- ✓AECI:自 2025-10 起增长约 1.9× [95% CI 1.5–2.8],约等于一年内完成两年历史进度(含内部未发布模型)
- ✓归因:置信排除「训练算力增速」;当前多数加速归因于 AI 辅助研发(约 80% 主观猜测),非完全自主贡献
- ✓风险:未见未来 12 个月明确瓶颈,存在进一步加速风险;关键证据大量被 Anthropic 脱敏
- ✓过程:与 10 月 15 日「类员工访问」评估不同;算力分配核验部分被 Anthropic 中途取消
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
AI 是否在加速自身研发,是 RSP 与公众风险判断的核心问题。METR 于 2026 年 8 月 12 日至 10 月 29 日在 Anthropic 做高权限评估,11 月 5 日发布摘要:截至 10 月,Anthropic 在可验证任务上的能力进展很可能约为历史速率的两倍。
架构亮点与底层机制
评估覆盖预训练、RL、算力、内部基准与访谈。公开主证据是 AECI 分段线性趋势;纳入内部未发布 Model 2/3/4 后,估计高于 Haiku 5.5 系统卡约 1.7×。加速以 AI 辅助为主,而非完全自主接管关键训练。
权威 Benchmark 与实测跑分对比
自 2025 年 10 月起 AECI 约 1.9×(95% CI 1.5–2.8);稳健性约 1.1×–2.9×。METR 强调 AECI 侧重易评分任务,未必映射真实影响;关键证据多被 Anthropic 脱敏。
开发者实战落地与开箱指南
读 metr.org/blog/2026-11-05-anthropic-ai-rd-acceleration-assessment/。可对照内部评测是否过拟合、AI 是否进入关键训练环。勿把「约 2×」外推到排期;与 10 月「类员工访问」评估不是同一项目。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察