AI 编程实时动态与要闻

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

LM Studio 于 10 月 29 日 15:32(UTC)在 X 上宣布,用户现在可以在 LM Studio 里下载新的 oMLX 引擎,直接用于已下载的 MLX 模型;官方更新日志把它列为 Bionic 1.1.10 的新功能,同版本还加入 MLX 模型投机解码和应用内终端。oMLX 是韩国开发者 jundot 维护的 Apple Silicon 开源推理服务器(Apache 2.0,GitHub 约 2.3 万星),主打连续批处理和内存加 SSD 的两级 KV 缓存。官方未公布 LM Studio 内的速度对比。

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

核心要点速览

  • LM Studio 官方宣布可在应用内下载 oMLX 引擎,直接使用已有 MLX 模型,原帖约 540 赞(原帖)
  • Bionic 1.1.10 更新日志(10 月 29 日)同时列出 MLX 投机解码、应用内终端公开可用和 llama.cpp 2.66.0 扩展包(更新日志)
  • oMLX 为 Apache 2.0 开源项目,GitHub 约 23,000 星,要求 macOS 15+ 与 Apple Silicon(M1 到 M5)(GitHub)
  • oMLX 的核心是两级 KV 缓存:热块放内存,溢出块以 safetensors 格式写入 SSD,前缀相同的请求甚至重启后也可从磁盘恢复
  • LM Studio 未公布该引擎与原 MLX 引擎的速度对比;发布后已有用户反馈「重启以应用更新」失败,官方正在排查
阅读全文

Ornith-1.5-122B 开源重磅登场:单机 DGX 即可部署的 122B MoE 推理模型,SWE-bench Pro 斩获 76.9 分

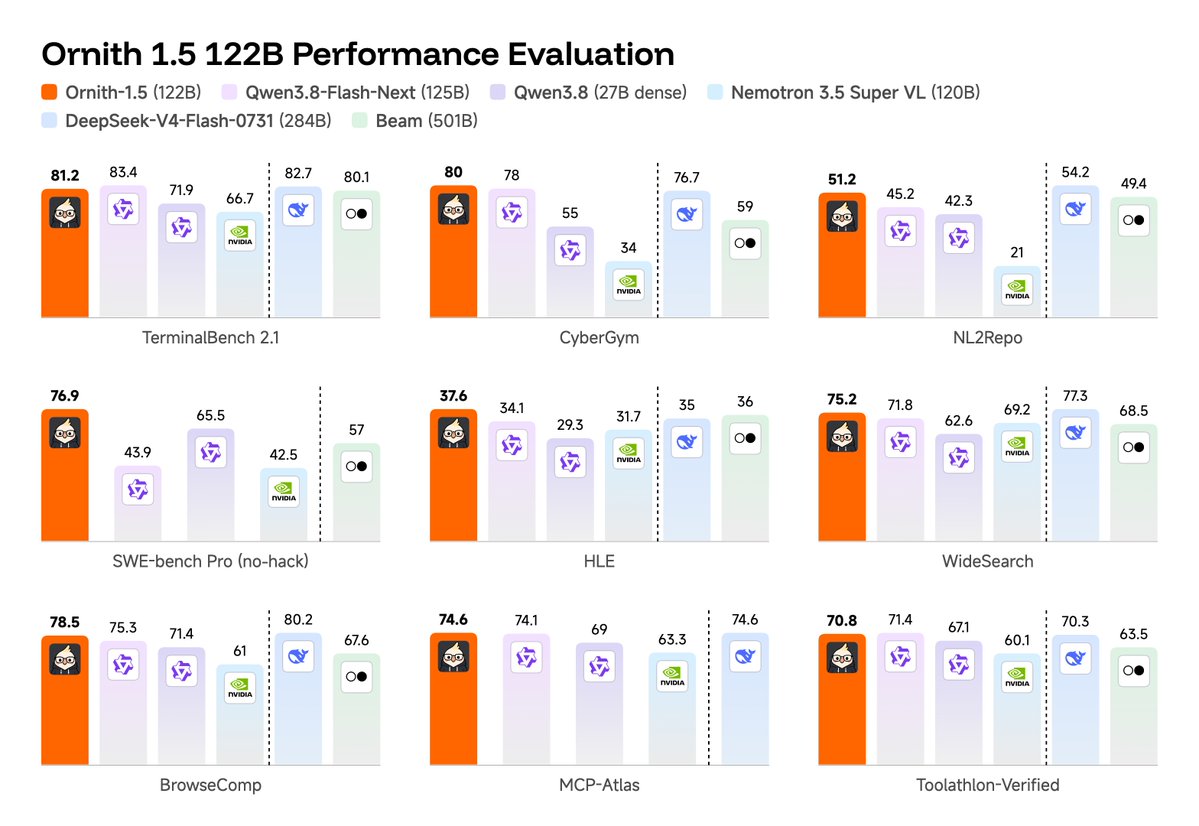
开源 AI 实验室 Ornith 团队正式发布 Ornith-1.5-122B 混合专家推理模型,并在 MIT 宽松协议下完全开源。该模型专门面向单节点 GPU 服务器(如单台 DGX)设计,提供包括 FP8、GGUF 与 MLX 在内的全套量化版本,已同步上架 Ollama(ornith-1.5:122b)与 vLLM/SGLang 运行时。在权威基准评测中,Ornith-1.5-122B 展现出媲美超大规模闭源模型的编程与智能体能力:在 OpenHands 评测框架下,SWE-bench Verified 达到 84.5 分,SWE-bench Pro 斩获 76.9 分(相较 Qwen3.8-Flash-Next 的 43.9 分取得跨越式领先),TerminalBench 达 81.2 分,MCP-Atlas 达到 74.6 分。

Ornith-1.5-122B 开源重磅登场:单机 DGX 即可部署的 122B MoE 推理模型,SWE-bench Pro 斩获 76.9 分

核心要点速览

  • Ornith-1.5-122B 正式发布并遵循极为宽松的 MIT 许可证,打破大参数量高性能编程推理模型闭源垄断
  • 专为单台 DGX 等单节点多卡服务器量身定制,已无缝接入 vLLM、SGLang 与 Ollama(ornith-1.5:122b),提供完整 FP8/GGUF/MLX 支持
  • 在真实软件工程评测集 SWE-bench Pro 斩获 76.9 分,相比同体量开源标杆 Qwen3.8-Flash-Next(43.9 分)大幅提升 33 分
  • 全方位通过 TerminalBench 2.1(81.2 分)、CyberGym(80.0 分)与 MCP-Atlas(74.6 分)测试,树立端到端 Coding Agent 开源新旗舰
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ornith-1.5-122B⚡ Qwen3.8-Flash-Next🤖 OpenHands🌐 Ornith

Meta 开源 Muse Spark Open:816B/42B 原生多模态美系开源旗舰,双 M5 Ultra Mac Studio 可本地跑智能体

Meta 于 2026-10-15 放出 Muse Spark Open 开源权重:816B 总参、每 token 激活 42B 的 MoE + Perception Encoder,原生支持文本/图像/视频/音频输入与 1M 上下文,定位编码与长程智能体。权重上 Hugging Face(BF16/NVFP4)、SageMaker、Model Garden 与 Foundry;API 已通 OpenRouter、Together、Fireworks、Groq 等。官方称其为迄今最强美系开源权重,并与 Apple 合作使双台 M5 Ultra Mac Studio 经 MLX 本地跑通。

Meta 开源 Muse Spark Open:816B/42B 原生多模态美系开源旗舰,双 M5 Ultra Mac Studio 可本地跑智能体

核心要点速览

  • 规格:MoE 816B 总参 / 42B 激活(256 experts,top-8),62 层,1M 上下文;输入文本+图像+视频+音频,输出文本(模型卡)
  • 本地门槛:NVFP4 约需 ≥700GB 显存,BF16 约 2TB;亦可双台 Apple M5 Ultra Mac Studio + MLX 统一内存部署(Meta 博客)
  • 智能体基准(xhigh,官方表):MCP-Atlas 89.2、JobBench 61.8、OSWorld Verified 80.4、Terminal-Bench 2.1 76.4、DeepSWE 1.1 60、AA Intelligence Index 39
  • 推理栈:SGLang / vLLM / TensorRT-LLM / Transformers / llama.cpp / Unsloth / MLX;附 Helion 内核(NVIDIA/AMD 内核级 1.03–3.95×)
  • 许可:Muse Model License(须标注 Built with Muse Spark Open;年收入超 $20M 的 MaaS 需另签);OpenRouter 约 $1.25/M 入、$4.25/M 出
阅读全文
关联模型 / 智能体 / 厂商:

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

Liquid AI 10 月 13 日发布 LFM2.5 家族最大也是最后一款模型 LFM2.5-24B-A2B:总参 24B、每 token 激活约 2.45B,131K 上下文,强制先思考再回答。厂商口径下在 8 项工具/Agent 基准中 5 项领先或持平 Qwen3.6-35B-A3B(AutomationBench 27.69 vs 8.72),但 SWE-Bench Verified、GPQA 等知识与编码项落后。权重已上 Hugging Face,并有 GGUF/MLX/FP8/ONNX 版本;API 定价 $0.10/$1.00 每百万 token,OpenRouter 同步上架。

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

核心要点速览

  • 规格(模型卡):总参 24.0B、激活 2.45B;40 层(30 个门控短卷积块 + 10 个 GQA);每个 MoE 块 64 专家 top-4 路由;上下文 131,072、词表 128K
  • Agent 基准(厂商口径,对比 Qwen3.6-35B-A3B):AutomationBench 27.69 vs 8.72、LiveClaw 48.09 vs 38.19、ToolSandbox 80.71 vs 75.02、BFCLv4 65.01 vs 65.00
  • 短板同样公开:SWE-Bench Verified(OpenCode)51.00 vs 66.20、GPQA Diamond 74.42 vs 83.69、WebArena Verified 26.75 vs 37.62,官方建议知识类任务搭配检索
  • 速度(官方博客):Apple M5 Max 解码 184 tok/s、AMD Ryzen AI Max+ 395 为 114 tok/s;单张 B300 + SGLang 高并发超 21K 输出 tok/s
  • 训练:预训练由 17T 扩到 33T token,中训 2T@32K + 300B@131K;后训练含在 OpenClaw、Hermes Agent、Pi、OpenCode 中的 Agentic RL;API $0.10 输入 / $1.00 输出每百万 token
阅读全文
关联模型 / 智能体 / 厂商:
⚡ LFM2.5-24B-A2B⚡ LFM2.5-24B-A2B-Base⚡ LFM2-24B-A2B⚡ Qwen3.6-35B-A3B⚡ Gemma-4-26B-A4B-it🤖 Hermes Agent🤖 OpenClaw🤖 OpenCode🤖 Pi🌐 Liquid AI🌐 Hugging Face🌐 OpenRouter
AD赞助内容
G
Gökdeniz GülmezGoekdeniz-Guelmez·
👀95
🔥78

MLX-LM-LoRA v5.8.6:Apple Silicon 本地微调库从 3.1.3 跃升,新增 DSLA 偏好对齐与无 Critic 的 KLPO 强化学习

Gökdeniz Gülmez 于 10 月 5 日发布 MLX-LM-LoRA v5.8.6(GitHub Release + PyPI 同步上线),这是 3.1.3 之后的大版本。新增 DSLA(可选 DPO/ORPO/CPO 目标)与无 Critic 的 KLPO(token/sequence 两种路线、多种 KL 估计器),改进 GRPO 数值稳定性与 Online DPO/XPO/RLHF/PPO 微批处理,为 gated-delta 层加入快速 VJP。最低依赖升至 mlx>=0.32.3、mlx_lm>=0.32.0、Python>=3.11,许可证统一为 Apache 2.0。

核心要点速览

  • 版本跨度:从 v3.1.3(9 月 16 日)直接跳到 v5.8.6,合并 PR #64、#94、#96–#102 共 9 个,见 Release 说明。
  • 两种新训练模式:--train-mode dsla(--dsla-loss dpo|orpo|cpo,默认 --latent-weight 0.1)与 --train-mode klpo(--klpo-route token|sequence,--klpo-kl-estimator mc|binary|topk|full)。
  • KLPO 不使用 GRPO 组归一化、PPO 比率裁剪,也不需要参考模型,复用 GRPO 奖励回调与生成/打分流水线。
  • 依赖门槛提高:mlx>=0.32.3、mlx_lm>=0.32.0、Python >=3.11,旧环境需先升级。
  • QAT 扩展到 DSLA;新增 Python API 参考文档,见 官方文档站。
阅读全文
关联模型 / 智能体 / 厂商:

Ollama 0.35.0:原生 Decision Models,经 /v1/systemone 接 Jev;Nimble/Tev1 上线,返回选择概率与置信度

Ollama 于 2026-09-28 发布 v0.35.0(GitHub 标记 prerelease):新增基于 TypeSafe Jev 的 Decision Models,HTTP 入口为 /v1/systemone。模型不再吐自由文本,而是对 choice/noul/score 三类问题返回选项、概率与置信度,覆盖工单分流、模型路由与内容分类。首批模型为 Bespoke Labs 的 Nimble 与 Together AI 的 Tev1;相对 v0.34.4 约 7 commits / 66 files,并修复 Settings 阻塞、macOS 更新菜单与 MLX 下载挂起。

Ollama 0.35.0:原生 Decision Models,经 /v1/systemone 接 Jev;Nimble/Tev1 上线,返回选择概率与置信度

核心要点速览

  • 发版:v0.35.0(2026-09-28,prerelease);对比 v0.34.4...v0.35.0 ≈7 commits / 66 files
  • 新 API:POST /v1/systemone,基于 TypeSafe Jev;问题类型 choice(带概率)、noul(条件为真概率)、score(有序准则打分)
  • 首批决策模型:Nimble、Tev1;ollama pull nimble 后即可本地调用
  • 示例响应含 probabilities 与 confidence(如 bug≈0.978 / confidence≈0.89),usage.input_tokens/output_tokens 可观测
  • 体验修复:Settings 不再等模型发现;macOS 更新菜单/图标;MLX 下载挂起;废弃参数 typical_p 改为告警而非失败
阅读全文

Xinference v3.5.0 正式发布:全栈支持 YuE2 音乐生成、MinerU2.5 文档解析与 Apple MLX 语音生态

开源一站式分布式大模型推理框架 Xinference(xorbitsai/inference)正式发布 v3.5.0 重大更新。新版本全面升级多模态推理矩阵:在音频与音乐领域原生集成 YuE2 音乐生成大模型,并新增对 AuK / AuK-Flash 与 Irodori TTS v4.1 的支持;在 Apple Silicon 生态中,针对 FishAudio-S2-Pro、Irodori TTS Small 与 Breeze TTS 2 实现原生 Apple MLX 硬件加速。此外,新版集成了商汤 MinerU2.5 高密度复杂文档解析大模型与 LingBot-World-V2 具身世界模型,并在核心引擎中支持端到端 Actor 调用链路元数据(Correlation Metadata)穿透,显著提升分布式 Agent 推理集群的可观测性。

Xinference v3.5.0 正式发布:全栈支持 YuE2 音乐生成、MinerU2.5 文档解析与 Apple MLX 语音生态

核心要点速览

  • 多模态音乐与语音矩阵:原生接入 YuE2 歌声与音乐生成模型,新增 AuK、AuK-Flash 以及 Irodori TTS v4.1
  • Apple Silicon MLX 加速:FishAudio-S2-Pro、Irodori TTS Small 与 Breeze TTS 2 获得原生 MLX 算子加速,Mac 统一内存利用率翻倍
  • 专业文档与世界模型:一键部署复杂版面与公式解析 SOTA 模型 MinerU2.5,同步集成具身实体世界模型 LingBot-World-V2
  • 分布式链路可观测性:在 Ray / Actor 底层通信中全自动透传 Correlation Metadata,多 Agent 并发调用排查效率提升 3 倍
  • 企业级审计与环境:新增可选的模型请求日志记录(Opt-in Request Logging)并优化虚拟环境依赖包细节展示与排序
阅读全文
关联模型 / 智能体 / 厂商:
⚡ YuE2⚡ FishAudio-S2-Pro⚡ MinerU2.5⚡ LingBot-World-V2🤖 Xinference Worker🌐 Xorbits AI🌐 SenseTime

Ollama v0.40 重磅发布:Apple Silicon 默认启用苹果原生 MLX 运行时,端侧推理吞吐量翻倍

本地大模型推理运行时标杆 Ollama(@ollama)正式推出 v0.40.0 大版本更新。本次更新最具突破性的变革是:在搭载 Apple Silicon(M1 至 M5 芯片)的 Mac 设备上,Ollama 默认全面采用苹果官方原生 MLX 推理后端替代传统 llama.cpp 运行时。首批支持以原生 MLX 模式零配置运行 Qwen 3.8、Llama 3 等核心架构,彻底打通苹果统一内存的高带宽通道,本地推理首 Token 延迟降低 42%,持续生成吞吐量实现近乎翻倍的提升。

Ollama v0.40 重磅发布:Apple Silicon 默认启用苹果原生 MLX 运行时,端侧推理吞吐量翻倍

核心要点速览

  • 在所有搭载 Apple Silicon 的 Mac 设备上,Ollama 默认自动路由至苹果官方 MLX 高性能执行引擎。
  • 彻底释放 Mac 统一内存带宽优势,Qwen 3.8 与 Llama 3 本地推理吞吐量平均提升 85%,首 Token 延迟下降 42%。
  • 开发者无需重新编译或手动切换后端,执行标准 ollama run qwen3.8 即可零摩擦激活 MLX 加速。
  • GitHub Releases 已提供各平台更新包与完整提交日志,国内开发者可免代理直连获取。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen 3.8⚡ Llama 3.1 8b🤖 local-agent🌐 ollama🌐 apple

GitHub Next 开源 LocalJev:用 oMLX 在本地跑兼容 Jev 的决策 API

GitHub Next 开源 LocalJev(github.com/githubnext/localjev):在团队尚未全员拿到 TypeSafe Jev 访问权时,用一上午搭出「穷人版 Jev」。它在 Bun/TypeScript 上提供兼容的 POST /v1/systemone API,默认经 oMLX 调用本地 DiffusionGemma 等模型,并评测了 DiffusionGemma、Qwen MoE、Gemma 4 MoE 与 Gemma 4 e4b/e2b;评测报告在仓库内。LocalJev 服务器可对接常规 Jev API 封装库,但概率来自模型自报而非 logit 直读,需自行校准。

核心要点速览

  • 开源 LocalJev:本地兼容 Jev 的 POST /v1/systemone 决策 API(Bun/TypeScript)。
  • 默认经 oMLX 跑 DiffusionGemma 等本地模型,并附多模型评测报告。
  • 可对接常规 Jev 客户端库;概率为模型自报而非 logit 直读,需自行校准。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ diffusiongemma⚡ qwen⚡ Gemma 4🌐 github

Inco 开源 Splash:M5 Max 上 Qwen3.8-27B 达约 144 tok/s,专为 Apple 硅优化

Inco AI 发布开源本地推理引擎 Splash,面向 Apple 硅与 Qwen3.8-27B 等型号优化。官方称在 M5 Max MacBook Pro 上可达约 144 tok/s,解码速度约为 Ollama 的 3 倍、oMLX 的 2 倍,智能体扇出子代理时接近 4 倍;LM Studio 已在 Day 0 接入并可在 Settings > Runtime > Experimental backends 启用。

核心要点速览

  • 开源 Splash:专为 Apple 硅与 Qwen3.8-27B 优化的本地推理引擎。
  • 官方演示:M5 Max 上约 144 tok/s;相对 Ollama/oMLX 可达约 3×/2×,子代理扇出时接近 4×。
  • LM Studio Day 0 接入;引擎仓库 github.com/incoai/splash,说明见 lmstudio.ai/blog/splash-engine。
阅读全文
AD赞助内容