
AI 编程实时动态与要闻

Cartesia 新一代 H-Net:不用 tokenizer、直接从原始字节学习,3B 级模型约 1T token 追平 SmolLM3 的 11T 训练成绩

Mamba 作者、Cartesia 首席科学家 Albert Gu 团队 10 月 28 日发布两篇研究博客,公布新一代分层网络 H-Net 的扩展结果:在严格对照的 scaling ladder 中,只把 BPE 分词换成学习式动态分块,就获得最高 3–5 倍计算效率提升;更大的两阶段字节级 H-Net(3.67B 参数)在与 SmolLM3-3B 每字节算力对齐的条件下,约 1T token 即达到 SmolLM3 训练 11T token 后的平均下游分数(厂商口径)。新架构尚未开源,官方称计划逐步发布。
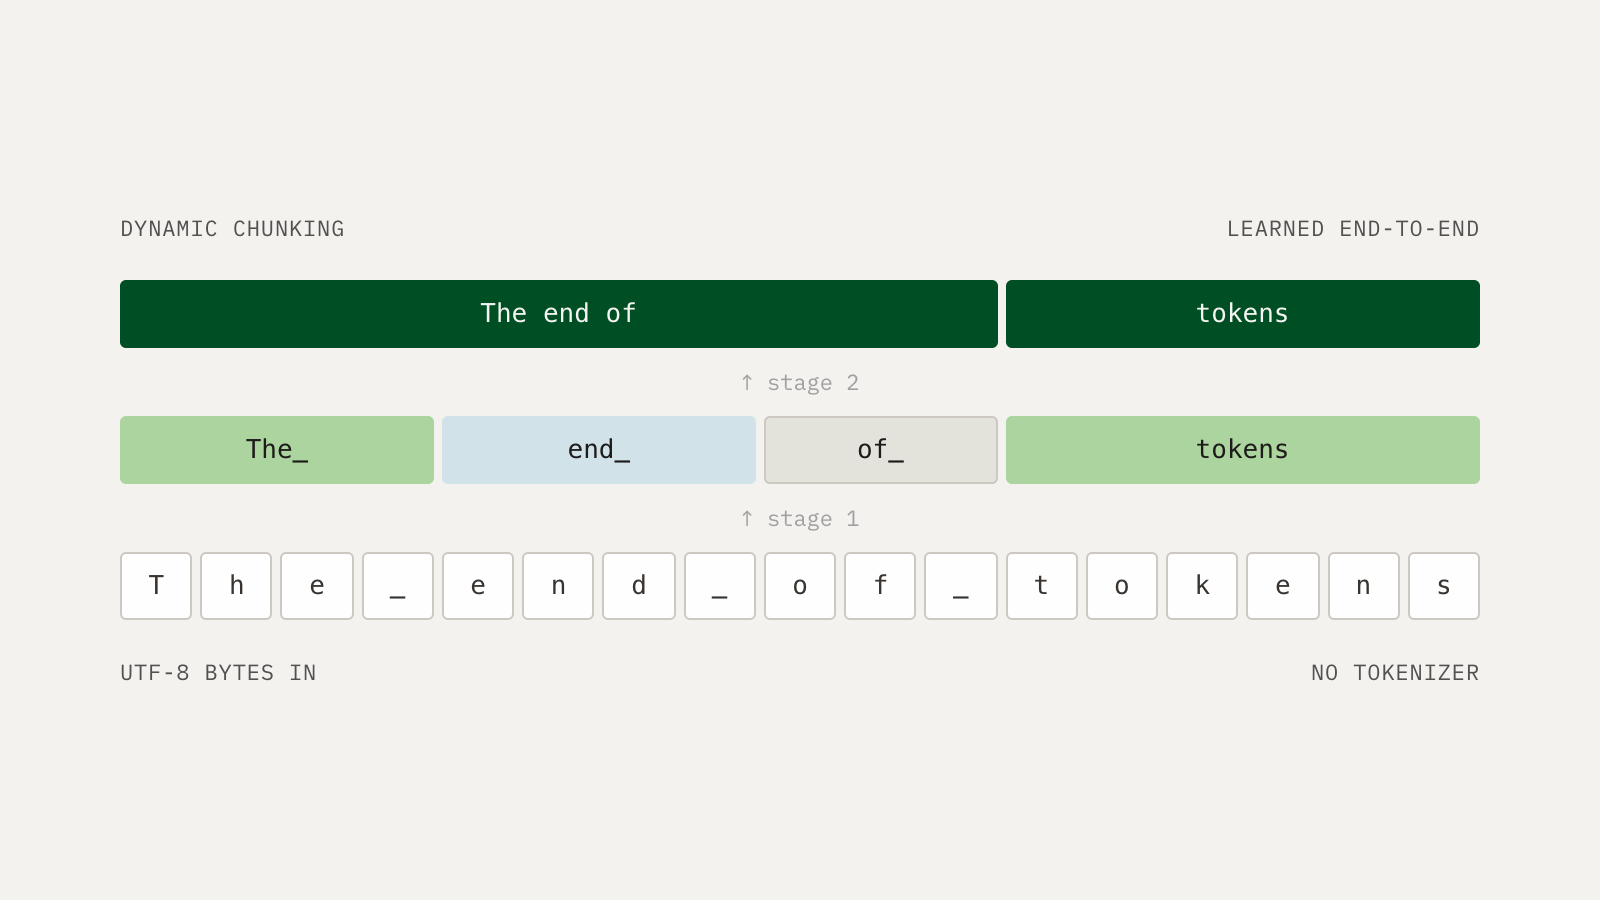
Cartesia 新一代 H-Net:不用 tokenizer、直接从原始字节学习,3B 级模型约 1T token 追平 SmolLM3 的 11T 训练成绩

核心要点速览

  • 对照实验(官方口径):1 阶段 H-Net 直接替换 BPE,验证损失约 1.3 倍、代码约 2 倍计算效率,整体最高 3–5 倍
  • 大模型对比:两阶段字节级 H-Net 3.67B 参数 vs SmolLM3 3.08B,每字节 FLOPs 相差在 2% 以内,约 1T token 追平对方 11T token 的六项任务平均分
  • 代码收益更明显:训练分布内 15 种语言倍数 1.49x–2.40x(中位 2.04x),分布外 10 种语言中位 3.10x,Prolog 最高 5.37x
  • 训练数据配比为英文 70%、代码 20%、数学 5%、多语言 5%;主网络约每 7.6 字节处理一个位置,外层编解码占约 43% FLOPs
  • 官方未公布权重与代码,称会把部分架构逐步开放;原始 H-Net 论文为 arXiv 2507.07955
阅读全文
关联模型 / 智能体 / 厂商:
⚡ H-Net⚡ SmolLM3-3B⚡ Mamba-2🌐 Cartesia🌐 Hugging Face

香港大学提出混合线性注意力投机解码 ReaDy:复用循环状态作为动态上下文,B200 解码吞吐达 302 TPS

传统投机解码(Speculative Decoding)依赖目标模型的静态隐层特征,无法适应草稿模型随位置变化的动态上下文需求。香港大学团队发表 ReaDy(arXiv:2610.20503,HF 6 赞)。该框架首次为混合线性注意力模型(Hybrid Linear Attention,结合 Transformer 与 Mamba/RWKV 循环层)设计了以紧凑循环隐状态为动态上下文的投机草稿机制。在 NVIDIA B200 单卡上对 Qwen3.8-27B 展开评测,投机接受长度达 4.53,单卡解码吞吐飙升至 302.78 TPS,较标准自回归提速 2.4 倍。

香港大学提出混合线性注意力投机解码 ReaDy:复用循环状态作为动态上下文,B200 解码吞吐达 302 TPS

核心要点速览

  • 香港大学提出首个专为混合线性注意力(HLA)架构打造的投机解码方法 ReaDy(arXiv:2610.20503)
  • 创新性地复用 HLA 骨干中的紧凑循环隐状态作为动态上下文,解决传统草稿模型特征静态僵化的问题
  • 在单张 NVIDIA B200 上对 Qwen3.8-27B 展开实测,解码吞吐达到 302.78 TPS,较标准自回归提速 2.4 倍,在 DSpark 基础上再提升 7.97%
  • 仅需 Rank 8 超轻量读取器即可达成最佳性能,投机接受长度达到 4.53 个 Token
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 开源 Nemotron 3.5 Super VL:120B-A12B 多模态智能体模型、1M 上下文;同步放出 2-bit 24GB 本地版 Bolt 74B-A9B

NVIDIA 于 2026-10-15 发布开源多模态智能体模型 Nemotron 3.5 Super VL:120B 总参、每 token 激活 12B,Mamba-2/Transformer 混合 MoE + C-RADIO 视觉编码器,支持文本、图像、文档与视频输入,最长 1M 上下文,自带 MTP 与 LiLiCorr 投机解码。权重、数据集与训练配方以 OpenMDW-1.1 开放,已上 Hugging Face、OpenRouter、ModelScope 与 NIM。同日放出面向 RTX/DGX Spark 的 Bolt 74B-A9B 24GB(原生 2-bit 量化感知训练),4GB 的 Bolt E4B 将于 10 月 23 日跟进。

NVIDIA 开源 Nemotron 3.5 Super VL:120B-A12B 多模态智能体模型、1M 上下文;同步放出 2-bit 24GB 本地版 Bolt 74B-A9B

核心要点速览

  • 规模:Super VL 120B 总参 / 12B 激活,最长 1M 上下文;BF16 参考部署需 4×H100 或 2×GB200,另有 NVFP4 版(模型卡)
  • 编码与终端(官方口径):SWE-bench Verified 71.10、Terminal-Bench 2.1 66.70、LiveCodeBench v6 88.22;同表 Qwen3.5-122B-A10B 分别为 71.9 / 48.70 / 76.7,GLM-5.3-Flash 为 79.10 / 82.70 / 80.6
  • 智能体评测:Hermes Bench 63.44%(Nemotron 3 Ultra 56.33%),LangChain Evals 87.05%(Ultra 84.3%);NVIDIA 称单卡吞吐最高达同级开源模型 5 倍、Baseten 端点 600+ TPS(技术博客)
  • 本地版 Bolt 74B-A9B 24GB:原生 2-bit(IQ2+QAT)、256K 上下文,Terminal-Bench 2.1 50.98、BrowseComp 66.75,对照 Qwen3.6-35B-A3B 为 44.38 / 48.74;PinchBench 87.82 略低于 Qwen3.6 的 88.07(Bolt 模型卡)
  • 推理工程:LiLiCorr 投机解码在 DGX Spark 上最高提速 2.3 倍;Dynamo 方案在 16×B200、50 tok/s/用户下服务人数提升 8 倍、首 token 延迟降 85%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ nemotron-3.5-super-vl⚡ nemotron-3.5-bolt-74b-a9b⚡ nemotron-3.5-bolt-e4b⚡ Nemotron 3 Ultra🤖 hermes-agent🤖 opencode🤖 OpenHands (All-Hands AI)🤖 Cline (VS Code Agent)🌐 Nvidia (NIM)

多智能体隐空间通信突破!哥伦比亚大学开源 CacheBack:按需剪裁 KV Cache 压缩达 94%,延迟骤降 3.2 倍

多智能体协同(Multi-Agent Systems)在分工解决长上下文复杂任务时,长期受困于通信媒介的底层两难选择:传输纯文本信息虽然紧凑,但需要频繁自回归解码且容易丢失接收智能体所需的隐式证据;而近期前沿的“隐空间通信(Latent Communication)”直接传输 KV Cache 虽避免了文本生成的延迟与信息损失,但全量 KV Cache 会随上下文长度和协同智能体数量线性暴涨,极易击穿 GPU 显存限制与上下文窗口。哥伦比亚大学团队提出了创新的“接收端条件化通信”理念,并发布了无需训练(Training-Free)的即插即用框架 CacheBack(arXiv:2609.32046):接收端智能体仅需向发送端发送一句极简的信息需求描述,发送端即可利用注意力权重对其自身的 KV Cache 进行高精度的按需过滤与剪裁。在 FanOutQA 复杂长文本多跳问答基准上,搭载 Qwen 3 的 CacheBack 成功剔除了接收端高达 75%~94% 的冗余状态,不仅使准确率相比传统文本通信大幅攀升 14.7 个百分点,还将中位数任务完成延迟缩短为原来的 1/3.2(降低 3.2 倍),并在密集 Transformer、Mamba 混合模型以及滑动窗口注意力等多架构上展现出通用稳健性。

多智能体隐空间通信突破!哥伦比亚大学开源 CacheBack:按需剪裁 KV Cache 压缩达 94%,延迟骤降 3.2 倍

核心要点速览

  • 提出创新的接收端条件化通信机制 CacheBack,彻底解决多智能体协作中 KV Cache 显存线性爆炸难题
  • 完全无需训练(Training-Free),利用注意力反向探针按需剪除 75%~94% 的冗余缓存状态
  • 在 FanOutQA 复杂问答中相较文本通信准确率飙升 14.7 个百分点,端到端中位数执行延迟缩减 3.2 倍
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Unsloth 发布 v0.1.815 与 CUDA 13 预编译轮子:本地极速运行 Qwen-Image-2.1 并接入 Claude 规范 Agent Skills

知名大模型轻量高效训练与推理工具 Unsloth 正式发布 v0.1.815-beta 版本,并上线 Linux x86_64 CUDA 13 官方预编译二进制轮子(涵盖 Flash-Attention 2.8.4、Causal-Conv1D 与 Mamba-SSM)。新版本原生支持在本地消费级与企业级 GPU 上以 Fast FP8 与 GGUF(默认 Q4_K_M)量化运行阿里开源的多模态图像编辑与生成旗舰模型 Qwen-Image-2.1。此外,Unsloth 本地 UI 引入了深度兼容 Claude Code 与 .agents 规范的自定义 Agent Skills 体系,支持在聊天中以 @skill 快速编排专用技能,长链思考思维块渲染速率提升一倍达到 60 FPS。

Unsloth 发布 v0.1.815 与 CUDA 13 预编译轮子:本地极速运行 Qwen-Image-2.1 并接入 Claude 规范 Agent Skills

核心要点速览

  • CUDA 13 官方二进制:提供针对 PyTorch 2.13/2.14 与 Python 3.13 的 Flash-Attention 2.8.4、Causal-Conv1D 与 Mamba 预编译 Wheel,告别数小时本地编译
  • Qwen-Image-2.1 本地量化落地:支持 Fast FP8 与 GGUF Q4_K_M,完整覆盖图像生成与多轮指令式图像编辑,彻底修复 A100 黑块伪影
  • 全兼容 Agent Skills 体系:无缝复用已有 Claude Code 与 .agents 目录中的专用指令技能,聊天框支持 @skill 即时激活与参数传递
  • 思维链推理渲染翻倍:重构 CoT 思考块交互逻辑,长推理文本流式渲染速度从 30 FPS 提升至 60 FPS,交互顿挫感大幅消除
  • 多系统开箱即用:内置 Debian 应用内自动更新,并为 Ubuntu 24.04+ ARM64 架构提供专用独立安装器
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 0.29.0:Model Runner V2 成默认,含 Mamba 前缀缓存与投机解码 API 统计

vLLM 发布 v0.29.0,Model Runner V2 成为所有模型的默认运行器。本版累计 594 次提交、277 名贡献者。亮点包括:Kimi-K3 再优化、DeepSeek-V4 共享专家并入 MegaMoE、Mamba 前缀缓存保留内部 prefill 检查点(TTFT 约提升 9–25%)、投机解码经 API 报告每请求接受率,以及面向 RL 权重同步的 sharded_rdt P2P 后端;并新增 Hy4-preview、Qwen3.8-Flash-Next、GraniteSWA、NemotronH Omni Reasoning V3 等模型支持。

核心要点速览

  • Model Runner V2 成为所有模型的默认 runner。
  • Mamba 前缀缓存使 TTFT 约提升 9–25%;投机解码可经 API 查看接受率。
  • DeepSeek-V4 MegaMoE 融合与 RL sharded_rdt P2P 权重同步,并扩展多款新模型。
阅读全文
关联模型 / 智能体 / 厂商:
