AI 编程实时动态与要闻

webAI 开源 TwIL-8B:8.8B 推理小模型,LiveCodeBench 81.6、MATH-500 98.2,非商用许可

webAI CEO David Stout 于 11 月 4 日(UTC 17:37)在 X 上宣布开源 TwIL-8B。官方 Hugging Face 模型卡显示:它基于 IBM Granite 4.2 8B,经全参数 SFT、GRPO/DAPO 强化学习和长度感知 RL 训练,分 balanced 与 verbose 两个版本;自报 LiveCodeBench 81.6(verbose)、MATH-500 98.2、IFBench 74.4,约为前沿模型 93%/92% 的水平,但 GPQA Diamond 仅 70.2。提供 4.98 GiB 的 Q4_K_M GGUF,可在本地运行;许可为 webAI 非商用协议。

webAI 开源 TwIL-8B:8.8B 推理小模型,LiveCodeBench 81.6、MATH-500 98.2,非商用许可

核心要点速览

  • TwIL-8B 共 8.79B 参数,基于 IBM ibm-granite/granite-4.2-8b,上下文 131,072 tokens,仅英文、文本到文本。
  • 自报成绩:MATH-500 98.2、AIME 2025 88.3、LiveCodeBench 81.6(verbose)、IFBench 74.4(verbose);GPQA Diamond 70.2 明显落后 Qwen3.5-9B(81.7)。
  • balanced 版在 AIME 2026 平均每题约 19.5k 输出 tokens,比 Qwen3.5-9B 的 31.2k 少约 38%,但仍约为 GPT-5.5 的 4 倍。
  • 所有分数为 webAI 内部测评,竞品分数直接引用公开数据、未重跑;未测 SWE-bench、工具调用和 Agent 任务。
  • 许可为 webAI Non-Commercial License 1.0,不能直接商用;GGUF Q4_K_M 约 4.98 GiB,可用 llama.cpp 本地运行。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ TwIL-8B⚡ Granite 4.2 8B⚡ Qwen3.5-9B⚡ Gemma 4 31B🌐 webAI🌐 IBM

Axiom 用 AI 智能体集群把整部 Stacks Project 形式化为 Lean:约 1600 万行,称史上最大的可复用形式化数学库

Axiom 于 11 月 4 日(X 官方账号 UTC 17:13 发帖,帖子浏览超 200 万)发布整部 Stacks Project 的 Lean 形式化。这部约 7500 页的代数几何开源参考书由 Johan de Jong 于 2005 年发起,形式化后约 1600 万行代码,官方称是迄今最大的一体化、可复用形式化数学库。工作由分层协调的 AI 智能体集群完成,过程中发现了原文数十处需要局部修正的命题,并给出反例。成果开源,可在 stacks.axiommath.ai 对照原文浏览。

Axiom 用 AI 智能体集群把整部 Stacks Project 形式化为 Lean:约 1600 万行,称史上最大的可复用形式化数学库

核心要点速览

  • 规模:约 7500 页原文、约 1600 万行 Lean 代码,官方称是最大的一体化可复用形式化数学库(厂商自述)。
  • 方法:分层 AI 智能体集群并行翻译命题、在 Mathlib 中查找已有抽象、构造证明,并用多智能体审计和与原文的语义交叉检查保证命题忠实。
  • 发现:系统找出原文数十处需修正的命题,包括缺失假设、正特征下的边界情况,并为错误处构造了显式反例。
  • 保留 Stacks 永久标签结构,每个 Lean 声明都能对应回原文;stacks.axiommath.ai 提供对照阅读和依赖图。
  • 这是 Axiom 继 10 月 27 日发布有限单群分类(CFSG)形式化之后的又一大型发布;按 de Jong 的要求,修正内容不直接提交到上游仓库。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:roon 称「火花」出现就离超人水平只差几个月到几年,「你几乎总是低估 AI」

AI 圈知名账号 roon(@tszzl,约 50 万粉丝)11 月 2 日在 X 发帖:「当你在 AI 模型身上看到某种能力的『火花』,就意味着它离超人水平只有几个月到几年。今天是小学数学,明天是纳维-斯托克斯。这些成果很难被过度炒作,你几乎总是在低估。」帖子约 5 小时获得近 2,000 赞、5.9 万次浏览。前 Anthropic Fellows 研究员 Adam Karvonen 反驳称,模型超人的领域都是可验证、易模拟、反馈快的,研究品味、机器人、经营公司未必会这么快。这是个人观点之争,不是任何公司的官方表态。

核心要点速览

  • roon 的原话:看到某种能力的「火花」,就意味着离超人水平只有几个月到几年,「今天小学数学,明天纳维-斯托克斯」,「你几乎总是在低估」。
  • 「火花」呼应当天热传的 MIT CSAIL 博客《Sparks of Weight-Space Programming》,roon 在回复里称那篇论文是「生命迹象」,指向用 AI 直接设计神经网络行为。
  • Adam Karvonen 的反驳:超人领域都具备可验证、易模拟、反馈快、容错高等条件,研究品味、机器人和经营公司未必能这么快突破。
  • 支持者 Derya Unutmaz(约 34 万粉丝)称人们总把 AI 当成炒作,事实正好相反;也有人认为外推指数曲线并不可靠。
  • 这是个人观点,没有新的跑分或数据,不代表 OpenAI 或其他公司立场。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:MIT 团队称 GPT-6 Astra 能直接读写神经网络权重,只改 Qwen3.5-0.8B 的 0.016% 权重让 MATH-500 从 7.9% 升到 48.1%

MIT CSAIL 博士生 Rikiya Takehi 11 月 2 日在 X 上发布「Weight-Space Programming(权重空间编程)」研究:作者团队(Takehi、Jayden Teoh、Alex Zhang、Omar Khattab)让 GPT-6 Astra 不用梯度、不做训练,直接阅读和修改神经网络权重。博客称 Astra 只改了 Qwen3.5-0.8B 的 13.1 万个权重(0.016%),修复了思考死循环,MATH-500 从 7.9% 升到 48.1%。原帖约 2.4 万赞、177 万浏览,Ethan Mollick 转评「等复现,但这很重要」。以上均为作者自报结果,尚未独立复现。

X 热议:MIT 团队称 GPT-6 Astra 能直接读写神经网络权重,只改 Qwen3.5-0.8B 的 0.016% 权重让 MATH-500 从 7.9% 升到 48.1%

核心要点速览

  • 原帖(2026-11-02 17:51 UTC)抓取时约 24,320 赞、2,697 转发、2,284 引用、177 万浏览、1.5 万收藏;沃顿商学院教授 Ethan Mollick 转评「等待复现,但这很重要」,约 880 赞。
  • 实验 8(作者口径):50 次前向预算下,Astra 只改 131,072 个权重(0.016%),Qwen3.5-0.8B 的 MATH-500 从 7.9% 升到 48.1%,IFEval 从 21.0% 升到 62.3%,触及 token 上限的回答从 93.0% 降到 33.1%。
  • 实验 5(作者口径):不给数据、梯度和工具,Astra 一次性写出的 MinAtar 策略网络在 Breakout 得 517.4 分,PPO 训练 1 亿步为 15.8、5 亿步为 25.3;Seaquest 为 53.1,低于 5 亿步 PPO 的 88.9。
  • 作者自己承认的边界:换成很少死循环的 Gemma 3 270M,Astra 的编辑没让 MATH-500 提升超过约 1 个点;作者结论是改权重能「移除遮住能力的障碍」,但不能凭空加能力。
  • 全部实验日志已公开在 GitHub 仓库 RikiyaT/lm_understand-logs,目前只有博客,没有同行评审论文,也没有第三方复现。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

a16z「Rack Spread」图表:5 月以来 token 均价降 67%,token 总花费反涨 122%–160%,GPU 租金同期上涨

a16z 10 月 30 日发布的 Charts of the Week(作者 Moses Sternstein)讨论了「Rack Spread」:GPU 租金在涨,token 价格在跌。a16z 官方 X 账号 10 月 31 日总结:5 月以来 token 均价下降 67%,token 花费增长超过 120%;按文章的粗算,用 Ramp 数据得出约 122%,用 Ornn 混合单价乘 OpenRouter 用量得出约 160%。另一条帖子给出 7 月中以来 B300 租金涨 106%、B200 涨 66%、H100 涨 17%。a16z 同时强调这些指数样本小且有偏差,不能代表真实总需求。

a16z「Rack Spread」图表:5 月以来 token 均价降 67%,token 总花费反涨 122%–160%,GPU 租金同期上涨

核心要点速览

  • 价格与花费:5 月以来 token 均价降 67%,token 花费涨超 120%(a16z 官方 X 帖,a16z 口径)
  • 两种粗算:Ramp 的 token 花费数据约 +122%;Ornn 混合单价 × OpenRouter 用量约 +160%(Charts of the Week,作者自称是粗算而非严谨方法)
  • GPU 租金:7 月中以来 B300 +106%、B200 +66%、H100 +17%,同期 token 均价 -58%(a16z 帖子)
  • 人均 AI 支出:亚特兰大联储调查的均值超过每员工 1,000 美元,Ramp 的中位数是每月 15.70 美元(每年 188 美元)
  • 热度:两条帖子约 371 和 492 赞、3.8 万和 9.6 万浏览(截至 18:15 SGT)
阅读全文

Anthropic 扩大 AI for Science 计划:向 NSF、Simons、Sloan 等 20 家基金会、研究机构和项目提供免费 Claude 额度

Anthropic 宣布把 2025 年 5 月启动的 AI for Science 计划从个人研究者扩展到机构层面:6 家科研资助方(含美国国家科学基金会 NSF、Simons、Sloan、Schmidt Sciences)将向研究者分发 Claude 额度,6 家研究机构(如 STScI、Sanger、Crick、EMBL)在内部使用,另有 6 个公共科研项目(如 gnomAD、FlyWire、Lean 数学库 Tau Ceti)直接获得支持。官方未公布额度总金额。

Anthropic 扩大 AI for Science 计划:向 NSF、Simons、Sloan 等 20 家基金会、研究机构和项目提供免费 Claude 额度

核心要点速览

  • 本次点名 20 家合作方,分三类:资助方与学会、研究机构、具体科研项目(官方口径)
  • 资助方包括年预算约 90 亿美元的美国 NSF、Simons、Sloan、Schmidt Sciences、ACS 旗下 CAS 等,由它们把 Claude 额度分给研究者
  • 机构包括负责哈勃、韦布望远镜科学运营的 STScI,以及 Wellcome Sanger、Francis Crick、EMBL、Gladstone 等
  • 项目侧覆盖 gnomAD(汇集 80 万+ 人 DNA 数据)、FlyWire 果蝇全脑连接组、Lean 自动形式化数学库 Tau Ceti 等
  • 额度总金额、单笔规模与申请方式官方未公布;此前已推出面向科学家的折扣版 Team 计划
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Claude🌐 Anthropic

Axiom 用 AI Agent 集群 24 天完成「有限单群分类定理」Lean 全形式化:约 4310 万行代码,史上最长数学证明首次被计算机完整验证

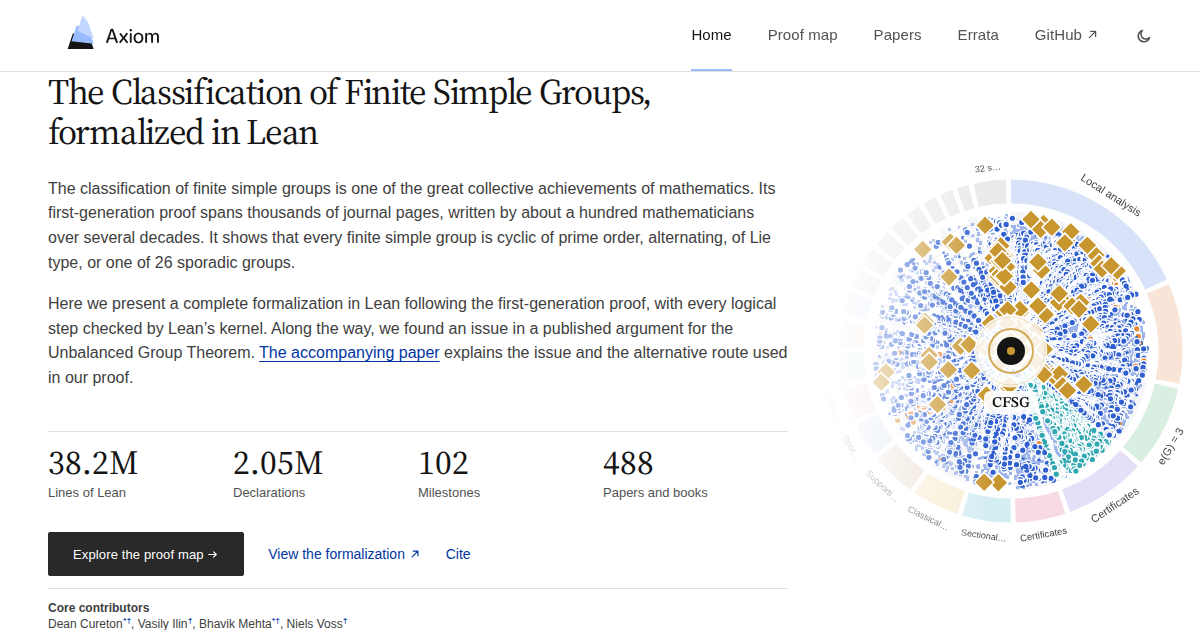
AI 数学公司 Axiom 10 月 27 日宣布,用数十个 AI Agent 组成的集群,在 24 天内把有限单群分类定理(CFSG,原证明约 1.5 万页、500 多篇论文、约 100 位数学家)完整形式化到 Lean 证明助手,产出约 4310 万行 Lean 代码、205 万条声明,并在 GitHub 开放仓库。过程中发现文献里 34 处值得注意的偏差,AxiomProver 还为「不平衡群定理」给出新的替代论证。

Axiom 用 AI Agent 集群 24 天完成「有限单群分类定理」Lean 全形式化:约 4310 万行代码,史上最长数学证明首次被计算机完整验证

核心要点速览

  • 官方口径:24 天、数十个 AI Agent 集群,产出约 4310 万行 Lean 代码、205 万条声明、100 个里程碑,引用 715 篇论文和专著
  • CFSG 原证明约 1.5 万页、500 多篇论文、约 100 位数学家,被称为「巨大定理」;这是它首次被计算机完整检查
  • 形式化暴露出文献中 34 处值得注意的偏差,最重要的是 Walter 1986 年不平衡群定理论证中的闭包断言存在反例(如 PSL₂(49))
  • AxiomProver 基于 Solomon 1976 年的理论给出替代论证,并证明新定理「Preservation of simple tops」,论文发布在 Hexagon(2610.00575)
  • 人类仍不可少:Richard Lyons、Ronald Solomon 等原 CFSG 学者参与审阅;勘误表将与群论专家顾问组持续公开
阅读全文
关联模型 / 智能体 / 厂商:
⚡ AxiomProver🌐 Axiom

Anthropic 公开内部 Claude 研究模型发现的 3-SAT 亚指数算法:论文与 Lean 4 证明称推翻指数时间假设(ETH)

Anthropic 在官方 GitHub 仓库 anthropics/formal-math 发布论文《A 2^o(n) Time Algorithm for 3-SAT》(署名 Claude, Anthropic)及 AI 编写的 Lean 4 形式化证明,称确定性算法可在 2^o(n) 时间内求解 3-SAT,从而推翻 ETH。Anthropic 员工 Levent Alpöge 在 X 上称核心算法由内部 Claude 研究模型于 10 月 16 日用 1400 万输出 token、无人工输入找到。仓库强调结果纯属渐近意义,对实际求解没有帮助。

核心要点速览

  • 论文称:确定性算法在 2^o(n) 时间内判定 n 个变量的 3-SAT,推翻 ETH;并在 2^O(n log log n / √log n) 时间内求解更难的计数问题 #3-SAT
  • 据 Levent Alpöge 的 X 帖:核心算法由内部 Claude 研究模型于 10 月 16 日发现,用了 1400 万输出 token、无人工输入,研究员随后与 Claude 一起改进论文表述
  • Lean 4 证明由 AI 模型编写,Lean v4.33.1 与 Mathlib 固定版本;README 称只依赖 Lean 三条标准公理,CI 还用独立内核 nanoda 复核
  • 仓库明确:结果纯属渐近意义,对实际求解 SAT 实例没有意义;目前仍待数学界独立审阅
  • 此前一天 OpenAI 也公布了其模型对 ETH 的反驳,两家结果目前都处于审阅阶段
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 公布内部模型三项新发现:称已证伪指数时间假设(ETH)、证明全维局部光滑化猜想,并给出 QCD 存在性证明

OpenAI 10 月 26 日发布博文,称其内部模型在数学、计算机科学和物理上各得到一项新结果:证明 Sogge 局部光滑化猜想在所有维度成立(进而推出 Kakeya 与 Stein 限制猜想);证明指数时间假设(ETH)为假,并已用 Lean 验证;给出四维 QCD 及含 Yang–Mills 在内的量子场论的严格存在性证明。数学和 CS 结果的论文与 Lean 证明已放到 GitHub 的 openai/math 仓库,物理结果由 David Gross 牵头的外部小组先行整理、暂不公开。这些都是官方口径,尚待学界独立验证。

OpenAI 公布内部模型三项新发现:称已证伪指数时间假设(ETH)、证明全维局部光滑化猜想,并给出 QCD 存在性证明

核心要点速览

  • 计算机科学(官方口径):论文给出一个确定性算法,在亚指数时间、多项式空间内精确计数定宽 CNF 公式的满足赋值,3-SAT 情形即证伪 ETH;AI 于 10 月 16 日得出证明,10 月 17 日完成 Lean 形式化
  • ETH 由 Impagliazzo、Paturi 和 Zane 提出,已被数百篇论文用作条件下界;验证小组由 Impagliazzo、Paturi(UC San Diego)和 Ryan Williams(MIT)牵头,OpenAI 承诺资助一场专题会议
  • 数学:证明局部光滑化猜想在所有空间维度 n≥2 成立,推出 Kakeya、Nikodym 极大猜想与 Stein 限制估计;此前仅有 2019 年的二维证明和 2025 年的三维 Kakeya 证明
  • 物理:Yang–Mills 存在性的自然语言证明 9 月 9 日完成、QCD 9 月 18 日完成,Yang–Mills 部分的 Lean 形式化 10 月 16 日完成;材料由 David Gross 等 5 人小组整理,暂不公开
  • OpenAI 称不寻求学术署名,外部参与者自愿、无报酬、不签保密协议;openai/math 仓库 10 月 7 日曾因符号错误撤回 3 篇稿件,结论仍需独立核查
  • 物理结果后续(10 月 28 日):KITP 公布 Yang-Mills 工作组声明,委员会为 Michael Douglas、David Gross(主席)、Arthur Jaffe、Igor Klebanov、Nikita Nekrasov;Gross 10 月 16 日受 OpenAI 委托保管证明,委员会称对 OpenAI 不负任何责任,将先核对 Lean 形式化的定义与标准是否一致再公开 Lean 证明,确认正确后连同评估发布全部 1147 页证明;禁闭与质量间隙仍是未解难题
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Zerodha CEO Nithin Kamath 问开发者用免费的 Kite API 和 AI 编程 Agent 做了什么

印度券商 Zerodha 创始人兼 CEO Nithin Kamath 10 月 26 日在 X 上发帖,问大家在 Kite API 免费之后,怎么把它和 AI Agent 结合、做出了什么。他认为 Claude Code、Codex 等 AI 编程 Agent 让没有太多编程经验的交易者和投资者也能自己搭工具,并称 Zerodha 观察到因为这些编程 Agent,使用 Kite API 的人在变多。帖子约 10 小时内获得 2,200 多个赞、2,000 多次收藏和 200 多条回复。这是 X 上的讨论和 CEO 本人观点,不是新产品发布。

X 热议:Zerodha CEO Nithin Kamath 问开发者用免费的 Kite API 和 AI 编程 Agent 做了什么

核心要点速览

  • 互动量(截至 2026-10-26 21:08 UTC,X API 公开数据):约 18.3 万次浏览、2,256 个赞、2,039 次收藏、219 条回复、113 次转发
  • 观点来源:Zerodha 创始人兼 CEO Nithin Kamath(@Nithin0dha)本人原帖,称编程 Agent 正在带动 Kite API 使用量上升,Zerodha 未公布具体增幅
  • 定价(据 Zerodha 官方 API 页面):Personal 档免费,含下单、GTT、提醒、保证金计算和组合管理;Connect 档 ₹500/月,增加实时 WebSocket 行情和历史 K 线
  • 官方 SDK 覆盖 Python、Java、Node.js、C#/.NET、Go、Rust、PHP、C++ 共 8 种语言,便于让编程 Agent 直接生成调用代码
  • 讨论焦点:AI 编程 Agent 让「非程序员自己写交易工具」变得普遍,同时也把风控和自动下单的风险交到了个人手里
阅读全文
AD赞助内容

GitHub Next 发布 PDD Kit:面向 Coding Agent 的形式化规约证明套件,从数学上杜绝代码边角缺陷

微软 GitHub 旗下创新实验室 GitHub Next 正式发布 PDD Kit(Property-Driven Development Kit)。针对当前自主编程智能体(Coding Agents)虽然能写出通过基础单元测试的代码、但在边界复杂条件下依然频频崩溃的行业顽疾,PDD Kit 引入了基于形式化数学证明的属性驱动开发规范。系统不再依赖概率性或有限用例的样本测试,而是自动从数学上证明 AI Agent 生成的代码在所有可能输入(For Every Input)下均严格满足预设规约,从根本上杜绝潜在的运行时 panic、越界与逻辑回退,推动 Coding Agent 从“概率代码生成”跨越至“形式化保真交付”。

GitHub Next 发布 PDD Kit:面向 Coding Agent 的形式化规约证明套件,从数学上杜绝代码边角缺陷

核心要点速览

  • GitHub Next 发布 PDD Kit 形式化规约套件,利用形式化数学证明彻底终结 Coding Agent 代码边角隐患
  • 提出“全输入空间数学证明”(Proofs for every input)新范式,替代脆弱的有限单元测试用例抽样
  • 在复杂算法与系统内核重构中,完全消除传统 Agent 常见的死锁、越界与状态不一致崩溃
  • 为自主软件工程智能体从实验原型迈向银行、航空与系统级核心软件开发提供了坚实的工程验证底座
阅读全文

CMU 与复旦奠基循环架构理论 Hugging MoE:三明治拓扑破解参数重用瓶颈,8B 循环 MoE 媲美 32B 深层前馈模型

循环语言模型(Looped Language Models)通过在逻辑深度上反复复用物理 Transformer 块大幅缩减权重规模,但过往架构将循环位置、输入注入与隐状态设计深度纠缠。卡内基梅隆大学(CMU)与复旦大学联合发表 Looped Models Done Right 第一部分(arXiv:2610.23036)。团队提出“前奏-循环块-尾声(Prelude-Recurrent-Coda)”三明治架构,在 5000 亿 Token 严苛预训练中,仅含 8.0B 常驻/7.94 亿激活参数的 Huginn MoE 在 MMLU、GSM8K 与 MATH500 上全面追平 32.0B 常驻/32 亿激活的前馈 MoE 基线。

CMU 与复旦奠基循环架构理论 Hugging MoE:三明治拓扑破解参数重用瓶颈,8B 循环 MoE 媲美 32B 深层前馈模型

核心要点速览

  • CMU 与复旦大学联合发表循环模型奠基之作(arXiv:2610.23036),首次系统解耦循环位置、输入注入与隐状态设计
  • 提出“前奏-循环块-尾声(P8-R12^8-C8)”三明治拓扑架构 Huginn,打破传统均匀全量循环的表征崩溃瓶颈
  • 将原则推广至循环 MoE 架构,在 5000 亿 Token 预训练中,8.0B 常驻/7.94 亿激活参数的 Huginn MoE 性能全面打平 32.0B 常驻/32 亿激活的前馈基准
  • 常驻显存开销暴降 75%,为在 16GB~24GB 消费级显卡部署 30B 级高性能推理提供了坚实工程路线
阅读全文
关联模型 / 智能体 / 厂商:

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

针对大模型数学证明缺乏步骤级验证标签与上下文精确复制存在 LM Head 梯度瓶颈的两大难题,今日两项基础研究给出突破:NYU/UCLA/Stanford 联合推出 LeanPRM(arXiv:2610.17697),利用 Lean 4 证明助手自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注数据集,将 Qwen3-4B 步骤验证准确率从 48.2% 拉升至 74.7%(远超 PRM800K 的 60.3%);康奈尔大学提出复制粘贴语言模型 CPLM(arXiv:2610.19247),以仅约 3% 算力开销打破 LM Head 梯度瓶颈,使窗口仅 w=128 的滑窗模型追平全注意力困惑度并在 4 倍外推长度(16K)持续收益。

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

核心要点速览

  • LeanPRM 利用 Lean 4 证明器与语法错误过滤模型,全自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注过程监督集
  • 基于 LeanPRM 训练的 Qwen3-4B 验证器在 LeanPRM-Bench 上将步骤准确率从 48.2% 提升至 74.7%(大幅领先 PRM800K 训练的 60.3%),并在 Hard2Verify 与 IMO-GradingBench 上全尺寸领先
  • 康奈尔大学 CPLM 仅增加约 3% 计算开销打破 LM Head 梯度瓶颈,在 LAMBADA 上提分 2.5~4.0 分,且仅用 w=128 滑窗即可追平全注意力模型的困惑度
阅读全文
关联模型 / 智能体 / 厂商:

破解 GRPO 同质化坍缩!SERO 可执行先知续写使 ALFWorld 泛化暴涨 11.2 分,EDEN 锚定嵌入噪声令 AIME 2025 飙升 13.3 分

无 Critic 群组强化学习(GRPO 等)在长程 Agent 与高难数学推理中极易陷入“采样轨迹高度同质化、全组零奖励无梯度信号”的探索死局。今日两篇前沿论文从轨迹续写与输入嵌入两端破局:SERO(arXiv:2610.19397)从策略真实到达的状态恢复环境并执行多步 Oracle 续写,使 7B 模型在 ALFWorld 分布外泛化暴涨 11.20 个百分点;UNSW 提出的 EDEN(arXiv:2610.16105)在输入末尾追加单个锚定高斯噪声嵌入位,在同等采样预算下令 Qwen2.5-Math-7B 的 AIME 2025 Pass@256 飙升 13.33 个百分点(达 66.67%)。

破解 GRPO 同质化坍缩!SERO 可执行先知续写使 ALFWorld 泛化暴涨 11.2 分,EDEN 锚定嵌入噪声令 AIME 2025 飙升 13.3 分

核心要点速览

  • SERO 从当前策略真实到达的状态恢复环境并执行多步 Oracle 可执行续写,使 7B 模型在 ALFWorld 分布外泛化成功率暴涨 11.20 个百分点(达 87.50%,分布内达 95.57%)
  • UNSW 提出的 EDEN 在不增加采样预算的前提下,通过追加单个锚定高斯噪声嵌入位,在 16 条采样预算下全面击败 32 条采样预算的标准 GRPO
  • 在奥赛级基准 AIME 2025 上,EDEN 将 Qwen2.5-Math-7B 的 Pass@256 从 53.33% 飙升至 66.67%(净增 +13.33 分),显著拓宽多路径推导覆盖率
阅读全文
关联模型 / 智能体 / 厂商:

HF 热榜双雄:Waypoint-OPD 门控策略蒸馏横扫代码数学六大设定,FDE-Gym 揭示 AI 驻场交付“最后一公里”仅 14/95 通关

今日 Hugging Face 每日论文榜前排由两项重磅研究领跑:获 451 赞榜首的《Waypoint-OPD》(arXiv:2610.21601)利用教师模型在强化学习过程中的中间检查点(Waypoint),根据早晚期策略偏移方向一致性对在线蒸馏施加门控,在 Qwen3-8B/14B/30B-A3B 代码与数学六大蒸馏设定中全线夺冠;获 230 赞的《FDE-Gym》(arXiv:2610.22350)首次构建面向驻场工程师(Forward-Deployed Engineer)真实客户交付的 95 任务基准,揭示顶尖智能体在需要挖掘隐性约束的真实交付中仅能圆满解决 14/95 项任务。

HF 热榜双雄:Waypoint-OPD 门控策略蒸馏横扫代码数学六大设定,FDE-Gym 揭示 AI 驻场交付“最后一公里”仅 14/95 通关

核心要点速览

  • Waypoint-OPD 登顶 HF 热榜(451 赞):引入 RL 中间检查点检验早晚期策略偏移方向一致性,在 Qwen3-8B/14B/30B-A3B 代码与数学 6 大蒸馏设定中全线第一
  • FDE-Gym 首测 AI 驻场工程师交付力(230 赞):覆盖 18 个行业 95 个真实客户交付任务,融合利益相关者沟通与生产系统实操
  • 揭示‘最后一公里’残酷差距:面对需主动挖掘隐性约束的真实交付场景,当前最强智能体配置平均仅得 0.56 分,95 项任务仅圆满通关 14 项
阅读全文
关联模型 / 智能体 / 厂商: