AI 编程实时动态与要闻

X 热议:微软 AI CEO Mustafa Suleyman 发长文《不要造有意识的超级智能》,称训练中若出现意识应全面暂停 AI 开发

微软 AI CEO Mustafa Suleyman 11 月 1 日在 X 上发布长文《Don't build conscious superintelligence》,回应外界对他 9 月「模型福利」文章的反应。他澄清「AI 没有意识」用的是现在时:今天没有,也必须保持如此;若训练中开始出现意识,他会呼吁所有人停止 AI 开发,直到能把这些属性设计掉。他还说 AI 开发者无权创造新的有意识物种,福利关注应放在人类、动物和自然环境上,同时称赞 Anthropic 公开宪法和研究的透明度,但表示不同意其做法。帖子约 353 赞、251 收藏、29 万浏览,引来伦理学者和从业者正反两方讨论。这是个人观点,不是微软的产品或政策公告。

X 热议:微软 AI CEO Mustafa Suleyman 发长文《不要造有意识的超级智能》,称训练中若出现意识应全面暂停 AI 开发

核心要点速览

  • 原帖:@mustafasuleyman 11 月 1 日长文,15:22 UTC 发布,约 353 赞、56 转发、79 回复、251 收藏、29 万浏览(抓取时)
  • 这是对他 9 月 16 日《是时候谈谈模型福利》(约 1,013 赞)一文反响的回应,作者 X 简介为微软 AI CEO、《The Coming Wave》作者、DeepMind 与 Inflection 联合创始人
  • 核心主张:「AI 没有意识」指的是现在,并且必须保持如此;若有证据表明 AI 已有意识,应立即公开;若训练中出现意识,应全面暂停开发
  • 他称赞 Anthropic 公开宪法和一系列论文、博客的透明度,但明确表示不同意其做法,并呼吁各实验室在这方面合作研究、共享安全信息
  • 引用帖中,UMass Amherst 经济与伦理学者 Itai Sher 称「说得很好」;UCL 教授 Tim Colbourn 认同但不认为能「默认把安全设计出来」,也有人指出目前没有公认的意识理论或检测方法
阅读全文
关联模型 / 智能体 / 厂商:

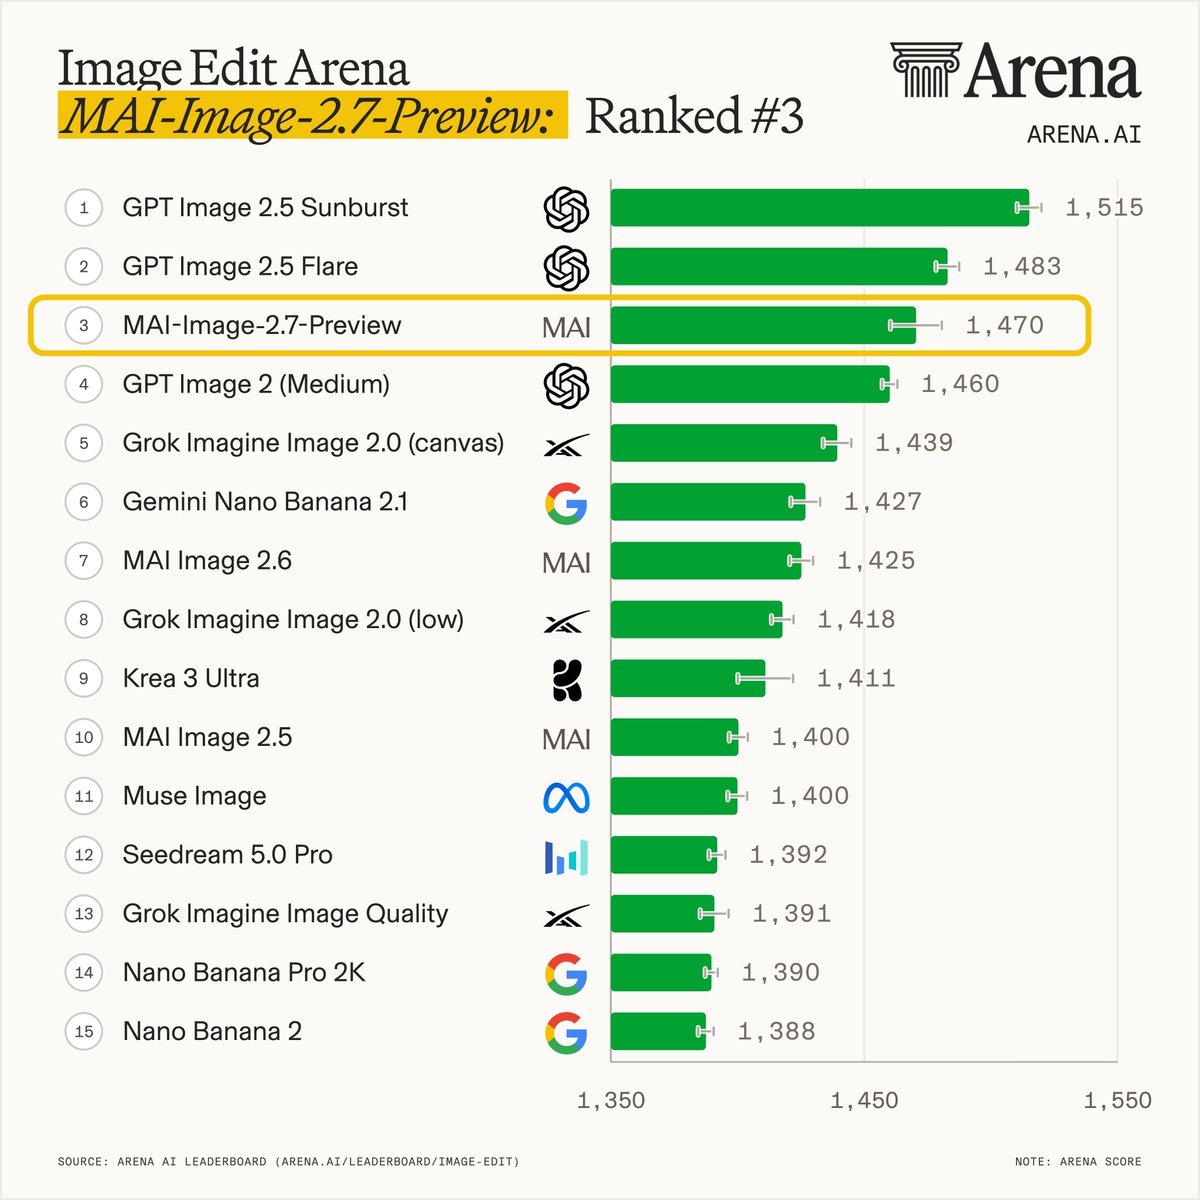
微软 MAI-Image-2.6 与 2.6-Flash 在 Microsoft Foundry 正式 GA,新一代 MAI-Image-2.7-Preview 登上 Image Edit Arena 第 3

微软 AI 10 月 27 日宣布 MAI-Image-2.6 和 MAI-Image-2.6-Flash 在 Microsoft Foundry 正式商用(GA),支持最多 5 张参考图的多图编辑、Bing 联网 grounding 和最高 1.5K 输出,并公布按 token 计价。同一天,新一代图像编辑模型 MAI-Image-2.7-Preview 以 1470 分登上 Arena 图像编辑榜总榜第 3(比 2.6 高 45 分),目前只能在 MAI Playground 做图像编辑。

微软 MAI-Image-2.6 与 2.6-Flash 在 Microsoft Foundry 正式 GA,新一代 MAI-Image-2.7-Preview 登上 Image Edit Arena 第 3

核心要点速览

  • MAI-Image-2.6 和 2.6-Flash 在 Microsoft Foundry 正式 GA,Adobe Firefly 也将「很快」接入 2.6(官方口径)
  • 官方定价:2.6 为文本输入 $5、图像输入 $8、图像输出 $38 / 百万 token;Flash 为 $1.75 / $2.50 / $19
  • 2.6 支持最多 5 张参考图的多图编辑、Bing 联网 grounding、动态宽高比和最高 1.5K 输出
  • Arena 数据:MAI-Image-2.7-Preview 以 1470 分列 Image Edit Arena 总榜第 3,比 2.6(第 7)高 45 分,微软在实验室排名中列第 2
  • Artificial Analysis 数据:2.7-Preview 在 AA-Image-Editing v2.1 排第 2,7 项编辑动作全部超过 2.6,其中 4 项排第 1
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI-Image-2.6⚡ MAI-Image-2.6-Flash⚡ MAI-Image-2.7-Preview🌐 Microsoft🌐 Microsoft AI

微软 MAI-Base-2 完成预训练:2.8T 总参 / 80B 激活 MoE,1.6 万张 GB200 跑 38 天,官方称预训练算力效率为 DeepSeek-V4-Pro-Base 的 4.2–12.3 倍

Microsoft AI 于 2026-10-15 发布技术博客与 PDF,宣布完成自研基座 MAI-Base-2 的预训练:每层 MoE(1 个共享 + 512 选 7 路由专家),80B 激活 / 2.8T 总参,102 层,原生无编码器视觉,50T token 训练混合、知识截止 2026 年 3 月。官方口径:在自建/外包的留出集 BPB 上低于所有参测开源模型,预训练 FLOPs 效率为 DeepSeek-V4-Pro-Base 的 4.2–12.3 倍。模型仍在后训练中,暂无 API、权重或发布日期,微软计划经 Foundry 向受信伙伴授权权重。

微软 MAI-Base-2 完成预训练:2.8T 总参 / 80B 激活 MoE,1.6 万张 GB200 跑 38 天,官方称预训练算力效率为 DeepSeek-V4-Pro-Base 的 4.2–12.3 倍

核心要点速览

  • 规模:80B 激活 / 2.8T 总参,102 层、隐藏维 8704,每层都是 MoE(1 共享 + 512 选 7);MAI-Base-1 为 35B / 1T、78 层、稠密与 MoE 交替(技术 PDF)
  • 算力:16k 张 GB200、2026 年 8–9 月共 38 天,平均 MFU 21%(按 BF16 2.5 PFLOPS 归一)、goodput 89%;Muon 优化器步仅占迭代时间 2.1%(165 ms)
  • 效率(厂商口径,基于缩放律估算):达到 DeepSeek-V4-Pro-Base 同等 BPB 所需 FLOPs 少 4.2–12.3 倍;相对 6 月的 MAI-Base-1 配方提升 6.3–12.7 倍
  • 数据:50T token 训练混合,VLM 数据占 18%(4.5T 唯一 token),唯一 token 比 Base-1 多约 36%,宣称全部为有机数据、不蒸馏其他模型
  • 可用性:仍在后训练,无公开 API/权重/日期;计划经 Microsoft Foundry 向受信伙伴授权权重,MAI-Base-3 已在筹备(官方博客)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI-Base-2⚡ MAI-Base-1⚡ MAI-Thinking-1⚡ DeepSeek-V4-Pro-Base⚡ Kimi K3⚡ Qwen3.8-2.4T-A95B🌐 Microsoft🌐 NVIDIA🌐 DeepSeek