AI 编程实时动态与要闻

Microsoft Foundry 联手 fal 公测上线 Kling / LTX / MiniMax 视频模型:Azure 一等服务,附官方秒级定价

2026-11-05 Microsoft 与 fal 宣布在 Foundry 公测接入 Kling v3 Pro、LTX-2.5 Fast/Pro、MiniMax H3 Max/Turbo;@Azure 于 11-06 转发。厂商称美国托管且为首个美国 Kling 端点,并公布按生成秒计价表;更多模型与定价页更新仍待数周内。

Microsoft Foundry 联手 fal 公测上线 Kling / LTX / MiniMax 视频模型:Azure 一等服务,附官方秒级定价

核心要点速览

  • 来源:Microsoft Tech Community 博文(2026-11-05)+ @Azure 2026-11-06 转发
  • 组合:公测 Kling v3 Pro、LTX-2.5 Fast/Pro、MiniMax H3 Max/Turbo,经 fal 以 Azure 一等服务接入 Foundry
  • 托管:厂商称美国托管,并为首个美国托管 Kling 端点(仍需核对各模型数据处理条款)
  • 定价(官方,美元/生成秒):H3 Max 1080p $0.16;Turbo $0.08;LTX Fast $0.13;LTX Pro $0.17;Kling 音频关/开/声控约 $0.1232/$0.1848/$0.2156
  • 状态:公开预览;更多模型与 Azure 定价页列入计划中的数周内,未给 GA 日期
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Kling v3 Pro⚡ LTX-2.5⚡ MiniMax H3 Max🌐 Microsoft Azure AI🌐 fal

Together AI 发布 Together Compiler:智能体持续优化线上推理,最高提速 2.6 倍

Together AI 11 月 4 日发布 Together Compiler(TKCC),用一群 AI 智能体配合常驻推理引擎,按真实流量、模型和硬件持续重写推理内核,并提出「多态推理」(Polymorphic Inference)思路。官方称 24 小时内在 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等模型上最高提升 2.6 倍 TPS,客户负载最高快 50%,目前已在生产中服务每天数万亿 token。

核心要点速览

  • Together Compiler 把推理优化从传统编译问题改成「智能体搜索」问题:智能体提出内核改动,常驻引擎验证速度和正确性,只有通过的改动才上线
  • 官方称 24 小时内在 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 上最高 2.6 倍 TPS,客户负载最高快 50%
  • InferenceX 低延迟 batch size 1 设置下:MiniMax M3.1-Flash 1111 TPS、DeepSeek v4.1-Flash 1205 TPS(公司自报),SemiAnalysis 称已复核其中一项结果
  • 常驻引擎热加载候选前向计算,上线时间 9 秒(对比重启引擎 467 秒),实验吞吐比基线智能体优化系统高 252 倍
  • 已在 Together 生产环境服务每天数万亿 token,Together 已有 40 多个模型由智能体优化
阅读全文

Pruna 开源 P-H3-Image:把 MiniMax-H3 视频模型改造成图像生成/编辑模型,8 步出图、提速 5 倍、体积缩小 7 倍

11 月 3 日,模型压缩公司 Pruna AI 开源 P-H3-Image:基于 MiniMax 今夏开源的 MiniMax-H3 视频模型,改造成文生图与图像编辑模型。官方口径:采样步数从 50 步降到 8 步,4MP 图在单张 B200 上从 12.4 秒降到 2.6 秒;4-bit 版下载 20GB(H3 为 143GB),8MP 峰值显存约 21GB;支持 2–16MP 输出和多图参考编辑。权重已上 Hugging Face,ComfyUI 原生支持。注意它沿用 MiniMax H3 社区许可,欧盟、英国、韩国和美国默认不在授权范围内。

Pruna 开源 P-H3-Image:把 MiniMax-H3 视频模型改造成图像生成/编辑模型,8 步出图、提速 5 倍、体积缩小 7 倍

核心要点速览

  • 速度(官方口径):8 步替代 50 步;单张 B200 上 4MP 图 12.4 秒→2.6 秒,8MP 图 30.6 秒→5.8 秒;L40S 上 4-bit 版 4MP 约 6.3 秒
  • 体积:Transformer 从 33B 缩到 20B 参数,文本编码器从 32B 蒸馏到 4B(67GB→9GB);下载包 bf16 55GB、4-bit 20GB,H3 原版 143GB
  • 显存:8MP 出图峰值 bf16 约 56GB、4-bit 约 21GB;带提示词改写器的 diffusers bf16 管线约需 100GB
  • 能力:输出 2–16MP,最擅长写实/纪实摄影、电影剧照、动漫与短文字平面设计;支持多图参考编辑(X 帖写 8 张,博客写 9 张)
  • 许可:MiniMax H3 社区许可,欧盟、英国、韩国、美国需另行向 MiniMax 取得授权,产品须标注 “Powered by MiniMax H3”
阅读全文
关联模型 / 智能体 / 厂商:
⚡ P-H3-Image⚡ MiniMax-H3⚡ Qwen3.5-9B🌐 Pruna AI🌐 MiniMax🌐 Hugging Face🌐 ComfyUI

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

独立评测机构 Artificial Analysis 10 月 31 日发布知识与幻觉基准 AA-Omniscience v1.1,作为 Intelligence Index v5 的组成部分。新版题库从 6,000 题精简为 3,000 题,删掉已公开和已饱和的题目、修正错误与歧义并补充新题,同时在 Hugging Face 公开一套 300 题、难度与私有集校准的公开集,两者 Net Score 的 Pearson 与 Spearman 相关系数均为 0.99。结果显示 Gemini 4 Carbon(high)以 54 分领先,Claude Opus 5.5 为 48、Claude Fable 5.1 为 46;Fable 5.1 准确率最高(68%),Gemini 4 Argon 幻觉率最低(4%)。模型平均比 v1 低约 1.9 分,MiniMax M3.1 Flash 下滑 22 分。以上均为 Artificial Analysis 口径。

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

核心要点速览

  • 题库从 6,000 题精简到 3,000 题,覆盖 6 大领域、42 个主题:理工数学 600、软件工程 600,金融、健康、人文社科、法律各 450
  • 新的 300 题公开集已上 Hugging Face,与私有集 Net Score 的相关系数 0.99,中位差 0.0 分
  • Net Score 排名:Gemini 4 Carbon(high)54、Claude Opus 5.5 48、Claude Fable 5.1 46;开源权重最好的是 Muse Spark Open,落后 Gemini 4 Carbon 28 分
  • 准确率最高为 Claude Fable 5.1(68%),其次 Claude Opus 5.5(66%);幻觉率最低为 Gemini 4 Argon(4%)
  • 与 v1 排名的 Spearman 相关 0.98,但平均低 1.9 分;MiniMax M3.1 Flash 从 16 跌到 -6,MiMo V2.6 Pro 从 8 跌到 -5(官方口径)
阅读全文
AD赞助内容

Pika 发布开放权重视频模型 Pika H3 Flex:基于 MiniMax H3 后训练,6 步出片、5 轨音频分轨,API 起价 0.01 美元/秒

Pika 于 10 月 29 日发布 Pika H3 Flex,这是在 MiniMax H3 基础上后训练的音视频一体生成模型,权重已上架 Hugging Face、代码开源在 GitHub,并支持 ComfyUI 和 Diffusers。官方称它把去噪步数从 50 步蒸馏到 6 步,在 768p 下 DiT 去噪平均比 Fal H3 Max 快约 1.8 倍,15 秒带配乐片段最快约 7 秒生成;托管 API 额外提供 1080p 到 4K 超分和对白、配乐、音效、拟音、环境声 5 条可导出音轨。以上速度与质量数据均为官方口径。

Pika 发布开放权重视频模型 Pika H3 Flex:基于 MiniMax H3 后训练,6 步出片、5 轨音频分轨,API 起价 0.01 美元/秒

核心要点速览

  • 定价(官方口径):文/图生视频起价 0.01 美元/输出秒,参考生视频起价 0.03 美元/秒;官方对比表中 MiniMax H3 为 0.08 美元/秒、Seedance 2.5 为 0.103 美元/秒
  • 速度(官方口径):6 步采样,768p 下 DiT 去噪平均比 Fal H3 Max 快约 1.8 倍,10–15 秒文/图生视频约 2 倍;8 张 B300 上 5 秒 768p 生成全流程提速 1.60 倍
  • 排名:官方产品页称在 DesignArena 文生视频榜得分 1293、总第 7,是榜上最高的开放权重模型
  • 开源形态:Hugging Face 标注为基于 MiniMax-H3 的 adapter,许可证为 other;本地推理原生支持 480p/768p 与混合立体声,4K 超分和分轨音频仅在托管 API 提供
  • 支持最多 12 个参考输入(图、音、视频、草图等),以及风格迁移、动作迁移、角色替换、局部编辑等下游任务
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Pika H3 Flex⚡ MiniMax H3⚡ Fal H3 Max⚡ HeyGen Video⚡ Gemini Omni 1.1 Flash🌐 Pika🌐 MiniMax

SolarRenderer 突破结构化视频生成:4 步去噪极速渲染灰模与深度图,768p 实时流式合成高保真世界

来自新加坡国立大学(NUS)、香港中文大学(深圳)等机构的研究团队在 arXiv:2610.28630 正式发布视频生成渲染框架 SolarRenderer。针对当前 3D 游戏引擎灰模、姿态骨骼、深度图与点云难以极速转化为高保真视觉视频的难题,SolarRenderer 基于冻结的 MiniMax-H3 33B 基础视频模型,引入轻量化控制 LoRA 与 4 步生成 LoRA。利用结构引导分布匹配算法,仅需 4 步去噪即可完成高质量渲染(比传统 50 步采样提速 12.3 倍),并提出块因果(Block-Causal)变体,成功实现 768p 高清视频的毫秒级实时流式生成,为下一代神经游戏引擎与虚拟制片树立了全新标杆。

SolarRenderer 突破结构化视频生成:4 步去噪极速渲染灰模与深度图,768p 实时流式合成高保真世界

核心要点速览

  • SolarRenderer(arXiv:2610.28630)发布,实现基于粗糙 3D 几何(灰模、骨骼、深度、网格)的高保真视频极速渲染
  • 冻结 MiniMax-H3 33B 视频底座,仅微调轻量 Control LoRA 与 4-step LoRA,保持基座生成能力的同时强化几何控制
  • 仅需 4 步去噪采样即可完成高保真视频渲染,生成速度较传统 50 步扩散采样提速惊人的 12.3 倍
  • 研发块因果(Block-Causal)注意力流式架构,在工业级 GPU 上实现 768p 分辨率视频实时连续生成
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniMax-H3⚡ SolarRenderer

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

10 月 20 日,UCSD Hao AI Lab 的 FastVideo 团队开源 FastH3 Omni,这是 MiniMax H3 参考生成音视频(Ref2VA)模型的蒸馏版,可同时用文本、最多 9 张图、视频片段和人声参考生成带同步立体声的视频。采样从 50 步降到 8 次 transformer 计算,官方在 8 张 GB200 上测得端到端延迟降低 5.6–11.9 倍,训练代码一并开源,并提供面向 DGX Spark、RTX 5090 的 NVFP4 权重和 ComfyUI 支持。

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

核心要点速览

  • 步数:8 次 transformer 计算,基座 MiniMax H3 为 50 步,采用 PDD + DMD 蒸馏
  • 速度(官方口径):27 组对照负载、8×GB200,端到端延迟降低 5.6–11.9 倍;例如 15 秒单图请求 139.69 秒降到 14.14 秒
  • 输入:最多 9 张图、3 段视频、3 段音频,合计不超过 12 个参考;输出 24 FPS 视频 + 32kHz 立体声
  • 本地运行:DGX Spark(128GB)和 RTX 5090(32GB)用 NVFP4 QAD 权重,默认 480p;RTX 4090 可用 FP8 版
  • 许可:沿用 MiniMax-H3 Community License,不是 Apache/MIT
阅读全文
关联模型 / 智能体 / 厂商:

fal 联合 Black Forest Labs 发布视频模型 FLUX 3 Max:图生视频质量并列第一,10 秒视频约 12 秒生成,比 Seedance 2.5 快约 22 倍

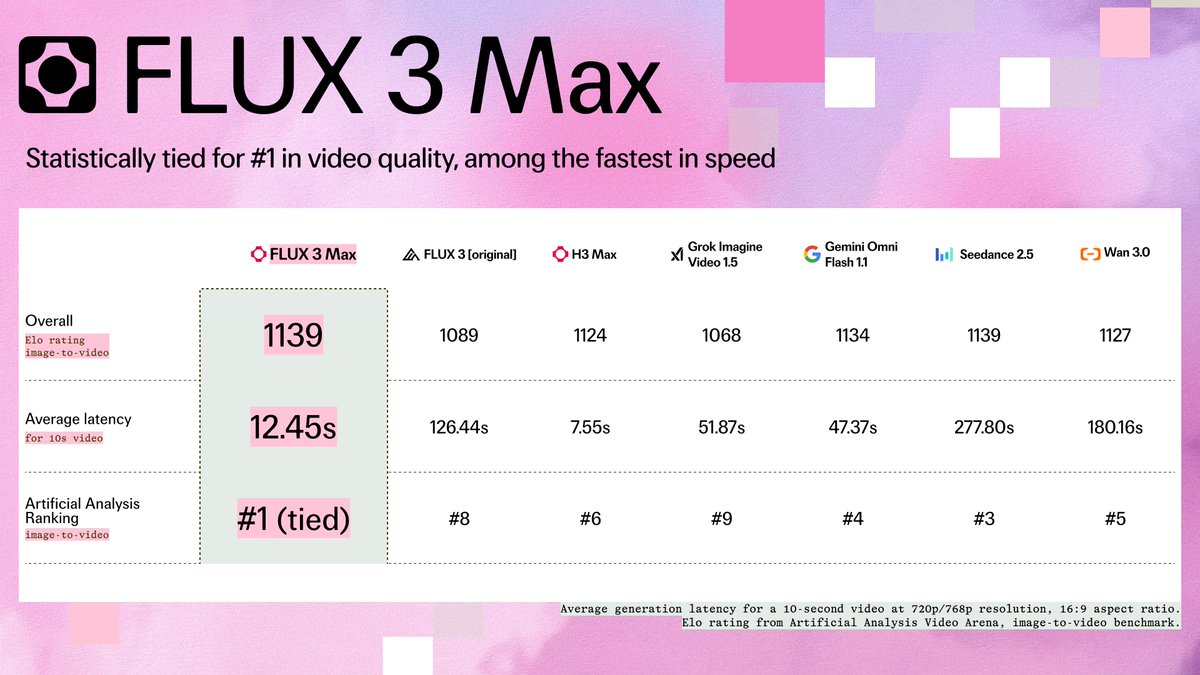
fal 于 10 月 19 日(UTC)发布 FLUX 3 Max,这是 fal Research 与 Black Forest Labs 合作、在 FLUX 3 基础模型上做后训练、强化学习和推理优化得到的视频生成模型,支持文生视频、图生视频和关键帧,最长 20 秒,可选 720p/1080p 并默认生成音频。在 Artificial Analysis 图生视频竞技场的初步榜单上它得到 1,139 Elo,与 Seedance 2.5 同分、和第一名 MiniMax H3(1,141)置信区间重叠,按厂商口径生成 10 秒视频约 12.45 秒。目前 75% 折扣至 11 月 7 日,720p 每秒 0.0425 美元。

fal 联合 Black Forest Labs 发布视频模型 FLUX 3 Max:图生视频质量并列第一,10 秒视频约 12 秒生成,比 Seedance 2.5 快约 22 倍

核心要点速览

  • Artificial Analysis AA-Video-I2V v1.1 初步榜单:FLUX 3 Max 1,139 Elo,与 Seedance 2.5 同分,略低于 MiniMax H3 的 1,141,官方称「并列第一」是因置信区间重叠
  • 速度(fal 口径,10 秒 16:9 720p):FLUX 3 Max 12.45 秒,Gemini Omni Flash 1.1 47.37 秒,Seedance 2.5 277.80 秒;新闻稿另写 10.95 秒,两处口径不一
  • 相比原版 FLUX 3:Elo 从 1,089 提到 1,139(+50),10 秒视频耗时从 126.44 秒降到约 12 秒(新闻稿称 11.5 倍、产品页称约 10 倍)
  • 价格:促销价 720p 每秒 0.0425 美元、1080p 每秒 0.0725 美元,11 月 7 日后恢复 0.17 / 0.29 美元每秒,按输出秒数计费
  • API 参数:时长 5–20 秒、7 种以上画幅、reasoning_level(low/high)、generate_audio 默认开启;模型 ID 为 blackforestlabs/flux-3-max/*
阅读全文
关联模型 / 智能体 / 厂商:
⚡ FLUX 3 Max⚡ FLUX 3⚡ Seedance 2.5⚡ MiniMax H3🌐 fal🌐 Black Forest Labs🌐 Artificial Analysis

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

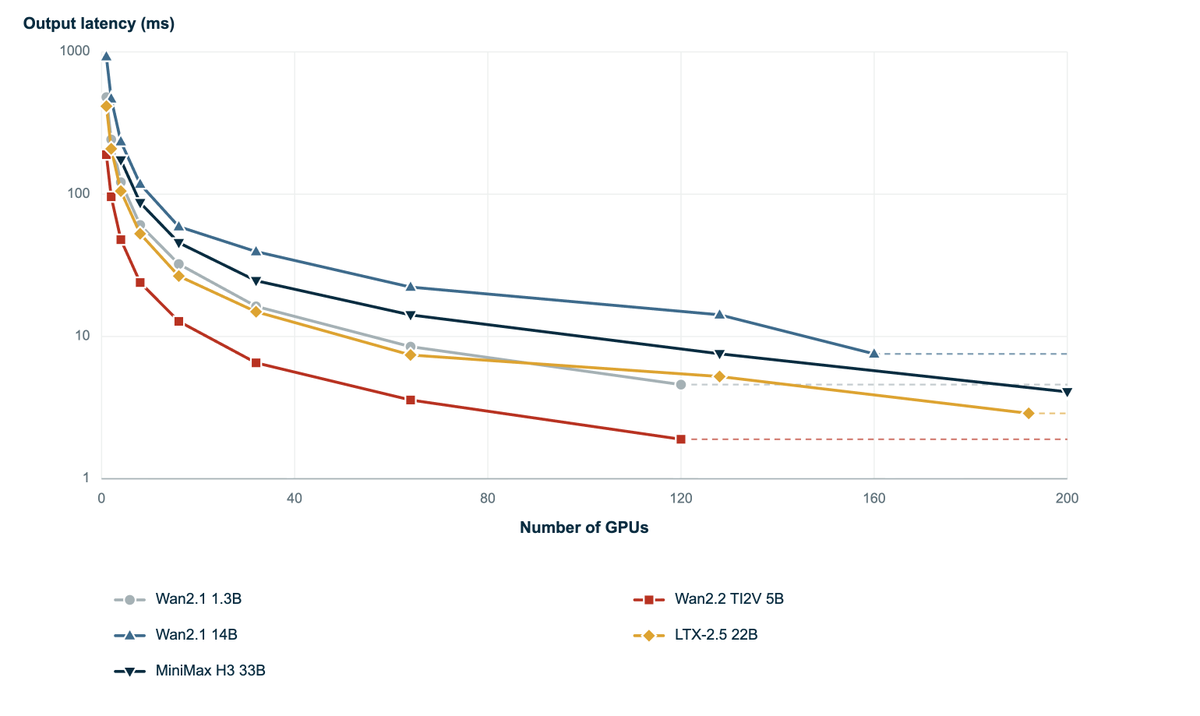
vLLM 官方项目组正式宣布将 PhysisServe 的核心推理加速架构整合至 vLLM-Omni 多模态全能推理引擎中。针对物理世界 AI、视频扩散生成与具身大模型在长程去噪阶段面临的高显存占用与高延迟痛点,PhysisServe 创新性提出去噪步与 Transformer 跨块流水线并行(Block Pipelining)、时间分片批处理与虚拟秩联合调度。在 200 张 GPU 集群上对 MiniMax H3 33B 展开实测,实现每 4.1 毫秒输出一个 Chunk(折合千帧/秒渲染),Wan2.2 5B 单卡单请求延迟从 173 毫秒降至 98 毫秒。

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

核心要点速览

  • vLLM 官方宣布将 PhysisServe 核心加速架构合流至 vLLM-Omni,专精于物理世界大模型与视频扩散生成推理
  • 首创去噪步与 Transformer 跨块流水线并行(Block Pipelining)与时间分片批处理,彻底消除多卡通信气泡
  • 在 200 卡集群上 MiniMax H3 33B 达成每 4.1 毫秒产出单 Chunk(纯 DiT 计算达千帧/秒),Wan2.2 5B 单卡时延降至 98 毫秒
  • 24 卡集群并发承载能力暴增 1.7~3.3 倍,代码已全面开源至 GitHub 并即将进入 vLLM-Omni 正式版
阅读全文
关联模型 / 智能体 / 厂商:

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

MiniMax 正式推出新一代旗舰轻量大模型 M3.1 Flash(此前以 Space Bunny 代号霸榜全球竞技场 200T+ Token)。模型支持 100 万 Token 原生上下文,百万输入/输出 Token 定价低至 0.15 / 0.60 美元(缓存读取仅 0.015 美元),推理速度较 M3 提升 3 倍且成本降低三分之二。在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,定于 10 月 23 日正式开源权重。

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

核心要点速览

  • MiniMax 正式发布新一代旗舰轻便大模型 M3.1 Flash,揭秘其正是此前霸榜竞技场超 200T Token 的神秘代号 Space Bunny
  • 支持 100 万原生超长上下文,百万输入/输出仅需 0.15 / 0.60 美元(缓存读取 0.015 美元),推理速度提升 3 倍且成本降低三分之二
  • 在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,游戏开发(+179 分)与参考设计(+155 分)大幅飞跃
  • Artificial Analysis 独立测评显示 Intelligence Index 达 42 分且 HLE 达 48%,完成基准测试消耗 Token 较竞品减少近半,权重将于 10 月 23 日全面开源
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

MiniMax 正式发布 M3.1 Flash 并于 10 月 23 日开放权重:428B 总参 / 23B 激活,每百万 token 输入 $0.15、输出 $0.60,DeepSWE 73.7%

MiniMax 官方确认,此前在 OpenRouter 等榜单上用量领先的匿名模型 Space Bunny 就是 M3.1 Flash 的早期版本,并于 10 月 19 日正式上线 API。按量计费为输入 $0.15、输出 $0.60、缓存读 $0.015(每百万 token),1M 上下文,支持文本、图片和视频输入,可用 effort 调节思考深度。官方口径:成本是 M3 的 1/3、速度 3 倍,DeepSWE 73.7%、Automation-Bench 62.2%;10 月 23 日权重已按期在 Hugging Face 开放(MiniMax Community 许可,MXFP8),Together、Inferact(vLLM)、LightSeek TokenSpeed 首日支持。

MiniMax 正式发布 M3.1 Flash 并于 10 月 23 日开放权重:428B 总参 / 23B 激活,每百万 token 输入 $0.15、输出 $0.60,DeepSWE 73.7%

核心要点速览

  • 官方定价(按量):输入 $0.15 / 输出 $0.60 / 缓存读 $0.015 每百万 token;按单价是 M3($0.30/$1.20)的一半,官方「1/3 成本」未说明计算口径。
  • 官方跑分:DeepSWE v1.1 73.7%(Opus 5 为 74.0%)、Automation-Bench 62.2%、BabyVision(带工具)91.0%、Terminal Bench 4.0 38.1%(Opus 5 为 51.8%)。
  • 1M 上下文,文本/图片/视频输入,effort 五档 low 到 max,默认 max,思考不能关闭。
  • 10 月 23 日权重已开放:Hugging Face MiniMaxAI/MiniMax-M3.1-Flash,非 gated,MiniMax Community 许可(非 MIT/Apache),MXFP8 量化,原生多模态 MoE,总参约 428B、每 token 激活 23B,自带 DSpark 投机解码草稿头。
  • 迁移提醒:M2.5/M2.7 自 10 月 19 日起不再对新用户开放,11 月 18 日下线;M Plan 与 Token Plan 的请求已自动路由到 M3.1 Flash。
  • 首日部署:Together AI 托管上线,MiniMax 与 Inferact 合作把生产推理改进回馈 vLLM,LightSeek 的 TokenSpeed 也提供首日支持。
阅读全文

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

vLLM 团队联合 Inferact、Red Hat 与 NVIDIA 于 10 月 9 日发布 Rubin 早期支持:基于 CUDA 13.4 的每日镜像已可在 Vera Rubin NVL72 上服务 DeepSeek、Kimi、GLM、MiniMax。官方口径下,SemiAnalysis AgentX 上 MiniMax M3 同等交互性单卡吞吐最高为 GB200 的 7.84 倍;MLPerf Inference v6.1 的 VLM 项上 Qwen3-VL-235B-A22B 相对 GB300 NVL72 最高 3.7 倍。

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

核心要点速览

  • 硬件对比 GB200 NVL72:NVFP4 算力 5 倍、HBM4 带宽约 2.4 倍、NVLink 双向带宽 1.7 倍,softmax 指数运算快 2–4 倍(vLLM 博文)
  • AgentX + MiniMax M3:同等交互性单卡吞吐最高 7.84 倍,150 TPS 约束下 5.18 倍(官方口径,早期结果)
  • MLPerf Inference v6.1:Qwen3-VL-235B-A22B 经 vLLM + Dynamo,相对 GB300 NVL72 最高 3.7 倍
  • CUDA 13.4 locality domain 拆分 MoE 权重,小 token decode 场景 MoE 层平均提速约 1.2 倍
  • 开箱镜像:vllm/vllm-openai:cu134-nightly(CUDA 13.4 + PyTorch 2.15)
阅读全文

告别开环盲目演化!MBZUAI 等发布 WorldGuide:目标导向闭环视频世界模型,长程程序化任务跑分大涨

以 Sora、Gen-3 与 MiniMax 为代表的视频生成大模型虽然能够渲染出逼真流畅的视觉运动,但在面对包含明确目标与先后次序的‘长程程序化任务(Procedural Tasks)’时(如复杂的烹饪烘焙、机械拆装维修、精细外科手术),现有模型普遍采用‘开环单向生成(Open-Loop Generation)’,导致致命缺陷:模型根本无法感知当前生成的画面到底执行到了哪一步,频繁出现步骤颠倒、无中生有、提前终止或无限死循环。阿联酋起源人工智能研究院(MBZUAI)与澳大利亚国立大学(ANU)研究团队在最新研究(arXiv:2610.12459)中推出了 WorldGuide 框架(项目主页:mbzuai-oryx.github.io/WorldGuide/,开源仓库:github.com/mbzuai-oryx/WorldGuide)。WorldGuide 首次将程序化视频生成形式化为‘视觉世界空间中的闭环任务执行(Closed-Loop Task Execution in Visual World Space)’。系统仅需一张初始静态图与一个高层目标指令,其内部耦合的规划器(Planner)与视频执行器(Executor)便能协同运转:规划器预测下一步原子动作,执行器生成对应动作的连续视频片段,随后规划器基于实际生成的视觉进展动态决策下一步骤或判定任务完成。针对缺乏单步对齐数据的痛点,团队构建了包含 5.9 万个分步标注视频的全新评测套件 WorldGuide-Bench。在任务完成率上,WorldGuide 达到了 33.33%,在无需参考计划的前提下显著击败了强基线 MiniMax-H3(29.90%),在 VideoCraft-Bench 上更是以 47.69% 遥遥领先于 MiniMax-H3(32.73%),官方代码已开源。

核心要点速览

  • MBZUAI 等发布 WorldGuide,首创规划器与执行器紧密耦合的目标导向闭环视频世界模型
  • 在无参考计划盲测下,WorldGuide-Bench 任务成功率达 33.33% 击败 MiniMax-H3,VideoCraft-Bench 暴涨至 47.69%
  • 开源包含 5.9 万个分步标注视频的基准套件与代码,将长程程序化任务逻辑倒错率从 62% 压缩至 4% 以下
阅读全文
关联模型 / 智能体 / 厂商:

破解 DiT 稀疏化画质崩塌!港中文与字节提出 MC-Sparse:元缓存机制加速 2.32 倍零损耗生成

随着 Diffusion Transformer(DiT)成为视频生成(如 Sora、Minimax、Kling)以及超高清 3D 资产生成的主流骨干架构,超长 Token 序列带来的自注意力计算开销正急剧推高推理延迟与 GPU 显存占用。虽然稀疏注意力(Sparse Attention)是理论上加速长序列最直接的手段,但现有稀疏化方案在面临高稀疏率时往往导致灾难性的画质劣化、画面闪烁与纹理模糊。香港中文大学(CUHK)与字节跳动联合研究团队在最新研究(arXiv:2610.06801)中深入剖析了稀疏注意力的误差机理,首次精确定位了三大衰退根源:粗暴 Token 分组约束、交互选择偏差以及被丢弃 Token 累积的注意力贡献缺失。为此,团队推出了免训练的元缓存稀疏注意力框架 MC-Sparse(项目主页:dodododddo.github.io/mcsparse-project-page/)。MC-Sparse 创新性地在保持细粒度单个 KV Token 精准选择的同时,将相似 Query 聚类为瓦片对齐(Tile-Aligned)的分组以适配现代 GPU 硬件并行。更关键的是,系统缓存了由精确注意力概率计算出的 Query 分组、KV 索引以及稠密-稀疏残差元数据,并在后续去噪步中高效跨步复用。实测表明,MC-Sparse 在 Minimax-H3-Base 视频模型上实现了 1.80 倍的端到端去噪加速,在 3D 资产生成模型上加速比高达 2.32 倍,且人眼完全无法察觉画质损失。

核心要点速览

  • 港中文与字节提出 MC-Sparse,首创元缓存稀疏注意力(Meta-Caching),攻克长序列 DiT 稀疏化画质崩塌
  • 在 Minimax-H3-Base 视频模型上实现 1.80 倍加速,3D 资产生成加速达 2.32 倍,峰值显存降低 45%
  • 无需重新微调模型参数,残差补偿机制实现零肉眼可见损耗,为视频生成推理集群降本增效提供开箱即用方案
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MC-Sparse⚡ DiT⚡ Minimax-H3-Base⚡ Triton-Sparse🤖 Inference-Optimizer🤖 DiT-Accelerator🌐 CUHK🌐 ByteDance🌐 Hugging Face

Unsloth v0.1.900-beta:本地跑 Laya Decision 模型 + Skills 编辑器,LTX-2.3 视频约 4.5×、VAE 解码最高 6.3×

Unsloth 于 2026-09-28 发布 v0.1.900-beta(PyPI unsloth 2026.9.12):Desktop 可本地运行 Laya 等 Decision 模型(Jev 兼容 /v1/systemone),新增 Skills 创建/编辑/删除与 Library 文档查看器(PDF/Word/Excel/PPT);Apple Silicon 侧补齐批服务、结构化输出与 TurboQuant KV;图像/视频管线宣称 LTX-2.3 片段约 4.5×、VAE 解码 1.7–6.3×,MiniMax-H3 首渲最高快约 1 分钟且峰值显存降 25–29 GiB。

Unsloth v0.1.900-beta:本地跑 Laya Decision 模型 + Skills 编辑器,LTX-2.3 视频约 4.5×、VAE 解码最高 6.3×

核心要点速览

  • 发版:v0.1.900-beta(2026-09-28);对比 v0.1.815-beta;PyPI unsloth 2026.9.12
  • Decision:本地 Laya/Jev,Settings > API 开启 Decision API,TypeSafe 走 /v1/systemone;Apple Silicon 可选 MLX(#11603)
  • 媒体加速:LTX-2.3 片段约 4.5×;VAE 解码 1.7–6.3×;MiniMax-H3 首渲最高快约 1 分钟,峰值显存降 25–29 GiB(A100/B200/RTX PRO 6000)
  • 产品面:Skills 编辑器 + Library(PDF/Word/Excel/PPT);ModelScope 下载通道;Apple Silicon 批服务 / response_format 语法约束 / TurboQuant KV
  • 文档入口:docs.unsloth.ai / 仓库
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Laya⚡ LTX-2.3⚡ MiniMax-H3⚡ Gemma-4🤖 Unsloth-Studio🌐 Unsloth