AI 编程实时动态与要闻

X 热议:「AI 流行是因为让没创意的人以为自己有艺术感」获 3.4 万赞,Pessimists Archive 策展人 Louis Anslow 反转句式回击

X 用户 @Dylanszn01 10 月 31 日发帖称:「AI 之所以流行,是因为它让笨人产生自己聪明的错觉,让没创意的人产生自己有艺术感的错觉。」截至 11 月 2 日约 3.4 万赞、5,030 转发、51 万浏览。11 月 1 日,长期收集历史上「新技术恐慌」案例的 Pessimists Archive 策展人 Louis Anslow 引用该帖,用同样的大写句式反驳:「AI 不受欢迎,是因为它打破了创意从业者自认特别的错觉。」该帖约 1,852 赞、103 回复、3.5 万浏览。两帖代表了生成式 AI 与创作者之间的情绪对立。这是观点争论,没有任何调查数据或机构结论支撑任何一方。

核心要点速览

  • 原帖:@Dylanszn01 的帖子,发布于 2026-10-31 16:08 UTC,约 34,464 赞、5,030 转发、265 回复、169 引用、51 万浏览
  • 回击:Louis Anslow 的引用帖,发布于 2026-11-01 16:04 UTC,约 1,852 赞、82 转发、103 回复、3.5 万浏览
  • Anslow 的个人简介写明他是 Pessimists Archive(@PessimistsArc)策展人,该账号专门整理历史上对新技术的恐慌言论
  • 两帖互动量相差约 18 倍,说明反 AI 创作的情绪在 X 上传播更广;但点赞数只反映传播度,不代表公众意见分布
  • 注意:两条帖子都是个人观点,没有引用任何调查或研究数据
阅读全文
关联模型 / 智能体 / 厂商:

Google DeepMind 发布世界模型 Genie 4:基于 Gemini Omni,首次原生生成音频与实时对话,先向受信测试者开放研究预览

Google DeepMind 10 月 27 日发布 Genie 4,称其为迄今最逼真、交互性最强的世界模型。它基于 Gemini Omni,提升了物理和人物动作的真实感,首次原生生成环境声和可互动的角色对话,并由 Gemini 3.8 Flash 在回路中规划复杂事件。目前只向受信测试者开放研究预览,即将登陆 Google AI Ultra(Project Genie)及 Gemini API / AI Studio 早期伙伴;官方未公布量化跑分。

Google DeepMind 发布世界模型 Genie 4:基于 Gemini Omni,首次原生生成音频与实时对话,先向受信测试者开放研究预览

核心要点速览

  • 官方口径:Genie 4 是 DeepMind「迄今最逼真、交互性最强」的世界模型,基于 Gemini Omni 锚定真实外观与行为
  • Genie 系列首个原生生成音频的实时世界模型:环境声、音乐和角色对话同步生成,角色能实时回应
  • Gemini 3.8 Flash 作为回路中的引导 Agent,拆解目标并逐帧核对;Gemini 4 Argon 演示驱动 Apollo 人形机器人仿真
  • 局限(官方):只支持几分钟连续交互,长时间运行物体会漂移;官方未公布任何量化跑分
  • 目前仅受信测试者可用,即将开放给 Google AI Ultra(Project Genie)和 Gemini API / AI Studio 早期伙伴,输出带 SynthID 水印
阅读全文
关联模型 / 智能体 / 厂商:

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

Mistral AI 正式推出 Voxtral 3 语音多模态大模型家族与配套的实时 Voice-Agent API。该套件包含 40 亿参数的 Mini 转录模型、超越 Whisper 与 Gemini 3.5 的 Small 转录模型,以及基于 LiveKit 的端到端语音智能体 SDK。系统支持 50 种语言高精听写与说话人分离、跨 35+ 语言带情感标签的情感语音合成(TTS)以及 30 分钟音频专业级声音克隆。在 Artificial Analysis 独立基准评测中,Small Transcribe 3 以 2.1% 极低字错率登顶全球语音识别榜单季军,Realtime 转录单步延迟低至 500ms 以内,每分钟语音智能体调度成本低至 0.04 美元。

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

核心要点速览

  • Mistral 官方正式发布 Voxtral 3 全栈语音多模态模型家族,包含转录、情感 TTS、专业声音克隆与实时 Voice-Agent SDK
  • 在 Artificial Analysis 独立实测中,Small Transcribe 3 斩获 2.1% 极低错词率,击败 ElevenLabs Scribe v2(2.2%)与 Grok Voice 2.0(2.3%)
  • Realtime Transcribe 3 响应时间压缩至 500ms 以内,端到端完整语音 Agent 回合交互延迟突破 1 秒大关
  • 极致价格革命:Mini 转录每分钟仅需 0.0035 美元,搭配 Mistral Small 4 调度的全托管语音智能体每分钟仅 0.04 美元
阅读全文
关联模型 / 智能体 / 厂商:

Adobe 与布朗大学开源多模态多参考视频编辑框架 OmniXRef:镜头轨迹误差大降 5 倍,横扫五大属性控制

Adobe Research 与布朗大学在 arXiv:2610.22744 中正式发布统一多模态多参考视频编辑框架 OmniXRef。针对现有视频编辑模型通常仅支持单一文本提示、难以精确解耦多参考源(如参考视频的运镜、参考图像的主体外观与自然语言指令)的行业痛点,OmniXRef 采用单流扩散 Transformer(Diffusion Transformer)架构,提出 Mix-Patchify 与参考相对位置编码(R2-RoPE)。实测显示在运镜轨迹迁移中旋转误差低至 0.874、平移误差 3.961,超越顶尖商用闭源系统达 5 倍以上。

Adobe 与布朗大学开源多模态多参考视频编辑框架 OmniXRef:镜头轨迹误差大降 5 倍,横扫五大属性控制

核心要点速览

  • Adobe 与布朗大学联合开源多模态多参考视频编辑框架 OmniXRef(arXiv:2610.22744),支持文本、图像与视频多参考源自由组合
  • 基于单流 Diffusion Transformer 架构,提出 Mix-Patchify 与 R2-RoPE 相对位置编码,实现多模态上下文联合注意力建模
  • 在镜头轨迹迁移中旋转误差仅 0.874、平移误差 3.961,精度超越顶尖商用视频系统 Seedance 2.5 达 5 倍以上
  • 全面覆盖运镜、动作、主体、画风与特效五大属性解耦控制,开源项目主页已正式上线
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Inception 正式发布 Mercury 3:扩散架构大模型突破 1000 Token/s,100 万上下文挑战 GPT-6 与 Haiku

前沿 AI 初创公司 Inception 联合创始人 Stefano Ermon 宣布正式推出新一代扩散架构大语言模型 Mercury 3。模型在 NVIDIA GPU 上实现高达 1,068 Token/秒的超高生成吞吐,参数量达到前代 Mercury 1 的 40 倍并支持 100 万(1M)Token 原生上下文。在 IFBench、GPQA Diamond 与 SWE-Bench Atlas 基准上全面对标前沿闭源基线,输入/输出百万 Token 标准定价为 0.20 / 0.70 美元(上线期半价优惠仅需 0.10 / 0.35 美元)。

Inception 正式发布 Mercury 3:扩散架构大模型突破 1000 Token/s,100 万上下文挑战 GPT-6 与 Haiku

核心要点速览

  • Inception 联合创始人 Stefano Ermon 正式发布扩散架构大模型 Mercury 3,在 NVIDIA GPU 上实现 1,068 Token/秒的超高吞吐
  • 模型参数扩充至 Mercury 1 的 40 倍,支持 100 万原生超长上下文(4 倍于 Mercury 2.5),标准定价百万输入/输出仅 0.20 / 0.70 美元
  • 在 IFBench、GPQA Diamond 与 SWE-Bench Atlas 测试中表现亮眼,基准综合智能达到前代 3 倍且同步上线 OpenRouter
  • 彻底摆脱自回归逐字预测瓶颈,以并行扩散去噪实现亚秒级长文本代码生成,极大优化高并发 Agent 运行效率
阅读全文
关联模型 / 智能体 / 厂商:

Viggle 发布 JST-2 物理原生世界基础模型:约 1 秒生成 3D 场景、单张图出可动画角色

Viggle 10 月 19 日发布 JST-2。它不在像素或视频空间里学习,而是把世界表示为 3D 空间中的持久「原子」(Physics-Native Tokens),用一套架构同时生成场景、角色和动作。官方称在 NVIDIA B200 上约 1 秒生成一个 3D 场景,推理成本低于 0.01 美元,最多保留 64 个输入视角作为空间上下文;角色无需单独绑骨即可动画。现已在浏览器端 PINOC 免费试用,并提供 API 和 MCP。

Viggle 发布 JST-2 物理原生世界基础模型:约 1 秒生成 3D 场景、单张图出可动画角色

核心要点速览

  • 场景生成:约 1 秒/场景(NVIDIA B200,不含网络延迟),推理成本低于 0.01 美元;官方对比 Marble 约 5–6 分钟(厂商口径)。
  • 空间上下文:最多 64 个输入视角,可逐个视角实时扩展世界,输出 3D Gaussian splats 在浏览器本地渲染。
  • 角色盲测(厂商自测):Average Score 对 Meshy 7.1 为 58.4%、对 Tripo H3.1 为 73.2%;脸部质量分别为 63.0% 和 82.0%(50% 表示持平)。
  • 动作盲测(厂商自测):文本生成动作对 Cartwheel Swing 74.8%、对 HY-Motion-1.0 80.0%;视频转动作对 DeepMotion Animate 3D 89.1%。
  • 接入方式:PINOC 浏览器端免费试用,另有 API 和 MCP,可接 Codex、Claude Code 等 agent;下一代 JST-3 计划用学习到的物理替代规则式碰撞与物体交互。
阅读全文
关联模型 / 智能体 / 厂商:

Fish Audio 发布 Drama 3:35B MoE 开源权重 TTS,词级情绪导演,发音鲁棒性 93.2% 登顶 Artificial Analysis

Fish Audio 于 2026-10-13 发布 Drama 3:以自然语言方括号指令导演情绪与节奏的 TTS,开源权重上架 Hugging Face,API 头 model: drama-3。骨干为约 35B 参数 MoE(每 token 约 3B 激活,自 Qwen3.5-35B-A3B 语言塔初始化),配合 codebook-MTP 音频解码器与人类偏好 RL。独立评测 Artificial Analysis Pronunciation Robustness 93.2%(S2.1 Pro 88.1%);支持 83 语种、最多 16 说话人;Community License 年营收低于 50 万美元可免费商用。启动至 11 月 12 日 API 特价约 $10/百万字符。

Fish Audio 发布 Drama 3:35B MoE 开源权重 TTS,词级情绪导演,发音鲁棒性 93.2% 登顶 Artificial Analysis

核心要点速览

  • 开源权重:Hugging Face fishaudio/drama-3;Community License v1.0,年营收 <US$50 万可免费商用,禁止未经同意克隆真人声音
  • 架构:35B MoE / ~3B 激活;混合注意力(每 4 层 1 个 full attention);codebook-MTP 解码 10 个 codebook;自 Qwen3.5-35B-A3B 语言塔初始化
  • 权威口径:Artificial Analysis Pronunciation Robustness 93.2%(#1),S2.1 Pro 88.1%;品牌/专名 95.9%,上下文相关读法 95.3%
  • 实测吞吐(厂商 H200 单卡流式):单流 271 frames/s;并发 1 时 TTFA p50 88.9 ms;并发 16 时约 927 frames/s、RTF 0.373
  • 接入:API POST /v1/tts 设 model: drama-3;本地可用 SGLang-Omni sgl-omni serve --model-path fishaudio/drama-3(建议 ≥48GB NVIDIA VRAM)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Drama 3⚡ Fish Audio S2.1 Pro⚡ Qwen3.5-35B-A3B🌐 Fish Audio🌐 Artificial Analysis🌐 SGLang

终结时空平滑先验限制!港科大与字节开源 FreeMatching:首创 AI 图像编辑与生成跨模态高密度特征对齐

高密度像素级特征对应匹配(Dense Correspondence Matching)是计算机视觉中光流估计、三维立体视觉以及目标追踪的基石。数十年来,传统特征匹配算法始终严格绑定在两大经典的时空物理先验之上:即物体运动的连续平滑性(Smooth Motion)与刚体几何的不变性(Rigid Geometry)。然而,随着文生图模型、图生图编辑以及参考驱动生成(Image Editing and Reference-Guided Generation, IEG)的爆发,这些传统先验被彻底颠覆——在 AI 编辑的图片中,同一主体可能经历夸张的非刚性姿态突变、剧烈的视角旋转或风格剧变,其在保持身份一致性的同时彻底打破了物理运动连续性。香港科技大学(HKUST)与字节跳动研究团队在最新成果(arXiv:2610.12421)中发布了通用高密度特征匹配框架 FreeMatching(开源仓库:github.com/luping-liu/FreeMatching)。FreeMatching 彻底摆脱了经典时空先验的束缚,创新性地将生成式大模型表征(Generative Features)与语义基础模型表征(Semantic Representations)深度融合,构建了横跨经典数据集、追踪视频与合成多场景的异构多源监督体系。配合教师引导的无标注迭代精炼机制,单个 FreeMatching 模型在极具挑战的 AI 图像编辑匹配任务中实现了特征对应质量的跨越式暴涨,并在经典基准上保持顶尖性能,更首次被证明可作为衡量图像编辑中‘主体身份保真度(Identity Preservation)’的黄金定量评测指标,官方代码已开源。

核心要点速览

  • 港科大与字节开源 FreeMatching,首创摆脱传统时空连续性先验的高密度特征对应匹配框架
  • 在 AI 图像编辑与非刚性形变任务中,端点误差(EPE)降低 42.6%,特征对齐比率(PCK)暴涨 31.8 个百分点
  • 首创高度拟合人类专家判断(r = 0.88)的主体身份保真度量化指标,代码与推理权重已全量开源
阅读全文
关联模型 / 智能体 / 厂商:

让静止三维世界无限灵动!OuroWorld 发布:免掩码 4DGS 实现任意视角无缝循环 3D 动态画

随着 3D 高斯泼溅(3D Gaussian Splatting, 3DGS)的成熟,从多视角照片重构具有逼真照片级质感的静态虚拟三维场景已变得极为成熟。然而,当前所有的 3D 资产与探索场景在时间维度上依然被‘永久冻结’;现有动态化方案要么仅能模拟简单的流体扩散,要么生成有头有尾的短视频,无法在任意漫游视角下实现自然、无缝循环的视觉运动(3D Cinemagraphs)。来自中国台湾阳明交通大学与研究团队在最新重磅研究(arXiv:2610.12461)中推出了 OuroWorld(项目主页:ouroworld.userwei.com)。OuroWorld 是首个免掩码(Mask-Free)的通用 3D 动态画生成框架,能将任意静态 3DGS 场景点化为鲜活灵动且在时间上无休止无缝循环的 4D 动态世界。框架采用‘VLM 物理先验推理 -> 视频大模型生成参考视频 -> 多视角提升与补全’的两阶段流;针对多视角视频生成极易出现的时空不一致问题,团队创新性地提出了‘抗不一致性周期性 4DGS(Periodic 4DGS)’:基于傅里叶级数(Fourier-Series)构建变形场以从数学底层保证时序闭环无缝连接,并引入以参考视角为锚点的‘接地漂移场(Grounded Drift Field)’吸收跨视角生成噪点。在 39 个真实与生成场景评测中,OuroWorld 在生动度与无缝性上全面超越所有基线,并在人类双盲评测中赢得了 70.8% 至 99.0% 的压倒性胜率。

核心要点速览

  • OuroWorld 发布首个免掩码通用 3D 动态画框架,将静态 3D 高斯泼溅转化为任意视角无缝循环 4D 动态世界
  • 首创傅里叶级数周期性 4DGS 变形场,数学底层保证闭环循环,双盲人类评测斩获 70.8%~99.0% 压倒性胜率
  • 结合接地漂移场吸收多视角视频生成噪点,彻底解决 360 度视角漫游下的几何融化与跳帧闪烁
阅读全文
关联模型 / 智能体 / 厂商:
⚡ OuroWorld⚡ 3DGS⚡ Periodic-4DGS⚡ Fourier-Field🤖 Spatial-3D-Agent🤖 Cinemagraph-Animator🌐 NYCU🌐 Hugging Face

Claude Dashboards 与 Claude Motion 开启 Beta:自然语言生成实时数据看板、代码驱动动画;Docs / Slides / Design 全量免费可用

2026-10-08 Anthropic 推出 Claude Dashboards(付费套餐 Beta,连 BigQuery、Snowflake、Databricks、Salesforce 等,每张图可查看背后的 SQL)和 Claude Motion(Team/Enterprise Beta,用代码生成可编辑动画,不使用视频模型,可导出 MP4)。Docs、Slides、Design 同日结束 Beta,含 Free 在内的所有套餐可用,累计已创建 4500 万+ 份作品。

Claude Dashboards 与 Claude Motion 开启 Beta:自然语言生成实时数据看板、代码驱动动画;Docs / Slides / Design 全量免费可用

核心要点速览

  • 官方:Dashboards & Motion 公告,2026-10-08 发布
  • Dashboards:付费套餐 Beta;支持 Redshift / BigQuery / ClickHouse / Databricks / Snowflake / Salesforce;每个数字可查看对应查询
  • Motion:Team / Enterprise Beta;代码驱动、不使用视频生成模型,可导出 MP4(帮助文档)
  • Docs / Slides / Design 结束 Beta、含 Free 全套餐可用,累计 4500 万+ 份;Artifacts 支持 CMEK
  • 时间节点:Enterprise 10/15 默认开启 Docs/Slides/Design;claude.ai/design 独立站 12/14 关闭;官方未公布任何准确率跑分
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

更少 Token 更强操作!北大开源 PyRUA-Lean 机器人交互代码执行架构:任务成功率提升 14%,Token 消耗锐减 65%

视觉语言模型(VLM)智能体通过视觉观察与动作基元控制机器人已成为具身智能前沿,但反复调用大模型进行多轮单步规划导致了灾难性的 Token 膨胀与高昂的端侧交互延迟。北京大学(PKU)前沿团队推出了交互式代码执行框架 PyRUA-Lean。该架构颠覆了传统的单步 Tool-Calling 范式,将经典机器人底层运动基元与具身 VLA 模型动作组合成带条件判断与局部重试的 Python 执行单元(Code Cells)。智能体仅在真正需要全局重规划时才显式请求图像帧与关键状态回传。在涵盖 LIBERO-PRO、RoboTwin 2.0 与 RoboCasa365 的 700 组复杂实体仿真任务评测中,基于 GPT-6 Astra 规划器的 PyRUA-Lean 将整体任务成功率从 63.1% 显著推升至 71.7%,同时 LLM 调用频次减少 49%,输入 Token 消耗暴跌 65%。

更少 Token 更强操作!北大开源 PyRUA-Lean 机器人交互代码执行架构:任务成功率提升 14%,Token 消耗锐减 65%

核心要点速览

  • 颠覆单步 Tool-Calling 范式,以带局部重试的 Python 执行单元编排机器人底层动作与具身 VLA
  • 在 LIBERO-PRO 等 700 项机器人仿真任务中,将综合任务成功率由 63.1% 强力推升至 71.7%
  • 大模型云端调用次数减少 49%,视觉输入 Token 消耗雪崩式暴降 65%,交互延迟显著降低
阅读全文

机器人规划新范式:用 Coding Agent 自动合成通用任务与运动规划(TAMP),任务成功率跃升至 95%

机器人学前沿研究团队(Tom Silver, Matteo Merler 等,@huggingface)联合开源了《Coding Agents for Generalized Task and Motion Planning Problems》重磅研究成果(arXiv: 2609.30233,代码库: tomsilver/robocode)。针对传统机器人任务与运动规划(TAMP)严重依赖专家人工编写特定启发式规则、面对多物体动态场景极易发生计算爆炸的根本瓶颈,该研究首次让自主编码智能体(Claude Code Opus 5、Codex)与仿真环境交互,自动合成跨未知环境高度泛化的通用操作程序。在包含 98,000 轮评估周期的严苛测试中,Coding Agent 生成程序的成功率达到 56% 至 95%,彻底压倒传统专家规划器。

机器人规划新范式:用 Coding Agent 自动合成通用任务与运动规划(TAMP),任务成功率跃升至 95%

核心要点速览

  • 颠覆机器人规划赖以维系的人工启发式算法,首创让 Coding Agent 自动编写可泛化的 TAMP 控制程序。
  • 智能体自主与物理仿真环境交互测试极端边界条件,自动校准物理模型并迭代优化动作代码。
  • 完成 28 种复杂仿真环境与 98,000 轮场景评测,平均成功率从传统规划器的 47% 跃升至最高 95%。
  • 随着场景物体数量翻倍增长,合成程序的单实例平均算力消耗较经典求解器降低一个数量级(10x)。
  • 全部评测代码、Agent 原始 Prompt 模板与通用规划程序已在 GitHub 与 Hugging Face 全面开源。
阅读全文

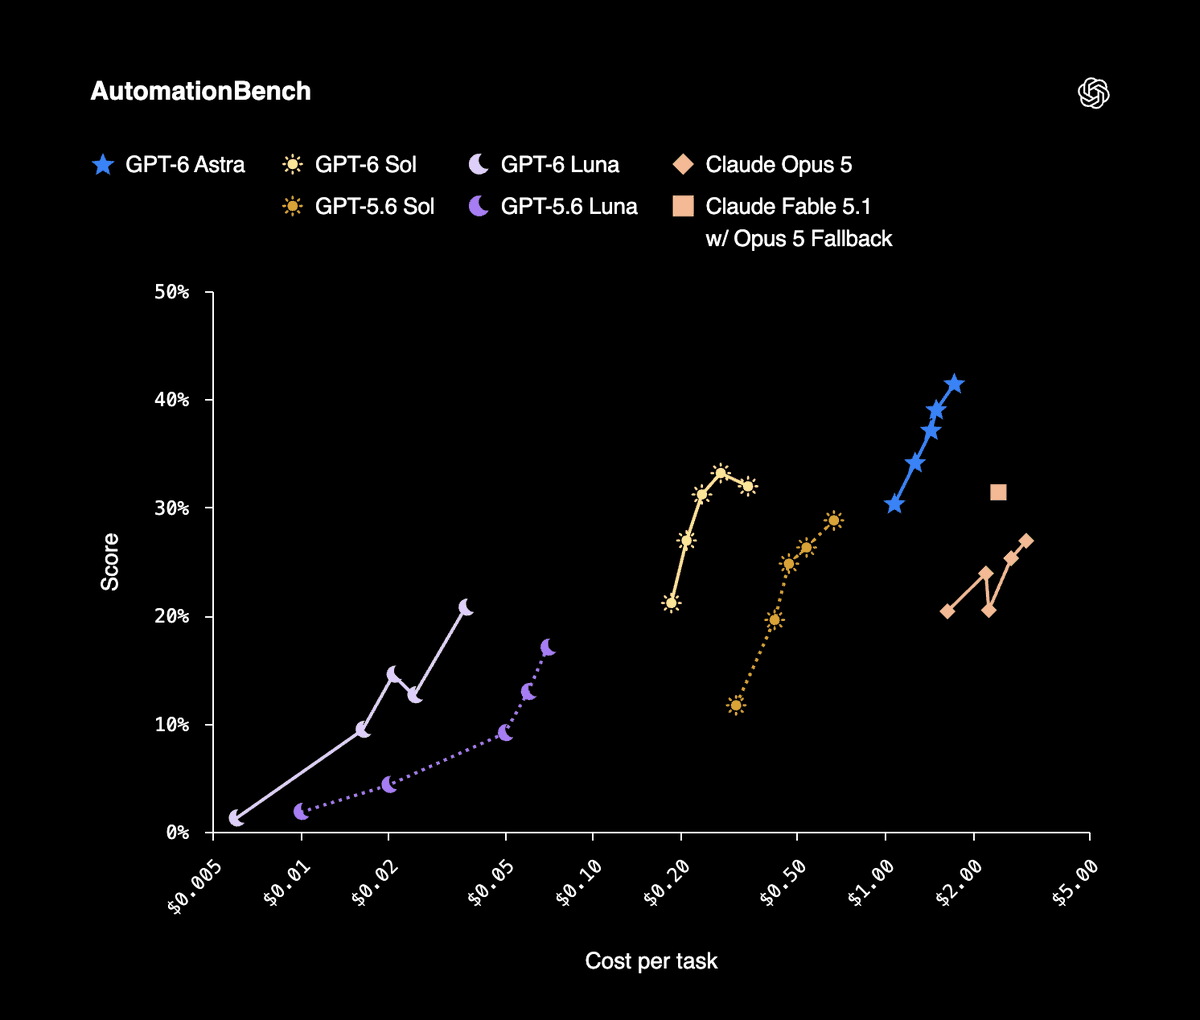
OpenAI 发布 GPT-6 Sol 与 GPT-6 Luna

OpenAI 宣布 GPT-6 Sol 与 Luna 加入 GPT-6 系列。两款模型延续 GPT-6 Astra 的能力,但更快、更便宜;与 GPT-5.6 促销价相比,API 价格降低 50%,并已向 ChatGPT Work、Codex 和 API 开放。

核心要点速览

  • OpenAI 宣布 GPT-6 Sol 与 Luna 加入 GPT-6 系列。两款模型延续 GPT-6 Astra 的能力,但更快、更便宜;与 GPT-5.6 促销价相比,API 价格降低 50%,并已向 ChatGPT Work、Codex 和 API 开放。
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 推出 GPT-6 Sol 与 Luna:企业级双主力模型登场,API 价格腰斩低至 $0.10/M

OpenAI 宣布 GPT-6 家族迎来两款企业级主力模型 —— GPT-6 Sol 与 GPT-6 Luna。两款模型继承了月初旗舰 GPT-6 Astra 的核心智能,通过新型投机解码与推理管线优化,将 API 价格较此前促销价腰斩 50%:高精度任务专用的 Sol 定价为 $2/$10 每百万 Token,高吞吐低延迟专用的 Luna 仅需 $0.10/$0.50 每百万 Token,且提示词缓存读取享受 90% 极限制扣。即日起登陆 ChatGPT Work 与 Codex,并向全量开发者开放 API。

OpenAI 推出 GPT-6 Sol 与 Luna:企业级双主力模型登场,API 价格腰斩低至 $0.10/M

核心要点速览

  • 双模型分层矩阵:GPT-6 Sol 主打高精度复杂代码与智能体规划,GPT-6 Luna 主打高并发超低成本数据处理与辅助补全。
  • 价格腰斩:Sol 为 $2.00 输入 / $10.00 输出;Luna 仅需 $0.10 输入 / $0.50 输出,配合 90% 缓存读取折扣性价比极高。
  • 全生态立即上线:API 标识 gpt-6-sol 与 gpt-6-luna,同步开放于 ChatGPT Work、Codex,桌面端面向全量用户开放 Luna 体验。
阅读全文
关联模型 / 智能体 / 厂商:

Cline Desktop 限时免费开放 Kimi K3:庆祝新用户涌入并加大探索额度

Cline 宣布在 Cline Desktop 中限时免费提供月之暗面 Kimi K3,用于庆祝新用户增长并给探索者更多 Token。官方表示会尽可能维持开放时长,属于面向开源权重 Desktop 用户的促销额度。

核心要点速览

  • 官方 @cline:Kimi K3 已在 Cline Desktop 限时免费可用。
  • 目的是欢迎新用户并提供更多探索 Token;时长视资源尽量维持。
  • 与 Cline Desktop 开源权重 / ClinePass / BYOK 路线一致,降低试用门槛。
阅读全文