AI 编程实时动态与要闻

微软开源 4B 电脑操作智能体 Mage-VL-Cowork:一个模型自己决定点界面还是写 bash,OSWorld-Verified 66.0%

微软 Mage 团队 10 月 30 日在 Hugging Face 以 Apache-2.0 发布 Mage-VL-Cowork:4B 参数的多模态电脑操作智能体,同一个模型每一步自己选择用截图点界面(computer_use)还是在终端跑 bash/Python,不需要外部调度器。官方报告它在 OSWorld-Verified(361 题、50 步上限)两次平均 66.0%,高于 Qwen3.6-27B 的 63.9%,但仍低于 9B 的 SCALECUA-Qwen3.5-9B(68.7%)。

微软开源 4B 电脑操作智能体 Mage-VL-Cowork:一个模型自己决定点界面还是写 bash,OSWorld-Verified 66.0%

核心要点速览

  • 4B 参数,基于 Mage-VL(Mage-ViT 视觉编码器 + Qwen3-4B-Instruct-2507),bf16 权重约 9.48 GB,Apache-2.0 许可。
  • OSWorld-Verified 两次独立跑分 65.33% 和 66.75%,取平均 66.0%;操作系统类任务 87.5%,多应用工作流 62.7%。
  • 官方对比:同一个 LibreOffice Calc 建图表任务,它用终端里的 Python 改表格 39 秒完成(6 步),纯界面操作的 Qwen3.6-27B 用了 9 分 56 秒(39 步)。
  • 在线 RL 比混合 SFT 再提升 10.16 个百分点,同时平均模型调用次数减少 13.0%、输出 token 减少 25.4%。
  • 训练数据由 Mage-CUA-Forge 生成约 29.4 万个桌面和网页任务,覆盖 6,915 种技能,单任务生成成本从 0.906 美元降到 0.158 美元。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Mage-VL-Cowork⚡ Mage-VL⚡ Qwen3-4B⚡ Qwen3.6-27B🌐 Microsoft

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

美团 LongCat 团队 11 月 2 日在 API 平台更新日志中上线 LongCat-2.5,这是 9 月 25 日 LongCat-2.5-Preview 的正式版。官方技术博客称它总参数 1.6 万亿、每个 token 激活约 480 亿,在 LongCat-2.0 基础上强化原生视觉理解和智能体编程,训练和 W4A4 推理都在国产 AI 加速卡上完成。官方口径成绩包括 Terminal Bench v2.1 88.4、Terminal Bench v4.0 38.5、BrowseComp 91.9、MCP Atlas 83.1。API 支持 OpenAI 和 Anthropic 两种格式,1M 上下文、最多 128K 输出,限时价每百万 token 输入 $0.30、缓存输入 $0.006、输出 $1.20。

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

核心要点速览

  • 规模:1.6 万亿总参数 MoE,每 token 激活约 480 亿;1M 上下文、最高 128K 输出(官方博客、API 文档)
  • 代码智能体(官方口径):Terminal Bench v2.1 88.4(Claude Opus 5 89.1、GPT-5.6-Sol 88.8)、Terminal Bench v4.0 38.5(GPT-5.6-Sol 37.3、Claude Opus 5 53.9)、DeepSWE v1.1 64.6
  • 通用智能体(官方口径):BrowseComp 91.9、MCP Atlas 83.1、AutomationBench v1.0.6 51.8、HLE w/tools 63.1;相比 LongCat-2.0 的 AutomationBench 15.8 大幅提升
  • 价格:限时每百万 token 输入 $0.30(¥2)、缓存输入 $0.006(¥0.04)、输出 $1.20(¥8)(定价页)
  • 工程:W4A4 推理相比 W8A8 基线预填充吞吐 +43.3%、解码吞吐 +42.77%;长序列 SFT 中 FSDP 单卡吞吐比 DDP 基线高 86%
阅读全文

沙特阿美完成收购 HUMAIN 49% 股权:PIF 保留 51%,2026 年注资约 26 亿美元现金,目标 2030 年 3GW AI 数据中心

沙特公共投资基金(PIF)与沙特阿美 11 月 1 日宣布交易完成:阿美通过全资子公司取得沙特 AI 公司 HUMAIN 49% 股权,PIF 保留 51% 控股。阿美除转入自有的 AI、算力和数字资产外,还将在 2026 年向 HUMAIN 注入约 99 亿沙特里亚尔(约 26 亿美元)现金。HUMAIN 计划到 2030 年部署 3GW AI 数据中心容量,并继续开发阿拉伯语多模态大模型 ALLaM。

核心要点速览

  • 股权:阿美 49%(经全资子公司持有)、PIF 51%,交易已于 2026-11-01 完成(阿美官方新闻稿)
  • 资金:2026 年现金注资约 99 亿沙特里亚尔(约 26 亿美元),另转入 AI、算力和数字资产(官方口径)
  • 算力目标:2030 年前部署 3GW AI 数据中心容量(官方口径)
  • 阿美称 2023 年以来「技术实现价值」达 113 亿美元,其中相当部分来自 AI 方案(阿美 CEO Amin Nasser,厂商口径)
  • HUMAIN 成立于 2025 年 5 月,业务覆盖数据中心、云平台、ALLaM 模型和行业方案四块
阅读全文
关联模型 / 智能体 / 厂商:

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

Mistral 10 月 29 日发布改进版 Mistral Large 4(Le Chonk)并开放权重,已上架 Hugging Face(另有 NVFP4 量化版),API 名为 mistral-large-4。相比 10 月初的公开预览,多做了约三周强化学习:官方口径 FrontierCode 2.0 得分 19.7%、Terminal-Bench 4.0 从 28% 升到 41%,并新增 low/medium/high 三档推理。许可证为改版 MIT,商用可用,但做模型即服务需另签商业许可。

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

核心要点速览

  • 规格:约 1T 总参数、每 token 激活 49B(含嵌入和输出层约 52B),128 个路由专家每次激活 4 个外加 1 个共享专家,1M 上下文,文本+图像输入
  • Mistral 口径:Cognition FrontierCode 2.0 得分 19.7%,高于 DeepSeek V4.1 Flash 的 19.3% 和 GLM-5.3 的 17.8%,开源模型第一
  • Artificial Analysis 编码智能体指数 48%,与 GLM-5.3 基本持平,但平均每任务少用 47% 的 token;Terminal-Bench 4.0 由预览版 28% 提升到 41%
  • Artificial Analysis Cyber Index 51%;对恶意网络安全请求的平均拒绝率 96.6%,官方称为开源模型中最高
  • 在 Mistral 自有欧洲数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练;Surge Code 盲评中仅次于 Claude Opus 5.5
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

2026-10-23(UTC 17:15,SGT 10-24 01:15),Kimi 官方账号 @Kimi_Moonshot 正式发布 Kimi K3.1 Pro,同时推出快 2–3 倍的 K3.1 Pro Highspeed,已在 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API 上线,完整权重承诺 2026-11-04 前开放。官方技术博客称它是 K3 的后训练版本(更大规模多领域联合 RL),MoE 总参 2.8T、激活 104B,1M token 上下文,多模态。厂商口径跑分:Terminal-Bench 4.0 65.7%(GPT-6 Astra 58.2%、Claude Opus 5.5 66.4%),BenchCAD 带工具 92.7%。Kimi API 定价页显示 kimi-k3.1-pro 输入 $2、输出 $10、缓存命中 $0.20 每百万 token,低于 K3 的 $3/$15。

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

核心要点速览

  • MoE 总参 2.8T、激活 104B,1M token 上下文,多模态;完整权重承诺 2026-11-04 前开放(官方博客)
  • 厂商口径:Terminal-Bench 4.0 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;内部 Kimi Code Bench 3.0 长程 61.2%(K3 为 55.95%)
  • API 定价:kimi-k3.1-pro 输入 $2 / 输出 $10 / 缓存命中 $0.20 每百万 token;Highspeed 版 $4 / $20(定价页)
  • 内部幻觉压力测试 Kimi Hallu Bench Hard:声明级幻觉率从 K3 的 23.4% 降到 8.3%(官方注明不代表日常错误率)
  • 开放权重版在中期训练和 RL 阶段移除了网络安全相关数据:xdev-bench-hard pass@3 从未处理版的 90.5% 降到 81.0%
阅读全文
关联模型 / 智能体 / 厂商:

微软亚研院开源 WildAWM:野外环境通用智能体世界模型,重构 GUI 与网页端到端仿真底座

微软亚洲研究院(MSRA)研究团队在 arXiv:2610.26828 正式发布并开源通用智能体世界模型 WildAWM(MSR-Orchard/WildAWM)。针对当前跨平台 GUI 与网页浏览智能体(Computer-Use Agents)在训练和评测中高度依赖昂贵、慢速且不可撤销的真实物理沙盒环境的痛点,WildAWM 首创可适应野外复杂异构环境的多模态自回归世界模型架构。模型能够在接收任意智能体动作(点击、输入、滚动)后,极其逼真地预测网页与桌面操作系统下一帧的高保真视觉状态演化与 DOM 结构变化,成功替代物理沙盒,为大规模自主智能体的离线强化学习与安全预演树立了全新基座。

微软亚研院开源 WildAWM:野外环境通用智能体世界模型,重构 GUI 与网页端到端仿真底座

核心要点速览

  • 微软亚研院在 arXiv:2610.26828 开源 WildAWM,首创面向真实野外复杂环境(桌面/Web)的智能体世界模型
  • 彻底破解 GUI 智能体训练依赖真实物理服务器与网页环境造成的昂贵算力开销和状态破坏风险
  • 基于动作条件(Action-Conditioned)的多模态自回归架构,精准仿真点击、键盘输入与长页面滚动后的视觉响应
  • 在跨电商、CRM 与操作系统多项仿真一致性评测中大幅超越传统离散状态转移模型,全面开源代码与权重
阅读全文

NVIDIA 集中发布 Nemotron 3.5 开源模型矩阵:涵盖超强检索、物理世界大模型与 13 倍速蛋白质设计

在 GTC Berlin 开幕主题演讲中,NVIDIA 官方集中发布了横跨多个专业垂直领域的全新开源模型矩阵。核心亮点包括:支持长文本视觉推理的 Nemotron 3.5 Super VL 与即开即用的 Bolt 系列语言模型;专为高精度 RAG 打造的 Nemotron Retriever 嵌入、重排与文档解析全套套件;面向实体工业的 Cosmos 物理世界模型;面向自动驾驶的 Alpamayo 2 Edge;以及与华盛顿大学 Baker 实验室联合开发的蛋白质生成大模型 BioNeMo RFD4-Proteina。官方实测显示,RFD4-Proteina 在 10 项以上蛋白质设计基准中斩获全球第一,在 200 个氨基酸的靶点设计上比 RFdiffusion3 提速惊人的 13 倍。

NVIDIA 集中发布 Nemotron 3.5 开源模型矩阵:涵盖超强检索、物理世界大模型与 13 倍速蛋白质设计

核心要点速览

  • NVIDIA 在 GTC Berlin 集中开源全栈垂直基础模型:包含 Nemotron 3.5 Super VL、Bolt 4GB 端侧版与 Cosmos 物理世界模型
  • 发布 Nemotron Retriever 全套套件,将企业级 RAG 检索、跨模态重排与复杂 PDF 版面解析的准确率推至行业前列
  • 与顶尖 Baker 实验室联合开源 BioNeMo RFD4-Proteina,在 10 余项蛋白质靶向结合任务中登顶全球性能榜首
  • RFD4-Proteina 生成 200 氨基酸蛋白质结构的设计速度比前代标杆 RFdiffusion3 提速整整 13 倍,大幅缩短原研药发现周期
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Super VL⚡ Nemotron 3.5 Bolt⚡ BioNeMo RFD4-Proteina⚡ Cosmos🌐 NVIDIA🌐 Baker Lab

多模态 Agent 长期记忆破局:MemPilot 提出按需记忆编排策略,打破多轮交互上下文膨胀

来自多所高校与机构的研究团队在 arXiv:2610.06830 中提出多模态智能体按需记忆编排框架 MemPilot。针对现有自主 Agent 在跨会话、长程多模态交互中频繁遭遇图文上下文爆炸、无效截图堆叠与历史关键信息遗忘的痛点,MemPilot 设计了主动记忆精选策略。系统将视觉快照、操作轨迹与文本事实进行自适应压缩、语义分级与按需唤醒,在多轮复杂交互测试中将记忆显存开销削减 60% 以上,显著提升跨会话任务完成率。

多模态 Agent 长期记忆破局:MemPilot 提出按需记忆编排策略,打破多轮交互上下文膨胀

核心要点速览

  • 多所高校联合发布多模态智能体按需记忆编排框架 MemPilot(arXiv:2610.06830),破解长程图文交互上下文饱和难题
  • 建立工作缓存、情境记忆画廊与长期认知库三级架构,将历史视觉帧动态降维蒸馏为结构化空间描述
  • 在真实连续多轮会话测试中将活跃记忆 Token 消耗大幅削减 60%~75%,操作生命周期延长 3 倍以上
  • 针对跨会话视觉凭据与布局检索任务,任务完成率相较传统文本 RAG 提升 18.5%,为长期多模态 Agent 奠定记忆基座
阅读全文
关联模型 / 智能体 / 厂商:

Adobe 与布朗大学开源多模态多参考视频编辑框架 OmniXRef:镜头轨迹误差大降 5 倍,横扫五大属性控制

Adobe Research 与布朗大学在 arXiv:2610.22744 中正式发布统一多模态多参考视频编辑框架 OmniXRef。针对现有视频编辑模型通常仅支持单一文本提示、难以精确解耦多参考源(如参考视频的运镜、参考图像的主体外观与自然语言指令)的行业痛点,OmniXRef 采用单流扩散 Transformer(Diffusion Transformer)架构,提出 Mix-Patchify 与参考相对位置编码(R2-RoPE)。实测显示在运镜轨迹迁移中旋转误差低至 0.874、平移误差 3.961,超越顶尖商用闭源系统达 5 倍以上。

Adobe 与布朗大学开源多模态多参考视频编辑框架 OmniXRef:镜头轨迹误差大降 5 倍,横扫五大属性控制

核心要点速览

  • Adobe 与布朗大学联合开源多模态多参考视频编辑框架 OmniXRef(arXiv:2610.22744),支持文本、图像与视频多参考源自由组合
  • 基于单流 Diffusion Transformer 架构,提出 Mix-Patchify 与 R2-RoPE 相对位置编码,实现多模态上下文联合注意力建模
  • 在镜头轨迹迁移中旋转误差仅 0.874、平移误差 3.961,精度超越顶尖商用视频系统 Seedance 2.5 达 5 倍以上
  • 全面覆盖运镜、动作、主体、画风与特效五大属性解耦控制,开源项目主页已正式上线
阅读全文
关联模型 / 智能体 / 厂商:

小米 AI 实验室发布细粒度多模态模型 Xiaomi-Lens-0:4B 参数刷新 RefCOCO 语义分割纪录,掩码自监督打通像素级空间定位

针对多模态大模型普遍依赖纯文本监督而欠缺像素级细粒度空间定位能力的瓶颈,小米 AI 实验室(Xiaomi AI Lab)发表技术报告 Xiaomi-Lens-0(arXiv:2610.23279)。该模型基于 Qwen3.5 4B 打造,通过轻量级掩码解码器将视觉编码器 Patch 特征、隐层表征与掩码 Token 状态深度融合,在 RefCOCO/RefCOCO+/RefCOCOg 目标表达理解(REC 达 94.6%/92.1%/92.5%)与表达语义分割(RES cIoU 达 83.4%/79.9%/81.1%)上全面超越 Florence-2 与 LISA,同时保持 69.7% 的通用多模态感知高分。

小米 AI 实验室发布细粒度多模态模型 Xiaomi-Lens-0:4B 参数刷新 RefCOCO 语义分割纪录,掩码自监督打通像素级空间定位

核心要点速览

  • 小米 AI 实验室发布 4B 参数细粒度多模态大模型 Xiaomi-Lens-0(arXiv:2610.23279),以 Qwen3.5 4B 为基座原生输出像素掩码
  • 在 RefCOCO/RefCOCO+/RefCOCOg 目标表达理解(REC)测试中分别斩获 94.6%、92.1% 与 92.5%,全面超越 Florence-2 与 Grounding-DINO-L
  • 在表达语义分割(RES)任务上取得 83.4% / 79.9% / 81.1% 的 cIoU 高分,大幅碾压 7B 级的 LISA 与 GSVA
  • 在 MME-RW-en 真实世界通用评测中取得 69.7%,超越 Qwen2.5-VL 7B,证实细粒度空间监督能够反哺通用多模态理解
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

零外部裁判登顶 WebArena Infinity 74.6%!Salesforce 开源 CLIFT 保形自验证,SCOPED-8B 跨能力蒸馏反超 32B 模型

针对网页与多模态智能体在强化学习中奖励稀疏、外部大模型裁判昂贵以及多能力梯度冲突的痛点,今日三项重磅研究实现突破:Salesforce AI Research 推出 CLIFT(arXiv:2610.06829),将保形认证的 URL 状态自验证问题库同时用于训练稠密奖励与测试期零裁判轨迹优选(CTS),使 Gemma-4 31B 在 WebArena Infinity 9 大应用上斩获 74.6% 登顶(超越 Gemini 3 Flash 的 70.1%),迁移至 GPT-5.5 刷新 VisualWebArena 53.7% SOTA;MMSearch-OPD(arXiv:2610.22240)将 9B 多模态深度搜索准确率提至 60.2%(+15.3 分);东北大学 SCOPED-8B(arXiv:2610.22217)通过技能解耦在线专家蒸馏斩获 73.13% 均分,越级击败 4 倍体积的 Qwen3-VL-32B(72.01%)与 Claude Opus 4.6(72.86%)。

零外部裁判登顶 WebArena Infinity 74.6%!Salesforce 开源 CLIFT 保形自验证,SCOPED-8B 跨能力蒸馏反超 32B 模型

核心要点速览

  • Salesforce 提出 CLIFT 保形自验证框架:使开源 Gemma-4 31B 在 WebArena Infinity 9 大应用上斩获 74.6% 最高成功率(较基座 +12.8 分,击败 Gemini 3 Flash 的 70.1%),且测试期轨迹优选(CTS)无需调用任何外部裁判
  • 将开源模型学到的 CLIFT 验证问题库零训练迁移至闭源 GPT-5.5,在 VisualWebArena 上以 53.7% 刷新最高纪录;MMSearch-OPD 则将 9B 多模态深度搜索 7 项基准均分拉升 15.3 分至 60.2%
  • 东北大学开源 SCOPED 技能解耦在线专家蒸馏框架:SCOPED-8B 在 8 大多模态基准上斩获 73.13% 均分,越级击败 4 倍体积的 Qwen3-VL-32B(72.01%)与 Claude-Opus-4.6(72.86%)
阅读全文
关联模型 / 智能体 / 厂商:

Google AI Studio 向 Pro 订阅者开放 Gemini 4 Argon 构建模式,Transformers v5.20.1 原生支持 Reflection AI Beam 与 Meta 816B Muse Spark Open

Google AI Studio 正式宣布向 Google AI Pro 订阅开发者全面开放旗舰模型 Gemini 4 Argon 的 Build 与 Playground 交互构建能力;与此同时,Hugging Face Transformers 连发 v5.20.0 与 v5.20.1,免远程代码原生集成 Reflection AI 编码大模型 Beam、Meta 816B(42B 激活/1M 上下文)全模态编程模型 Muse Spark Open、蚂蚁 Ling 3.0 Flash 及面壁 MiniCPM-V 4.7。

Google AI Studio 向 Pro 订阅者开放 Gemini 4 Argon 构建模式,Transformers v5.20.1 原生支持 Reflection AI Beam 与 Meta 816B Muse Spark Open

核心要点速览

  • Google AI Studio 正式向 Pro 订阅用户开放 Gemini 4 Argon 的 Build 与 Playground 模式(https://ai.studio/build),赋能长程交互式应用构建
  • Hugging Face Transformers v5.20.1 原生合入 Reflection AI 面向私有化与长程 Agent 打造的低 Token 消耗旗舰编码模型 Beam,并修复 DeepGEMM Mega MoE 专家并行 Bug
  • 同步原生支持 Meta 816B 总参数(42B 激活、1,048,576 上下文、支持 BF16/NVFP4)全模态编程模型 Muse Spark Open 与蚂蚁 KDA+MLA 混合架构 Ling 3.0 Flash
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

Perplexity 开发者团队(@perplexitydevs)联合 OpenRouter 与 Vercel AI Gateway 正式上线新一代开源权重多模态决策模型 pplx-decider-v1.2(27B)与轻量级 pplx-decider-flash-v1.2(4B)。该系列模型支持同时输入文本与图像,直接返回带校准概率分布的类型化决策结果(Typed Answers with Probabilities),其中 27B 版本输入定价低至 $0.02/百万 Token,4B Flash 版速度更快且成本再砍半,成为智能体路由与工具选择的极速基础设施。

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

核心要点速览

  • 双尺寸多模态决策模型上线:发布 27B 旗舰版 pplx-decider-v1.2 与 4B 极速版 pplx-decider-flash-v1.2,支持图文输入直出类型化概率决策
  • 输入定价低至 $0.02/百万 Token:27B 版本仅售 $0.02/1M 输入 Token,4B Flash 版本速度更快且成本再减半
  • OpenRouter 与 Vercel 同步首发:支持 pplx-decider-latest 动态别名,专为智能体工具路由、护栏审查与多模态状态分类打造
阅读全文
关联模型 / 智能体 / 厂商:

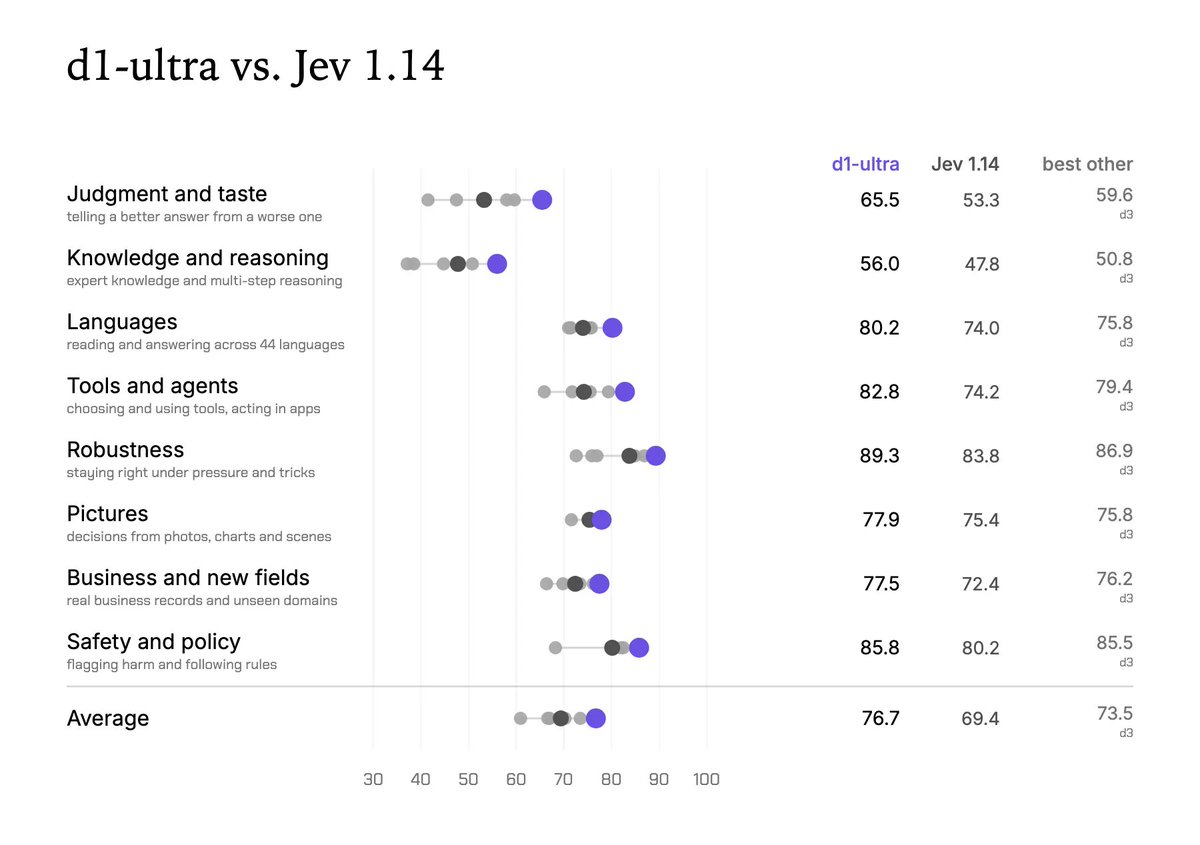
Liquid AI 发布 d1-ultra 决策模型:不生成 token 直接输出校准概率,Artificial Analysis Decision Index 以 65 分居首,输入 $0.042/百万 token

Liquid AI 于 10 月 15 日发布多模态决策模型 d1-ultra,输入文本和图像,一次前向传播直接返回是非、单选、打分三类问题的概率,不生成任何 token,只按输入计费。Artificial Analysis 独立评测中它以 65 分登顶 Decision Index v1.0,领先至少 8 分,非幻觉率 85%;已上线 Liquid API、Vercel AI Gateway 与 OpenRouter。

Liquid AI 发布 d1-ultra 决策模型:不生成 token 直接输出校准概率,Artificial Analysis Decision Index 以 65 分居首,输入 $0.042/百万 token

核心要点速览

  • Artificial Analysis Decision Index v1.0 得分 65,第一名,领先其他决策模型至少 8 分(独立评测)
  • AA-Omniscience-Decision 非幻觉率 85%,第二名 Microsoft-Decision-1 为 40%;但因更多弃答,准确率 32% 低于 d1 的 41%
  • 定价 $0.042 / 百万输入 token,输出免费;1024×1024 图像计 1,536 token(官方博客)
  • 上下文 32,768 token,支持 44 种语言,Liquid 自有 112 项评测中八大类全部领先(厂商口径)
  • 调用方式:Liquid /decisions/v1/systemone 端点 model: d1-ultra,或 Vercel/OpenRouter 的 liquid/d1-ultra(文档)
阅读全文
关联模型 / 智能体 / 厂商:

Meta 开源 Muse Spark Open:816B 总参 / 42B 激活 MoE,1M 上下文,官方称迄今最强美系开源权重模型

Meta 于 2026-10-15 发布 Muse Spark Open 权重:原生多模态 MoE(约 816B 总参、每 token 激活约 42B、1M 上下文),面向长程编程与智能体;权重可经 Hugging Face 等下载,并已上线 Together、Fireworks、Groq、OpenRouter 等托管推理。官方与第三方给出 DeepSWE 60%、MCP-Atlas 89.2%、JobBench 61.8% 等结果(口径见评测方法论文档)。

Meta 开源 Muse Spark Open:816B 总参 / 42B 激活 MoE,1M 上下文,官方称迄今最强美系开源权重模型

核心要点速览

  • 规模:约 816B 总参 / 每 token 激活约 42B;MoE 每层 256 专家、top-8 路由;62 层、隐藏维 8192;上下文至 1,048,576(HF 技术帖)
  • 编码/智能体(Meta 记分卡 / AA,xhigh):DeepSWE 60.0%;SWE-Atlas Codebase QnA 58.0%;MCP-Atlas 89.2%;JobBench 61.8%;Toolathlon-Verified 72.8%(评测方法)
  • 吞吐(NVIDIA 技术博客,GB300 NVL72 上 agentic 负载):宣称最高约 50K tok/s/GPU、约 600 tok/s/用户;提供 NVFP4 检查点(NVIDIA 博客)
  • 落地:权重 Muse Model License(有限商业条款);引擎含 SGLang / vLLM / TensorRT-LLM / MLX / llama.cpp;双台 Apple M5 Ultra Mac Studio 可桌面本地跑(官方演示)
  • 第三方综指:Artificial Analysis Intelligence Index 约 38.9–39(xhigh,2026-10-07 口径),低于闭源前沿,但是开源权重档位中的重点对照(AA)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark Open⚡ Muse Spark Open 816B-A42B🤖 Muse Code🌐 Meta🌐 NVIDIA🌐 Hugging Face🌐 Apple