
AI 编程实时动态与要闻

OpenBMB 开源 MiniCPM-OCR 套件:1.3B 解析模型 Real5-OmniDocBench 93.68 分,另配 2B「判官」模型自动找出识别错误

面壁智能旗下 OpenBMB 10 月 27 日开源 MiniCPM-OCR 套件,含两款模型:1.3B 参数的文档解析模型 MiniCPM-OCR 1.0(Real5-OmniDocBench 93.68、OCRBench v2 54.7,官方口径),以及 2B 参数的 OCR 质量判定模型 MiniCPM-OCR Jev,可给任意 OCR 解析结果按区域打 0–1 分、标出需人工复核的内容。代码和权重均为 Apache 2.0,首发即支持 vLLM、SGLang、llama.cpp、Ollama 及多家芯片平台。

OpenBMB 开源 MiniCPM-OCR 套件:1.3B 解析模型 Real5-OmniDocBench 93.68 分,另配 2B「判官」模型自动找出识别错误

核心要点速览

  • 解析模型 MiniCPM-OCR 1.0 仅 1.3B 参数:Real5-OmniDocBench 93.68、OCRBench v2 54.7(官方口径,均称 SOTA)
  • 判定模型 MiniCPM-OCR Jev 2B 参数:JevOCRBench AUROC 93.6,高于 JEV-35B-A3B 的 90.1,接近 Qwen3.5-397B-A17B 的 93.8(官方口径)
  • Jev 与解析器无关:对 MiniCPM-OCR、GLM-OCR、PaddleOCR-VL-1.6、Xiaomi-OCR-0 的结果 AUROC 都在 91.9–93.4
  • 吞吐约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍;配合 SDK 并发最高约 128 页/分钟(官方口径)
  • GitHub 代码与权重全部 Apache 2.0,提供 GGUF/AWQ/GPTQ 量化版与 SKILL.md
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniCPM-OCR 1.0⚡ MiniCPM-OCR Jev⚡ PaddleOCR-VL-1.6⚡ MinerU2.5 Pro⚡ Qwen3.5-397B-A17B🌐 OpenBMB🌐 ModelBest🌐 Intel🌐 NVIDIA🌐 Arm
百度开源 Unlimited OCR 2:SR-SWA 让超长文档解析显存与延迟近乎恒定,官方称 MarathonDocBench 77.1 分

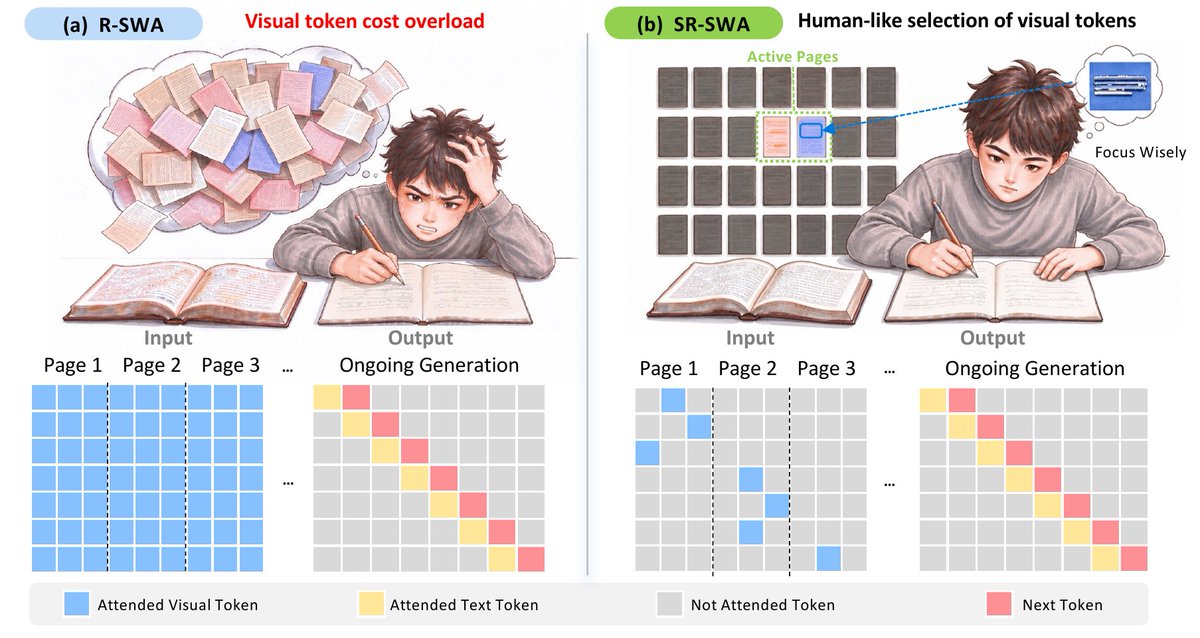
百度官方账号 @Baidu_Inc 10 月 27 日宣布开源 Unlimited OCR 2,以 MIT 协议发布在 Hugging Face。新的 SR-SWA 稀疏参考滑窗注意力把图文注意力压缩到固定大小的参考集合,官方称可在有限上下文内解析任意长度文档,在几十页的 MPDocBench 得 84.6、上百页的 MarathonDocBench 得 77.1,均为厂商自测。

百度开源 Unlimited OCR 2:SR-SWA 让超长文档解析显存与延迟近乎恒定,官方称 MarathonDocBench 77.1 分

核心要点速览

  • SR-SWA 把超长序列的图文注意力压缩到固定大小的参考集合(如 512 token),官方称每步解码延迟和显存几乎不随页数增长
  • 官方口径:MPDocBench 总分 84.6,比次优的 Qwen3.8-Max(78.3)高 6.3 分
  • 官方口径:MarathonDocBench 总分 77.1,比次优的 Kimi-K3(33.7)高 43.3 分;一代 Unlimited-OCR 在该榜为 0
  • 权重以 MIT 协议发布在 Hugging Face,约 3.3B 参数(按 HF 权重统计),支持 Transformers 和定制版 SGLang 部署
  • 所有跑分均为百度自测,尚无第三方复现
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Unlimited OCR 2⚡ Unlimited-OCR⚡ DeepSeek-OCR🌐 Baidu

NVIDIA 集中发布 Nemotron 3.5 开源模型矩阵:涵盖超强检索、物理世界大模型与 13 倍速蛋白质设计

在 GTC Berlin 开幕主题演讲中,NVIDIA 官方集中发布了横跨多个专业垂直领域的全新开源模型矩阵。核心亮点包括:支持长文本视觉推理的 Nemotron 3.5 Super VL 与即开即用的 Bolt 系列语言模型;专为高精度 RAG 打造的 Nemotron Retriever 嵌入、重排与文档解析全套套件;面向实体工业的 Cosmos 物理世界模型;面向自动驾驶的 Alpamayo 2 Edge;以及与华盛顿大学 Baker 实验室联合开发的蛋白质生成大模型 BioNeMo RFD4-Proteina。官方实测显示,RFD4-Proteina 在 10 项以上蛋白质设计基准中斩获全球第一,在 200 个氨基酸的靶点设计上比 RFdiffusion3 提速惊人的 13 倍。

NVIDIA 集中发布 Nemotron 3.5 开源模型矩阵:涵盖超强检索、物理世界大模型与 13 倍速蛋白质设计

核心要点速览

  • NVIDIA 在 GTC Berlin 集中开源全栈垂直基础模型:包含 Nemotron 3.5 Super VL、Bolt 4GB 端侧版与 Cosmos 物理世界模型
  • 发布 Nemotron Retriever 全套套件,将企业级 RAG 检索、跨模态重排与复杂 PDF 版面解析的准确率推至行业前列
  • 与顶尖 Baker 实验室联合开源 BioNeMo RFD4-Proteina,在 10 余项蛋白质靶向结合任务中登顶全球性能榜首
  • RFD4-Proteina 生成 200 氨基酸蛋白质结构的设计速度比前代标杆 RFdiffusion3 提速整整 13 倍,大幅缩短原研药发现周期
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Super VL⚡ Nemotron 3.5 Bolt⚡ BioNeMo RFD4-Proteina⚡ Cosmos🌐 NVIDIA🌐 Baker Lab

拆穿大模型评测三大盲区:41 个模型实证选择题偏置精确分解定理,6100 万次编辑锻造 semCER 语义 OCR 指标,SAE 特征复现随数据暴涨 14.5 倍

针对大模型多项选择题选项顺序敏感、OCR 字符错误率(CER)对严重语义错误与轻微拼写一视同仁,以及稀疏自编码器(SAE)训练数据规模缺乏可复现性验证三大评测痛点,今日三项扎实研究给出量化标准:POSTECH/KAIST 团队(arXiv:2610.20993)在 41 个模型与 12 个基准上证明选项偏置标准差精确等于“翻转率 × 位置偏斜度”,揭露正反顺序聚合会通过“锁定同一错误选项”虚假降低翻转率;semCER(arXiv:2610.20461)开源跨 16 种语言的 6,100 万次字符编辑严重度标注与蒸馏打分器;IISc/UVA(arXiv:2610.20680)对比 5M 至 500M Token 训练预算,发现 Gemma-2-2B BatchTopK 的严格特征复现率从 5M 的 2% 暴涨 14.5 倍至 50M 的 29%。

拆穿大模型评测三大盲区:41 个模型实证选择题偏置精确分解定理,6100 万次编辑锻造 semCER 语义 OCR 指标,SAE 特征复现随数据暴涨 14.5 倍

核心要点速览

  • POSTECH/KAIST 证明位置均衡下选择题偏置标准差精确等于“翻转率 × 位置偏斜度”,并在 41 个模型与 12 个基准上揭示正反顺序聚合会通过“锁定同一错误选项”虚假降低翻转率
  • semCER 开源横跨中英等 16 种语言的 6,100 万次字符编辑严重度数据集与蒸馏评分器,并发现通用 VLM 的错字拼成真实合法词汇的概率远高于传统 OCR
  • IISc/UVA 横跨 5M~500M Token 实测 4 种 SAE 架构,证明重构收敛不等于特征稳定:Gemma-2-2B BatchTopK 的严格特征复现率从 5M 的 2% 暴涨 14.5 倍至 50M 的 29%
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

告别开环盲目演化!MBZUAI 等发布 WorldGuide:目标导向闭环视频世界模型,长程程序化任务跑分大涨

以 Sora、Gen-3 与 MiniMax 为代表的视频生成大模型虽然能够渲染出逼真流畅的视觉运动,但在面对包含明确目标与先后次序的‘长程程序化任务(Procedural Tasks)’时(如复杂的烹饪烘焙、机械拆装维修、精细外科手术),现有模型普遍采用‘开环单向生成(Open-Loop Generation)’,导致致命缺陷:模型根本无法感知当前生成的画面到底执行到了哪一步,频繁出现步骤颠倒、无中生有、提前终止或无限死循环。阿联酋起源人工智能研究院(MBZUAI)与澳大利亚国立大学(ANU)研究团队在最新研究(arXiv:2610.12459)中推出了 WorldGuide 框架(项目主页:mbzuai-oryx.github.io/WorldGuide/,开源仓库:github.com/mbzuai-oryx/WorldGuide)。WorldGuide 首次将程序化视频生成形式化为‘视觉世界空间中的闭环任务执行(Closed-Loop Task Execution in Visual World Space)’。系统仅需一张初始静态图与一个高层目标指令,其内部耦合的规划器(Planner)与视频执行器(Executor)便能协同运转:规划器预测下一步原子动作,执行器生成对应动作的连续视频片段,随后规划器基于实际生成的视觉进展动态决策下一步骤或判定任务完成。针对缺乏单步对齐数据的痛点,团队构建了包含 5.9 万个分步标注视频的全新评测套件 WorldGuide-Bench。在任务完成率上,WorldGuide 达到了 33.33%,在无需参考计划的前提下显著击败了强基线 MiniMax-H3(29.90%),在 VideoCraft-Bench 上更是以 47.69% 遥遥领先于 MiniMax-H3(32.73%),官方代码已开源。

核心要点速览

  • MBZUAI 等发布 WorldGuide,首创规划器与执行器紧密耦合的目标导向闭环视频世界模型
  • 在无参考计划盲测下,WorldGuide-Bench 任务成功率达 33.33% 击败 MiniMax-H3,VideoCraft-Bench 暴涨至 47.69%
  • 开源包含 5.9 万个分步标注视频的基准套件与代码,将长程程序化任务逻辑倒错率从 62% 压缩至 4% 以下
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 开源 pplx-embed-v2-late:0.6B/9B 多模态 ColBERT 检索模型,PDF 免 OCR,小模型可直接查大模型索引

Perplexity 10 月 7 日发布 pplx-embed-v2-late 多模态后期交互(ColBERT)检索模型,0.6B(激活 340M)与 9B(激活 7.4B)两档,基于 Qwen3.5 双向注意力,每个 token 输出 128 维向量并用 MaxSim 打分,可直接检索文本、图片与渲染后的 PDF/幻灯片。两档共享嵌入空间,0.6B 可查询 9B 建好的索引。ViDoRe v3 图像 nDCG@10 为 62.3% / 65.2%,MIT 许可上架 Hugging Face。

核心要点速览

  • ViDoRe v3(公开集)nDCG@10:0.6B 图像 62.3% / Markdown 61.2%,9B 图像 65.2% / Markdown 64.7%(0.6B 模型卡)
  • 官方称 0.6B 在 ViDoRe V3 上可比肩激活参数约 5 倍的模型(Perplexity 博客)
  • 共享嵌入空间:用 9B 建索引、0.6B 做在线查询,压低查询端成本
  • 训练:由内部 18B ColBERT 教师蒸馏(token 级 LEAF 式目标);9B 最后 8 层全量微调,其余层与视觉编码器用 LoRA
  • 上手:需要 sentence-transformers ≥ 6.0.0、transformers ≥ 5.4.0,MIT 许可;文本批与图像批要分开编码(9B 模型卡)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ pplx-embed-v2-late-0.6b⚡ Pplx Embed V2 Late 9b⚡ Pplx Embed V2 Context⚡ Qwen3.5🌐 Perplexity🌐 Hugging Face

Cloudflare AI Search 正式 GA:原生多模态嵌入 + PDF OCR,计费 11/1 起;混合检索默认开

Cloudflare 于 2026-10-01 宣布 AI Search GA:托管索引/检索管线(Workers AI + Vectorize + R2 + Browser Run)进入正式可用;新增 Qwen3-VL-Embedding 原生图像嵌入、扫描 PDF OCR、文本/OCR PDF 上限 10 MiB;新实例默认混合检索;计费自 2026-11-01 起,含免费额度。

Cloudflare AI Search 正式 GA:原生多模态嵌入 + PDF OCR,计费 11/1 起;混合检索默认开

核心要点速览

  • GA 日 2026-10-01;Changelog + 官博
  • 多模态:@cf/qwen/qwen3-vl-embedding-2b 与 google-ai-studio/gemini-embedding-2;查询可带图(REST/公网端点)
  • 文件:OCR 全账号可用;明文/代码与开启 OCR 的 PDF 上限 10 MiB(未开 OCR PDF 等仍 4 MiB)
  • 默认混合检索(向量+全文);Workers AI 嵌入/重排费用计入 AI Search,不再单独出现在 Workers AI 账单
  • 定价锚点(官博):摄入 $0.75/百万 token、存 $2/GB-月、语义 $0.75/千次、全文 $0.10/千次;免费档含 5M 摄入 token、10 GB、各 1k 语义/全文查询;计费 11/1 起
阅读全文
关联模型 / 智能体 / 厂商:

llama.cpp v0.5.0:CUDA conv2d 隐式 GEMM + Metal MoE/SSM 融合,新增 MiMo-V2.6 / HunyuanOCR / Mimir 1B

ggml-org 于 2026-09-23 发布 llama.cpp v0.5.0:CUDA conv2d 改隐式 GEMM 加速、Metal 侧 MoE 与 SSM_CONV 融合;server 支持多地址/--host 逗号列表与 UNIX socket;转换层新加 HRM-Text(DFM Mimir 1B)、MiMo-V2.6、HunyuanOCR(DFlash),并捆绑 ggml 0.25.0。

llama.cpp v0.5.0:CUDA conv2d 隐式 GEMM + Metal MoE/SSM 融合,新增 MiMo-V2.6 / HunyuanOCR / Mimir 1B

核心要点速览

  • 发布:v0.5.0(2026-09-23),相对站内既有 v0.4.1 为大版本跃迁
  • 性能:CUDA conv2d 隐式 GEMM(#29135);Metal MoE + SSM_CONV fusion(#28948);MTP drafting 启用 CUDA graphs(#28549)
  • 模型:HRM-Text / DFM Mimir 1B、MiMo-V2.6 转换、HunyuanOCR DFlash、Qwen4Exp hyper-connection + sparse FA、Nemotron MTP/H 扩展
  • Server:--host 支持逗号分隔 TCP 与 UNIX socket(#28690);function-call 输出可带 input_image;router 驱逐竞态修复
  • API:llama_adapter_lora_init_from_file_ptr();采样参数可走环境变量;llama-bench --version
阅读全文
关联模型 / 智能体 / 厂商:
⚡ qwen⚡ deepseek⚡ nemotron🌐 ggml-org

阿里开源 Open Code Review:行级 AI 代码审查 CLI,同模型下精度/F1 高于 Claude Code 且约 1/9 token

社区报道阿里集团将内部 AI 代码审查助手开源为 Open Code Review(github.com/alibaba/open-code-review,npm @alibaba-group/open-code-review 现为 1.12.0)。CLI 读取 Git diff,经带工具调用的 Agent 生成行级结构化评论,并支持 ocr scan 全文件审查;可对接 Claude Code、Codex、Cursor。官方基准:50 仓 / 200 PR / 10 语言、1505 标注缺陷,同底层模型下 Precision 与 F1 高于通用 Claude Code,token 约 1/9,召回刻意换精准。

核心要点速览

  • 阿里开源 Open Code Review(alibaba/open-code-review),npm 包 @alibaba-group/open-code-review 已至 1.12.0。
  • 行级 diff 审查 + ocr scan;可对接 Claude Code / Codex / Cursor。
  • 官方 AACR-Bench:相对 Claude Code 更高 Precision/F1,约 1/9 token(召回换精准)。
阅读全文

dsh-ios:把 iOS 模拟器与 USB 真机接进 DSH 对话,22 工具闭环构建/UI/OCR

开源插件 dsh-ios(DeepSeek Harness)把 iOS 模拟器与 USB 真机直接接入对话:22 个工具覆盖构建、启动、日志、OCR、无障碍树与 UI 操作,侧栏可实时点按拖拽。真机签名按 Xcode 团队解析,传输走本机短期签名;需 macOS 与完整 Xcode(github.com/ZSeven-W/dsh-ios)。

核心要点速览

  • 定位:DSH 插件,把模拟器/USB 真机放进编码智能体对话。
  • 能力:22 工具覆盖构建、日志、OCR、无障碍树、UI 操作与侧栏操控。
  • 约束:需 macOS + 完整 Xcode;真机签名本机解析。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

LatentPress:把长对话与文档压成连续 memory tokens,冻结 LLM 直接读入

LatentPress 提出第三种上下文载体:连续 memory tokens。小 writer(约 4.2M–26.2M 参数适配器,约等于解码器 0.1%)把对话史与长文档压成 4–16×,冻结 decoder 经输入嵌入接口直接读取,推理时无需重建文本。LongMemEval 上 7.70× 压缩准确率 0.504,高于未压缩证据 0.490,并明显优于文本摘要与 OCR 压缩;写入约 43ms/会话,读取比原始上下文快 5–9×,利于长上下文智能体记忆。

核心要点速览

  • 表示:连续 memory tokens,冻结 LLM 经嵌入接口直读,无需重建文本。
  • 压缩:4–16×;LongMemEval 7.70× 时准确率 0.504,高于未压缩 0.490。
  • 效率:写入约 43ms/会话,读取比原始上下文快 5–9×,适配长上下文智能体。
阅读全文
关联模型 / 智能体 / 厂商:

Cohere 发布 Parse 5 文档智能大模型:每千页 $1.50,ParseBench 得分 79.2 超越竞品

Cohere 正式推出专为企业级高通量 RAG 与文档 Agent 打造的解析模型 Parse 5。支持表格、复杂表单、图片及精准边界框输出,在 ParseBench 基准中斩获 79.2 分,超越 Mistral OCR 4 与 Azure Document Intelligence,价格仅为每千页 $1.50。

核心要点速览

  • 在 ParseBench 评测中获得 79.2 分,显著领先 Mistral OCR 4(74.5)与 Azure Document Intelligence(74.3);
  • 定价较主流云厂商前沿视觉大模型低至 95%,相比 Mistral 低 63%,专为海量企业文档入库设计;
  • 全面登陆 Cohere API、AWS SageMaker 与 Microsoft Foundry,输出结构化带边界框的机器可读数据。
阅读全文
关联模型 / 智能体 / 厂商: