
AI 编程实时动态与要闻

Perplexity CEO 公布 Gemini 4 Carbon 早期评测:WANDR 深度研究基准 0.857 创新高,每任务 5.86 美元,高于 Argon 和 GPT-6 Astra

Perplexity CEO Aravind Srinivas 在 X 上公布 Gemini 4 Carbon 的早期评测:在 Perplexity 的 Wide-And-Deep-Research(WANDR)长篇研究基准上拿到 0.857,创新高,每任务成本 5.86 美元;Gemini 4 Argon 为 0.802(7.88 美元),GPT-6 Astra 为 0.735(13.34 美元)。他称 Carbon 是 Perplexity 目前见过长篇研究和回答质量最强的模型,待 token 容量充足后将向所有 Pro 和 Max 用户在 Perplexity Computer 中开放。
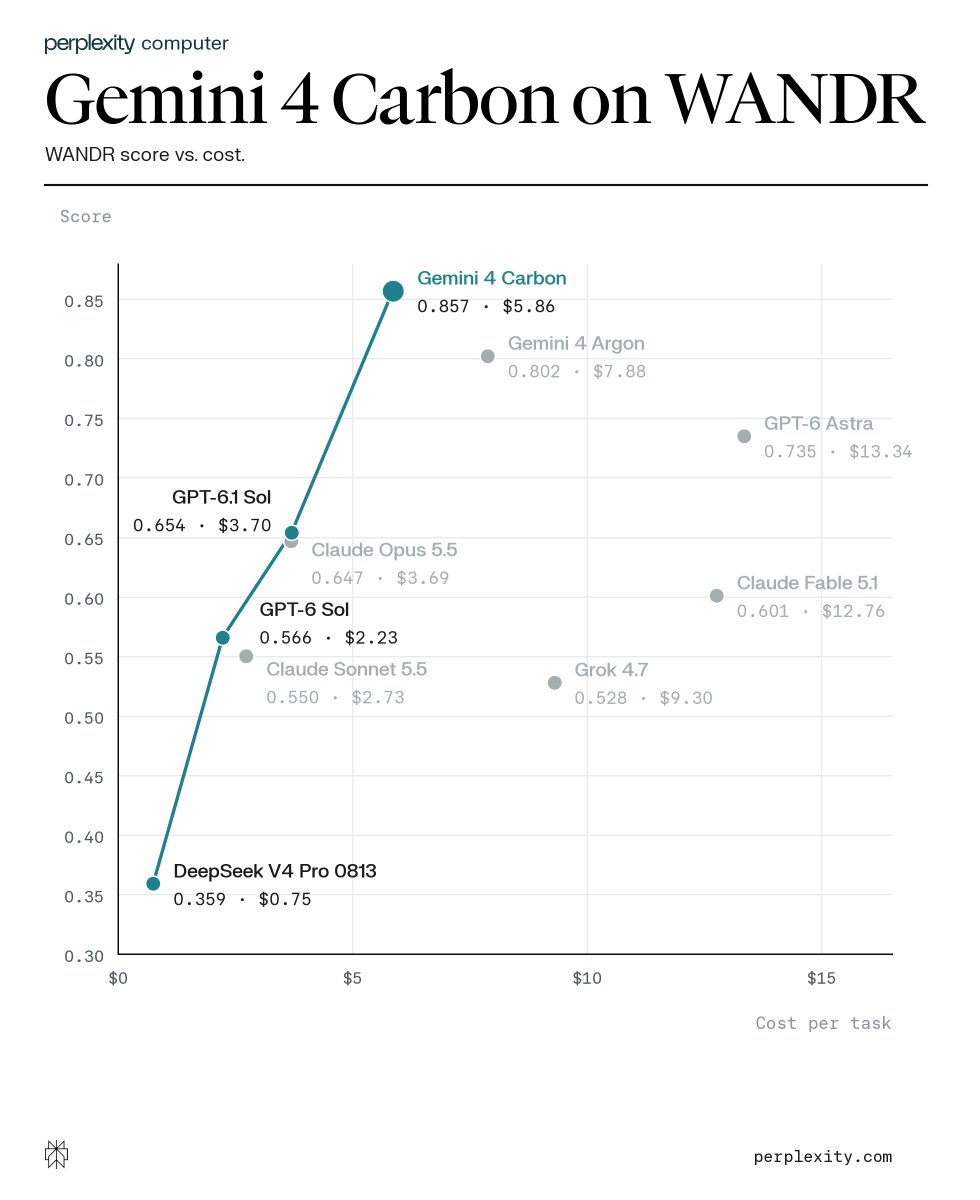
Perplexity CEO 公布 Gemini 4 Carbon 早期评测:WANDR 深度研究基准 0.857 创新高,每任务 5.86 美元,高于 Argon 和 GPT-6 Astra

核心要点速览

  • WANDR 得分(Perplexity 口径):Gemini 4 Carbon 0.857、Gemini 4 Argon 0.802、GPT-6 Astra 0.735、GPT-6.1 Sol 0.654、Claude Opus 5.5 0.647、Claude Fable 5.1 0.601
  • 成本更低:Carbon 每任务 5.86 美元,低于 Argon 的 7.88 美元和 GPT-6 Astra 的 13.34 美元
  • 性价比曲线:DeepSeek V4 Pro 0813(0.359,0.75 美元)、GPT-6 Sol(0.566,2.23 美元)、GPT-6.1 Sol(0.654,3.70 美元)和 Carbon 构成 Perplexity 图中的成本前沿
  • Claude Sonnet 5.5 为 0.550(2.73 美元),Grok 4.7 为 0.528(9.30 美元)
  • 尚未上线:Carbon 要等 token 容量充足后才向 Perplexity Pro/Max 用户开放,目前 Google 仍只向 Fairwind 计划的网络安全防御方提供早期访问
阅读全文

Perplexity 官宣 Perplexity Computer 登陆 macOS:本地大模型与端侧 Agent 深度整合,实现 100% 离线 Mac 控制

Perplexity 官方正式宣布将 Perplexity Computer 功能原生集成至 macOS 客户端应用中。与此前高度依赖云端传输屏幕截图并接收键盘鼠标动作指令的传统 Computer-Use 方案不同,Perplexity Computer 实现了模型与智能体执行回路的全本地化运行(The model and the agent both run on your Mac)。通过深度调用 macOS 原生辅助功能(Accessibility API)与本地端侧轻量多模态模型,该功能消除了云端网络延迟,并在彻底保护用户屏幕隐私的前提下,赋能智能体在用户桌面上全自主操作本地应用、整理文件与执行跨软件复杂工作流。

Perplexity 官宣 Perplexity Computer 登陆 macOS:本地大模型与端侧 Agent 深度整合,实现 100% 离线 Mac 控制

核心要点速览

  • Perplexity 官方正式在 macOS 客户端推出 Perplexity Computer,实现模型推理与智能体循环全本地运行
  • 彻底打破传统云端 GUI Agent 的隐私隐患,屏幕画面与按键事件无需上传服务器,100% 杜绝敏感数据外泄
  • 零云端往返时延(Zero Cloud RTT),利用 Apple Silicon 统一内存与硬件神经引擎,实现极速桌面响应
  • 深度结合 macOS 原生无障碍体系与应用沙盒,支持跨终端、浏览器与本地开发套件的端到端自动化编排
阅读全文
关联模型 / 智能体 / 厂商:

小红书、北大与港中文深圳提出 LangDiT:专为连续扩散语言模型重构 Transformer,生成困惑度骤降至 11.33 刷新 SOTA

现有连续扩散语言模型(CDLM)普遍直接套用自回归 LLM 或图像 DiT 架构,存在特征尺度失控与梯度路由紊乱问题。小红书、北京大学、香港中文大学(深圳)与 UCLA 团队联合发表 LangDiT(arXiv:2610.22330)。通过骨干网与 Q/K RMSNorm、展宽噪声条件调制、词表头残差截断解耦及置信度门控自条件引导,在 OpenWebText 基准上将 LangFlow 生成困惑度压至 21.72,适配 Plaid 架构后进一步取得 11.33 的全新 SOTA 困惑度记录。

小红书、北大与港中文深圳提出 LangDiT:专为连续扩散语言模型重构 Transformer,生成困惑度骤降至 11.33 刷新 SOTA

核心要点速览

  • 小红书、北大与港中文深圳联合发表 LangDiT(arXiv:2610.22330),首次系统重构专属于连续扩散语言模型的 Transformer 架构
  • 通过 Q/K RMSNorm、展宽噪声条件调制解耦数值稳定性与时间步注入,利用词表头梯度截断消除自条件反馈污染
  • 在 OpenWebText 1024 长度无条件文本生成中,将 LangFlow 生成困惑度降至 21.72,将 Plaid 困惑度大幅压缩至 11.33 的全新纪录
  • 在仅需 128 步去噪采样下仍取得 27.51 的优异困惑度,证实骨干网络定制是非自回归语言模型取得质变的核心动力
阅读全文
关联模型 / 智能体 / 厂商:

苏黎世联邦理工与港大破解 MoE 路由探索困境 MirrorMoE:自适应专家剪枝化解共享专家抑制效应,全尺度 PPL 显著下降

现代混合专家(MoE)普遍结合“细粒度专家切分”与“共享专家”设计,但二者在底层产生致命冲突:共享专家均质化了 Token 表征,抑制了路由探索,导致组合膨胀的专家空间无法被充分利用。苏黎世联邦理工学院(ETH Zurich)与香港大学团队发表 MirrorMoE(arXiv:2610.22353,GitHub: BingcongLi/MirrorMoE),通过 Token 自适应抑制冗余专家收缩探索空间,在从 100M 到 2.4B 全尺度上实现显著的 PPL 下降与下游基准全线涨点。

苏黎世联邦理工与港大破解 MoE 路由探索困境 MirrorMoE:自适应专家剪枝化解共享专家抑制效应,全尺度 PPL 显著下降

核心要点速览

  • 苏黎世联邦理工学院与香港大学团队发表 MirrorMoE(arXiv:2610.22353),揭示现代 MoE 中共享专家导致表征均质化、抑制细粒度路由探索的根本困境
  • 提出 Token 自适应专家抑制算法,在保持零额外计算与训练时间开销的前提下动态收缩探索空间
  • 在 100M 至 2.4B 参数全尺度上全面降低预训练困惑度(2.4B 模型 PPL 从 21.17 降至 20.50)
  • 在六大下游基准平均得分提升 1.64 个百分点,其中 BoolQ 准确率大幅提升 4.03 个百分点(58.53% vs 54.50%)
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

针对大模型数学证明缺乏步骤级验证标签与上下文精确复制存在 LM Head 梯度瓶颈的两大难题,今日两项基础研究给出突破:NYU/UCLA/Stanford 联合推出 LeanPRM(arXiv:2610.17697),利用 Lean 4 证明助手自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注数据集,将 Qwen3-4B 步骤验证准确率从 48.2% 拉升至 74.7%(远超 PRM800K 的 60.3%);康奈尔大学提出复制粘贴语言模型 CPLM(arXiv:2610.19247),以仅约 3% 算力开销打破 LM Head 梯度瓶颈,使窗口仅 w=128 的滑窗模型追平全注意力困惑度并在 4 倍外推长度(16K)持续收益。

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

核心要点速览

  • LeanPRM 利用 Lean 4 证明器与语法错误过滤模型,全自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注过程监督集
  • 基于 LeanPRM 训练的 Qwen3-4B 验证器在 LeanPRM-Bench 上将步骤准确率从 48.2% 提升至 74.7%(大幅领先 PRM800K 训练的 60.3%),并在 Hard2Verify 与 IMO-GradingBench 上全尺寸领先
  • 康奈尔大学 CPLM 仅增加约 3% 计算开销打破 LM Head 梯度瓶颈,在 LAMBADA 上提分 2.5~4.0 分,且仅用 w=128 滑窗即可追平全注意力模型的困惑度
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

Perplexity 开发者团队(@perplexitydevs)联合 OpenRouter 与 Vercel AI Gateway 正式上线新一代开源权重多模态决策模型 pplx-decider-v1.2(27B)与轻量级 pplx-decider-flash-v1.2(4B)。该系列模型支持同时输入文本与图像,直接返回带校准概率分布的类型化决策结果(Typed Answers with Probabilities),其中 27B 版本输入定价低至 $0.02/百万 Token,4B Flash 版速度更快且成本再砍半,成为智能体路由与工具选择的极速基础设施。

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

核心要点速览

  • 双尺寸多模态决策模型上线:发布 27B 旗舰版 pplx-decider-v1.2 与 4B 极速版 pplx-decider-flash-v1.2,支持图文输入直出类型化概率决策
  • 输入定价低至 $0.02/百万 Token:27B 版本仅售 $0.02/1M 输入 Token,4B Flash 版本速度更快且成本再减半
  • OpenRouter 与 Vercel 同步首发:支持 pplx-decider-latest 动态别名,专为智能体工具路由、护栏审查与多模态状态分类打造
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 开源核心沙盒引擎 SPACE:基于 Rust 与 Firecracker 微虚拟机,在 VM 边界外硬隔离凭证与外发流量

Perplexity 宣布以 Apache 2.0 协议正式开源支撑 Perplexity Computer 每一次智能体任务执行的底层安全沙盒平台 SPACE(Sandboxed Platform for Agentic Code Execution)。该平台采用 Rust 编写,为每个智能体任务分配独立的 Firecracker microVM(或可插拔容器运行时),并将 API 密钥凭证管控与出站网络流量审计完全置于虚拟机外部,从架构根源上阻断提示词注入导致的密钥窃取,开源首日即斩获逾 1100 颗 GitHub Star。

Perplexity 开源核心沙盒引擎 SPACE:基于 Rust 与 Firecracker 微虚拟机,在 VM 边界外硬隔离凭证与外发流量

核心要点速览

  • Perplexity Computer 同款底座开源:以 Apache 2.0 协议开源 Rust 编写的智能体代码执行沙盒平台 SPACE,迅速斩获 1130+ GitHub Star
  • 任务级 Firecracker microVM 强隔离:为每个智能体任务分配独立微虚拟机(支持可插拔运行时),兼具 KVM 硬件级隔离与极速启动
  • VM 外部凭证与出站流量管控:密钥与外发流量审计完全置于虚拟机外部,从根源上杜绝提示词注入导致的 Token 窃取与外传
阅读全文

vLLM Semantic Router 开源 Decision 3.0:0.6B–27B 六款多模态决策模型,官方测评 Jev Decision Index 第一

vLLM Semantic Router(vllm-sr)团队于 10 月 11 日在 Hugging Face 以 Apache-2.0 开源 Decision 3.0 系列(d3、d3-flash、d3-mini、d3-nano、d3-lite、d3-edge),基于 Qwen3.5/3.8,支持文本、图片和视频输入,一次调用直接输出选择题、是/否、打分三类问题的概率而不生成文本。官方口径:27B 旗舰 d3 在 Jev Decision Index 0.3.1 得 64.7,领先 Perplexity Decider v1.1(62.8)和上一代 Decision 2.0(55.9);单张 MI325X 上文本请求中位延迟 55ms。vLLM 官方账号转发祝贺。

vLLM Semantic Router 开源 Decision 3.0:0.6B–27B 六款多模态决策模型,官方测评 Jev Decision Index 第一

核心要点速览

  • 六档尺寸:d3-edge 0.59B、d3-lite 0.85B、d3-nano 2.2B、d3-mini 4.5B、d3-flash 8.4B、d3 26.1B,全部 Apache-2.0(HF 合集)
  • 官方口径 Jev Decision Index 0.3.1:d3 64.7,Perplexity Decider v1.1 62.8,Jev 60.1,Decision 2.0 55.9
  • 视觉榜(Vision Index 0.3.1):d3 71.6,Perplexity Decider v1.1 70.6,JEV-27B-VL 69.6
  • 单张 AMD MI325X、单并发中位延迟:d3 文本 55ms / 图片 273ms / 10 秒视频 553ms;d3-edge 文本仅 6.7ms
  • 不生成文本,直接给每个选项打概率;同一输入可一次问多道 Choice / Yes-No / Score 题
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Decision 3.0⚡ d3⚡ D3 Flash⚡ D3 Edge⚡ Qwen3.5⚡ Qwen3.8🌐 vLLM🌐 vLLM Semantic Router

告别盲目死循环!清华与人大提出增量式深度研究框架 IOEDR:动态图脚手架节省 33% Token 与 61% 搜索调用

以 OpenAI Deep Research、Perplexity Deep Research 为代表的自主深度研究智能体(Deep Research Agents)正在重构人类信息获取与综合分析的范式。然而,面对高度发散、长达数十轮的开放式命题(如行业全景深度报告、复杂技术选型论证),现有智能体普遍采用‘黑盒式单向搜索-汇总’策略,导致三大严重弊端:模型在浩瀚网页中陷入重复无意义搜索、各章节间观点自相矛盾且事实漂移严重、随着探索深入上下文急剧膨胀产生数十万冗余 Token。清华大学与中国人民大学研究团队最新发布重磅成果《Incremental Open-Ended Deep Research with Structured Harness》(arXiv:2610.11566,项目主页:ioedr-project.github.io)。团队提出了增量式深度研究新范式 IOEDR,首次将研究报告生成建模为‘不断进化的层级状态图(Hierarchical State Graph)与全局证据池(Persistent Evidence Pool)’。智能体不再盲目抓取,而是基于结构化脚手架(Structured Harness)驱动探索边界:通过动态大纲增量扩展、证据置信度交叉检验以及目标导向的停机判定,精准填补知识空白。在权威的 DeepResearch Bench 上,IOEDR 不仅将生成报告的事实准确率与多维深度显著提升,更将整体 Token 消耗骤减 33.2%,外部搜索 API 调用次数暴跌 61.4%!

核心要点速览

  • 清华与人大联合提出增量式深度研究框架 IOEDR,将长文研报建模为层级状态图与全局去重证据池
  • 在 DeepResearch Bench 上削减 61.4% 的搜索 API 请求,整体 Token 消耗骤降 33.2%,解决跨章节事实漂移与自相矛盾
  • 结构化脚手架引入信息增益评估与动态停机机制,抗噪过滤率高达 92.4%,为 Deep Research 产品提供高可靠工程范式
阅读全文

Perplexity 开源 pplx-embed-v2-late:0.6B/9B 多模态 ColBERT 检索模型,PDF 免 OCR,小模型可直接查大模型索引

Perplexity 10 月 7 日发布 pplx-embed-v2-late 多模态后期交互(ColBERT)检索模型,0.6B(激活 340M)与 9B(激活 7.4B)两档,基于 Qwen3.5 双向注意力,每个 token 输出 128 维向量并用 MaxSim 打分,可直接检索文本、图片与渲染后的 PDF/幻灯片。两档共享嵌入空间,0.6B 可查询 9B 建好的索引。ViDoRe v3 图像 nDCG@10 为 62.3% / 65.2%,MIT 许可上架 Hugging Face。

核心要点速览

  • ViDoRe v3(公开集)nDCG@10:0.6B 图像 62.3% / Markdown 61.2%,9B 图像 65.2% / Markdown 64.7%(0.6B 模型卡)
  • 官方称 0.6B 在 ViDoRe V3 上可比肩激活参数约 5 倍的模型(Perplexity 博客)
  • 共享嵌入空间:用 9B 建索引、0.6B 做在线查询,压低查询端成本
  • 训练:由内部 18B ColBERT 教师蒸馏(token 级 LEAF 式目标);9B 最后 8 层全量微调,其余层与视觉编码器用 LoRA
  • 上手:需要 sentence-transformers ≥ 6.0.0、transformers ≥ 5.4.0,MIT 许可;文本批与图像批要分开编码(9B 模型卡)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ pplx-embed-v2-late-0.6b⚡ Pplx Embed V2 Late 9b⚡ Pplx Embed V2 Context⚡ Qwen3.5🌐 Perplexity🌐 Hugging Face
AD赞助内容
P
Perplexityperplexity-ai·
👀124
🔥84

Perplexity 开源 pplx-decider-v1.1-27b 决策模型:Decision Index 从 56.4 提到 61.56,反超 Jev 3.6 分

Perplexity 在 Hugging Face 发布 Apache-2.0 的 pplx-decider-v1.1-27b,基于 Qwen3.8-27B,不生成文本而是直接输出带概率的分类/路由/打分答案;Decision Index 总分 61.56(v1 为 56.4,Jev 为 57.9),并可通过 Perplexity Decisions API 调用。

Perplexity 开源 pplx-decider-v1.1-27b 决策模型:Decision Index 从 56.4 提到 61.56,反超 Jev 3.6 分

核心要点速览

  • Decision Index 总分 61.56,比 v1(56.4)高 5.16 分,比 Jev(57.9)高 3.66 分,同一 Qwen3.8-27B 底座
  • 分项:Language 69.45、Retrieval 61.26、Tools 78.88、Knowledge 48.18(仍低于 Jev 的 51.4)
  • 提升主要来自取消全注意力层的因果掩码(noncausal)以及加入 tasksource 等更多训练数据
  • 输出头是 [255, 5120] 的 BF16 readout,不是全词表 lm_head;权重约 49 GiB,需 CUDA GPU
  • 托管调用:POST /v1/decisions,支持 noul / choice / score 三类问题,一次请求可问多个问题(文档)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ pplx-decider-v1.1-27b⚡ Pplx Decider V1 27b⚡ Qwen3.8-27B⚡ Jev🌐 Perplexity

Vercel AI SDK @ai-sdk/perplexity 5.0.0:从 Sonar Chat Completions 迁到 Agent API,预设/工具/用量元数据全换

Vercel AI SDK 于 2026-09-26 发布 @ai-sdk/[email protected]:语言生成路径从 Sonar Chat Completions 切换到 Perplexity Agent API。Sonar 模型 ID 与 provider options 需改为 Agent API 的 presets、models 与 tools;请求/响应元数据、原始流事件、usage/cost 形态均变,且不再支持 Sonar PDF 输入以及 image/video 结果。同提交还补齐 Agent API 终端事件文本恢复、原生 tool traces(如 finance)放行,以及 URL citation 去重与 search result ID 关联。

Vercel AI SDK @ai-sdk/perplexity 5.0.0:从 Sonar Chat Completions 迁到 Agent API,预设/工具/用量元数据全换

核心要点速览

  • 发版:@ai-sdk/[email protected](npm 同步 5.0.0)
  • 破坏性:生成栈迁到 Agent API;Sonar model ID / provider options 需改写为 presets、models、tools
  • 能力边界:不再支持 Sonar PDF 输入与 image/video 结果;usage/cost 与 raw stream 元数据形态变化
  • 流式修复:从 Agent API 终端事件/output items 恢复缺失文本(含 incomplete),并按 content part 跟踪避免重复
  • 引用:URL citation 在流中按 URL 去重,同时保留 search result ID 便于 citation 关联;finance 等原生 tool traces 不再被误当 web search 校验
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 用数百 AI 编程智能体构建 CobbleDB,替换搜索栈 DynamoDB 读路径

Perplexity 仅由 2 名工程师配合数百个 AI 编程智能体,构建了定制 Rust 数据库 CobbleDB,用于替换搜索栈中的 DynamoDB 读取路径。该案例展示了编码智能体在真实基础设施开发中的协作规模,同时明确限制智能体不得运行数据库。

核心要点速览

  • 2 名工程师协调数百个 AI 编程智能体,完成定制 Rust 数据库 CobbleDB
  • CobbleDB 已用于替换 Perplexity 搜索栈中的 DynamoDB 读取路径
  • 智能体参与构建但不被允许运行数据库,体现代码生成与生产权限的隔离
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity:两名工程师+数百 AI 智能体两月建成 CobbleDB,替换 DynamoDB 延迟约降 5×

Perplexity(@perplexity_ai)公布 CobbleDB:由两名工程师与数百个主动常驻 AI 智能体在两个月内建成的键值库,服务搜索网页内容热路径。替换 DynamoDB 后,中位批量读延迟从 31.4 ms 降至 5.60 ms,p99 从 123 ms 降至 24.2 ms,并计划开源供其他 AI 搜索团队使用。

核心要点速览

  • 两名工程师+数百 AI 智能体两月建成生产级 CobbleDB 键值库。
  • 替换 DynamoDB 后中位/ p99 批量读延迟约降 5×(31.4→5.6 ms,123→24.2 ms)。
  • 官方表示计划开源,面向其他 AI 搜索与热路径读负载团队。
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity Portable Computer 登陆 Windows:24GB+ NVIDIA RTX 本地智能体,含本地 MCP 与定时任务

Perplexity 宣布 Portable Computer 现已支持搭载 NVIDIA RTX 的 Windows PC:可在本地运行 harness、智能体与模型,处理本机文件与连接应用,必要时再回退云端前沿模型。本地完成的工作不消耗 Computer 积分;同线程还公布本地 MCP 与无人值守定时任务,NVIDIA 同步确认需 24GB+ VRAM。

核心要点速览

  • Portable Computer 正式支持 Windows + NVIDIA RTX,本地跑 harness/智能体/模型。
  • 本地任务不消耗 Perplexity Computer 积分,可按需请求云端前沿模型。
  • 新增本地 MCP 与定时任务;NVIDIA 侧要求 GeForce/RTX PRO 24GB+ VRAM。
阅读全文
关联模型 / 智能体 / 厂商: