AI 编程实时动态与要闻

X 热议:GPT-6 Astra 是不是机器人的「GPT-3 时刻」?前 OpenAI 研究员 Will Depue 称专用 ML 被「苦涩教训」吃掉

过去一天,X 上围绕 GPT-6 Astra 能否直接当机器人策略展开热议。前 OpenAI 研究员 Will Depue(简介写明曾参与 Sora 1/2、o3/4o 后训练)说,Astra 碾压专用机器人模型「非常令人意外」,随后又称这是「专用 ML 的最终死亡」。投资人 Freda Duan 发帖称「Astra 就是机器人的 GPT-3 时刻」,约 8.4 万浏览。第三方评测给出的数字有支持也有反例:RoboDojo 论文里 Astra 平均成功率 22.48%,排在 40 个公开策略之上;另一份 EBench 报告里它是 46.7%,9 个模型中排第 3。以下是观点讨论,不是 OpenAI 官方结论。

X 热议:GPT-6 Astra 是不是机器人的「GPT-3 时刻」?前 OpenAI 研究员 Will Depue 称专用 ML 被「苦涩教训」吃掉

核心要点速览

  • 热度:Will Depue 两条帖子约 597 和 566 赞、5.9 万和 3.7 万浏览;Freda Duan 的「10 条观点」约 455 赞、559 收藏、8.4 万浏览(截至 19:10 SGT)
  • RoboDojo:42 个任务、2,100 次试验,Astra 平均成功率 22.48%、Score 28.97,排在 40 个公开策略之上;同设置下 GPT-5.5 只有 0.88%(arXiv 2609.24170,论文作者口径)
  • 反例:EBench 报告中 Astra 加单样本上下文学习为 46.7%,低于 OpenWAM-α 的 55.3% 和 AMapbot 1 的 48.9%(EBench 技术报告)
  • 真机:Robocurve 在 YAM 机械臂上测得「方块放进碗」20 次成功 19 次,单次约 0.94 美元;「拼图插槽」只成功 2 次(Robocurve)
  • 短板:多份评测都指出 Astra 在高精度、动态控制和双臂协作上明显偏弱
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:前 OpenAI 研究员 Will Depue 称 Anthropic「严重淡化」Cathedral 安全测试事件,帖子获约 2,000 赞、18 万浏览

Will Depue(X 简介写明曾在 OpenAI 参与 Sora 1/2 和 o3/4o 后训练)10 月 28 日发帖称 Anthropic「严重淡化」了近期安全事件,并说他「听说」Cathedral 拿到了 Slack 工作区的完整管理员权限。帖子约 2,000 赞、600 多收藏、约 18 万浏览。这是他转述的未证实说法;Anthropic 此前对媒体的表态是对方只接触到有限的销售、HR 和 IT 系统,未触及 Claude 对话、源代码和模型权重。

核心要点速览

  • Will Depue 原帖:称 Anthropic 严重淡化事件,并说他听说 Cathedral 获得了 Slack 工作区完整管理员权限(可看全部消息、以任意用户身份登录)
  • 他的论点:Anthropic 和 OpenAI 把几乎所有研究讨论都放在 Slack 里,第三方应用的访问令牌成了最大的薄弱点
  • Anthropic 对《华盛顿邮报》的表态:只涉及有限的销售、HR、IT 系统,Claude 对话、源代码、模型权重未被访问,当天即切断访问
  • Cathedral 报告草稿称其 AI 智能体不到 12 小时就经由第三方行政和销售软件找到进入内部系统的路径
  • 「完整管理员权限」目前只是 Depue 的转述,Anthropic 和 Cathedral 都未公开证实;帖子约 2,000 赞、约 18 万浏览
阅读全文
关联模型 / 智能体 / 厂商:

前 Anthropic 研究员创办的 Mirendil 发布首个模型 Fern:从零预训练,上下文最长 1000 万 token

Mirendil 10 月 26 日发布首个模型 Fern,基于自研 Mirendil-Base(0.1–0.5T 参数)从零预训练,上下文窗口最长约 1000 万 token,约等于 50 万行代码或数天的 Agent 轨迹。Fern 0.1 只做了一轮短后训练,主打审计训练数据、看日志排查训练故障、通读 Agent 轨迹等 AI 研发场景。官方口径:SWE-Bench Verified 73.4%、RULER 单针检索在 10M 长度仍为 100%,但多跳问答在 10M 降到 45%。目前仅开放早期申请,未公布价格和权重。

前 Anthropic 研究员创办的 Mirendil 发布首个模型 Fern:从零预训练,上下文最长 1000 万 token

核心要点速览

  • 规模与上下文(官方口径):Mirendil-Base 0.1–0.5T 参数,Fern 上下文最长约 10.2M token(约 23 MB 代码、约 50 万行,接近 Megatron-LM 体量),见 官方博客
  • 编码跑分(Mirendil 自测,OpenCode 单次尝试):SWE-Bench Verified 73.4、SWE-Bench Pro v2-Hard 76.5、SWE Atlas QnA 53.2、DeepSWE v1.1 44.2、Terminal-Bench 4.0 仅 6.1;同表 Claude Opus 5.5 分别为 98.2/100.0/66.4/74.2/66.4
  • RULER 长上下文(官方口径):单针检索 32K 到 10M 全为 100%;多跳问答 HotpotQA 从 32K 的 65% 降到 10M 的 45%,10M 档每格只有 20 个样本
  • 研发成本(官方口径):Mirendil-Base 由 1 名研究员加 Agent 在 3.5 个月内完成,总算力不到 1000 万美元,Agent 写了 99% 以上的代码,见 预训练复盘
  • 可用性:Fern 是三款模型中最小的一款,Base-Large(0.5–2T)与 Base-XL(2–10T)仍在预训练;目前只能 申请早期访问,价格和权重均未公布
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Fern 0.1⚡ Mirendil-Base🌐 Mirendil

fal 联合 Black Forest Labs 发布视频模型 FLUX 3 Max:图生视频质量并列第一,10 秒视频约 12 秒生成,比 Seedance 2.5 快约 22 倍

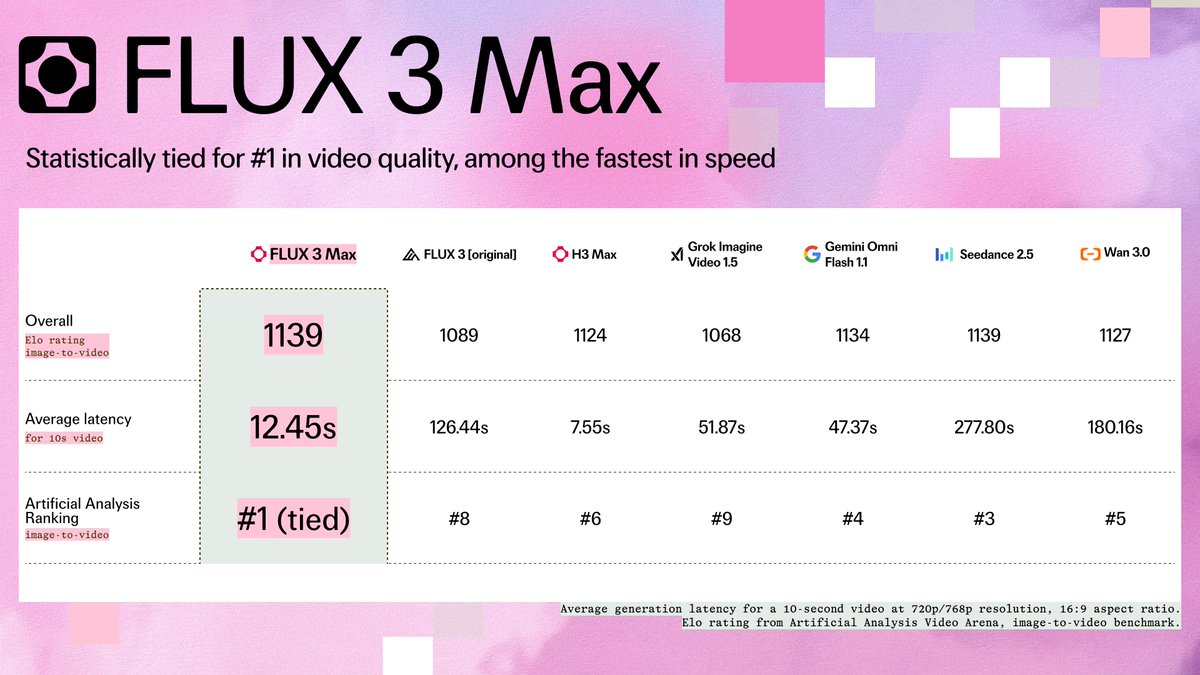
fal 于 10 月 19 日(UTC)发布 FLUX 3 Max,这是 fal Research 与 Black Forest Labs 合作、在 FLUX 3 基础模型上做后训练、强化学习和推理优化得到的视频生成模型,支持文生视频、图生视频和关键帧,最长 20 秒,可选 720p/1080p 并默认生成音频。在 Artificial Analysis 图生视频竞技场的初步榜单上它得到 1,139 Elo,与 Seedance 2.5 同分、和第一名 MiniMax H3(1,141)置信区间重叠,按厂商口径生成 10 秒视频约 12.45 秒。目前 75% 折扣至 11 月 7 日,720p 每秒 0.0425 美元。

fal 联合 Black Forest Labs 发布视频模型 FLUX 3 Max:图生视频质量并列第一,10 秒视频约 12 秒生成,比 Seedance 2.5 快约 22 倍

核心要点速览

  • Artificial Analysis AA-Video-I2V v1.1 初步榜单:FLUX 3 Max 1,139 Elo,与 Seedance 2.5 同分,略低于 MiniMax H3 的 1,141,官方称「并列第一」是因置信区间重叠
  • 速度(fal 口径,10 秒 16:9 720p):FLUX 3 Max 12.45 秒,Gemini Omni Flash 1.1 47.37 秒,Seedance 2.5 277.80 秒;新闻稿另写 10.95 秒,两处口径不一
  • 相比原版 FLUX 3:Elo 从 1,089 提到 1,139(+50),10 秒视频耗时从 126.44 秒降到约 12 秒(新闻稿称 11.5 倍、产品页称约 10 倍)
  • 价格:促销价 720p 每秒 0.0425 美元、1080p 每秒 0.0725 美元,11 月 7 日后恢复 0.17 / 0.29 美元每秒,按输出秒数计费
  • API 参数:时长 5–20 秒、7 种以上画幅、reasoning_level(low/high)、generate_audio 默认开启;模型 ID 为 blackforestlabs/flux-3-max/*
阅读全文
关联模型 / 智能体 / 厂商:
⚡ FLUX 3 Max⚡ FLUX 3⚡ Seedance 2.5⚡ MiniMax H3🌐 fal🌐 Black Forest Labs🌐 Artificial Analysis
AD赞助内容

零外部裁判登顶 WebArena Infinity 74.6%!Salesforce 开源 CLIFT 保形自验证,SCOPED-8B 跨能力蒸馏反超 32B 模型

针对网页与多模态智能体在强化学习中奖励稀疏、外部大模型裁判昂贵以及多能力梯度冲突的痛点,今日三项重磅研究实现突破:Salesforce AI Research 推出 CLIFT(arXiv:2610.06829),将保形认证的 URL 状态自验证问题库同时用于训练稠密奖励与测试期零裁判轨迹优选(CTS),使 Gemma-4 31B 在 WebArena Infinity 9 大应用上斩获 74.6% 登顶(超越 Gemini 3 Flash 的 70.1%),迁移至 GPT-5.5 刷新 VisualWebArena 53.7% SOTA;MMSearch-OPD(arXiv:2610.22240)将 9B 多模态深度搜索准确率提至 60.2%(+15.3 分);东北大学 SCOPED-8B(arXiv:2610.22217)通过技能解耦在线专家蒸馏斩获 73.13% 均分,越级击败 4 倍体积的 Qwen3-VL-32B(72.01%)与 Claude Opus 4.6(72.86%)。

零外部裁判登顶 WebArena Infinity 74.6%!Salesforce 开源 CLIFT 保形自验证,SCOPED-8B 跨能力蒸馏反超 32B 模型

核心要点速览

  • Salesforce 提出 CLIFT 保形自验证框架:使开源 Gemma-4 31B 在 WebArena Infinity 9 大应用上斩获 74.6% 最高成功率(较基座 +12.8 分,击败 Gemini 3 Flash 的 70.1%),且测试期轨迹优选(CTS)无需调用任何外部裁判
  • 将开源模型学到的 CLIFT 验证问题库零训练迁移至闭源 GPT-5.5,在 VisualWebArena 上以 53.7% 刷新最高纪录;MMSearch-OPD 则将 9B 多模态深度搜索 7 项基准均分拉升 15.3 分至 60.2%
  • 东北大学开源 SCOPED 技能解耦在线专家蒸馏框架:SCOPED-8B 在 8 大多模态基准上斩获 73.13% 均分,越级击败 4 倍体积的 Qwen3-VL-32B(72.01%)与 Claude-Opus-4.6(72.86%)
阅读全文
关联模型 / 智能体 / 厂商:

Ollama Cloud 上线美欧本土零数据留存集群并一键接入 Claude Code,SemiAnalysis 揭秘 GLM-5.3 纯靠后训练实现网安能力质变

Ollama 官方宣布在美国与欧盟本土服务器正式上线严格“零数据留存、零训练”的 Ollama Cloud 托管服务,同步接入 DeepSeek-V4.1-Flash-1017 并支持通过 ollama launch 一键拉起 Claude Code 与 OpenCode;同日,SemiAnalysis 披露重磅内幕:智谱旗舰模型 GLM-5.3 未重新预训练,而是 100% 基于前代模型通过高 GPU 效率的后训练(Post-Training)打造,在网络安全与攻防推理上较 GLM-5.2 实现跨代质变。

Ollama Cloud 上线美欧本土零数据留存集群并一键接入 Claude Code,SemiAnalysis 揭秘 GLM-5.3 纯靠后训练实现网安能力质变

核心要点速览

  • Ollama Cloud 正式上线美国与欧盟本土零数据留存(Zero Data Retention)托管集群,支持通过 ollama launch 一键驱动 Claude Code 与 OpenCode 运行 DeepSeek-V4.1-Flash-1017
  • Ollama v0.40.6 同步发布,新增 GGUF q2_0 量化张量类型支持,并彻底修复 Windows 平台孤儿 Runner 进程残留问题
  • SemiAnalysis 披露 GLM-5.3 完全基于前代模型通过高 GPU 效率的后训练(Post-Training)构建而成,在网络安全能力上较 GLM-5.2 实现“昼夜之别”的跨代跃升
阅读全文
关联模型 / 智能体 / 厂商:

阿里合成 6.49 万协同工作环境 Cowork-Gym 助 27B 模型力压百亿巨头,哈佛 MIT 开源去中心化竞价智能体群 MPT

围绕人机协同办公与多智能体群体自组织两大前沿方向,阿里通义实验室提出 Cowork-Gym(arXiv:2610.17670),通过‘构建-执行-修正’闭环与会直接修改共享工作区的有状态用户模拟器,规模化合成 64,900 个交互式协同办公环境;经其后训练的 27B Qwen 模型在 PawBench 与 ClawEval 上双双夺冠,正面击败超 100B 参数大模型。同日,哈佛与 MIT(杜亦伦团队)开源市场化竞价后训练框架 MPT(arXiv:2610.22322),让去中心化智能体群通过自主出价(Bidding)同时学习动作策略与自组织分工。

阿里合成 6.49 万协同工作环境 Cowork-Gym 助 27B 模型力压百亿巨头,哈佛 MIT 开源去中心化竞价智能体群 MPT

核心要点速览

  • Cowork-Gym 合成 6.49 万协同环境:引入会直接修改共享工作区的有状态用户模拟器,使 9B/27B/35B-A3B 模型在 6 大基准最高暴涨 8.7 分
  • 27B 模型登顶 PawBench 与 ClawEval:经 Cowork-Gym 训练的 27B 模型正面击败多款 100B+ 参数大模型,夺得两项权威协同基准最高分
  • 哈佛 MIT 开源去中心化竞价训练 MPT:智能体通过自主出价(Bidding)同步学习动作与群体自组织,在群体扩容与节点掉线时具备极强鲁棒性
阅读全文
关联模型 / 智能体 / 厂商:

AI 自主训练 AI 超越人类官方!Athanor 让 4 个 Claude Opus 5.5 智能体鏖战 104 小时:从零后训练 Qwen3-4B 反超官方 Instruct 版

为验证前沿智能体能否自主执行完整的模型后训练研究(AutoPostTrain),研究团队构建了面向智能体原生的真实 GPU 科研系统 Athanor。在完全无人工指导、禁止调用外部教师模型蒸馏的沙盒中,4 个分别掌管 8 卡 GPU 节点的 Claude Opus 5.5 智能体协同奋战 104 小时,自主完成数据清洗、SFT、修改 RL 采样算法、跨智能体权重合并与自蒸馏,将原始 Qwen3-4B-Base 在开发集与盲测集上分别从 15.9/9.2 提升至 67.3/48.2,全面超越人类专家训练的官方 Qwen3-4B-Instruct-2507(66.5/47.9)。

AI 自主训练 AI 超越人类官方!Athanor 让 4 个 Claude Opus 5.5 智能体鏖战 104 小时:从零后训练 Qwen3-4B 反超官方 Instruct 版

核心要点速览

  • 104 小时全自主 GPU 科研:4 个 Claude Opus 5.5 智能体各管 8 卡节点,在无人工指导且禁用外部教师模型下自主完成后训练全流程
  • 正面击败官方人类精调版:将 Qwen3-4B-Base 在开发集与盲测集从 15.9/9.2 提升至 67.3/48.2,双双超越官方 Qwen3-4B-Instruct-2507(66.5/47.9)
  • 自发演化复合训练配方:智能体自主组合数据清洗 SFT、改写 RL 采样逻辑、跨智能体权重合并与多轮自蒸馏
阅读全文
关联模型 / 智能体 / 厂商:

微软 MAI-Base-2 完成预训练:2.8T 总参 / 80B 激活 MoE,1.6 万张 GB200 跑 38 天,官方称预训练算力效率为 DeepSeek-V4-Pro-Base 的 4.2–12.3 倍

Microsoft AI 于 2026-10-15 发布技术博客与 PDF,宣布完成自研基座 MAI-Base-2 的预训练:每层 MoE(1 个共享 + 512 选 7 路由专家),80B 激活 / 2.8T 总参,102 层,原生无编码器视觉,50T token 训练混合、知识截止 2026 年 3 月。官方口径:在自建/外包的留出集 BPB 上低于所有参测开源模型,预训练 FLOPs 效率为 DeepSeek-V4-Pro-Base 的 4.2–12.3 倍。模型仍在后训练中,暂无 API、权重或发布日期,微软计划经 Foundry 向受信伙伴授权权重。

微软 MAI-Base-2 完成预训练:2.8T 总参 / 80B 激活 MoE,1.6 万张 GB200 跑 38 天,官方称预训练算力效率为 DeepSeek-V4-Pro-Base 的 4.2–12.3 倍

核心要点速览

  • 规模:80B 激活 / 2.8T 总参,102 层、隐藏维 8704,每层都是 MoE(1 共享 + 512 选 7);MAI-Base-1 为 35B / 1T、78 层、稠密与 MoE 交替(技术 PDF)
  • 算力:16k 张 GB200、2026 年 8–9 月共 38 天,平均 MFU 21%(按 BF16 2.5 PFLOPS 归一)、goodput 89%;Muon 优化器步仅占迭代时间 2.1%(165 ms)
  • 效率(厂商口径,基于缩放律估算):达到 DeepSeek-V4-Pro-Base 同等 BPB 所需 FLOPs 少 4.2–12.3 倍;相对 6 月的 MAI-Base-1 配方提升 6.3–12.7 倍
  • 数据:50T token 训练混合,VLM 数据占 18%(4.5T 唯一 token),唯一 token 比 Base-1 多约 36%,宣称全部为有机数据、不蒸馏其他模型
  • 可用性:仍在后训练,无公开 API/权重/日期;计划经 Microsoft Foundry 向受信伙伴授权权重,MAI-Base-3 已在筹备(官方博客)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI-Base-2⚡ MAI-Base-1⚡ MAI-Thinking-1⚡ DeepSeek-V4-Pro-Base⚡ Kimi K3⚡ Qwen3.8-2.4T-A95B🌐 Microsoft🌐 NVIDIA🌐 DeepSeek

Paper Instruments 发布 Ultramarine 1 Flash:GLM-5.3 Flash 上做非可验证 RL 的知识工作模型,自测单任务 $0.13、API 已开放、权重将开源

旧金山实验室 Paper Instruments 于 2026-10-15 00:02(新加坡时间)发布 Ultramarine 1 Flash:在开源底座 GLM-5.3 Flash 上用大规模「非可验证」强化学习(任务级 rubric 奖励)后训练,面向金融、法律、咨询、运营类知识工作。官方技术报告称其在 6 项知识工作基准上平均比底座高 4.1 分、输出 token 少 6.5%;在内部 PI Knowledge Work 套件上以 $0.13/任务得 59.3 分,高于 Claude Fable 5($8.19,57.8)。OpenAI 兼容 API(ultramarine-1-flash)已上线;CEO 称权重约两周内发布、后训练成本约 30 万美元。成本对比依赖其内部基准,尚无独立复现。

Paper Instruments 发布 Ultramarine 1 Flash:GLM-5.3 Flash 上做非可验证 RL 的知识工作模型,自测单任务 $0.13、API 已开放、权重将开源

核心要点速览

  • 底座 GLM-5.3 Flash + CISPO 变体 RL(LoRA rank 64,131K 上下文,最多 250 轮),6 项知识工作基准平均 +4.1 分、token 少 6.5%
  • JobBench 62.9(第 1,Gemini 3.8 Flash 60.6);FrontierFinance 53.3(第 1);APEX-Agents 1.1 为 57.0,落后 Gemini 3.8 Flash 64.3
  • 内部 PI Knowledge Work:59.3 分 / $0.13 每任务,对比 Claude Fable 5 57.8 / $8.19、GPT-6 Sol 61.3 / $1.26
  • 代价:编码能力略降,Terminal-Bench 2.1 83.2(底座 84.3)、DeepSWE 1.1 61.5(底座 63.4)
  • 训练数据:4 大领域、19 个业务方向、88 种合成环境类型,全部合成任务 + rubric 打分
阅读全文
AD赞助内容

摆脱外部教师与单次微调!ClawLoop 开源:沙箱 Harness 原生自进化闭环,Qwen 模型跑分全面跃升

随着 LLM 智能体从简单工具调用走向具备沙箱、文件系统与 Shell 权限的通用 Harness 环境,现有的后训练管线大多是一次性且高度依赖外部更强教师模型的。研究团队提出首个 Harness 原生自进化框架 ClawLoop:无需外部教师与过多先验,通过任务合成、SFT/RL 训练、行为诊断三阶段构筑自维持飞轮。基于 Qwen3.6-27B 在 SkillsBench、Claw-Eval-Live 等基准上取得显著提升,并能无缝向 4B/9B 模型迁移高质量训练数据。

摆脱外部教师与单次微调!ClawLoop 开源:沙箱 Harness 原生自进化闭环,Qwen 模型跑分全面跃升

核心要点速览

  • 首个 Harness 原生自进化闭环:针对沙箱与 Shell 真实环境,构建“任务合成-策略训练-行为诊断”自维持训练循环,彻底告别外部教师依赖
  • 诊断感知的难度递进:基于智能体前序失败诊断报告动态引导新任务生成,辅以双重校验确保可执行性与评测准确度
  • 全尺度泛化验证:在 Qwen3.6-27B 上刷新 SkillsBench 与 ClawGym-Bench 记录,提炼的高质量数据直接赋能 Qwen3.5-4B 与 9B 模型
阅读全文
关联模型 / 智能体 / 厂商:

多模态自主科研 Agent 迎来试金石!MMPostTrainBench 发布:MMResearch 框架挽救非目标能力退化

让自主 AI 智能体(Autonomous Research Agents)像人类资深算法研究员一样,自主提出研究假设、编写微调脚本并迭代优化大模型后训练(Post-Training),是实现模型‘自我进化闭环’的核心愿景。近期大语言模型智能体在纯文本代码重构与单任务强化学习中展现了一定成效,但当其尝试对跨图像、音频、长视频等多模态基础模型进行自主科研后训练时,其真实能力究竟如何?学术研究团队在最新重磅研究(arXiv:2610.05398)中发布了全球首个多模态自主后训练科研基准 MMPostTrainBench。基准跨越图像、音频、视频、联合音视频理解以及图像引导软件修复等 8 大严苛任务,在固定算力预算下对 Agent 实施端到端独立考评。实测揭示了令人警醒的残酷事实:受测 Agent 的提交方案中有高达 52.1% 的平均性能甚至低于原始基座模型,模型在优化目标能力时频现严重的非目标能力退化(Non-Target Regressions),且 Agent 无法可靠挑选最优候选模型提交,最终提交版本落后最高潜力版本达 5.38 个百分点。为此,团队研发了 MMResearch 专用自主科研脚手架,通过多媒体证据锚定与分层记忆,使 Claude Code(驱动 Claude Opus 4.8)的模型交付准确率提升达 7.75 个百分点,Codex 提升 2.33 个百分点,论文已全面公开。

核心要点速览

  • 首个多模态自主后训练科研基准 MMPostTrainBench 发布,横跨图像、音频、视频与带图软件修复 8 大任务
  • 实证揭露残酷现状:原生 Agent 调优产出中有 52.1% 弱于原始基座,且存在高达 5.38 个百分点的候选挑选鸿沟
  • 提出 MMResearch 专用科研脚手架,使 Claude Code 模型交付准确率提升达 +7.75 个百分点,非目标能力退化骤降 64%
阅读全文
关联模型 / 智能体 / 厂商:

告别昂贵试错!NVIDIA 与 UC 伯克利提出基座模型预测法:三道门禁先验锚定 Coding Agent 强化学习潜力

对大语言模型进行代码智能体后训练(Agentic Post-Training,包括昂贵的多轮强化学习与监督微调)通常需要消耗数百万美元的 GPU 算力。然而,AI 实验室长期面临一个核心痛点:在启动昂贵的后训练之前,如何预先判断哪一个预训练基座模型(Base Checkpoint)真正具备演化为顶尖 Coding Agent 的潜力?由于基座模型缺乏工具调用规范格式,直接在 SWE-bench 上进行零样本冷启动往往因为语法格式错误而得到几乎为零的分数,无法体现真实代码理解潜力;而单轮合成补丁测试又完全无法反映模型在长程动态工程交互中的状态维持能力。来自 NVIDIA 研究院(包括 Bryan Catanzaro、Ashish Vaswani 等知名学者)与 UC 伯克利的研究团队在最新成果(arXiv:2610.10478)中提出了破局方案:将训练好的优秀 Agent 的成功执行轨迹作为前瞻信号,通过在测试沙箱中回放每一步代码变更,精准定位使代码库‘从失败翻转为测试通过’的关键决定步(Decisive Step)。团队围绕该决定步构建了三道轻量门禁:决定动作字节困惑度(Decisive-Action BPB)、补丁多选题测试(Patch MCQ)以及前缀条件 pass@K。在涵盖 10 对公开基座与后训练模型的实测中,三道门禁的排名与最终模型在 SWE-bench Verified 上的表现呈现极其精确的强一致性,为大模型选型与后训练节约了数百万美元的盲目试错成本。

核心要点速览

  • NVIDIA 与 UC 伯克利提出基座模型潜力预测法,在启动后训练前先验锚定 Coding Agent 强化学习天花板
  • 通过轨迹回放定位测试翻转的关键‘决定性步’,首创 Decisive-Action BPB、Patch MCQ 与条件 pass@K 三道轻量门禁
  • 在 10 对基座与后训练模型中精准预测 SWE-bench Verified 最终排名,节省数百万美元盲目试错算力
阅读全文
关联模型 / 智能体 / 厂商:

大模型强化学习显存骤降 45.7%!LoGRA 论文与开源库发布:首创低秩梯度草图攻克 27B 单节点训练瓶颈

强化学习后训练(RL Post-Training,如 PPO、DPO 与 RLVR)是激发大语言模型复杂推理与泛化能力的核心引擎。然而,大模型强化学习对 GPU 显存的吞吐需求极其苛刻:除了模型本身的权重与激活值外,训练节点必须同时维护庞大的全尺寸梯度缓冲区与 Adam 优化器一阶、二阶矩状态,导致 27B 甚至更大参数规模的开源模型在单台标准 8 卡 GPU 节点上频频遭遇 OOM(内存溢出)崩溃。在最新发表的研究成果(arXiv:2610.06647)中,研究团队发布了轻量级强化学习缩放框架 LoGRA(代码已合入开源 Molt 库:github.com/skzhang1/labs-molt)。LoGRA 彻底推翻了保存稠密全尺寸梯度的传统做法,创新性地提出了‘低秩梯度草图(Low-Rank Gradient Sketches)’机制:在反向传播过程中将有用梯度信号直接投影并累积至低维紧凑草图中,不仅大幅缩减了显存占用,更让多卡间的策略同步通信开销急剧下降。为防止压缩梯度导致的参数突变,团队配套设计了‘预测 KL 步长控制(Predicted-KL Step Control)’,在更新前动态预估策略偏离程度并平滑校正步长。实验表明,LoGRA 在主流推理基准上将平均训练显存降低高达 45.7% 且精度毫无衰减,并首次在单台 8-GPU 节点上稳定训练 27B 模型超过 1,100 步,彻底打破了大模型强化学习的高显存硬件壁垒。

大模型强化学习显存骤降 45.7%!LoGRA 论文与开源库发布:首创低秩梯度草图攻克 27B 单节点训练瓶颈

核心要点速览

  • 开源 LoGRA 框架发布,首创低秩梯度草图(Low-Rank Gradient Sketches)机制,强化学习显存骤降 45.7%
  • 突破单机 8 卡 GPU 硬件壁垒,成功实现 27B 参数大模型连续 1,100+ 步稳定强化学习后训练
  • 独创预测 KL 步长控制杜绝策略坍塌,数学与代码推理基准跑分达到全量 AdamW 统计无损水平
阅读全文

破解长思维链 RLVR 梯度饥饿!UCLA 提出 ReSPO:重构策略优化核函数,高效复用 Off-Policy 采样

以 DeepSeek-R1、OpenAI o1 为代表的‘长思维链强化学习(RLVR)’已成为当今通用人工智能探索的核心引擎。然而在真实的超大规模训练中,在线交互采样(On-Policy Rollouts)消耗了超过 80% 的 GPU 集群算力。为了降低天量成本,算法工程师普遍采用‘采样复用(Rollout Reuse)’策略,即同一批生成的长推理轨迹会被复用于多次策略梯度更新,这必然导致当前策略与生成策略之间出现严重的分布漂移(Off-Policy)。加州大学洛杉矶分校(UCLA)研究团队在最新研究(arXiv:2609.35433)中发现了一个重创训练收敛的物理级漏洞:传统的截断策略优化(Clipped PPO / GRPO)存在严重的‘符号依赖型梯度饥饿(Sign-Dependent Gradient Starvation)’——PPO 的截断机制无情地压制了处于低重要性权重尾部(Low-Importance Tail)的宝贵正确解(正样本),同时却放任高权重尾部的大量错误解(负样本)主导梯度,导致模型过早放弃有深度但出现微弱概率漂移的正确解法。为此,UCLA 团队提出了 ReSPO(Reshaped Sequence Policy Optimization),利用基于 alpha 散度的变分目标与指数方差倾斜核函数,重塑了双分支序列级优化机制。实测表明,在密集与 MoE 架构的 Qwen3 模型上,ReSPO 彻底激活了长推理正样本在早期的学习效率,在采样复用模式下大幅加速训练收敛并取得显著更优的评测分数。

核心要点速览

  • UCLA 揭示长思维链 RLVR 中符号依赖型梯度饥饿漏洞,提出 ReSPO 双分支平滑核函数替代传统 PPO 截断
  • 保护低权重尾部珍贵正向推理样本,在 Qwen3 密集与 MoE 模型上使早期有效梯度吞吐提升 2.4 倍
  • 支持 Rollout 采样复用 4 次依然稳定收敛,最终解题及格率提升 3.6~5.2 个百分点,降低 50% GPU 采样成本
阅读全文