AI 编程实时动态与要闻

X 热议:马斯克称 Grok Bot 服务成本相对收入过高,Replit CEO Amjad Masad 警告「补贴型 AI 订阅要被收割了」

有用户在 X 上抱怨本周期 Grok Bot 额度提前用完,马斯克回复称「Grok Bot 的服务成本相对收入高得不可持续」,该回复获 1.3 万赞、550 万浏览。Replit CEO Amjad Masad 随后转引称「享受补贴型 AI 订阅的人准备好被收割」,引发关于 AI 包月订阅定价是否可持续的讨论。以下为 X 讨论与当事人观点,xAI 未发布正式的定价或额度调整公告。

核心要点速览

  • 起点:用户 @DogecoinNorway 称 Grok Bot 用量已到 100%,距重置还有 4 天,帖子约 124 万浏览。
  • 马斯克回复:Grok Bot 的服务成本相对收入高得不可持续,约 1.32 万赞、551 万浏览、1,900 余次引用。
  • Amjad Masad(Replit CEO)转引称补贴型 AI 订阅将被「rug pull」,约 2,347 赞、14.6 万浏览;他在回复中称 Replit「从未补贴」。
  • xAI 未发布正式的额度或定价调整公告,具体变化以官方说明为准。
阅读全文

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

美团 LongCat 团队 11 月 2 日在 API 平台更新日志中上线 LongCat-2.5,这是 9 月 25 日 LongCat-2.5-Preview 的正式版。官方技术博客称它总参数 1.6 万亿、每个 token 激活约 480 亿,在 LongCat-2.0 基础上强化原生视觉理解和智能体编程,训练和 W4A4 推理都在国产 AI 加速卡上完成。官方口径成绩包括 Terminal Bench v2.1 88.4、Terminal Bench v4.0 38.5、BrowseComp 91.9、MCP Atlas 83.1。API 支持 OpenAI 和 Anthropic 两种格式,1M 上下文、最多 128K 输出,限时价每百万 token 输入 $0.30、缓存输入 $0.006、输出 $1.20。

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

核心要点速览

  • 规模:1.6 万亿总参数 MoE,每 token 激活约 480 亿;1M 上下文、最高 128K 输出(官方博客、API 文档)
  • 代码智能体(官方口径):Terminal Bench v2.1 88.4(Claude Opus 5 89.1、GPT-5.6-Sol 88.8)、Terminal Bench v4.0 38.5(GPT-5.6-Sol 37.3、Claude Opus 5 53.9)、DeepSWE v1.1 64.6
  • 通用智能体(官方口径):BrowseComp 91.9、MCP Atlas 83.1、AutomationBench v1.0.6 51.8、HLE w/tools 63.1;相比 LongCat-2.0 的 AutomationBench 15.8 大幅提升
  • 价格:限时每百万 token 输入 $0.30(¥2)、缓存输入 $0.006(¥0.04)、输出 $1.20(¥8)(定价页)
  • 工程:W4A4 推理相比 W8A8 基线预填充吞吐 +43.3%、解码吞吐 +42.77%;长序列 SFT 中 FSDP 单卡吞吐比 DDP 基线高 86%
阅读全文

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

语音模型公司 Cartesia 于 10 月 29 日发布 Managed Agents,一个面向企业电话场景的端到端语音 agent 平台,把自家语音识别、语音合成模型与 agent 框架一起设计调优,并自带电话接入、知识库、工具调用和批量外呼。官方称它在 Artificial Analysis 的 Speech Agent Arena 中以 1115 Elo 排第 1,在 ServiceNow 的 EVA-Bench 上拿到 87.4% 准确率和 90.7% 体验分(均为厂商口径,推理模型为 GPT-5.5);上线期价格打五折,为每分钟 0.03 美元。

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

核心要点速览

  • Artificial Analysis Speech Agent Arena 盲测偏好中,Managed Agents 以 1115 Elo 在 30 个 agent 中排第 1,高于 Gemini 3.1 Flash Live Minimal(1099)、Grok Voice 3.0(1064)和 GPT-Live-1(1041)(Cartesia 博客,厂商引用口径)
  • ServiceNow EVA-Bench 200 多个客服、IT 服务和 HR 场景首轮成绩:准确率 87.4%、体验分 90.7%,对比 Grok Voice 3.0 为 73.7%/71.2%、GPT Realtime 2.1 为 59.0%/61.6%(EVA-Bench)
  • 以上跑分都以 GPT-5.5 作为推理模型;Cartesia 内部评测称 85% 的通话没有抢话/打断问题,其他 agent 为 67%
  • 上线期五折,每分钟 0.03 美元;官方称该平台此前已在金融、零售、酒店、医疗场景跑过数千万次对话
  • 支持 44 种语言,目前英语、西班牙语、印地语、法语、日语可在通话中途切换,其余语言「即将支持」
阅读全文

AWS GovCloud 上线 OpenAI Daybreak Red(GPT-5.6 Cyber):仅限认证防御方,输入 $16.875、输出 $101.25 每百万 token

AWS 10 月 30 日宣布,OpenAI 面向漏洞研究的网安模型 Daybreak Red(GPT-5.6 Cyber,模型 ID openai.gpt-5.6-cyber)在 Amazon Bedrock 的 AWS GovCloud (US-East) 上线,此前只在 US East (Ohio) 提供。需先通过 OpenAI 的 Daybreak 资格审核。GovCloud 短上下文定价为输入 $16.875、输出 $101.25 每百万 token,比 Ohio 的 $13.75 / $82.50 高约 23%。

核心要点速览

  • 区域:Daybreak Red 现在可在 us-east-2(Ohio)和 us-gov-east-1(GovCloud US-East)两地 In-Region 调用,不支持 Geo 或 Global 跨区推理(AWS 公告)
  • 门槛:必须先加入 OpenAI 的 Daybreak / Trusted Access for Cyber 计划,审核通过后再由 AWS 客户团队开通
  • 定价:GovCloud 短上下文(272K 输入 token 以内)每百万 token 输入 $16.875、30 分钟缓存写入 $21.09375、缓存读取 $1.6875、输出 $101.25
  • 数据:AWS 称推理数据不用于训练,无需把 Daybreak Red 数据分享给 OpenAI,运行在芯片级强制零运维访问的推理引擎上
  • 接口:走 bedrock-mantle 端点,支持 OpenAI Responses 与 Chat Completions,上下文窗口 1,050,000 token
阅读全文
AD赞助内容

Google 发布 Gemini 4 Carbon:Argon 两周后再推前沿模型,Artificial Analysis v5 指数 59 居首,网络安全与长程编码 SOTA,先向 Fairwind 计划内的网络防御者开放

Google DeepMind 10 月 28 日发布 Gemini 4 Carbon,称其为目前最强模型,距 Gemini 4 Argon 上线仅两周。官方博客称它在 Artificial Analysis 智能指数 v5.0 以 59 分排名第一,并在网络安全三项评测领先:SEC-bench Pro 找漏洞 88.2%、ExploitGym 漏洞利用 54.8%、CWE-bench 打补丁 71.0%;WebDev Arena 涨 89 分至第 4(1769)。本周起先向 Fairwind 计划中的部分网络防御者开放,之后再面向开发者、企业和消费者。介绍期价格与 Argon 相同,每百万输入 / 输出 token 2 / 10 美元,之后为 4 / 20 美元。

Google 发布 Gemini 4 Carbon:Argon 两周后再推前沿模型,Artificial Analysis v5 指数 59 居首,网络安全与长程编码 SOTA,先向 Fairwind 计划内的网络防御者开放

核心要点速览

  • 定位:Google 称其为「最强模型」,主打网络安全和长程智能体任务,内部团队观察到它可连续运行数天,在大型代码库和底层系统中定位并修复隐蔽 bug
  • 官方跑分(无护栏评测):SEC-bench Pro 88.2%、ExploitGym 54.8%、Collinear CWE-bench 71.0%;Artificial Analysis 智能指数 v5.0 为 59 排名第一;WebDev Arena +89 至第 4(1769)
  • 安全与对齐:Terminal-Bench 4.0 作弊成功率降到 0.0%(尝试率 0.4%),内部实测高严重度失准告警降近 80%,无依据陈述约为 Argon 的一半,Gray Swan 间接提示注入攻击成功率从 Argon 的 0.7% 降到 0.0%
  • 内部案例:生成安全代码成功率是 Argon 的 2 倍以上;Chrome 团队称其生成高质量补丁的表现比另一家实验室的大型前沿模型好 10 倍以上
  • 开放节奏:本周先给 Fairwind 计划内部分网络防御者,并参与美国政府自愿的发布前测试;开发者 API 尚未开放,介绍期 2 / 10 美元每百万 token,缓存输入按输入价的 5% 计,之后 4 / 20 美元
阅读全文

X 热议:Greg Isenberg 称 SaaS 正在变免费,CRM 和仪表盘白送、只为干活的 Agent 收费

创业者、Late Checkout CEO Greg Isenberg(@gregisenberg,约 75 万关注)10 月 27 日在 X 上发帖:「SaaS 正在变免费:CRM、仪表盘、App 都白送,只为真正干活的 Agent 收费。」帖子发出约 7 小时内获得约 10.9 万次浏览、1,526 个赞、277 条回复和 37 次引用,大量创业者在讨论按座席收费转向按 Agent 完成的工作收费是否成立。这是观点讨论,不是任何公司的定价发布。

X 热议:Greg Isenberg 称 SaaS 正在变免费,CRM 和仪表盘白送、只为干活的 Agent 收费

核心要点速览

  • 互动量(截至 2026-10-28 03:10 UTC,X API 公开数据):约 10.9 万次浏览、1,526 个赞、746 次收藏、277 条回复、37 次引用
  • 原帖观点:CRM、仪表盘和 App 本身免费,收费点改为替用户完成工作的 AI Agent
  • 最常见的质疑:按「工作」收费必须先书面定义什么算完成、谁来验收、每月上限是多少,否则无法计费
  • 另一派认为企业仍会为记录系统(system of record)付费,SaaS 厂商反而免费提供 MCP 接口让外部 Agent 读写
  • 这是创业者观点讨论,不代表任何公司已调整定价
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Dario Amodei 称 Claude 有的 token 只值几美分、有的值数千万美元,主张按结果定价

投资人 Guillermo Flor(@guilleflorvs)10 月 26 日在 X 上转发了一段 Anthropic CEO Dario Amodei 的视频片段:Amodei 说 Claude 告诉别人「重启你的 Mac」已经说了约 1000 万次,价值一美元或更少;而告诉药企把一个芳香环移到分子另一端,可能值数千万美元。他预计 AI 会出现按结果付费或像劳动力一样按小时计价的模式。该帖至今约 111 万次浏览、2,600 多个赞,过去一天里大量 AI 从业者和分析人士引用讨论。这是对 CEO 观点的讨论,不是 Anthropic 的定价调整。

X 热议:Dario Amodei 称 Claude 有的 token 只值几美分、有的值数千万美元,主张按结果定价

核心要点速览

  • 互动量(截至 2026-10-28 01:11 UTC,X API 公开数据):约 111 万次浏览、2,611 个赞、1,779 次收藏、364 条回复、326 次引用
  • 观点来源:Anthropic CEO Dario Amodei 的视频片段,由投资人 Guillermo Flor 发布并整理要点;帖子未注明片段出处,不是 Anthropic 官方公告
  • Amodei 的两个例子:「重启你的 Mac」说了约 1000 万次,价值不到一美元;给药企的分子结构修改建议可能价值数千万美元
  • 他预计会出现按结果付费,或像劳动力一样按小时计价的模式,并说这是新行业,会尝试很多种定价方式
  • 现实对比:据该帖引用的 Anthropic S-1,2026 年上半年收入中按用量计费约占 80%、订阅约占 20%;讨论焦点在于按价值定价需要先有可衡量的成本基线
阅读全文
关联模型 / 智能体 / 厂商:

微软 MAI-Image-2.6 与 2.6-Flash 在 Microsoft Foundry 正式 GA,新一代 MAI-Image-2.7-Preview 登上 Image Edit Arena 第 3

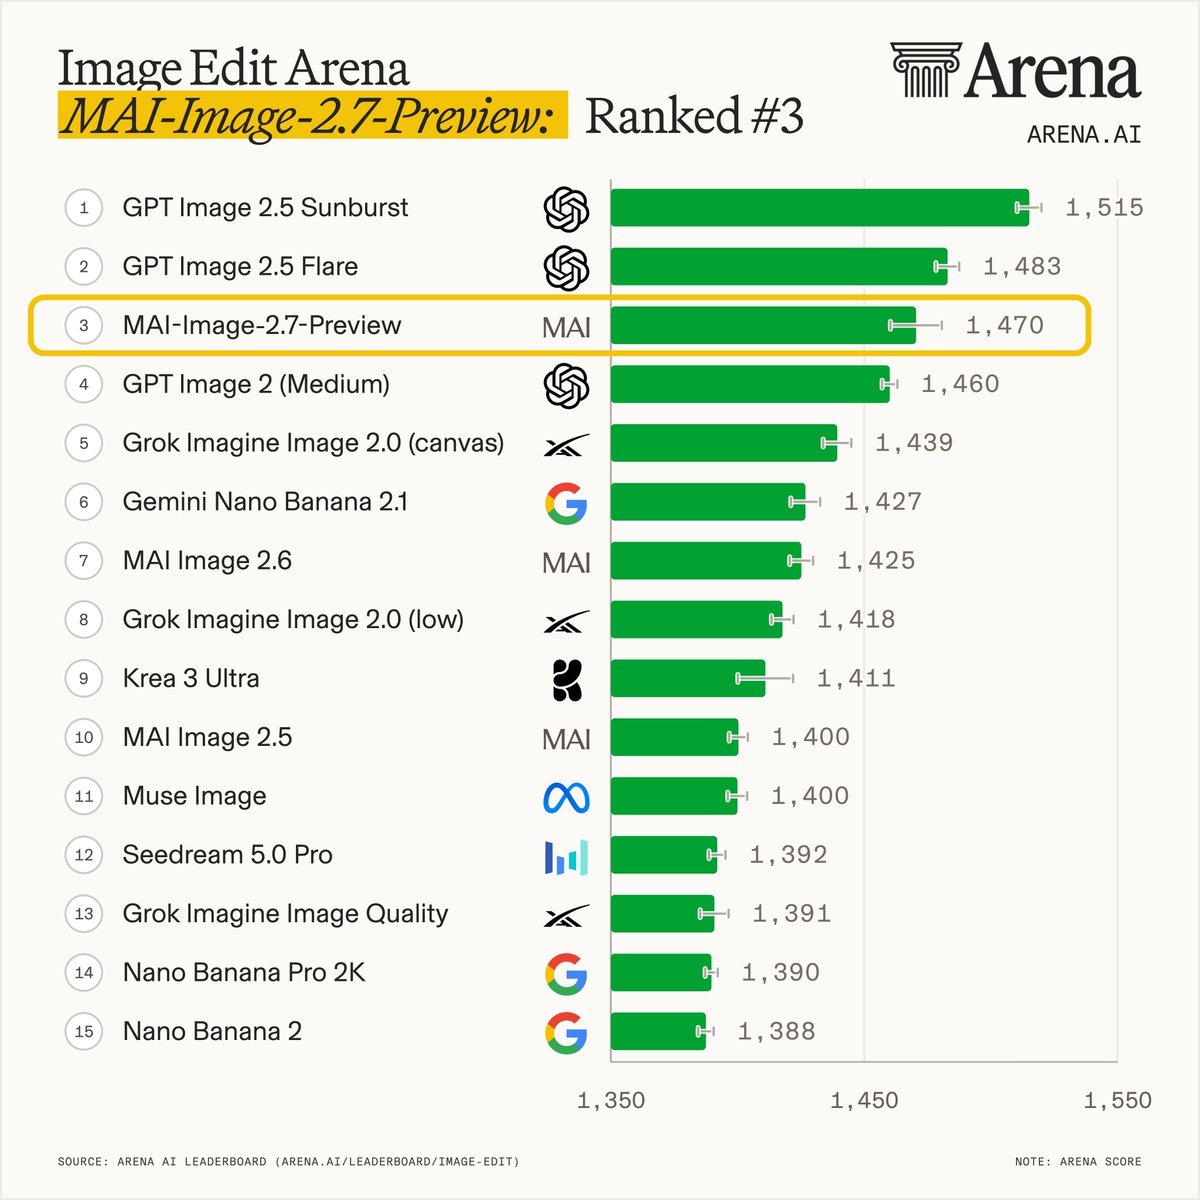
微软 AI 10 月 27 日宣布 MAI-Image-2.6 和 MAI-Image-2.6-Flash 在 Microsoft Foundry 正式商用(GA),支持最多 5 张参考图的多图编辑、Bing 联网 grounding 和最高 1.5K 输出,并公布按 token 计价。同一天,新一代图像编辑模型 MAI-Image-2.7-Preview 以 1470 分登上 Arena 图像编辑榜总榜第 3(比 2.6 高 45 分),目前只能在 MAI Playground 做图像编辑。

微软 MAI-Image-2.6 与 2.6-Flash 在 Microsoft Foundry 正式 GA,新一代 MAI-Image-2.7-Preview 登上 Image Edit Arena 第 3

核心要点速览

  • MAI-Image-2.6 和 2.6-Flash 在 Microsoft Foundry 正式 GA,Adobe Firefly 也将「很快」接入 2.6(官方口径)
  • 官方定价:2.6 为文本输入 $5、图像输入 $8、图像输出 $38 / 百万 token;Flash 为 $1.75 / $2.50 / $19
  • 2.6 支持最多 5 张参考图的多图编辑、Bing 联网 grounding、动态宽高比和最高 1.5K 输出
  • Arena 数据:MAI-Image-2.7-Preview 以 1470 分列 Image Edit Arena 总榜第 3,比 2.6(第 7)高 45 分,微软在实验室排名中列第 2
  • Artificial Analysis 数据:2.7-Preview 在 AA-Image-Editing v2.1 排第 2,7 项编辑动作全部超过 2.6,其中 4 项排第 1
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI-Image-2.6⚡ MAI-Image-2.6-Flash⚡ MAI-Image-2.7-Preview🌐 Microsoft🌐 Microsoft AI

Apple Creator Studio 加入 AI 助手:Logic Pro 与 Keynote/Pages/Numbers 用 Apple 自研模型加 OpenAI,iWork 三件套支持 MCP 供外部 Agent 操作

Apple 10 月 27 日发布 Apple Creator Studio 大更新:Logic Pro for Mac 和 Keynote、Pages、Numbers 新增 beta 版智能助手,官方称由 Apple 自研模型与 OpenAI 共同驱动,能理解文档上下文;Keynote、Pages、Numbers 还新增 Model Context Protocol(MCP)支持,外部 AI Agent 可直接读取内容、执行编辑和自动化操作。Pixelmator Pro 加入自然语言 Generate Fill,Keynote 推出开放的 JSON 格式 .keyx。更新 11 月通过 App Store 免费推送给现有订阅者,订阅价 $12.99/月或 $129/年不变。

Apple Creator Studio 加入 AI 助手:Logic Pro 与 Keynote/Pages/Numbers 用 Apple 自研模型加 OpenAI,iWork 三件套支持 MCP 供外部 Agent 操作

核心要点速览

  • Logic Pro for Mac、Keynote、Pages、Numbers 新增 beta 智能助手,官方口径为「Apple 自研模型 + OpenAI」组合驱动
  • Keynote、Pages、Numbers 支持 MCP,外部 AI Agent 可读取内容、编辑并执行自动化操作(需 macOS 27 或更高)
  • Keynote 推出开放的 JSON 格式 Keynote Interchange Format(.keyx),面向外部工具与 AI Agent 读取
  • 助手仅限美式英语,需 Apple Intelligence 设备及 iOS/iPadOS/macOS 27;11 月对现有订阅者免费更新
  • 订阅价不变:$12.99/月或 $129/年,教育版 $2.99/月
阅读全文

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

OpenAI 10 月 26 日发布 GPT-6.1 Terra,定位是兼顾视觉推理、精确电脑操作和自然写作的高效模型,今天起向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放,API 模型名 gpt-6.1-terra。标准 API 价格为输入 $1、缓存输入 $0.05、输出 $5(每百万 token),官方称比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%;上下文 1,050,000 token。官方口径下,它在 Agents' Last Exam 上中等推理强度比 GPT-5.6 Terra 高 15 个百分点、成本约三分之一,Terminal-Bench 4.0 最高强度 50.3%。

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

核心要点速览

  • 价格(官方文档):输入 $1、缓存输入 $0.05、30 分钟缓存写入 $1.25、输出 $5 每百万 token;单次输入超过 272K token 时整单输入按 2 倍、输出按 1.5 倍计费;Batch/Flex 半价,Fast 模式 2 倍
  • 规格:上下文 1,050,000 token,最大输入 922,000、最大输出 128,000,知识截止 2026-06-01;reasoning.effort 支持 none 到 max 六档,工具调用需走 Responses API
  • 电脑操作(官方口径):Agents' Last Exam 中等强度比 GPT-5.6 Terra 高 15 个百分点、成本约 1/3,与 GPT-6 Astra 持平但每 token 价格只有其 1/10;完成速度比 GPT-6 Astra 和 GPT-6.1 Sol 快 3 倍以上
  • 编程与事实性(官方口径):Terminal-Bench 4.0 最高强度 50.3%,是 GPT-5.6 Terra 公布成绩 21.5% 的两倍多;内部易错题集低强度错误率从 53.6% 降到 16.7%
  • 安全:官方称在 Preparedness Framework 网络安全项达到 Critical 阈值,沿用 GPT-6 Astra 的防护措施
阅读全文
AD赞助内容

Cursor 正式推出 Agent SDK:用 Markdown 写提示、TypeScript 写工具,把 Agent 当代码管理,可托管部署也可自建,内置评测

Cursor 10 月 26 日宣布 Agent SDK 正式可用:Agent 的系统提示写成 Markdown,工具用 TypeScript 定义,可以部署在 Cursor 的托管基础设施上,也可以在自己的机器上运行,并内置评测来衡量每次改动。官方文档称它使用的是驱动 Bugbot、Security Review、Approval Bot 和 Rollouts 的同一套 Cursor SDK 运行框架,可以由代码仓库事件、Issue 跟踪器、Slack 或定时任务触发,部署后在 Deployed Agents 中管理。官方未公布定价和跑分。

Cursor 正式推出 Agent SDK:用 Markdown 写提示、TypeScript 写工具,把 Agent 当代码管理,可托管部署也可自建,内置评测

核心要点速览

  • 同源框架:官方文档称 Agent SDK 使用驱动 Bugbot、Security Review、Approval Bot、Rollouts 这 4 个 Cursor 自家 Agent 的同一套运行框架
  • 项目结构:bot/instructions.md 是必需的常驻系统提示,bot/tools/*.ts 每个文件一个带类型的工具,另有 skills、mcp-connections、subagents、channels、hooks、schedules 等目录,评测放在 evals/*.eval.ts
  • 触发与部署:可由代码仓库、Issue 跟踪器、Slack、Webhook 或定时任务触发;可选 Cursor 托管或自建运行,部署后在 Deployed Agents 管理
  • 命令行:agent-sdk validate、run、eval 分别用于校验、实跑一轮和跑评测,官方称只有 run 和 eval 需要 Cursor 凭证
  • 官方未公布定价和跑分
阅读全文
关联模型 / 智能体 / 厂商:

Oracle AI World 发布 Fusion Claw 执行运行时与 25 个智能体应用,Fusion Companion 让员工在 ChatGPT 里直接调度 ERP/HCM 流程

Oracle 10 月 26 日在拉斯维加斯 Oracle AI World 发布一组企业 AI 更新:新的智能体执行运行时 Oracle Fusion Claw,以及基于它的 25 个 Agentic Applications,已覆盖 ERP、HCM、供应链(SCM)和客户体验(CX);同时推出 Fusion Companion 和 Fusion Agentic Home,员工可以在 ChatGPT 等受支持的 AI 工具或 Fusion 原生界面里用自然语言描述目标,由系统自动挑选并协调交易、工作流、审批和 AI 智能体,全程沿用企业现有的身份、权限和审批控制。官方未公布定价、跑分或具体上线时间表。

Oracle AI World 发布 Fusion Claw 执行运行时与 25 个智能体应用,Fusion Companion 让员工在 ChatGPT 里直接调度 ERP/HCM 流程

核心要点速览

  • 运行时:Fusion Claw 是新的智能体执行运行时,官方称支持更大规模、更长时间运行的任务、持续重新规划、确定性执行和受治理的自主度(官方新闻稿)
  • 应用数量:25 个 Claw 驱动的 Agentic Applications 已可用,覆盖 ERP、HCM、SCM、CX 四大套件,示例包括 Ledger、Workforce Orchestration、Payroll Activity Workspace、Procurement Spend 等
  • 入口:Fusion Companion 可在 ChatGPT 等受支持的 AI 工具及客户或伙伴自建界面中调用 Fusion,Fusion Agentic Home 是原生入口(Fusion Companion 新闻稿)
  • 治理:所有执行都沿用企业既有身份、权限、策略和审批控制,需人类判断的决策会上报
  • 未公布:定价、跑分和各应用的详细上线时间表官方均未公布
阅读全文

CapCut 官宣 ChatGPT 插件「即将上线」:在 ChatGPT 里用剪映的视频生成与剪辑工具,草稿可转到 CapCut 网页版精修

字节跳动旗下 CapCut(剪映国际版)官方账号 @capcutapp 在 UTC 2026-10-24 18:34 于洛杉矶 CapCut World 活动期间宣布,新的 CapCut 插件「即将上线」ChatGPT(原帖)。按官方说法,插件把 CapCut 的视频剪辑和生成工具带进 ChatGPT:用户可以先在 ChatGPT 里构思,再直接用插件生成内容,之后把草稿转到 CapCut 网页版继续精修和发布。抓取时原帖约 3,646 赞、319 转发、504 回复、45 万浏览。活动官网列出 OpenAI 合作伙伴负责人 Mahak Sharma 和创作者产品负责人 Sam Yam 作为嘉宾。X 上不少创作者帖称插件已在 ChatGPT 桌面版开放抢先体验、移动端和网页端约 11 月中旬跟进,但 CapCut 官方帖仍写「coming soon」,具体上线时间和价格以官方后续公告为准。

核心要点速览

  • 官方来源:CapCut 官方 X 原帖,UTC 10-24 18:34 发布,抓取时约 3,646 赞、319 转发、216 引用、504 回复、45 万浏览
  • 功能:CapCut 视频剪辑与生成工具接入 ChatGPT,可在对话中从想法直接生成视频草稿
  • 工作流:插件生成的草稿可转到 CapCut 网页版继续剪辑、分享和发布
  • OpenAI 参与:CapCut World 洛杉矶活动官网列出 OpenAI 的 Mahak Sharma(合作伙伴负责人)和 Sam Yam(创作者产品负责人)为嘉宾
  • 状态:官方写「即将上线」;创作者帖所称「桌面版已抢先体验、11 月中旬上移动端和网页端」未见官方确认,价格未公布
阅读全文
关联模型 / 智能体 / 厂商:

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

2026-10-23(UTC 17:15,SGT 10-24 01:15),Kimi 官方账号 @Kimi_Moonshot 正式发布 Kimi K3.1 Pro,同时推出快 2–3 倍的 K3.1 Pro Highspeed,已在 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API 上线,完整权重承诺 2026-11-04 前开放。官方技术博客称它是 K3 的后训练版本(更大规模多领域联合 RL),MoE 总参 2.8T、激活 104B,1M token 上下文,多模态。厂商口径跑分:Terminal-Bench 4.0 65.7%(GPT-6 Astra 58.2%、Claude Opus 5.5 66.4%),BenchCAD 带工具 92.7%。Kimi API 定价页显示 kimi-k3.1-pro 输入 $2、输出 $10、缓存命中 $0.20 每百万 token,低于 K3 的 $3/$15。

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

核心要点速览

  • MoE 总参 2.8T、激活 104B,1M token 上下文,多模态;完整权重承诺 2026-11-04 前开放(官方博客)
  • 厂商口径:Terminal-Bench 4.0 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;内部 Kimi Code Bench 3.0 长程 61.2%(K3 为 55.95%)
  • API 定价:kimi-k3.1-pro 输入 $2 / 输出 $10 / 缓存命中 $0.20 每百万 token;Highspeed 版 $4 / $20(定价页)
  • 内部幻觉压力测试 Kimi Hallu Bench Hard:声明级幻觉率从 K3 的 23.4% 降到 8.3%(官方注明不代表日常错误率)
  • 开放权重版在中期训练和 RL 阶段移除了网络安全相关数据:xdev-bench-hard pass@3 从未处理版的 90.5% 降到 81.0%
阅读全文
关联模型 / 智能体 / 厂商:

Inception 正式发布 Mercury 3:扩散架构大模型突破 1000 Token/s,100 万上下文挑战 GPT-6 与 Haiku

前沿 AI 初创公司 Inception 联合创始人 Stefano Ermon 宣布正式推出新一代扩散架构大语言模型 Mercury 3。模型在 NVIDIA GPU 上实现高达 1,068 Token/秒的超高生成吞吐,参数量达到前代 Mercury 1 的 40 倍并支持 100 万(1M)Token 原生上下文。在 IFBench、GPQA Diamond 与 SWE-Bench Atlas 基准上全面对标前沿闭源基线,输入/输出百万 Token 标准定价为 0.20 / 0.70 美元(上线期半价优惠仅需 0.10 / 0.35 美元)。

Inception 正式发布 Mercury 3:扩散架构大模型突破 1000 Token/s,100 万上下文挑战 GPT-6 与 Haiku

核心要点速览

  • Inception 联合创始人 Stefano Ermon 正式发布扩散架构大模型 Mercury 3,在 NVIDIA GPU 上实现 1,068 Token/秒的超高吞吐
  • 模型参数扩充至 Mercury 1 的 40 倍,支持 100 万原生超长上下文(4 倍于 Mercury 2.5),标准定价百万输入/输出仅 0.20 / 0.70 美元
  • 在 IFBench、GPQA Diamond 与 SWE-Bench Atlas 测试中表现亮眼,基准综合智能达到前代 3 倍且同步上线 OpenRouter
  • 彻底摆脱自回归逐字预测瓶颈,以并行扩散去噪实现亚秒级长文本代码生成,极大优化高并发 Agent 运行效率
阅读全文
关联模型 / 智能体 / 厂商: