AI 编程实时动态与要闻

Boson AI 发布 Higgs Realtime Duplex:45B MoE 全双工多模态交互模型,边听边看边说并在后台调工具,API 候补中

Boson AI(李沐、Alex Smola 团队)于 2026-11-05 发布研究预览 Higgs Realtime Duplex:一个 45B MoE 前台模型,把语音、视频、工具结果都切成 160ms 分块同时收发,可边听边看边说、实时渲染自己的脸,同时思考、调用工具或把难题委派给更大的后端模型而不中断对话。官方口径 Big Bench Audio 98.9、τ-Voice 69.8、Full-Duplex-Bench v1.5 75.5。目前 API 仅开放候补名单,旧版 Higgs Realtime 已可用。
Boson AI 发布 Higgs Realtime Duplex:45B MoE 全双工多模态交互模型,边听边看边说并在后台调工具,API 候补中

核心要点速览

  • 形态:45B MoE 前台模型,在约 2 万亿 token 文本/音频/视频上继续训练;所有流按 160ms 分块,静音也算一块
  • 后台干活:边说话边思考、异步调工具,难题带完整上下文委派给更大的后端模型(官方建议用前沿模型)
  • 官方口径跑分:Big Bench Audio 98.9(表内最高)、IFEval 94.1、τ-Voice 69.8(GPT-Live-1 约 74.5)、Full-Duplex-Bench v1.5 75.5(GPT-Live-1 80.1、TML 77.8)
  • 成本设计:音视频流约 2.6K tokens/分钟,含思考与工具约 2.6–5K;目标是 1 小时对话成本不超过人工 1 小时的 1/10
  • 可用性:Duplex API 仅候补名单;声音与人脸可用参考音频/单张图零样本替换
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Higgs Realtime Duplex⚡ Higgs Realtime⚡ GPT-Live-1⚡ TML Interaction Small🌐 Boson AI

Cursor 上线 Voice Chat:可与 Agent 实时双向语音通话,覆盖 Agents Window / IDE / Web / iOS,语音层用 Grok Voice

2026-11-06,Cursor Changelog 发布 Voice Chat with Agents:在 Agents Window、IDE、网页与 iOS 上与编码 Agent 实时双向语音通话;语音听写仍是另一功能。语音层由 Grok Voice 负责(可选 Ara/Eve/Leo/Rex/Sal 等),编码仍用你为该 Agent 选择的模型;开启 Privacy Mode 时语音零留存。需登录 Cursor 账号(仅 API Key 不可发起通话)。

Cursor 上线 Voice Chat:可与 Agent 实时双向语音通话,覆盖 Agents Window / IDE / Web / iOS,语音层用 Grok Voice

核心要点速览

  • 来源:Cursor Changelog「Voice Chat with Agents」(2026-11-06)+ 官方文档 cursor.com/docs/agent/voice-chat
  • 能力:Agent 空闲且输入框为空时点波形按钮开聊;通话中可委派编码、只读查 diff/进度/历史、切换 Project worker
  • 分工:Grok Voice 负责听与说;编码 Agent 仍用你选的模型,并口头播报短进度与完成摘要
  • 隐私与门槛:Privacy Mode 开=语音零留存;需账号登录;仅 API Key 会话无法开通话;默认约 10 分钟无操作挂断,另有每日通话上限
  • 与听写区分:Cmd+Shift+Space 仍是听写(Voice Mode);Voice Chat 是双向通话,无单独快捷键
阅读全文
关联模型 / 智能体 / 厂商:

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

Meta AI(@AIatMeta)于 11 月 5 日宣布,Connect 上预览的 Muse Realtime Avatar 开始在美国 Muse App 灰度:把 Muse Realtime Voice 变成可互动的实时形象。研究博客称系统为音频驱动的 Diffusion Transformer,与语音共享 speech token 流以同步口型与表情;单会话在 GB200 上可流式输出 448×768@25fps,用户话轮结束到音视频首字节约 870ms,并用 Meta Video Seal 做不可见水印。面向 18+ 用户;官方未公布全球时间表与开发者 API。

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

核心要点速览

  • 美国 Muse App 开始灰度 Realtime Avatar;Connect 时预览,现进入消费端(@AIatMeta)
  • 架构:语音 VQ token 同时驱动音频解码与 Avatar 视频;因果分块 + 自强制蒸馏,教师约 120 次评估压到学生 2 次(约 60×)
  • 性能口径:448×768@25fps,约 870ms 首包;单 GB200 相对 BF16 基线服务容量约 8×,可达 12 路并发(研究博客)
  • 主观评测:相对 Runway Characters、HeyGen LiveAvatar,评分者在整体与多数维度更偏好 Muse(厂商评测)
  • 安全:生成视频嵌入 Video Seal 不可见水印;示例不代表 App 内全部形象;无公开开发者 API
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark⚡ Muse Presence🤖 Muse🌐 Meta

OpenAI Realtime 负责人宣布:GPT-Live 外呼电话 API 正式 GA,可经任意 SIP 中继主动拨号并支持 DTMF

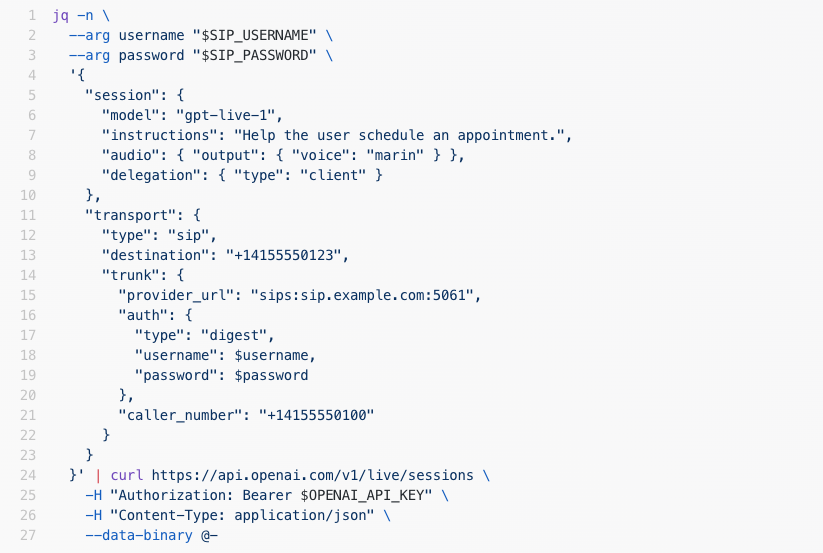
OpenAI Realtime AI 负责人 Justin Uberti 11 月 4 日发帖称 GPT-Live 外呼电话 API 已 GA:Live 语音智能体可通过 Telnyx、Twilio 等任意 SIP 中继主动拨号,支持 HD Voice 与双向 DTMF。官方文档给出 Live API + SIP transport 接入方式;Greg Brockman 转发确认。

OpenAI Realtime 负责人宣布:GPT-Live 外呼电话 API 正式 GA,可经任意 SIP 中继主动拨号并支持 DTMF

核心要点速览

  • OpenAI Realtime AI 负责人 Justin Uberti:GPT-Live 外呼电话 API 已 GA,可经任意 SIP 中继拨号
  • 官方文档:Live API POST /v1/live/sessions + transport.type=sip,支持 HD Voice 与双向 DTMF
  • 中继要求 TLS(sips:)信令与 SDES-SRTP;示例兼容 Telnyx、Twilio 等
  • 硬限制(文档):振铃最长约 3 分钟,接通后最长约 2 小时
  • Greg Brockman 转发确认;写作按员工第一手说明引用,非公司主账号通稿
阅读全文
关联模型 / 智能体 / 厂商:
⚡ OpenAI GPT Live 1🌐 OpenAI
AD赞助内容

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

Mistral AI 正式推出 Voxtral 3 语音多模态大模型家族与配套的实时 Voice-Agent API。该套件包含 40 亿参数的 Mini 转录模型、超越 Whisper 与 Gemini 3.5 的 Small 转录模型,以及基于 LiveKit 的端到端语音智能体 SDK。系统支持 50 种语言高精听写与说话人分离、跨 35+ 语言带情感标签的情感语音合成(TTS)以及 30 分钟音频专业级声音克隆。在 Artificial Analysis 独立基准评测中,Small Transcribe 3 以 2.1% 极低字错率登顶全球语音识别榜单季军,Realtime 转录单步延迟低至 500ms 以内,每分钟语音智能体调度成本低至 0.04 美元。

Mistral 正式发布 Voxtral 3 语音大模型套件与实时 Voice-Agent API:端到端延迟低至 500 毫秒

核心要点速览

  • Mistral 官方正式发布 Voxtral 3 全栈语音多模态模型家族,包含转录、情感 TTS、专业声音克隆与实时 Voice-Agent SDK
  • 在 Artificial Analysis 独立实测中,Small Transcribe 3 斩获 2.1% 极低错词率,击败 ElevenLabs Scribe v2(2.2%)与 Grok Voice 2.0(2.3%)
  • Realtime Transcribe 3 响应时间压缩至 500ms 以内,端到端完整语音 Agent 回合交互延迟突破 1 秒大关
  • 极致价格革命:Mini 转录每分钟仅需 0.0035 美元,搭配 Mistral Small 4 调度的全托管语音智能体每分钟仅 0.04 美元
阅读全文
关联模型 / 智能体 / 厂商:

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

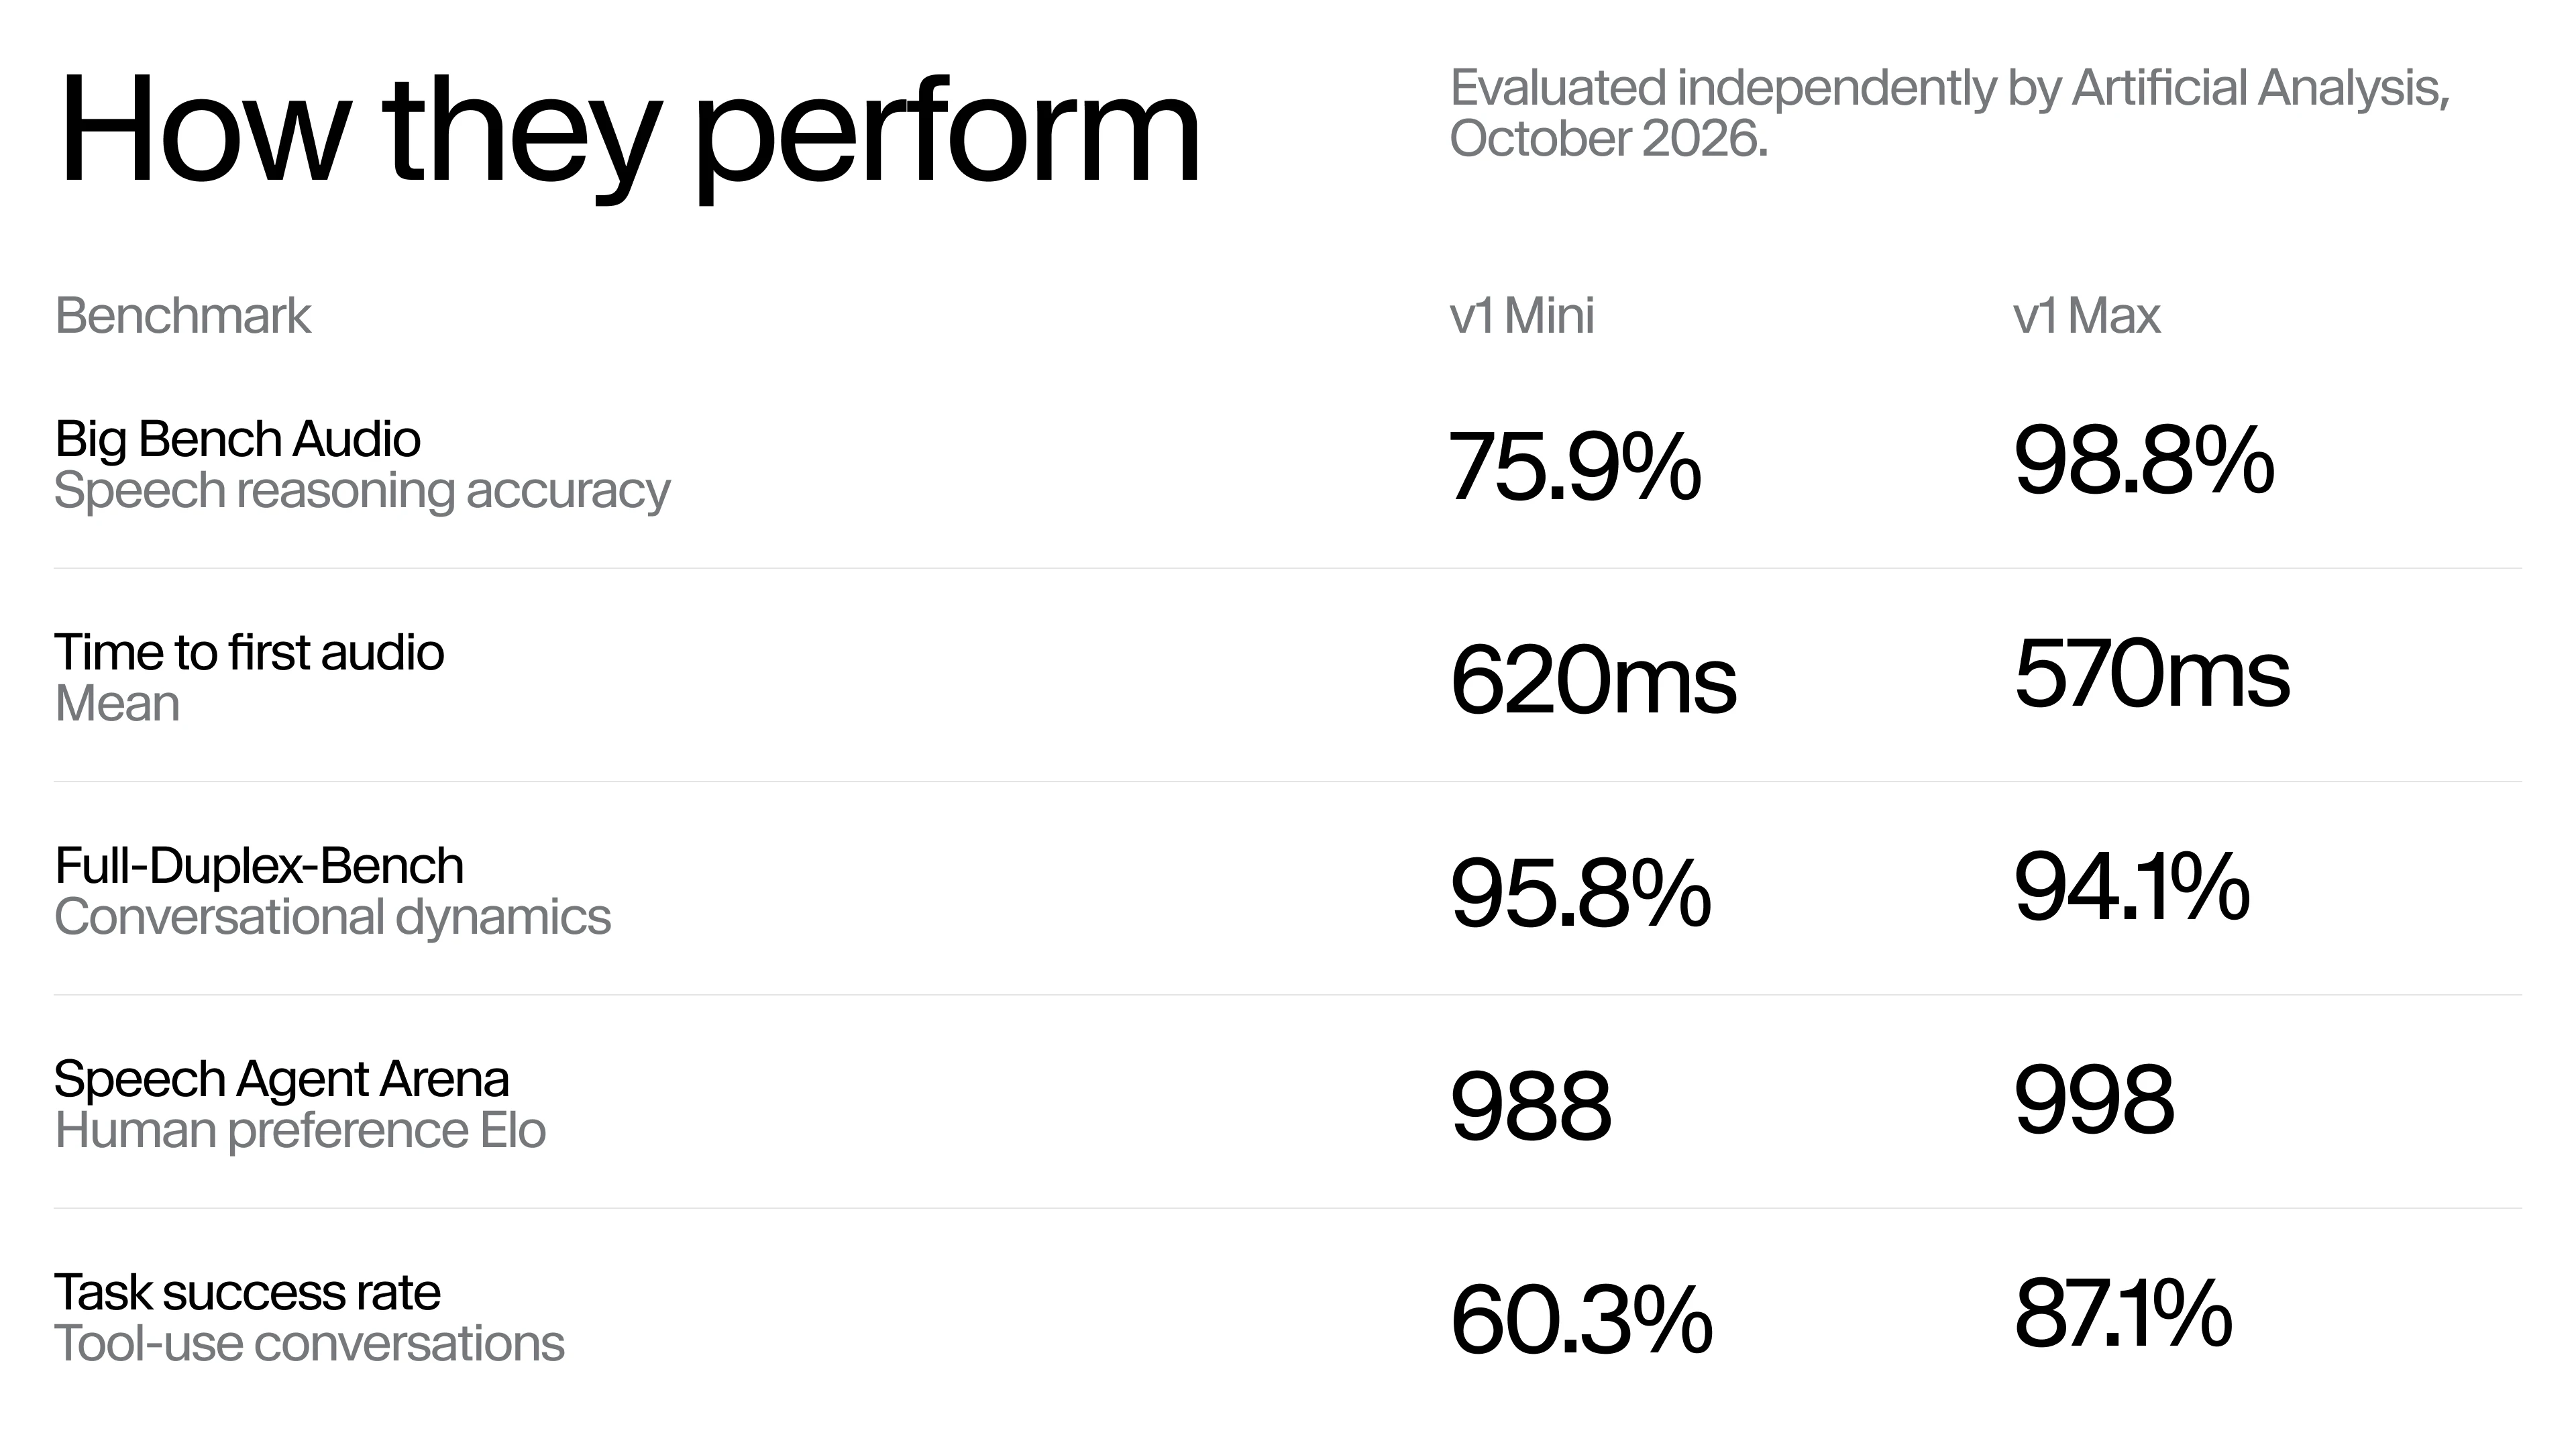
10 月 20 日,ElevenLabs 发布 Eleven Realtime,一类端到端语音到语音模型,每个模型本身就是完整的语音 Agent,不再需要自己拼语音识别、大模型和语音合成。v1 Mini 主打低成本自然对话,v1 Max 面向客服和多步骤工具调用。两者支持 90+ 语言、可用 17,000+ 种音色。官方引用 Artificial Analysis 独立评测:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开始说话。接口兼容 OpenAI Realtime API,改端点和模型名即可迁移。

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

核心要点速览

  • 语音推理(Artificial Analysis 独立评测,官方引用):Big Bench Audio 1,000 道语音推理题,v1 Max 答对 98.8%,v1 Mini 75.9%
  • 速度(官方口径):Max 平均 0.57 秒开始说话,Mini 0.62 秒;官方推文说「半秒开口」,发布文给出的实测略高于半秒
  • 对话动态与偏好:Full-Duplex-Bench 上 Mini 95.8%、Max 94.1%;Speech Agent Arena 盲测 Max 998 分、Mini 988 分
  • 工具调用任务完成率 Max 87.1%、Mini 60.3%,官方因此建议重度调工具的场景用 Max
  • 覆盖 90+ 语言、17,000+ 音色;Realtime API 走 WebSocket(wss://api.elevenlabs.io/v1/convai/realtime),可直接用 OpenAI 官方 SDK,发布文未公布价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Eleven Realtime v1 Mini⚡ Eleven Realtime v1 Max🤖 ElevenAgents🌐 ElevenLabs🌐 Artificial Analysis

Mistral 发布 Voxtral 3 语音模型家族与语音 Agent SDK:转写支持 50+ 语言、TTS 每百万字符 13 美元,可欧盟托管或自部署

10 月 20 日,Mistral 发布 Voxtral 3:语音转文字模型 Voxtral Small/Mini Transcribe 3、实时转写 Voxtral Mini Transcribe Realtime 3、语音合成 Voxtral Mini TTS 3(Voxtral Speech 3),以及基于 LiveKit 的语音 Agent SDK,把“听—思考调工具—说”串成一条流式管线,官方称每轮响应不到 1 秒。转写覆盖 50+ 语言并支持说话人分离和上下文偏置,TTS 覆盖 35+ 语言、50+ 方言,另有 30 分钟录音即可复刻音色的 Pro Voice。模型已通过 Mistral API(欧盟、美国、全球端点)上线,也可自部署。

Mistral 发布 Voxtral 3 语音模型家族与语音 Agent SDK:转写支持 50+ 语言、TTS 每百万字符 13 美元,可欧盟托管或自部署

核心要点速览

  • 多语种转写(官方口径):FLEURS 45 种语言宏平均 WER,Voxtral Small Transcribe 3 为 4.1%(指定语言)/4.0%(自动识别),与 Microsoft AI Transcribe 2 持平,优于 Scribe v2 的 4.9% 和 Whisper large-v3 的 16.0%/14.9%
  • 说话人分离(官方口径):cpWER 方面 Small 为 18.4%、Mini 为 18.6%,上一代 Voxtral Mini Transcribe 2 为 30.9%,Gemini 3.5 Transcribe 为 38.4%
  • 价格:Voxtral Mini Transcribe 3 为 4B 参数,每分钟 0.0035 美元(文档标注 Public Preview、32k 上下文);Voxtral Speech 3 每百万字符 13 美元
  • 实时转写:Voxtral Mini Transcribe Realtime 3 延迟可低于 500 毫秒;官方 FLEURS 35 语言图中 480ms 档 WER 为 6.4%,仍高于 Gemini 3.5 Realtime Transcribe 的 4.2%
  • 语音 Agent SDK 基于 LiveKit,支持 SIP 电话与 WebRTC,每个环节可单独替换 LLM、音色或语言,Pro Voice 用 30 分钟录音即可复刻音色
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Voxtral Small Transcribe 3⚡ Voxtral Mini Transcribe 3⚡ Voxtral Mini Transcribe Realtime 3⚡ Voxtral Mini TTS 3🤖 Voxtral voice agent SDK🌐 Mistral AI🌐 LiveKit

OpenAI Node 7.25.0:beta.agents 原生 Computer Use;7.24 同步 GPT-6.1 Sol 与 Agents 会话凭据

官方 TypeScript SDK [email protected](v7.25.0,2026-09-29)在 beta.agents 加入 Computer Use(#2837),与同日 Python 3.22.0 能力对齐。紧前版 v7.24.0 已落地 Agents credential/session(#2812)、gpt-6.1-sol 标识(#2836)、Responses Cyber access、Realtime Translation client secret 与专用 Node Translation WebSocket。相对 v7.23.0...v7.25.0 ahead_by 35。

OpenAI Node 7.25.0:beta.agents 原生 Computer Use;7.24 同步 GPT-6.1 Sol 与 Agents 会话凭据

核心要点速览

阅读全文

OpenAI Python SDK 3.20.0:Agents 凭据/会话选项、Responses Cyber 访问计划,WebSocket 增量文本与工具快照可观测

OpenAI 于 2026-09-28 发布官方 Python SDK v3.20.0:为 Agents 凭据增加 metadata 与免替换鉴权的更新路径,会话支持 ultrafast 服务档与 misalignment_policy_violation;Responses 可声明 Cyber access program(standard/daybreak_blue/daybreak_red);并提供可选 ResponsesWebSocketAccumulator,在流式场景输出不可变的文本/工具增量快照。同期修复 Live/Realtime WebSocket 路径查询串、队列重放与未映射 TLS 重试。

OpenAI Python SDK 3.20.0:Agents 凭据/会话选项、Responses Cyber 访问计划,WebSocket 增量文本与工具快照可观测

核心要点速览

  • 发版:v3.20.0(2026-09-28);相对 v3.19.2
  • Agents:凭据 metadata + 可更新鉴权;会话 ultrafast tier;新增 misalignment_policy_violation(#3967)
  • Responses Cyber:access_programs.cyber 支持 standard / daybreak_blue / daybreak_red(#3956)
  • 可观测流:可选 ResponsesWebSocketAccumulator 输出增量文本/工具快照;官方称 190+ WebSocket/accumulator 测试通过(#3973)
  • 安装:pip install -U openai;文档见 api.md 与 API Reference
阅读全文

LiveKit Agents 1.8.3:Gemini 3.8 Live 默认 NON_BLOCKING、GPTLive Azure,AssemblyAI Universal 与工具 handoff 防护

LiveKit 于 2026-09-26 在 GitHub 发布 Python 包 [email protected](PyPI livekit-agents 1.8.3):Google Gemini 3.8 Live 路径默认 tool_behavior=NON_BLOCKING,并在 text API 上以 parameters_json_schema 发送 FunctionTool schema;OpenAI 侧新增 GPTLiveModel.with_azure,Realtime inference client 迁入 agents core;STT 增加 AssemblyAI universal-3-6-pro 与 language_confidence,ElevenLabs realtime chunk duration 可配;语音栈修复并行工具取消 handoff、按 call_id 配对 tool output、fallback/stream adapter 原样转发帧,以及 LiveAvatar 打断与插件注册。同日 JS @livekit/[email protected] 强化 agent_turn 遥测与自适应打断。

LiveKit Agents 1.8.3:Gemini 3.8 Live 默认 NON_BLOCKING、GPTLive Azure,AssemblyAI Universal 与工具 handoff 防护

核心要点速览

  • 发版:[email protected] / PyPI 1.8.3;JS 同步 @livekit/[email protected]
  • Gemini:3.8 Live 默认 NON_BLOCKING tool_behavior;text API 用 parameters_json_schema 传 FunctionTool
  • OpenAI:GPTLiveModel.with_azure;Realtime inference client 迁入 agents core
  • STT:AssemblyAI universal-3-6-pro + language_confidence;ElevenLabs realtime chunk duration 可配
  • 语音正确性:并行工具不再取消 agent handoff;tool output 按 call_id 配对;Fallback/StreamAdapter 原样转发帧
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

CopilotKit 1.74.0:跨 SDK 消费多容器 Learned Skills,Web Inspector 定向 What's New 与 HUD 埋点

CopilotKit 于 2026-09-25 发布 v1.74.0(npm @copilotkit/react-core 1.74.0):各 SDK 可消费来自多个容器的 learned skills,把技能资产从单运行时扩展到可组合的多容器供给;Web Inspector 支持定向 What's New 通知,并跟踪 launcher HUD 的曝光与操作。修复包括:threads drawer 不再因未解析 entitlement 锁死、未真正打开的 socket 停止刷新 realtime 凭证、React 侧停止逐条 message 状态克隆与虚拟滚动拉扯、授予空权限的 Memory policy 不再直接导致 run 失败。

CopilotKit 1.74.0:跨 SDK 消费多容器 Learned Skills,Web Inspector 定向 What's New 与 HUD 埋点

核心要点速览

  • 发版:v1.74.0 / npm @copilotkit/[email protected]
  • Skills:跨 SDK consume learned skills from multiple containers(#7384),技能可组合供给
  • Inspector:定向 What's New 通知(#6956)+ launcher HUD 曝光/操作埋点(#7376)
  • 稳健性:未打开 socket 不再刷 realtime 凭证;空授权 Memory policy 不再 fail run
  • React:停止 per-message state cloning 与虚拟滚动拉扯,降低长线程 UI 抖动
阅读全文
关联模型 / 智能体 / 厂商:

Pydantic AI 2.51.0:新增 OpenAILiveModel 对接 GPT-Live,暴露 context_window_used 并收紧 Gemini Live 连接校验

Pydantic AI 于 2026-09-25 发布 v2.51.0:新增 OpenAILiveModel 支持 OpenAI GPT-Live 实时会话,并在 realtime session 上暴露 context_window_used(来自 GPT-Live 上报比例或 response usage);兼容性上对齐 dated gemini-3.8-live 标识、在连接阶段拒绝 Google Affective Dialog,并对强制 tool_choice 的 realtime 调用抛 UserError。PyPI pydantic-ai 2.51.0 已同步。

Pydantic AI 2.51.0:新增 OpenAILiveModel 对接 GPT-Live,暴露 context_window_used 并收紧 Gemini Live 连接校验

核心要点速览

  • 发版:v2.51.0 = PyPI pydantic-ai 2.51.0,文档 pydantic.dev/docs/ai
  • 实时:新增 OpenAILiveModel 对接 GPT-Live(#8390);session 暴露 context_window_used(GPT-Live 比例或 response usage,#8803)
  • 兼容:匹配 dated gemini-3.8-live id;连接时拒绝 google_affective_dialog(Gemini 3.1/3.8 Flash Live);Gemini Live close code 改抛 RealtimeError(#8761)
  • 安全:OpenAI / Azure OpenAI / xAI 上强制 tool 的 realtime tool_choice 直接 UserError(#8755)
  • 性能:缓存 agent graph 避免每次 Agent.run() 重建(#8658);单子节点时不再起 task group(#8774)
阅读全文
关联模型 / 智能体 / 厂商:

Pydantic AI 2.50.0:DecisionModel 协议落地,TypeSafe 可按名路由并支持 Gemini 3.8 Live

Pydantic AI 于 2026-09-25 发布 2.50.0:新增 DecisionModel 基类(TypeSafeModel 实现之),按路由名询问 Decision、可选 decision_route_threshold,并补齐 Gemini 3.8 Live 实时语音、durable 上下文标记与音频秒级计费。

Pydantic AI 2.50.0:DecisionModel 协议落地,TypeSafe 可按名路由并支持 Gemini 3.8 Live

核心要点速览

  • 协议:新增 DecisionModel,TypeSafeModel 成为其实现;可用路由名询问走哪条路(#8733)
  • 兼容:工具调用偏置改为可选 decision_route_threshold;ModelSelectionContext.messages 以当前请求结尾并新增 .prompt(#8737、#8739)
  • 实时:支持 gemini-3.8-live / gemini-3.8-live-extended-thinking;RequestUsage.audio_seconds 覆盖按时长计费语音(#8393、#8427)
  • 可观测:每次 DecisionModel 请求发出 decide span(#8698);RunContext.in_durable_context 标记持久化工作流钩子(#8723)
  • 升级:pip install -U 'pydantic-ai==2.50.0';对照 v2.50.0 Release 与 docs
阅读全文
关联模型 / 智能体 / 厂商:

Pydantic AI 2.49.0:GitHub Copilot OAuth 设备流 + TypeSafe BoolCriteria,Bedrock 对齐 GPT-6 家族

Pydantic AI 于 2026-09-24 发布 v2.49.0(PyPI 同步)。亮点包括 GitHubCopilotOAuthFlow 设备授权、BoolCriteria 语义化是/否字段、RealtimeSession.wait_for_reply(),以及 Bedrock Converse 对 gpt-6-sol / gpt-6-luna / gpt-6-astra 的兼容修复与 GPT-5.6/GPT-6 参数剥离,避免 400。

Pydantic AI 2.49.0:GitHub Copilot OAuth 设备流 + TypeSafe BoolCriteria,Bedrock 对齐 GPT-6 家族

核心要点速览

  • 安装:pip install -U 'pydantic-ai==2.49.0'(PyPI 上传于 2026-09-24 03:23 UTC)
  • 新能力:GitHubCopilotOAuthFlow 设备码登录(#8618)
  • BoolCriteria + Enum True/False 语义说明,改善 TypeSafeModel 问卷式字段(#8586)
  • 实时:RealtimeSession.wait_for_reply()(#8514)
  • Bedrock:放行 gpt-6-sol/luna/astra;对 GPT-5.6/GPT-6 自动丢掉 temperature/top_p 以免 400(#8656/#8668)
阅读全文

xAI 发布 Grok Voice Transcribe 2.0:短指令 WER 降至 6.8%,批处理约 $0.10/小时

SpaceXAI(xAI)正式上线 Grok Voice Transcribe 2.0,宣称在客服通话、口述凭证与短语音指令等真实场景上准确率约为上一代两倍,且价格不变。官方称其在 Artificial Analysis 32 个流式转写模型中准确率排名第一;短指令词错误率从约 20.6% 降至约 6.8%。支持流式/批处理、自动语种检测与中途换语、词级时间戳与置信度、免费说话人分离,批处理约 $0.10/小时、实时流式约 $0.20/小时,既有 Speech-to-Text API 集成可无感升级。

核心要点速览

  • 宣称客服通话/口述凭证/短指令等场景准确率约为 Transcribe 1.0 的两倍,价格不变。
  • Artificial Analysis 流式转写榜准确率第 1;短指令 WER 约 20.6%→6.8%。
  • 批处理约 $0.10/小时、实时流式约 $0.20/小时;含说话人分离、语种切换与词级时间戳,API 可无感升级。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Grok Voice Transcribe 2🌐 xAI