AI 编程实时动态与要闻

X 热议:开源 AI 开发者 Jun Song 称拒绝黑客组织「天价」请求,对方想用海量攻击数据后训练开源权重模型

11 月 1 日 02:20(UTC),开源 AI 开发者、Supergemma 的打造者 Jun Song(@jun_song)在 X 发帖称:一个匿名黑客组织联系他,开出「天文数字」报酬,请他用对方掌握的漏洞利用数据对开源权重模型做强化学习后训练;他说数据量大到「说是 FBI 卧底数据集也会信」,自己已拒绝,但担心迟早有人接单。帖子截至 17:10 SGT 约 2,029 赞、22 万浏览、771 收藏,还被改写成调侃段子转发。这是个人陈述,报价、数据规模和黑客组织身份都无法核实,下文按讨论处理。

核心要点速览

  • 热度:原帖 约 2,029 赞、127 转发、101 回复、771 收藏、22.2 万浏览(截至 11 月 1 日 17:10 SGT)
  • 说法:匿名黑客组织出「天文数字」报酬,请他用漏洞利用数据后训练开源权重模型;他称已拒绝,金额和数据规模均未公开,无法核实
  • 对比:他说自己做过的一个白帽项目基于 GLM-5.3,所用数据不到对方的 1%,就已经「大幅超过前沿模型」,这是作者自述,没有公开跑分
  • 反应:帖子被 msuiche、Samuel Cardillo 等人照着开头改写成调侃段子,讨论在当真与调侃之间分化
  • 议题:开源权重模型一旦发布就无法收回,安全护栏可以被后训练去掉,这类请求把「开源 vs 滥用风险」的争论推到了具体场景
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:图灵奖得主 Richard Sutton 晒出 17 岁时写下的「智能爆炸」预言,称自己因此对奇点很淡定

强化学习奠基人、2024 年图灵奖得主 Richard Sutton 10 月 30 日 23:42(UTC)在 X 发帖说,自己对技术奇点「很淡定」,原因之一是 50 多年前就看到它要来:1975 年他 17 岁时写道,一旦人类造出比自己更聪明的智能,它就能再造出更聪明的智能,智能水平可能在几年内急速上升。帖子获得 2,300 多赞、约 16.7 万次浏览,中英文圈大量转发讨论「人类还剩什么角色」。以下按观点讨论整理,不代表已证实结论。

核心要点速览

  • 原帖:Richard Sutton 本人 10 月 30 日 23:42 UTC 发布,引用他 1975 年 17 岁时写下的一段文字,并说这是他对奇点「淡定」的原因之一
  • 原文要点:先要理解大脑;理解一旦突破,进步会指数加速;比人更聪明的智能会继续造出更聪明的智能;人类要么被甩在后面,要么自己成为那种智能
  • 热度(X API,10 月 31 日约 19:07 SGT 读取):2,376 赞、232 次转发、45 条引用、97 条回复、882 次收藏、约 16.7 万次浏览
  • 讨论焦点:这是否早于今天的「递归自我改进」叙事;中文圈转发集中在「人类智能还有什么意义」;也有人主张用 AI 加速自身学习
  • Sutton 是强化学习与 TD 学习的奠基者,2019 年的《The Bitter Lesson》主张通用、可随算力扩展的方法最终胜出
阅读全文

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

Mistral 10 月 29 日发布改进版 Mistral Large 4(Le Chonk)并开放权重,已上架 Hugging Face(另有 NVFP4 量化版),API 名为 mistral-large-4。相比 10 月初的公开预览,多做了约三周强化学习:官方口径 FrontierCode 2.0 得分 19.7%、Terminal-Bench 4.0 从 28% 升到 41%,并新增 low/medium/high 三档推理。许可证为改版 MIT,商用可用,但做模型即服务需另签商业许可。

Mistral 正式开放 Mistral Large 4「Le Chonk」权重:1T 总参 / 约 52B 激活的多模态 MoE,官方称 FrontierCode 2.0 开源第一

核心要点速览

  • 规格:约 1T 总参数、每 token 激活 49B(含嵌入和输出层约 52B),128 个路由专家每次激活 4 个外加 1 个共享专家,1M 上下文,文本+图像输入
  • Mistral 口径:Cognition FrontierCode 2.0 得分 19.7%,高于 DeepSeek V4.1 Flash 的 19.3% 和 GLM-5.3 的 17.8%,开源模型第一
  • Artificial Analysis 编码智能体指数 48%,与 GLM-5.3 基本持平,但平均每任务少用 47% 的 token;Terminal-Bench 4.0 由预览版 28% 提升到 41%
  • Artificial Analysis Cyber Index 51%;对恶意网络安全请求的平均拒绝率 96.6%,官方称为开源模型中最高
  • 在 Mistral 自有欧洲数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练;Surge Code 盲评中仅次于 Claude Opus 5.5
阅读全文
关联模型 / 智能体 / 厂商:

Cadence 发布 Maestro 芯片设计领域 AI 模型组合:结合 NVIDIA Nemotron 驱动 AI Super Agents,官方称质量最高提升 30%、token 效率最高 5 倍

EDA 巨头 Cadence 10 月 26 日发布 Maestro AI 模型组合,包含领域后训练 LLM、决策模型和可自我改进的 agent skills,用来驱动其 AuraStack、ChipStack、InnoStack、ViraStack 等 AI Super Agents 操作 EDA/SDA 工具。Cadence 用确定性求解器给输出打分,形成强化学习闭环。官方初步结果称相比通用基础模型质量最高提升 30%、token 效率最高 5 倍。NVIDIA 提供 Nemotron 与 OpenShell,可部署在 Cadence 云、公有云或客户本地。首批模型 2026 年第四季度向部分早期客户开放。

核心要点速览

  • Maestro 不是单个模型,而是一组领域后训练 LLM、决策模型和自我改进的 agent skills,按任务与前沿/开源模型混合调度
  • 确定性求解器和 EDA 工具对输出按工程目标与约束打分,作为强化学习反馈,形成可验证闭环
  • Cadence 口径:相比通用基础模型,质量最高提升 30%,token 效率最高 5 倍;暂无第三方评测
  • NVIDIA 提供 Nemotron 模型与 OpenShell 沙箱参考架构;客户可用自有设计数据继续后训练,支持本地部署
  • 首批模型仅在 2026 年 Q4 向部分早期客户开放;Socionext 称部署 InnoStack 预计最高 5 倍生产力提升
阅读全文
AD赞助内容

微软亚研院开源 WildAWM:野外环境通用智能体世界模型,重构 GUI 与网页端到端仿真底座

微软亚洲研究院(MSRA)研究团队在 arXiv:2610.26828 正式发布并开源通用智能体世界模型 WildAWM(MSR-Orchard/WildAWM)。针对当前跨平台 GUI 与网页浏览智能体(Computer-Use Agents)在训练和评测中高度依赖昂贵、慢速且不可撤销的真实物理沙盒环境的痛点,WildAWM 首创可适应野外复杂异构环境的多模态自回归世界模型架构。模型能够在接收任意智能体动作(点击、输入、滚动)后,极其逼真地预测网页与桌面操作系统下一帧的高保真视觉状态演化与 DOM 结构变化,成功替代物理沙盒,为大规模自主智能体的离线强化学习与安全预演树立了全新基座。

微软亚研院开源 WildAWM:野外环境通用智能体世界模型,重构 GUI 与网页端到端仿真底座

核心要点速览

  • 微软亚研院在 arXiv:2610.26828 开源 WildAWM,首创面向真实野外复杂环境(桌面/Web)的智能体世界模型
  • 彻底破解 GUI 智能体训练依赖真实物理服务器与网页环境造成的昂贵算力开销和状态破坏风险
  • 基于动作条件(Action-Conditioned)的多模态自回归架构,精准仿真点击、键盘输入与长页面滚动后的视觉响应
  • 在跨电商、CRM 与操作系统多项仿真一致性评测中大幅超越传统离散状态转移模型,全面开源代码与权重
阅读全文

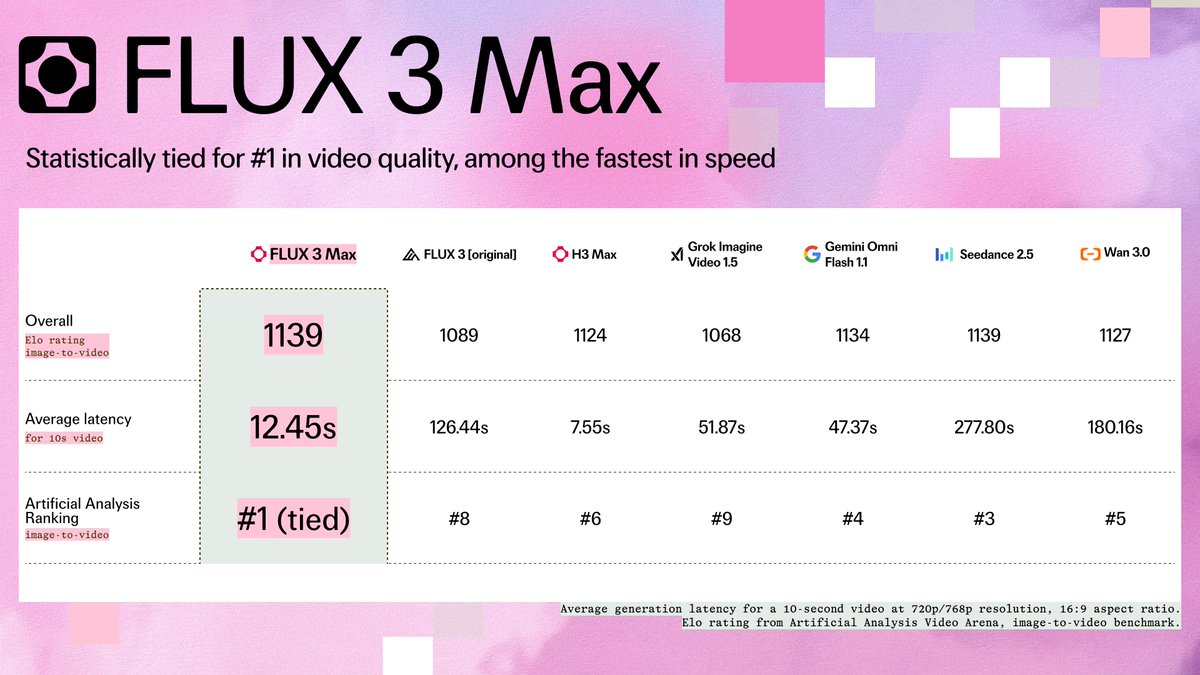
fal 联合 Black Forest Labs 发布视频模型 FLUX 3 Max:图生视频质量并列第一,10 秒视频约 12 秒生成,比 Seedance 2.5 快约 22 倍

fal 于 10 月 19 日(UTC)发布 FLUX 3 Max,这是 fal Research 与 Black Forest Labs 合作、在 FLUX 3 基础模型上做后训练、强化学习和推理优化得到的视频生成模型,支持文生视频、图生视频和关键帧,最长 20 秒,可选 720p/1080p 并默认生成音频。在 Artificial Analysis 图生视频竞技场的初步榜单上它得到 1,139 Elo,与 Seedance 2.5 同分、和第一名 MiniMax H3(1,141)置信区间重叠,按厂商口径生成 10 秒视频约 12.45 秒。目前 75% 折扣至 11 月 7 日,720p 每秒 0.0425 美元。

fal 联合 Black Forest Labs 发布视频模型 FLUX 3 Max:图生视频质量并列第一,10 秒视频约 12 秒生成,比 Seedance 2.5 快约 22 倍

核心要点速览

  • Artificial Analysis AA-Video-I2V v1.1 初步榜单:FLUX 3 Max 1,139 Elo,与 Seedance 2.5 同分,略低于 MiniMax H3 的 1,141,官方称「并列第一」是因置信区间重叠
  • 速度(fal 口径,10 秒 16:9 720p):FLUX 3 Max 12.45 秒,Gemini Omni Flash 1.1 47.37 秒,Seedance 2.5 277.80 秒;新闻稿另写 10.95 秒,两处口径不一
  • 相比原版 FLUX 3:Elo 从 1,089 提到 1,139(+50),10 秒视频耗时从 126.44 秒降到约 12 秒(新闻稿称 11.5 倍、产品页称约 10 倍)
  • 价格:促销价 720p 每秒 0.0425 美元、1080p 每秒 0.0725 美元,11 月 7 日后恢复 0.17 / 0.29 美元每秒,按输出秒数计费
  • API 参数:时长 5–20 秒、7 种以上画幅、reasoning_level(low/high)、generate_audio 默认开启;模型 ID 为 blackforestlabs/flux-3-max/*
阅读全文
关联模型 / 智能体 / 厂商:
⚡ FLUX 3 Max⚡ FLUX 3⚡ Seedance 2.5⚡ MiniMax H3🌐 fal🌐 Black Forest Labs🌐 Artificial Analysis

慕尼黑工大开创关系型数据库世界模型 TabWM:推演业务动态演化,开启企业数据库智能体强化学习

慕尼黑工业大学(TUM)研究团队在 arXiv:2610.16763 中开创性提出将关系型数据库交互建模为环境世界模型的 TabWM(Tabular World Model)框架与 WorldRel 生成器。针对现有关系型机器学习仅能静态预测表格属性、无法推演特定业务操作对数据库状态演化后果的根本缺陷,TabWM 将操作数据库视作离散“关系世界”,通过离线执行日志推演动态状态转移,为企业自主决策智能体与数据库离线强化学习铺平道路。

慕尼黑工大开创关系型数据库世界模型 TabWM:推演业务动态演化,开启企业数据库智能体强化学习

核心要点速览

  • 慕尼黑工业大学开创性提出将关系型数据库建模为世界模型的 TabWM 框架与 WorldRel 基准(arXiv:2610.16763)
  • 打破传统机器学习对表格的静态预测局限,推演业务动作引发的跨表级联状态差分演化
  • 在完全未见的动态世界中仅凭 10~20 条历史轨迹即可达成 0.84 以上的状态预测相关度,决策回报提升 28.4%
  • 为企业在生产数据库外部构建高保真离线业务沙盒、落地自主 Agent 强化学习提供了开创性基础
阅读全文
关联模型 / 智能体 / 厂商:

AWS 与 UIUC 联合开源 Lean4AgenticRL:形式化验证多级过程奖励,TerminalBench 跑分高达 77.3%

亚马逊 AWS 与伊利诺伊大学厄巴纳-香槟分校(UIUC)研究团队在 arXiv:2610.22448 中正式开源 Lean4AgenticRL 框架。针对传统 Agent 强化学习过度依赖稀疏二值结果奖励(Outcome Rewards)、忽视底层工具调用与中间工作流状态的痛点,该研究首次将多级过程奖励锚定在 Lean4 交互式定理证明器的形式化模式中,提出工作流阶段归一化 GRPO 算法。训练得到的 LAR-27B 在 TerminalBench-2.1 上斩获 77.3% 高分,较基座模型提升 9.89%。

AWS 与 UIUC 联合开源 Lean4AgenticRL:形式化验证多级过程奖励,TerminalBench 跑分高达 77.3%

核心要点速览

  • AWS 与 UIUC 联合推出 Lean4AgenticRL(arXiv:2610.22448),首创将多级过程奖励形式化锚定在 Lean4 交互式定理证明器中
  • 针对稀疏结果奖励痛点,提出工作流阶段归一化 GRPO 算法,有效隔离长轨迹多步探索的高方差与奖励黑客
  • 训练得到的 LAR-27B 在 TerminalBench-2.1 上取得 77.3% 佳绩,较基座模型大幅提升 9.89%,超越同尺寸最优模型 5.07%
  • 消融实验证实形式化阶段校验使收敛速度提升超 42%,为工业级自主编程与终端 Agent 提供可验证强化学习新范式
阅读全文
关联模型 / 智能体 / 厂商:

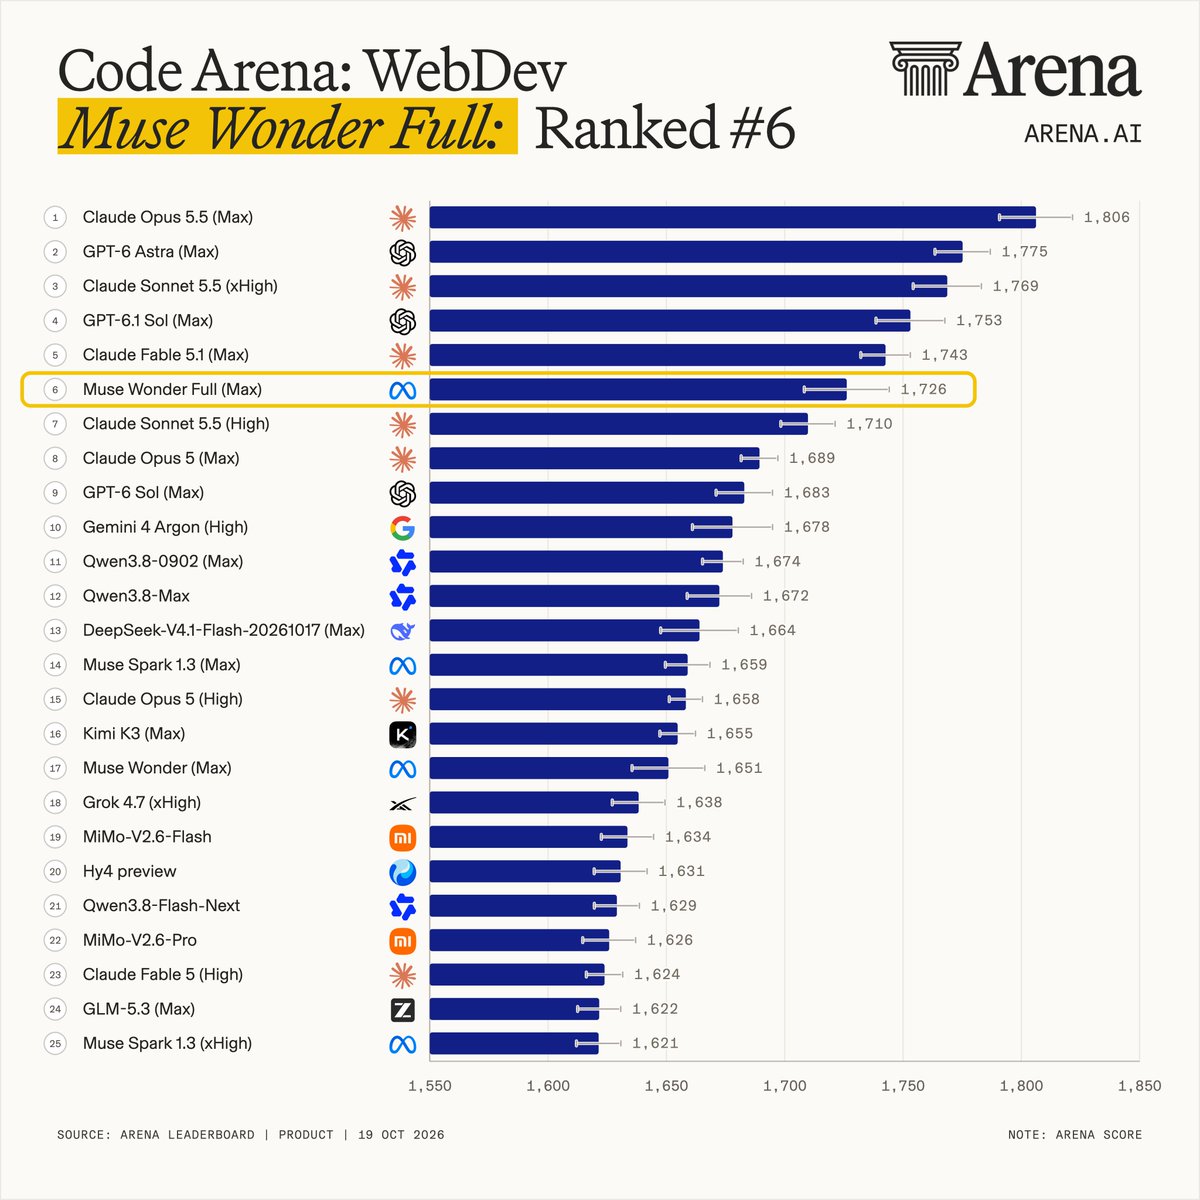
Meta 披露 Prometheus 吉瓦级超算集群:Muse Wonder 跃居 WebDev 竞技场第 6,助力 Meta 升至全球第三

Meta 官方正式披露其位于俄亥俄州新奥尔巴尼的吉瓦级(Gigawatt-Scale)AI 超算中心 Prometheus,拥有数十万张顶尖 GPU,在预训练中实现超 85% 的有效算力率(Goodput),在强化学习(RL)中达到 90% 以上。在此超级算力加持下,Meta 新一代代码与视觉旗舰模型 Muse Wonder Full 在 LMSYS Code Arena: WebDev 中斩获 1726 分跃居全球第 6 名(超越 Claude Sonnet 5.5 与 Gemini 4 Argon),推动 Meta 晋升全球前三大模型实验室。

Meta 披露 Prometheus 吉瓦级超算集群:Muse Wonder 跃居 WebDev 竞技场第 6,助力 Meta 升至全球第三

核心要点速览

  • Meta 披露位于俄亥俄州新奥尔巴尼的 Prometheus 吉瓦级超算集群,拥有数十万张 GPU 并实现 85%+ 预训练有效算力率
  • 强化学习有效算力率达 90%+,在 Muse Wonder 训练期间达成约 47,000 GPU·小时连续无故障运行
  • Muse Wonder Full 在 LMSYS Code Arena: WebDev 斩获 1726 分位列全球第 6,超越 Claude Sonnet 5.5(+16 分)与 Gemini 4 Argon(+48 分)
  • 推动 Meta 跃居全球第 3 大 AI 实验室,并同步推出可在单张消费级 GPU 上 4-bit 本地运行的 Muse Glimmer 30B
阅读全文
关联模型 / 智能体 / 厂商:

Meta 首次详解训练 Muse Wonder 的吉瓦级超算 Prometheus:预训练有效算力 85%+、RL 90%+,目标扩到约 100 万块 GPU

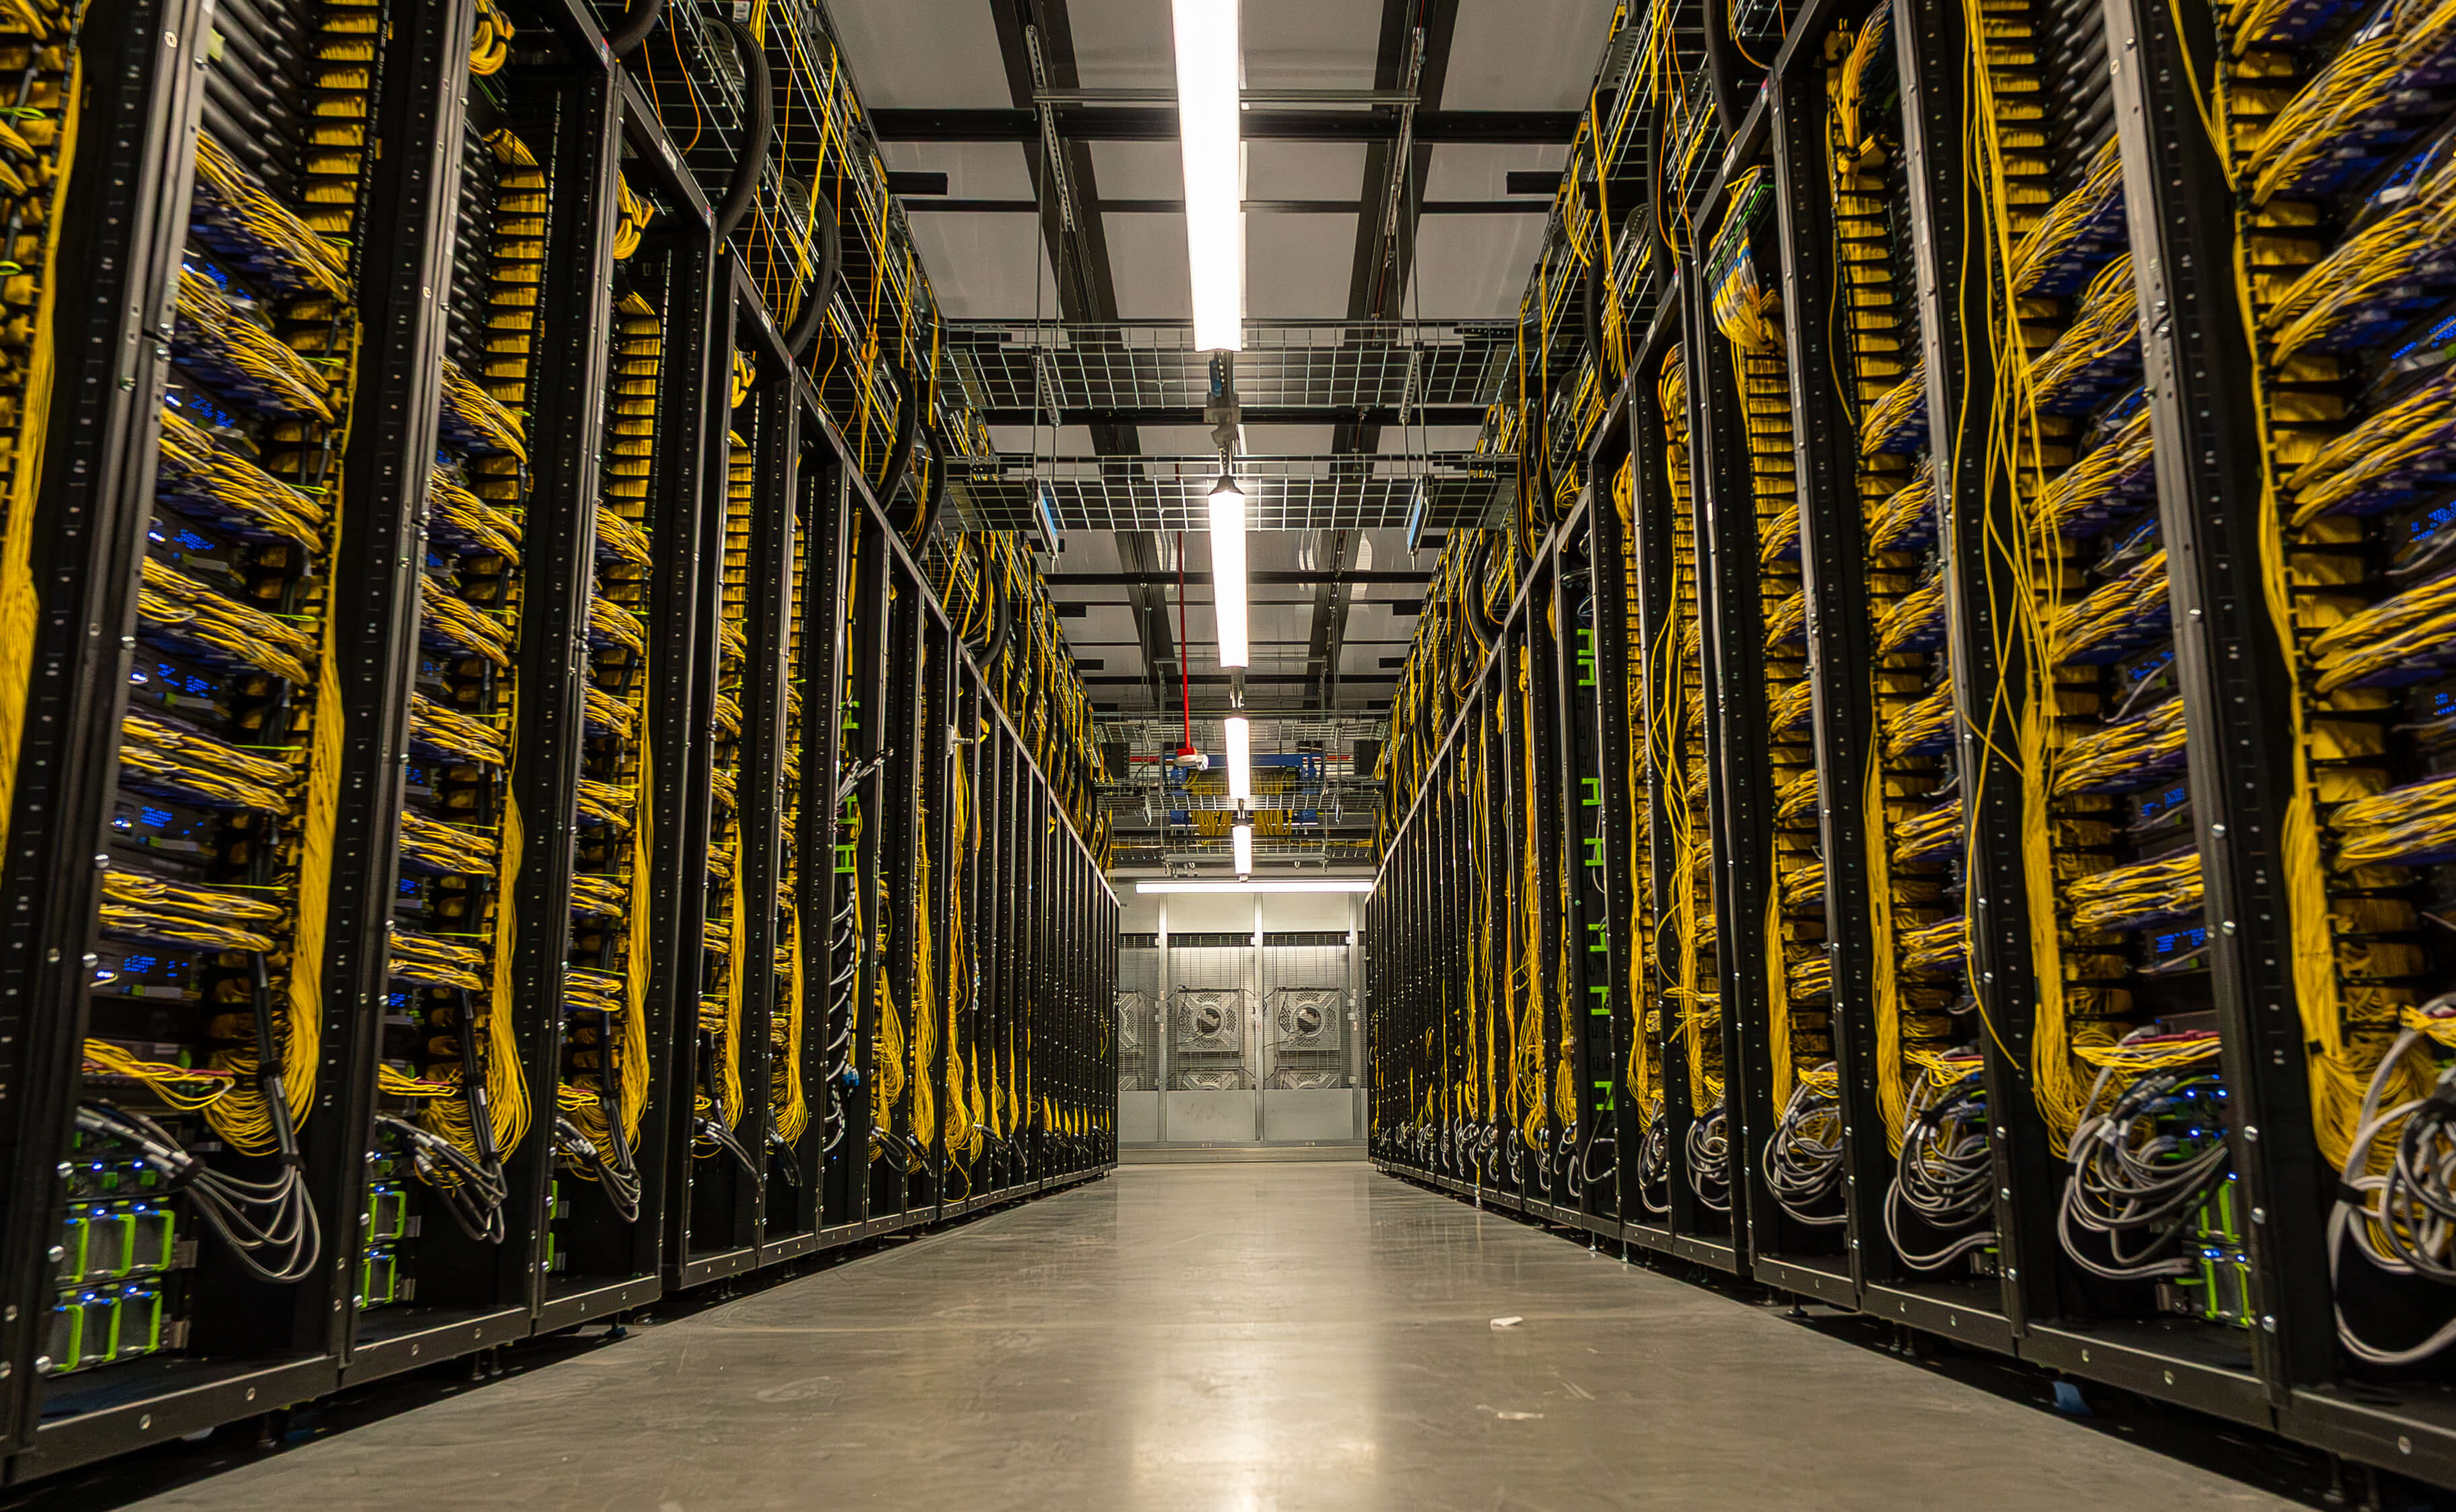
Meta 工程博客 10 月 19 日发文,首次公开训练 Muse 系列(含 Muse Wonder)的俄亥俄州 New Albany 超算集群 Prometheus。一期已建成,目前有数十万块 GPU,满配目标约 100 万块。训练 Muse Wonder 时预训练 goodput(有效训练时间占比)超过 85%、强化学习超过 90%,平均无中断时间约 4.7 万 GPU 小时,之后经固件修复提升到 5.4 万以上。硬件为 GB200 NVL72 和 GB300 NVL72 两代平台,Vera Rubin NVL72 即将到位。

Meta 首次详解训练 Muse Wonder 的吉瓦级超算 Prometheus:预训练有效算力 85%+、RL 90%+,目标扩到约 100 万块 GPU

核心要点速览

  • 规模:一期已用于训练 Muse 系列,现有数十万块 GPU,满配约 100 万块,跨多栋建筑当作一台机器运行。
  • 稳定性:Muse Wonder 预训练 goodput 超 85%、RL 超 90%;平均无中断时间约 4.7 万 GPU 小时,现已超 5.4 万。
  • 中断率:2025 年年中峰值接近每 8K GPU 每天约 1000 次中断,一年工程后下降 99%。
  • 冗余设计:每个 NVL72 机柜只用 64 块 GPU、留 8 块热备,另备约 2% 机柜;3.2768 万卡任务需 523 个机柜共 37,656 块 GPU,约多 13%。
  • 网络:单栋楼 fabric 最多连 20,736 块 GPU,跨楼聚合网络覆盖 2 公里到 100 多公里。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Modal 将用 NVIDIA Vera CPU 跑 Agent 沙箱:高并发下吞吐最高达同级 x86 的 2 倍

Modal 10 月 19 日发布博客,宣布将为 Modal Sandboxes 引入 NVIDIA 的 Arm 架构 Vera CPU,这是它首次走出纯 x86 机群。Modal 用 50 个 Terminal-Bench 任务自建了 Agentless Agent Bench,测得在大量并发容器下,Vera 的任务吞吐最高可达同级 x86 GNR 机器的 2 倍,单任务延迟持平或更低(厂商口径)。空载串行时 Vera 优势并不明显。这批算力主要服务后台编码 Agent 和强化学习 rollout。

Modal 将用 NVIDIA Vera CPU 跑 Agent 沙箱:高并发下吞吐最高达同级 x86 的 2 倍

核心要点速览

  • 吞吐:高并发下 Vera 任务吞吐最高为同级 x86 GNR 机器的 2 倍,单任务延迟持平或更低(Modal 早期测试,厂商口径)。
  • 基准:Agentless Agent Bench 由 50 个 Terminal-Bench 官方解法与校验器组成,去掉网络调用,只测编译、grep、git、设备模拟等 CPU 工作。
  • 空载串行:50 个任务里 Vera 常常更快但并非总是,领先幅度不大;优势主要出现在资源争抢时。
  • 原因:Modal 认为 Vera 的高内存带宽让每核可多塞容器而不降频;增加 CPU 数量时 x86 方案提前到达吞吐平台期。
  • 落地:这是 Modal 首次支持 Arm,需要改造基础设施和镜像构建;官方未公布上线时间和价格。
阅读全文

斯坦福与伯克利提出 Librarian Agents:训练 LLM 预先编排长上下文工作区,检索开销直降 33.8%

来自斯坦福大学与加州大学伯克利分校的研究团队在 arXiv:2610.22273 中提出图书管理员智能体(Librarian Agents)。针对传统 RAG 被动检索导致推理期跨文档推理瓶颈的问题,该方法利用强化学习(RL)训练 LLM 预先对杂乱的超长文档工作区进行“前瞻性主动编排”,生成由模块化文件、子目录与交叉链接构成的合成文件系统。在 BrowseComp+ 评测中准确率达 55.86%,导航 Token 消耗降低 33.8% 至 51%。

斯坦福与伯克利提出 Librarian Agents:训练 LLM 预先编排长上下文工作区,检索开销直降 33.8%

核心要点速览

  • 斯坦福与伯克利联合发布 Librarian Agents(arXiv:2610.22273),提出将大模型从被动反应式 RAG 升级为前瞻性工作区主动编排
  • 利用强化学习训练构建智能体执行 CreateFile 与 MergeFiles 等操作,将超长杂乱文档预先重构为结构化的合成文件系统
  • 在 BrowseComp+ 评测中以仅 3,635 个导航 Token 取得 55.86% 准确率,相较平铺非层级结构节省 51% 的推理期导航 Token 开销
  • 在每个知识库回答 10 个问题的场景下,单正确答案期望 Token 消耗降低 33.8%,为高频复用的大型代码库与企业知识库提供高效摊销解法
阅读全文
关联模型 / 智能体 / 厂商:

破解 GRPO 同质化坍缩!SERO 可执行先知续写使 ALFWorld 泛化暴涨 11.2 分,EDEN 锚定嵌入噪声令 AIME 2025 飙升 13.3 分

无 Critic 群组强化学习(GRPO 等)在长程 Agent 与高难数学推理中极易陷入“采样轨迹高度同质化、全组零奖励无梯度信号”的探索死局。今日两篇前沿论文从轨迹续写与输入嵌入两端破局:SERO(arXiv:2610.19397)从策略真实到达的状态恢复环境并执行多步 Oracle 续写,使 7B 模型在 ALFWorld 分布外泛化暴涨 11.20 个百分点;UNSW 提出的 EDEN(arXiv:2610.16105)在输入末尾追加单个锚定高斯噪声嵌入位,在同等采样预算下令 Qwen2.5-Math-7B 的 AIME 2025 Pass@256 飙升 13.33 个百分点(达 66.67%)。

破解 GRPO 同质化坍缩!SERO 可执行先知续写使 ALFWorld 泛化暴涨 11.2 分,EDEN 锚定嵌入噪声令 AIME 2025 飙升 13.3 分

核心要点速览

  • SERO 从当前策略真实到达的状态恢复环境并执行多步 Oracle 可执行续写,使 7B 模型在 ALFWorld 分布外泛化成功率暴涨 11.20 个百分点(达 87.50%,分布内达 95.57%)
  • UNSW 提出的 EDEN 在不增加采样预算的前提下,通过追加单个锚定高斯噪声嵌入位,在 16 条采样预算下全面击败 32 条采样预算的标准 GRPO
  • 在奥赛级基准 AIME 2025 上,EDEN 将 Qwen2.5-Math-7B 的 Pass@256 从 53.33% 飙升至 66.67%(净增 +13.33 分),显著拓宽多路径推导覆盖率
阅读全文
关联模型 / 智能体 / 厂商:

破解上下文压缩与子智能体分叉 RL 难题!Mosaic 首创多会话智能体强化学习:按边际贡献精准分配跨会话优势

现有智能体强化学习(Agentic RL)普遍假设单条轨迹在单一连续累积的上下文会话(Single-Session)中完成,但这与真实生产环境中广泛使用的上下文压缩(Context Compaction)和子智能体派生(Subagent Forking)严重脱节。研究团队提出多会话智能体强化学习框架 Mosaic(arXiv:2610.22174),通过无 Critic 的分层优化将‘会话使用信号’纳入全局优势估计,并根据估计的边际贡献(Marginal Contribution)对每个独立子会话塑形奖励。在 BrowseComp 上的实测表明,Mosaic 在上下文压缩与子智能体分叉两大场景中全面超越传统全局广播基线,且平均消耗更少的会话次数。

破解上下文压缩与子智能体分叉 RL 难题!Mosaic 首创多会话智能体强化学习:按边际贡献精准分配跨会话优势

核心要点速览

  • 直击生产级 Agent 核心痛点:首次解决‘上下文压缩(Context Compaction)’与‘子智能体派生(Subagent Forking)’造成的多会话强化学习失配问题
  • 无 Critic 双层边际贡献分配:轨迹层计入会话开销信号,会话层按估计边际贡献独立塑形优势,淘汰粗暴的全局优势广播
  • BrowseComp 提分降耗双赢:基于 Qwen3.5-4B 在压缩与分叉双场景全面击败基线,且单任务平均消耗的会话数量显著减少
阅读全文
关联模型 / 智能体 / 厂商:

揭秘单元测试奖励副作用!PreciseCoder 根治编程模型“过度修改与无病乱改”:平均改动行数从 15 行锐减至 3 行

基于单元测试通过与否的强化学习(Unit-Test RL)是当前后训练代码模型的标准范式,但研究发现仅靠测试通过率奖励会诱导模型‘胡乱扩大修改范围’甚至在原本正确的代码上产生幻觉式改写。研究团队提出 PreciseCoder,在单元测试奖励之上引入语义验证的局部化精准编辑奖励。在 4B、9B 与 27B 模型上将平均修改代码行数从 7–15 行压缩至仅 3 行,零样本迁移至仓库级修复解决更多 Issue,且将 9B 推理轨迹提供给 GPT-5.6 Sol 与 Qwen3.8-Max 可直接提升 4.6–12.4 个百分点的编辑精度。

揭秘单元测试奖励副作用!PreciseCoder 根治编程模型“过度修改与无病乱改”:平均改动行数从 15 行锐减至 3 行

核心要点速览

  • 揭示纯单元测试 RL 隐患:仅靠测试通过率奖励会诱导代码模型大面积过度编辑,甚至在正确代码上产生幻觉修改
  • 平均改动从 7–15 行压缩至 3 行:引入语义验证局部编辑奖励,在 4B/9B/27B 模型上实现外科手术式精准修复并泛化至仓库级任务
  • 9B 思维链跨代赋能旗舰模型:将 9B PreciseCoder 的推理轨迹喂给 GPT-5.6 Sol 与 Qwen3.8-Max,零训练直接提升 4.6–12.4 个百分点编辑精度
阅读全文
关联模型 / 智能体 / 厂商: