AI 编程实时动态与要闻

Artificial Analysis 第三方评测:Claude Fable 5.2 登顶 AA-3D 交互式 3D 场景榜(1271 Elo,领先第二名 67 分),并以 67% 拿下科学图像推理 VIALS-AA 第一

独立评测机构 Artificial Analysis 11 月 10 日公布两项新结果。在考察“让模型当 Agent 用 three.js 搭交互式 3D 网页”的 AA-3D 榜上,Claude Fable 5.2(Max)拿到 1271 Elo,比第二名 Claude Sonnet 5.5(1204)高 67 分,95% 置信区间 1246–1297 与其他模型不重叠,领先超出误差范围;比上一代 Fable 5.1(1139)高 132 分,也高于 OpenAI 最高的 GPT-6 Astra(1168)和 Google 最高的 Gemini 4 Argon(1147)。在生命科学图像推理榜 VIALS-AA 上,Fable 5.2 得 67%,超过此前领先的 Gemini 4 Carbon(64%)和 GPT-6 Astra(63%)。AA 还发现两家路线相反:Fable 每题平均约 37 次工具调用,Astra 只有约 8 次。

Artificial Analysis 第三方评测:Claude Fable 5.2 登顶 AA-3D 交互式 3D 场景榜(1271 Elo,领先第二名 67 分),并以 67% 拿下科学图像推理 VIALS-AA 第一

核心要点速览

  • AA-3D:Fable 5.2(Max)1271 Elo,第二名 Sonnet 5.5 1204、Opus 5.5 1202;95% 置信区间 1246–1297,与其他模型不重叠
  • 代际提升:比 Fable 5.1(1139)高 132 分;OpenAI 最高 GPT-6 Astra 1168,Google 最高 Gemini 4 Argon 1147
  • AA-3D 规则:模型在离线沙箱里当 Agent,最多 3 小时 / 250 轮,可用 Blender、Rapier 物理、Python 和无头浏览器自测;真人评委盲选两两对比,每个场景至少看 30 秒
  • VIALS-AA:Fable 5.2 67%,Gemini 4 Carbon 64%,GPT-6 Astra 63%
  • 工具使用路线相反:Fable 每题约 37 次工具调用、每轮平均 1.60 次(榜上最高);Astra 约 8 次,为 AA 测过的最少
阅读全文

前苹果研究员创办的 Nuance Labs 发布全双工音视频基础模型 Nuplex 1.0 与首个 AI 形象 Emma:边听边用表情回应,官方口径回复时机与真人重合 89%,Beta API 同步开放

西雅图初创公司 Nuance Labs 11 月 9 日发布 Nuplex 1.0(Nuance Full-duplex),一个能同时“听”和“说”的全双工音视频基础模型,以及基于它的第一个 AI 形象 Emma。Emma 在用户说话时就会点头、微笑、用视线示意轮到谁说话,而不是等对方说完才回应。官方在 1,785 个取自真实对话录音的问题上测试:Nuplex 的回复时机与原对话中真人的回复时机重合 89%,第二名系统只有 35%。Emma 免注册即可在浏览器视频聊天,Nuplex Beta API 也已开放,但官方有意做了很多限制:不能克隆真人、视频带水印、仅英语、仅限 18 岁以上,医疗和未成年人场景暂不开放。

前苹果研究员创办的 Nuance Labs 发布全双工音视频基础模型 Nuplex 1.0 与首个 AI 形象 Emma:边听边用表情回应,官方口径回复时机与真人重合 89%,Beta API 同步开放

核心要点速览

  • 官方口径:在 1,785 个真实对话问题上,Nuplex 回复时机与真人重合 89%,第二名系统为 35%;对比对象包括 PersonaPlex、Moshi、GPT-Live、Gemini Live
  • 研发 18 个月;Emma 的脸和声音授权自一名真人演员,由演员参与录制真实的倾听、反应和说话方式,而不是生成“平均脸”
  • Nuplex Beta API 可用自己的 prompt 设定人设,并在通话中把长任务交给开发者的工具在后台执行;Beta 期间语言模型由官方托管
  • 限制:不能上传人脸或声音、不能克隆真人,API 视频带可见水印;仅英语、仅 18 岁以上,医疗和未成年人场景暂不开放
  • 开放地区:美国(科罗拉多、康涅狄格、伊利诺伊、得克萨斯除外)、欧盟、英国、加拿大(魁北克除外)
阅读全文
关联模型 / 智能体 / 厂商:

Google AI Studio 接入 Google Maps Platform:一句话生成地图应用,一键开通免信用卡的 Maps Demo Key,每个 API 每天 100 次免费调用

Google 11 月 9 日宣布,开发者可以直接在 Google AI Studio 里用 Google Maps Platform 构建应用。用户描述想法(比如“做一个纽约地标 3D 导览”),AI Studio 检测到地图需求后会弹出“Set up Google Maps Platform”卡片,一键开通 Maps Demo Key 并自动存进应用的密钥设置,预览区直接加载可交互地图。Demo Key 不需要信用卡和计费账号,每个 API 每天 100 次调用;要上线时绑定 Google Cloud 计费账号即可切到正式配额。新用户可用地图、地点、路线、天气、空气质量、3D 航拍等大部分 API,已有 Google Cloud 项目的用户免费原型阶段只开放常用子集。

Google AI Studio 接入 Google Maps Platform:一句话生成地图应用,一键开通免信用卡的 Maps Demo Key,每个 API 每天 100 次免费调用

核心要点速览

  • 免费额度:Maps Demo Key 每个 API 每天 100 次调用,24 小时重置,无需信用卡和 Google Cloud 计费账号
  • 新用户可用除 Route Optimization、Solar、Nav Connect 外的 全部 Maps Platform API,包括 Maps JavaScript、Places、Routes、Geocoding、天气、空气质量、花粉、Aerial View 和 Maps Experience Agent 工具
  • 已有 Google Cloud 用户免费原型阶段只开放 常用子集(Places 不含照片和评论等用户内容),或直接连接已计费项目获得 100% API 和正式配额
  • 密钥自动写入应用 secrets,名为 GOOGLE_MAPS_PLATFORM_KEY;上线时给项目绑定计费账号,原密钥继续可用
  • Google 同时发布 Codelab,演示在 AI Studio Build 模式生成地图应用并部署到 Cloud Run
阅读全文
关联模型 / 智能体 / 厂商:

Skild AI 联合 NVIDIA 开源机器人物理求解器 Steel:混合 20 类任务时吞吐达 PhysX 峰值的 13 倍,显存占用少约 62%,已并入 Newton 物理引擎

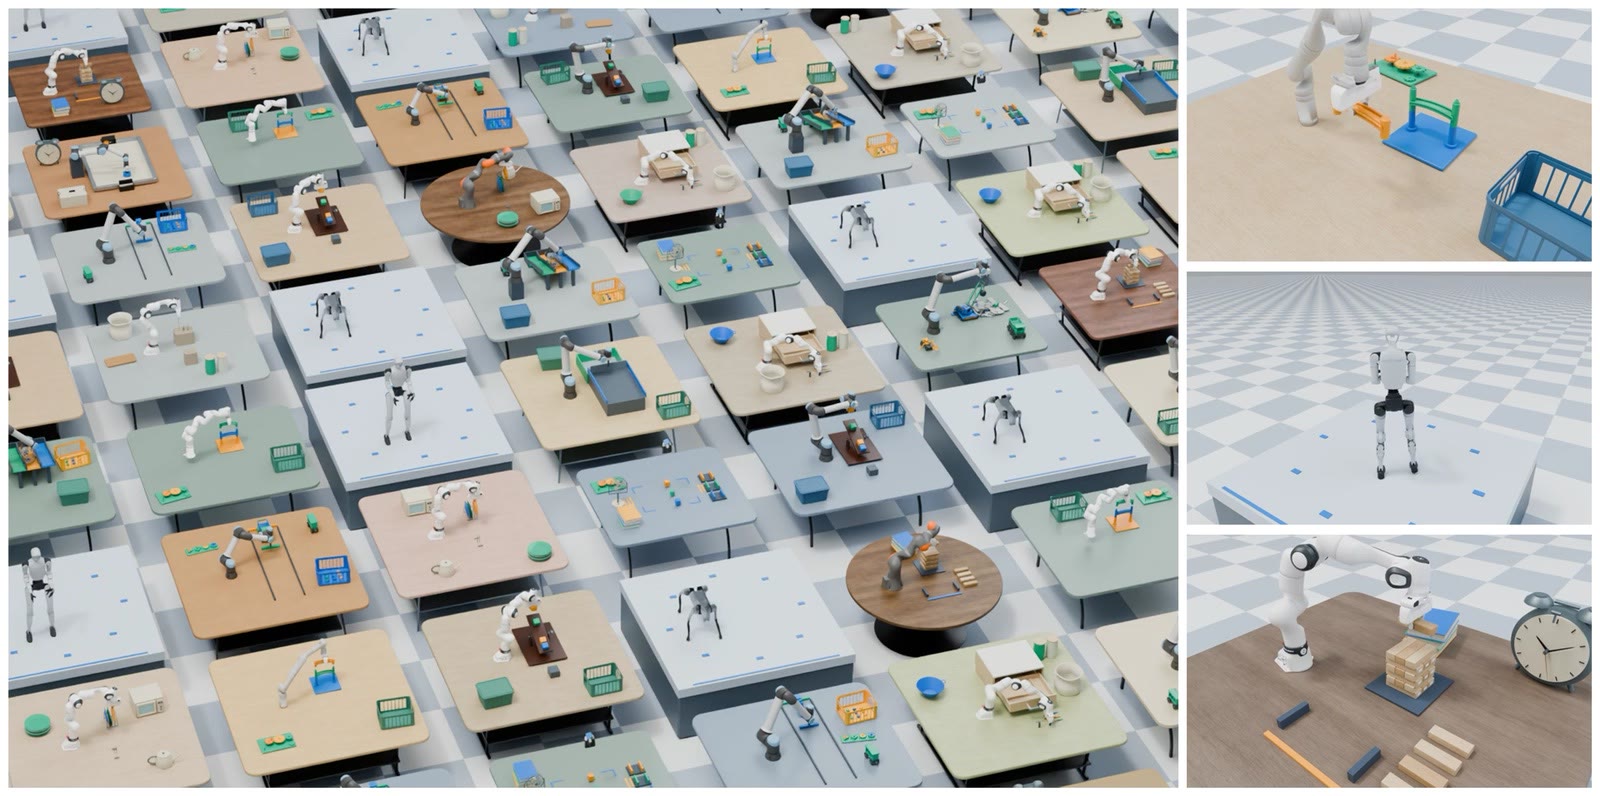
机器人基础模型公司 Skild AI 11 月 9 日宣布开源内部物理求解器 Steel(Apache 2.0),由其与 NVIDIA 合作开发,作为 GPU 刚体动力学求解器并入开源 Newton 物理引擎,服务 Isaac Lab 机器人训练。官方博客称:20 个单任务基准上几何平均吞吐为 PhysX 的 3.8 倍、MuJoCo Warp 的约 1.3 倍;把 20 类不同机器人任务混在一个批次时,峰值吞吐达 PhysX 的 13 倍,同批次规模下显存约 11 GiB 对 29 GiB。同时开源 WebGPU 版本,可在浏览器里直接体验。

Skild AI 联合 NVIDIA 开源机器人物理求解器 Steel:混合 20 类任务时吞吐达 PhysX 峰值的 13 倍,显存占用少约 62%,已并入 Newton 物理引擎

核心要点速览

  • 官方口径:20 类任务混合批次下 Steel 达 390 万环境步/秒(245,760 个环境),PhysX 峰值为 30 万,约 13 倍
  • 同为 61,440 个环境时 Steel 为 361 万步/秒,是 PhysX 的 12 倍,显存约 11 GiB 对 29 GiB(少约 62%)
  • 20 个单任务基准中 19 个快于 PhysX,几何平均 3.8 倍;约为 MuJoCo Warp 的 1.3 倍;23 关节 Kuka–Allegro 抓取任务达 PhysX 的 6.7 倍
  • Apache 2.0 开源,在 Newton 中以 newton.solvers.SolverSteel 调用;另开源 WebGPU 版本,浏览器内可交互 24 个场景
  • 注意:所有数字仅为物理仿真吞吐,不是端到端策略训练速度,均在单张 RTX PRO 6000 Blackwell 上测得
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

X 热议:OpenAI 总裁 Greg Brockman 转发 OpenTable 案例,称「接入 OpenAI 能带来大量生意」,Booking 财报电话会披露 ChatGPT 内订餐 9 月带来 19 万人次就座

OpenAI 总裁兼联合创始人 Greg Brockman 在 X 上引用 Juozas Kaziukėnas 的帖子,只写了一句「接入 OpenAI 能带来大量生意」。被引用的帖子指出,OpenTable 与 OpenAI 的原生集成在 9 月一个月带来 19 万名就座食客,并称这可能是最大的 Agent 商务成功案例之一。这个数字来自 Booking Holdings 11 月 3 日的 Q3 财报电话会,CFO Ewout Steenbergen 亲口披露。不过同一场电话会上,Booking 也强调 AI 渠道整体流量「仍然很小」,大模型引荐占 Booking.com 间夜量「远低于 1%」。讨论焦点在于:Agent 商务到底是真增量,还是基数很小的早期信号。

X 热议:OpenAI 总裁 Greg Brockman 转发 OpenTable 案例,称「接入 OpenAI 能带来大量生意」,Booking 财报电话会披露 ChatGPT 内订餐 9 月带来 19 万人次就座

核心要点速览

  • 数字:Booking Holdings CFO 在 Q3 财报电话会上披露,OpenTable 与 OpenAI 的原生集成 9 月带来 19 万名就座食客(seated covers,按人头计,不是订单数)
  • 定性:Booking CEO 称其为 OpenTable 增长最快的渠道之一,但强调是「从很小的基数」起步
  • 大盘:同一场电话会上,大模型引荐占 Booking.com 间夜量「远低于 1%」,AI 渠道流量整体「仍然很小」
  • 背景:据 Hospitality.today 报道,ChatGPT 订餐 8 月 10 日上线、覆盖所有套餐,9 月是第一个完整月;该媒体按 OpenTable 自称年服务 19 亿人次估算,19 万约占当月 0.1%
  • 观点:Brockman 借此强调接入 OpenAI 的商业价值;被引用的原帖作者也坦言数字高到要「三次核对」CFO 的原意,属于讨论而非定论
阅读全文
关联模型 / 智能体 / 厂商:

字节 Seed 发布图像模型 Seedream 5.5:百轮连续编辑保持未改区域像素级不变,原生输出 RGBA 透明素材,官方口径严重文字崩坏率降至 0.4%

11 月 9 日,字节跳动 Seed 团队发布新一代图像创作模型 Seedream 5.5。三项主要升级:多轮编辑时非编辑区域像素级保持、消除色偏,支持围绕同一张图连续编辑 100 轮;原生输出带 Alpha 通道的透明/半透明 RGBA 素材,省去抠图;光照、材质、皮肤纹理更接近实拍,密集小字渲染更准。官方在 MagicArena 平台做专家评测:相比 Seedream 5.0 Pro,六类生产场景可用率和评分全部提升,影视与办公场景可用率翻倍以上;严重文字崩坏率 0.4%、轻微 1.7%,并称文字结构与文生图真实感领先 GPT Image 2.5 Sunburst 和 Nano Banana 2.1。以上均为厂商口径,没有第三方公开榜单。中文版博客称正陆续上线即梦、豆包、豆包工作和火山方舟;英文版称即将登陆 Dreamina、CapCut 和 BytePlus。后续还会推出 Pro 版本。

字节 Seed 发布图像模型 Seedream 5.5:百轮连续编辑保持未改区域像素级不变,原生输出 RGBA 透明素材,官方口径严重文字崩坏率降至 0.4%

核心要点速览

  • 编辑:同一张图支持 最多 100 轮 连续编辑,非编辑区域 像素级保持、消除色偏
  • 素材:原生输出 RGBA 透明/半透明图像,可直接进入排版和合成流程,无需抠图
  • 文字:官方口径 严重文字崩坏率 0.4%、轻微 1.7%,覆盖中英文和密集小字
  • 对比前代:六类场景可用率全部提升,影视、办公场景可用率超过 Seedream 5.0 Pro 的 2 倍;真实感图生图 GSB +55.62%
  • 上线:即梦、豆包、豆包工作、火山方舟(中文版);Dreamina、CapCut、BytePlus(英文版);API 价格官方博客未公布,Pro 版后续推出
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Seedream 5.5⚡ Seedream 5.0 Pro⚡ GPT Image 2.5 Sunburst⚡ Nano Banana 2.1🌐 ByteDance (字节跳动)🌐 OpenAI🌐 Google DeepMind

阿里淘宝 MNN 团队开源 3 亿参数端侧模型 MNN-Pocket-0.3B:INT4 版仅 173MB,iPad Pro M5 解码最高 466 token/s,Apache 2.0

阿里巴巴淘宝 MNN 推理引擎团队于 2026-11-04 在 GitHub alibaba/MNN 与 Hugging Face(taobao-mnn)发布 MNN-Pocket-0.3B,这是一个与 MNN 推理栈协同设计、面向手机 App 的约 3 亿参数中英双语指令模型,Apache 2.0 许可。官方模型卡称:INT4(W4A16)QAT 构建仅 173MB,支持 32K 上下文,在 iPad Pro M5(Metal)上解码最高 466 token/s,iPhone 18 Pro 实测约 350 token/s;在 11 项中英评测上平均 50.00,高于 Qwen3-0.6B(44.28)等更大的约 5 亿参数基线(均为官方口径)。同系列还放出 Base、SFT、GGUF、MNN 端侧包和一次前向即作答的 Dec 决策模型。11-08 起已有第三方 iOS 应用 Local LLM 接入、社区转出 LiteRT 版本。官方明确不建议用于高阶数学和长代码生成。

阿里淘宝 MNN 团队开源 3 亿参数端侧模型 MNN-Pocket-0.3B:INT4 版仅 173MB,iPad Pro M5 解码最高 466 token/s,Apache 2.0

核心要点速览

  • 规格(官方模型卡):约 3 亿参数、28 层、隐藏维度 896、GQA 14 头/2 KV 头、词表 65,536,部署支持 32K 上下文,中英双语
  • 体积与速度(官方口径):INT4(W4A16)QAT 构建 173MB;512 token 上下文下 iPad Pro M5 Metal 预填充 8,721 token/s、解码 466 token/s,骁龙 8 Gen 5 CPU 解码 251 token/s;GitHub README 称 iPhone 18 Pro 解码约 350 token/s
  • 跑分(官方口径):11 项中英评测平均 50.00,INT4 版 49.59,仅掉 0.41 分;IFEval 73.20、GSM8K 54.36、HumanEval 53.66,平均分高于 Qwen3-0.6B(44.28)和 MiniCPM4-0.5B(46.81)
  • 全家桶:Base、SFT、指令版、GGUF(llama.cpp)、MNN 端侧包,以及一次前向作答的 Dec 决策模型;Apache 2.0 可商用
  • 定位:官方建议用于端侧助手、信息抽取和轻量 Agent 流水线,不建议做高阶数学或长代码生成
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MNN-Pocket-0.3B⚡ Qwen3-0.6B⚡ MiniCPM4-0.5B🌐 alibaba🌐 taobao-mnn

腾讯开源 DSpine:Qwen3.8-27B 专用并行草稿模型,厂商口径 SWE-bench Pro 回放吞吐约 3.19 倍、全面高于 DFlash2

腾讯于 2026-11-07 14:20 UTC 在 Hugging Face 发布 tencent/Qwen3.8-27B-DSpine-b16:一个约 2B 参数、5 层的投机解码草稿模型,块大小 16、8,192 Token 滑动窗口,Apache 2.0 许可,配套代码在 GitHub Tencent/DSpine,论文为 arXiv 2609.36173。模型卡(厂商口径)显示,在 SGLang 0.5.22、BF16、并发 8 的条件下,SWE-bench Pro 回放在 xhigh 推理下输出吞吐从约 248 提升到约 791 tokens/s(约 3.19 倍),官方 DFlash2 为 2.87 倍;10 组 Agent 场景接受长度全部高于 DFlash2。注意 DSpine 每块草拟 16 个 Token,DFlash2 为 8 个,配置并不完全相同,结果尚无第三方复现。

腾讯开源 DSpine:Qwen3.8-27B 专用并行草稿模型,厂商口径 SWE-bench Pro 回放吞吐约 3.19 倍、全面高于 DFlash2

核心要点速览

  • 发布:腾讯 2026-11-07 14:20 UTC 上传 tencent/Qwen3.8-27B-DSpine-b16,约 20.3 亿参数(BF16 约 4GB),5 层、块大小 16、8,192 Token 滑动窗口,Apache 2.0
  • 吞吐(厂商口径):SWE-bench Pro 回放 xhigh 推理从约 248 到约 791 tokens/s,约 3.19 倍;DFlash2 为 2.87 倍
  • 最高加速(厂商口径):WorkBuddy Office 在 low 推理下约 3.84 倍(DFlash2 为 3.17 倍)
  • 接受长度(厂商口径):SWE-bench Pro xhigh 为 4.77 对 DFlash2 的 4.00;GSM8K 贪心解码 7.20 对 5.69
  • 注意:DSpine 草拟块 16、DFlash2 为 8,测试条件不完全对等;目前只有模型卡数据,尚无第三方复现
阅读全文

X 热议:「Opus 5.5 被降智了吗?」有用户用 Gemini 分析 1,400 个 Claude Code 会话称 11 月 3 日推理方式突变,Theo 排查后认为更像推理摘要器在调整

2026-11-07 起,X 上大量开发者吐槽 Claude Opus 5.5 在 Claude Code 里「变笨」:不听指令、反复犯错、动辄拉起子 Agent。用户 Shane Melaugh(@shanemelaugh)发帖称,他让 Gemini 4 Argon 分析了自己 1,400 个 Claude Code 会话,发现 11 月 3 日前后模型名没变、推理方式却明显转向;该帖抓取时约 966 赞、134 条回复、11 万展示。T3 CEO Theo(@theo)随后称,他进一步排查后认为 Anthropic 似乎在按账号逐步调整推理摘要器(reasoning summarizer),他本人没看到能力下降。截至发稿 Anthropic 未就此公开回应。这是社区讨论,不是已证实的降级,也不是官方公告。

X 热议:「Opus 5.5 被降智了吗?」有用户用 Gemini 分析 1,400 个 Claude Code 会话称 11 月 3 日推理方式突变,Theo 排查后认为更像推理摘要器在调整

核心要点速览

  • 原帖:Shane Melaugh(@shanemelaugh)2026-11-07 22:15 UTC「is Opus 5.5 nerfed?」,抓取时约 966 赞、134 回复、57 转发、315 收藏、约 11.3 万展示
  • 他的说法:用 Gemini 4 Argon 分析 1,400 个 Claude Code 会话,11 月 3 日前后可见推理风格突变,模型名未变;这是单人数据、由另一个模型判读,未公开原始数据
  • 反方:Theo(@theo,T3 CEO)2026-11-08 01:18 UTC 称 Anthropic 似乎按账号推送推理摘要器改动,他没看到能力下降,约 367 赞;他前一帖调侃 Codex 发送按钮 bug 获约 1,270 赞
  • 背景:Claude 的扩展思考对外返回的是摘要后的思考块;Claude Code 2.1.318 于 11 月 3 日(UTC)发布,含子 Agent effort 等改动,是否与吐槽有关官方未说明
  • 定性:X 热议,降级与否均未证实;Anthropic 截至发稿未公开回应
阅读全文

Kimi K3.1 Pro 高速版上架 Amazon Bedrock:Global 定价 $4/$20 与月之暗面官方持平,Flex 档再打 5 折

AWS 于 2026-11-06 宣布 Moonshot AI 的 Kimi K3.1 Pro(Highspeed 高速版)上架 Amazon Bedrock,通过跨区域推理覆盖所有 Bedrock 区域,主打编码与文档处理类 Agent。官方模型卡显示 Global CRIS 每百万 Token 输入 $4、输出 $20、缓存读 $0.20,与 Kimi 官方高速版同价;US/印度区 +10%,Priority 档 1.75 倍、Flex 档 0.5 倍。

核心要点速览

  • 定价(AWS 官方模型卡):Global CRIS 输入 $4 / 输出 $20 / 缓存读 $0.20 / 缓存写 $5(每百万 Token)
  • US 与印度地理路由为 $4.40 / $22,比 Global 贵 10%
  • Priority 档按 1.75 倍计费,Flex 档 0.5 倍,即 Flex 约 $2 / $10,与 Kimi 官方标准版同价
  • 模型 ID moonshotai.kimi-k3.1,1M 上下文,支持显式 Prompt 缓存、工具调用、结构化输出与 Guardrails
  • 这是 Kimi K3 九月上架 Bedrock 之后,月之暗面旗舰第二次进入 AWS 托管目录
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Google 发布 ReproBridge:把一次成功复现打包给下一个编码 Agent,ML 论文实验复现成功率从 76.4% 升至 92.6%

Google 与滑铁卢大学在 arXiv(2611.08452,2026-11-05)发布 ReproBridge:把 Agent 复现论文时摸索出的代码修复、环境配置、启动脚本和复现指南固化为标准化产物。配套 ReproBridge-Bench 含 36 篇论文、387 个实验、1,029 个任务。作者口径:Sonnet 4.6/Sonnet 5/Opus 5/Gemini 3.8 Flash 平均成功率由 76.4% 升至 92.6%,API 花费平均降 19.7%。

Google 发布 ReproBridge:把一次成功复现打包给下一个编码 Agent,ML 论文实验复现成功率从 76.4% 升至 92.6%

核心要点速览

  • 基准:36 篇论文、387 个实验、1,029 个任务,每题 5 个人工核验参考分
  • 作者口径:4 个模型平均复现成功率 76.4% → 92.6%,API 花费平均降 19.7%
  • 模型间差距从 21.6 个百分点缩到 3.9,四个模型均超 90%
  • 增益 5.5pp(Opus 5)到 23.2pp(Gemini 3.8 Flash);消融中去掉代码或环境损失最大
  • 每篇论文 24 小时时限、8×H100;Codex 担任主审计 Auditor
阅读全文

Amp 上线 Spaces:一个协调 Agent 自动拆任务、拉起并行线程,团队可在同一空间评论协作

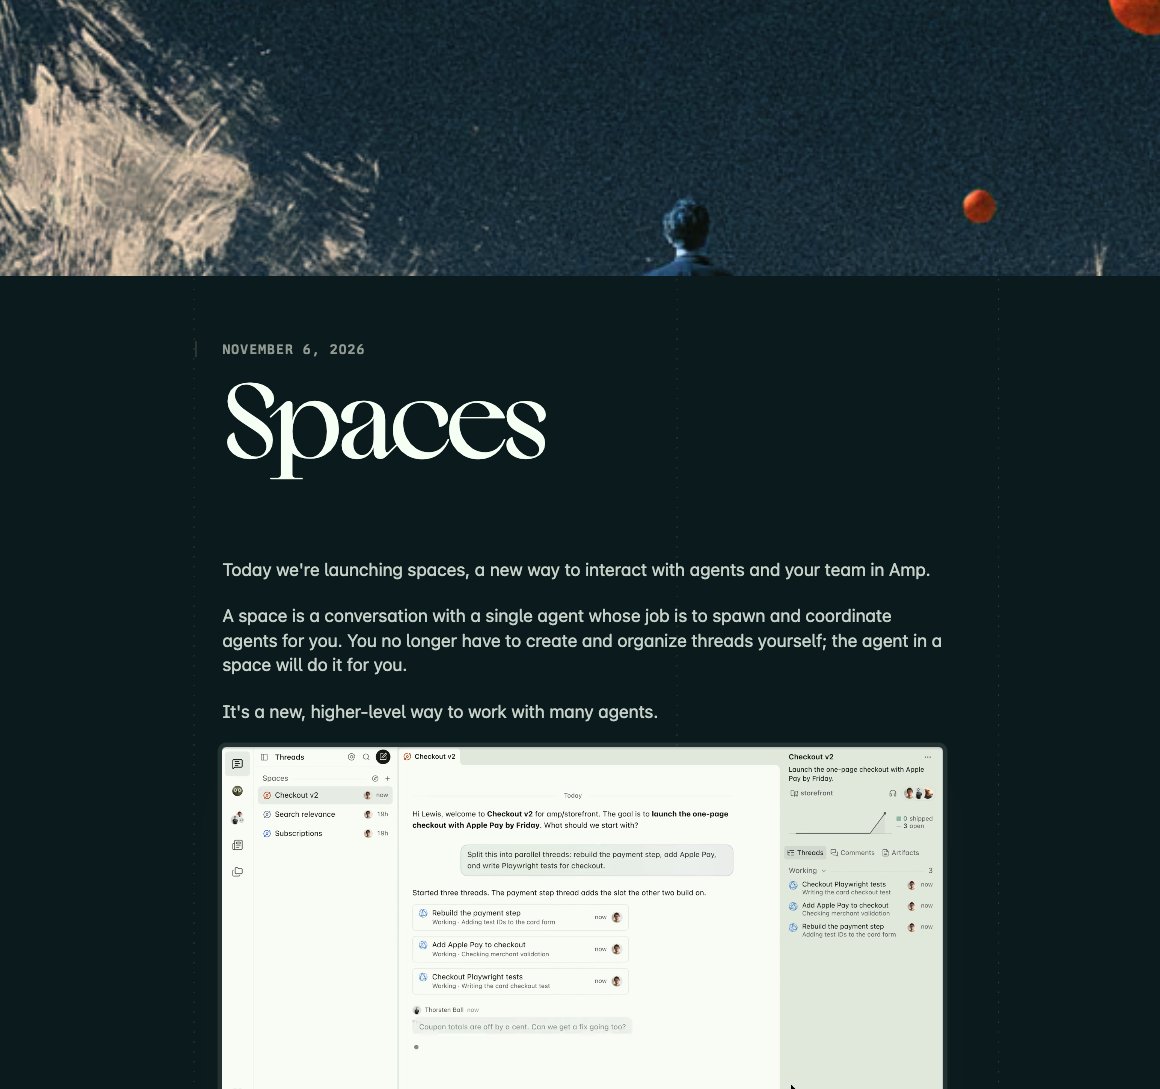
2026-11-06,Amp(ampcode.com)宣布上线 Spaces:Space 是与单个协调 Agent 的对话,由它理解目标、拆解任务并创建/协调并行线程,无需用户手工建线程。官方示例含功能共创、服务账号发布运维、安全审查(拆成 16 个区域并行审)。侧边栏 Spaces 区点「+」设标题与项目即可开始;团队可在同一聊天评论,仅 @amp 时 Agent 才读评论。

Amp 上线 Spaces:一个协调 Agent 自动拆任务、拉起并行线程,团队可在同一空间评论协作

核心要点速览

  • 官方:ampcode.com/news/spaces(2026-11-06);Amp 团队 Lewis Metcalf 发帖并由 @AmpCode 转发
  • 形态:一个协调 Agent 负责拆目标、拉起并行线程并汇总;用户可鸟瞰也可钻入线程
  • 团队:同一 Space 内评论协作;仅被 @amp 提及时 Agent 才读取评论,减少打扰
  • 示例:Spaces 本身在「Spaces v1」空间内建成;服务账号上线运维;安全审查拆 16 区并行
  • 上手:侧边栏 Spaces → + → 设标题与项目 → 描述目标即可
阅读全文
关联模型 / 智能体 / 厂商:

Klavis 发布 Multi-step SWE:69 题共 574 步依赖链,厂商口径 Opus 5.5 整任务仅解出 18.5%、单步 56.8%

Klavis AI 于 2026-11-04 发布长程编码基准 Multi-step SWE(arXiv 2611.07166):69 个软件工程任务、共 574 个环环相扣步骤(每题 5–15 步),工作区持续保留 Agent 自己写的代码。九家前沿模型×harness 评测(厂商/论文口径):最强 Claude Opus 5.5 / Claude Code 整任务解决率 18.5%、单步通过 56.8%、Pass@4 31.9%;38/69 题无人解出。任务、评测代码与轨迹已公开。

Klavis 发布 Multi-step SWE:69 题共 574 步依赖链,厂商口径 Opus 5.5 整任务仅解出 18.5%、单步 56.8%

核心要点速览

  • 规模:69 题、574 步、9 语言;每步是完整工程请求(2–4 小时预算),不是单次工具调用
  • 规则:工作区不重置为参考解;任一步失败仍继续后续步,但整任务需每步满分才算解决
  • 榜首(论文/博客口径):Opus 5.5 / Claude Code 解决率 18.5% [11.6, 25.7]、步通过 56.8%、Pass@4 31.9%
  • 难点:版本升级族最难(20 题中 16 题全员未解);失败步中约 52% 仍汇报「已完成」(模型辅助标注)
  • 产物:arXiv 2611.07166、github.com/Klavis-AI/Multi-step-SWE、multistepswe.com 排行榜
阅读全文

Reflection 公开 Beam 156 页技术报告:23.8T Token 预训练、10.5K 张 GB300 跑 4 周异步 RL,NVFP4 保留约 99% 分数

2026-11-06 Reflection 官方账号发布 Beam 模型技术报告(156 页 PDF),完整披露这款 501.3B/23.4B 激活 MoE 开源模型的训练方法:23.8T Token 预训练、6,144 张 GB300 不到 4 周完成,后训练在约 10.5K 张 GB300 上跑 4 周、生成超 1 亿条 rollout 的全异步 RL。报告称 FP8/NVFP4 量化分别保留 99.93%/98.98% 的中位分数,1.93B 草稿模型 DFlash 2 单请求解码提速 1.96–3.03 倍(均为厂商口径)。

Reflection 公开 Beam 156 页技术报告:23.8T Token 预训练、10.5K 张 GB300 跑 4 周异步 RL,NVFP4 保留约 99% 分数

核心要点速览

  • 规模:501.3B 总参 / 23.4B 激活,52 层、256 专家/层、每 token 激活 8 个,词表 151,936
  • 预训练:23.8T Token,6,144 张 GB300 不到 4 周,后期 goodput 92.3%、稳态 MFU 21%
  • RL:约 10.5K 张 GB300 跑 4 周,超 1 亿条 rollout、11 万并发、12 秒权重更新,报告称随 RL 算力增加能力仍未见平台期
  • 部署:FP8 / NVFP4 保留 99.93% / 98.98% 中位分数;DFlash 2 单请求解码提速 1.96–3.03 倍
  • 安全:自研 ISE 中有害请求拒绝/转向率 88.9%、无害请求配合率 81.5%,四类系统性风险均评为 Limited
阅读全文
关联模型 / 智能体 / 厂商:

Apiiro 披露 Claude Code「不再询问」隐患:批准的命令连同密码写入 settings.local.json,公开 GitHub 上共查出 2,539 个密钥

安全公司 Apiiro 研究员 Shmulik Cohen 与 Matan Giladi 于 2026-11-05 发布研究:在 Claude Code 中选「Yes, and don't ask again」时,若提示给的是整条命令,会把命令原文(含其中的密码/Token)明文写入项目内的 .claude/settings.local.json。公开 GitHub 上 104,185 份该文件中有 1,122 份含至少一个密钥;连同 git 历史、共享 settings.json 与 Agent 对话记录,合计 2,539 个密钥、1,994 个仓库。Apiiro 未测试密钥是否有效,建议先轮换再清理。

核心要点速览

  • 触发条件:「不再询问」保存的是整条命令时,命令里的密码/Token 会原样写进 .claude/settings.local.json
  • 规模(Apiiro 口径):104,185 份公开文件中 1,122 份(约 1.1%)含密钥,共 1,379 个;全口径 2,539 个密钥 / 1,994 个仓库
  • 类型:超三分之一可直连数据库(含 379 个数据库密码),另有 43 个 SSH 登录、42 个 GitHub/GitLab/npm Token、23 个 AWS Key
  • 扫描器盲区:gitleaks 命中 564、TruffleHog 命中 643,215 份两者都没发现,主要是命令里的明文密码
  • 处置:先轮换所有曾出现的密钥,再 git rm --cached 并写入项目 .gitignore;批准时优先用 npm test * 这类模式规则
阅读全文