AI 编程实时动态与要闻

月之暗面正式开放 Kimi K3.1 Pro 权重:2.8T 总参 / 104B 激活 MoE 上架 Hugging Face,MXFP4 量化约 1.56TB,自定义许可证限制大型 MaaS 商用

Kimi 官方账号 @Kimi_Moonshot 于 11 月 4 日 16:00(UTC)宣布开放 Kimi K3.1 Pro 模型权重,仓库 moonshotai/Kimi-K3.1-Pro 已公开、无需申请。模型卡显示它是 2.8T 总参、104B 激活的原生多模态 MoE,1M 上下文,权重以 MXFP4(量化感知训练)发布,仓库约 1.56TB;官方推荐 vLLM、SGLang 和 TokenSpeed 部署。许可证允许自由使用和修改,但年收入超 2000 万美元的 MaaS 业务需另签协议。

月之暗面正式开放 Kimi K3.1 Pro 权重:2.8T 总参 / 104B 激活 MoE 上架 Hugging Face,MXFP4 量化约 1.56TB,自定义许可证限制大型 MaaS 商用

核心要点速览

  • 架构:93 层(1 层稠密),69 层 KDA + 24 层 Gated DSA 注意力,896 个专家每 token 选 16 个外加 2 个共享专家,视觉编码器 MoonViT-V2(401M)。
  • 相比 K3,把全注意力的 Gated MLA 层换成了 Gated DeepSeek Sparse Attention,用于更高效的长上下文。
  • 模型卡厂商口径:Terminal-Bench 4.0 65.7(Opus 5.5 66.4)、SWE Marathon v1.1 51.7(Opus 5.5 46.3)、HLE-Full 带工具 70.0、BrowseComp 92.1;ProgramBench 31.5 明显落后 Opus 5.5 的 65.0。
  • 许可证:对外提供 MaaS 且连续 12 个月收入超 2000 万美元需与月之暗面另签协议;月活超 1 亿或月收入超 2000 万美元的产品须醒目标注「Kimi K3.1-Pro」,内部使用不受这两条限制。
阅读全文

OpenBMB 开源 MiniCPM-OCR 套件:1.3B 解析模型 Real5-OmniDocBench 93.68 分,另配 2B「判官」模型自动找出识别错误

面壁智能旗下 OpenBMB 10 月 27 日开源 MiniCPM-OCR 套件,含两款模型:1.3B 参数的文档解析模型 MiniCPM-OCR 1.0(Real5-OmniDocBench 93.68、OCRBench v2 54.7,官方口径),以及 2B 参数的 OCR 质量判定模型 MiniCPM-OCR Jev,可给任意 OCR 解析结果按区域打 0–1 分、标出需人工复核的内容。代码和权重均为 Apache 2.0,首发即支持 vLLM、SGLang、llama.cpp、Ollama 及多家芯片平台。

OpenBMB 开源 MiniCPM-OCR 套件:1.3B 解析模型 Real5-OmniDocBench 93.68 分,另配 2B「判官」模型自动找出识别错误

核心要点速览

  • 解析模型 MiniCPM-OCR 1.0 仅 1.3B 参数:Real5-OmniDocBench 93.68、OCRBench v2 54.7(官方口径,均称 SOTA)
  • 判定模型 MiniCPM-OCR Jev 2B 参数:JevOCRBench AUROC 93.6,高于 JEV-35B-A3B 的 90.1,接近 Qwen3.5-397B-A17B 的 93.8(官方口径)
  • Jev 与解析器无关:对 MiniCPM-OCR、GLM-OCR、PaddleOCR-VL-1.6、Xiaomi-OCR-0 的结果 AUROC 都在 91.9–93.4
  • 吞吐约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍;配合 SDK 并发最高约 128 页/分钟(官方口径)
  • GitHub 代码与权重全部 Apache 2.0,提供 GGUF/AWQ/GPTQ 量化版与 SKILL.md
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniCPM-OCR 1.0⚡ MiniCPM-OCR Jev⚡ PaddleOCR-VL-1.6⚡ MinerU2.5 Pro⚡ Qwen3.5-397B-A17B🌐 OpenBMB🌐 ModelBest🌐 Intel🌐 NVIDIA🌐 Arm

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

扩散智能 DiffuSpace(成员来自推出 Dream 7B 的港大 NLP 实验室)10 月 28 日发布首个模型 Clover-35B-A3B-Preview:基于 Qwen3.6-35B-A3B 初始化的 MoE 扩散语言模型,总参 35B、激活约 3B、128K 上下文,按块并行去噪生成。官方口径下 SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、GPQA Diamond 83.8,单张 GB300 上 Agent 场景生成速度 680 tokens/s。权重 Apache 2.0,已上 Hugging Face、ModelScope 和 GitHub,支持 SGLang 与 llama.cpp。

港大 Dream 团队创立的 DiffuSpace 开源 Clover-35B-A3B 扩散语言模型:单卡 680 tokens/s,SWE-bench Verified 73.6

核心要点速览

  • 35B 总参、约 3B 激活的 MoE 扩散模型,由 Qwen3.6-35B-A3B 初始化,128K 上下文,支持思考模式
  • 官方称六项 Agent 评测全部第一:SWE-bench Verified 73.6、Terminal-Bench 2.1 51.7、τ³ Overall 65.3,超过 LLaDA2.2 flash、Mercury 2.5 和 Qwen3.6-35B-A3B
  • 速度(官方口径):单张 GB300、BF16、batch=1 下 Agent 场景 680 tokens/s;单张 H200 上 515 tokens/s,高于 DFlash2 加速 Qwen 的 365 tokens/s
  • INT4 量化后可在 16GB 显存的 RTX 5070 Ti 上运行,MATH-500 生成速度 101.8 tokens/s
  • Hugging Face 权重 Apache 2.0,BF16 约 69GB,官方推荐用 SGLang 部署
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Clover-35B-A3B-Preview⚡ Qwen3.6-35B-A3B⚡ Dream 7B⚡ LLaDA2.2 flash⚡ Mercury 2.5🌐 DiffuSpace🌐 HKU NLP🌐 Alibaba Qwen🌐 NVIDIA

Cloudflare 披露 Workers AI 上 GLM-5.3 跨请求泄露事故:KV 缓存配置不匹配叠加 SGLang 漏洞,13 天内 155 条回复混入其他用户数据

Cloudflare 10 月 26 日在官方博客发布事故报告:8 月 27 日至 9 月 9 日,Workers AI 上的 GLM-5.3(@cf/zai-org/glm-5.3)对超过 681,280 token 的长提示,有 155 条回复混入了其他用户刚发过的请求内容,且都返回 HTTP 200。原因是 prefill 节点 KV 缓存池小于 1,048,576 token 的上下文窗口,叠加 SGLang 在 prefill/decode 分离模式下处理超长请求的漏洞。Cloudflare 称未发现恶意利用,已修复并建议运营方升级到 SGLang v0.5.22 或更高版本。

Cloudflare 披露 Workers AI 上 GLM-5.3 跨请求泄露事故:KV 缓存配置不匹配叠加 SGLang 漏洞,13 天内 155 条回复混入其他用户数据

核心要点速览

  • 影响范围:2026-08-27 至 09-09 共 155 条回复受影响,均为超过 681,280 token 的提示;Cloudflare 确认 Workers AI 其他模型未受影响
  • 根因 1:GLM-5.3 上下文 1,048,576 token,但 prefill KV 池只有 681,280 token;修复后池容量约 204 万 token,约为上下文的 2 倍
  • 根因 2:SGLang 把超长请求标记为拒绝并换成 1 token 占位,却没中止,decode 节点读到了未被覆盖的旧缓存页
  • 响应:9 月 8 日经 HackerOne 收到 Knostic 的 Gadi Evron 报告,9 月 9 日宣布事故后 40 分钟内下线模型,当天 19:40 UTC 恢复
  • 行动建议:自建 SGLang 的团队升级到 v0.5.22 或更高版本,并直接核对 KV 池大小与上下文长度
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Z.ai GLM 5.3🌐 cloudflare🌐 zai
AD赞助内容

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

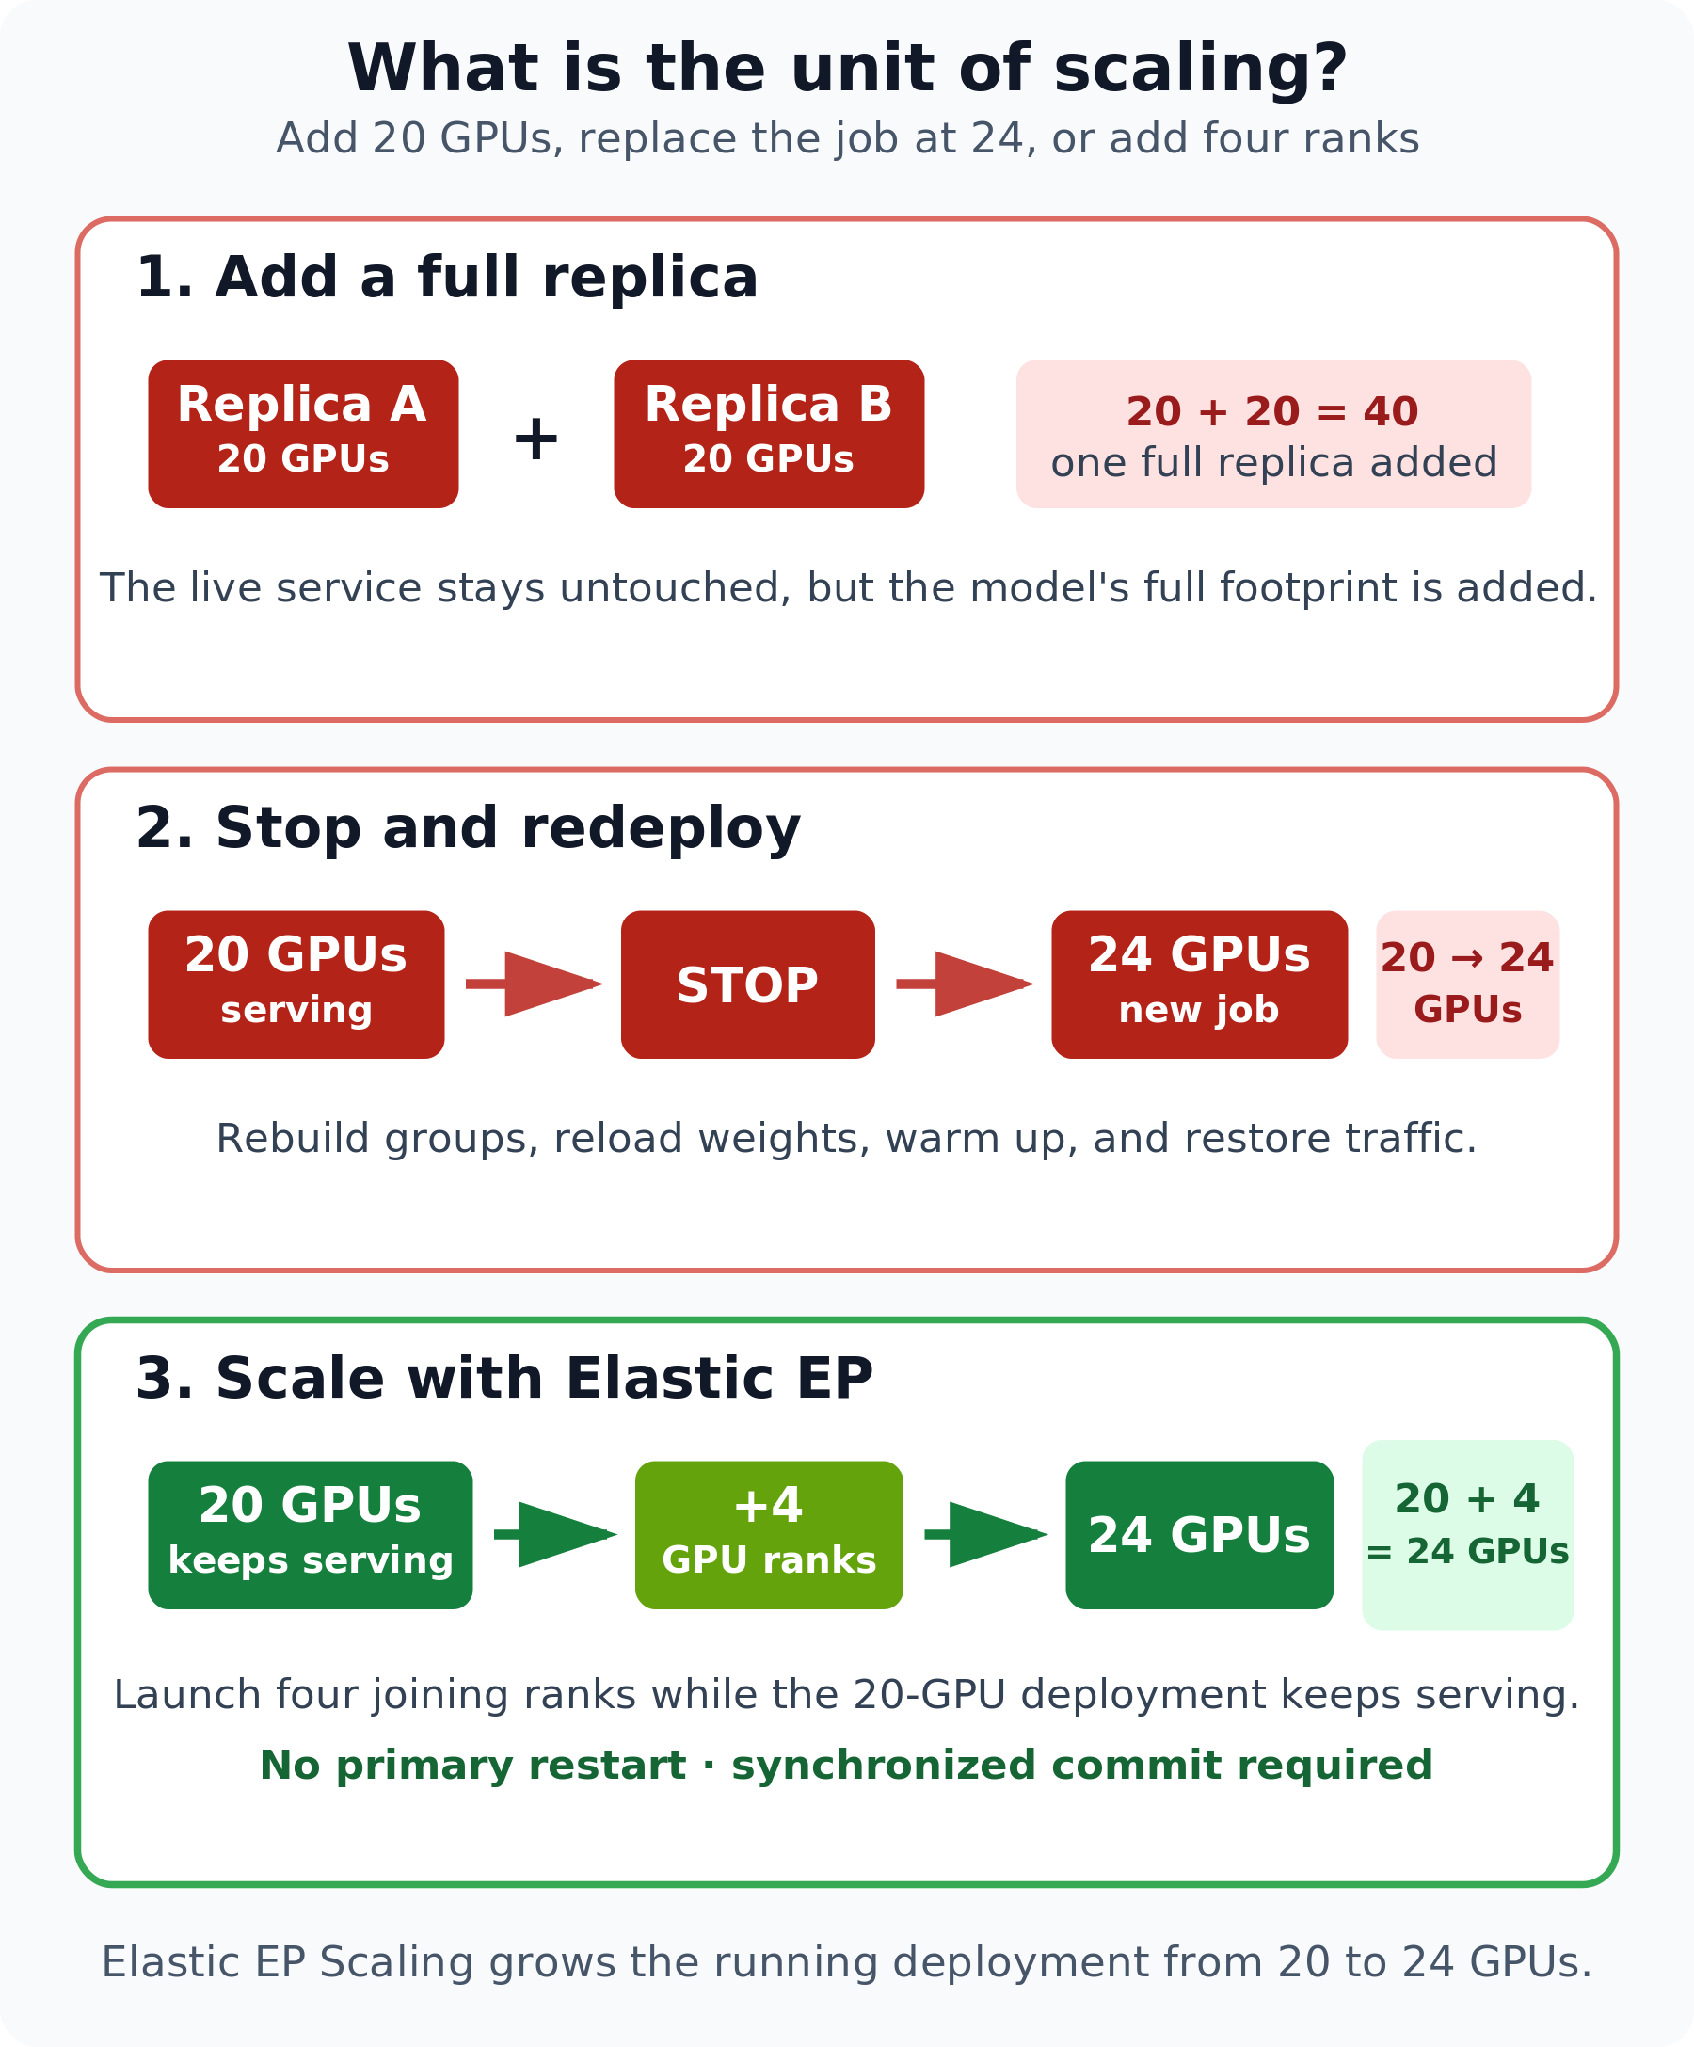
LMSYS 团队联合 NVIDIA Dynamo 团队在官方技术博客与 X(@lmsysorg)正式宣布,高性能大模型推理框架 SGLang 推出弹性专家并行(Elastic EP)与 NIXL(Near-Instant Cross-Node Link)动态伸缩后端。针对超大 MoE 架构(如 DeepSeek-V3/V4)在传统静态专家并行下因单卡硬件故障导致全集群崩溃重启、以及业务高峰期无法在线扩容的严重痛点,Elastic EP 实现了专家-GPU 映射解耦。依托 NVIDIA NIXL 高性能通信原语与 Mooncake 调度器,SGLang 首次实现在完全不中断在线推理请求的前提下,将运行中的 MoE 集群动态扩容(如从 20 卡无感扩展至 24 卡),并支持单节点故障的秒级自动降级容错。

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

核心要点速览

  • LMSYS 与 NVIDIA Dynamo 团队联手发布 SGLang Elastic EP,正式支持 MoE 模型在线动态扩缩容
  • 彻底破解静态专家并行(Static EP)在单节点硬件故障时全集群宕机的致命痛点,支持秒级自动容错降级
  • 集成 NVIDIA NIXL 高性能跨节点通信原语(--moe-a2a-backend nixl),支持 RDMA 与 NVLink 原生零拷贝调度
  • 实现零停机在线扩容(Live Scale-Up),集群可在持续处理生产推理请求的同时从 20 卡在线平滑扩容至 24 卡
阅读全文

Google Cloud 开源 TorchTPU:PyTorch 原生直通谷歌 TPU 芯片,vLLM 与 SGLang 宣布首发适配

Google Cloud 官方正式宣布开源 TorchTPU 核心加速框架,首次实现 PyTorch 框架原生、无编译壁垒地直接运行在 Google TPU(TPU v5p 与最新 TPU v6e)芯片之上。传统基于 PyTorch/XLA 的方案因复杂的计算图编译开销和动态形状限制,严重制约了 PyTorch 开发者在 TPU 上的创新步伐。TorchTPU 彻底打通了原生 PyTorch Eager 模式与自定义 Triton/C++ 硬件内核;主流高性能大模型推理引擎 vLLM 与 SGLang 同步官宣提供首发适配。同时,Google Cloud 宣布在其 Model Garden 引入 OpenAI 旗舰模型与 Codex,成为首个集齐全部三大顶级闭源模型的超算云平台。

Google Cloud 开源 TorchTPU:PyTorch 原生直通谷歌 TPU 芯片,vLLM 与 SGLang 宣布首发适配

核心要点速览

  • Google Cloud 官方开源 TorchTPU,支持 PyTorch 原生、免转译直接运行在 TPU v5p 与 TPU v6e 芯片
  • 彻底消除 PyTorch/XLA 传统图编译开销,原生支持 PyTorch Eager 动态模式与自定义 Triton/C++ 算子加速
  • vLLM 与 SGLang 同步发布专为 TorchTPU 深度优化的官方版本,实现高并发大模型推理吞吐量翻倍
  • OpenAI 旗舰模型与 Codex 正式登陆 Google Cloud Model Garden,打造最全面的跨厂商大模型生态
阅读全文

Eagle 发布 EAGLE-4 推测解码草稿模型:一个 drafter 按批量与硬件自适应,官方称 Qwen3.8-27B 单请求 961.6 tok/s

10 月 20 日,推理加速公司 Eagle 发布 EAGLE-4,这是 EAGLE 推测解码系列的第四代。它用一个草稿模型按批量、硬件和负载动态调整推测树,同时保持目标模型输出分布不变。官方口径下,Qwen3.8-27B 在 4 张 B300 上单请求达 961.6 tokens/s。代码以 eagle-harness v0.1.0 发布,支持 SGLang、vLLM 和实验性的 TokenSpeed。注意:多数转发称其“开源”,但官方许可证是源码可用(source-available)许可,并非 OSI 开源。

Eagle 发布 EAGLE-4 推测解码草稿模型:一个 drafter 按批量与硬件自适应,官方称 Qwen3.8-27B 单请求 961.6 tok/s

核心要点速览

  • 官方/厂商口径:Qwen3.8-27B + TokenSpeed,BF16、4× B300、TP4、单请求、T=0 下达 961.6 tokens/s(论文图 1(a))
  • 仓库实测表:vLLM 4× B300 单并发 241.6→722.8 tok/s(2.99×),并发 8 为 1.70×;SGLang 并发 8 为 1.91×、并发 64 降到 1.35×
  • AMD 也有数:SGLang 单卡 MI355X 并发 8 为 2.07×、并发 32 为 1.56×(ROCm 7.2)
  • 架构:滑动窗口草稿层 + 低秩候选头 + 只追加草稿缓存;harness 先离线标定验证延迟,再按“收益/成本”决定树的宽深
  • 许可:Eagle 4 Source-Available License,非商用免费;商用仅限 12 个月总营收不超过 2000 万美元且不构成竞品,超出需另签授权
阅读全文
关联模型 / 智能体 / 厂商:

Google 联合 Meta 开源 TorchTPU:PyTorch 原生跑在 TPU 上,把 .to("cuda") 改成 .to("tpu") 即可迁移,vLLM、SGLang 同步上 TPU 原生后端

10 月 20 日 PyTorch Conference 2026 上,Google 宣布与 Meta PyTorch 团队共同开发的 TorchTPU 在 GitHub 开源,让 TPU 和 GPU、CPU 一样成为 PyTorch 原生设备:支持 eager 模式和 torch.compile、约 450 个 ATen 算子、torch.distributed 集合通信。同时开源 vLLM-TorchTPU、SGLang-TorchTPU 推理引擎,打通 TorchTitan、Ray、VeRL、Hugging Face Transformers v5(device_map="tpu"),并预览面向 Claude Code、Antigravity 等编码助手的 TPU agent suite。前一天 AWS 刚发布同类的 TorchNeuron。

Google 联合 Meta 开源 TorchTPU:PyTorch 原生跑在 TPU 上,把 .to("cuda") 改成 .to("tpu") 即可迁移,vLLM、SGLang 同步上 TPU 原生后端

核心要点速览

  • 迁移门槛(PyTorch 官方博客):现有代码把 model.to("cuda") 改成 model.to("tpu")、分布式后端换成 tpu_dist 即可跑起来;官方也说明想拿到峰值性能仍需按 TPU 调整形状和切分
  • 覆盖面(官方口径):约 4,917 个热门 Hugging Face 模型中 98%(4,821 个)可在 TPU 上无报错运行,657 个架构代表模型里 97%(638 个)与 GPU 数值一致
  • 训练扩展(官方口径):TorchTitan 上 Qwen3 MoE 235B 从 1,024 扩到 8,192 颗 TPU v7,MFU 基本稳定在 27%–29%;64 颗 TPU v7 上吞吐 1,828 TPS,接近 JAX/MaxText 的 1,937 TPS
  • 推理成本(官方转引 SemiAnalysis InferenceX):TPU v7 加 vLLM-TorchTPU 在 8K/1K 场景每百万 token 2.01 美分,9 月首测时为 3.6 美分
  • 同步开源 4 个仓库:torch_tpu、vllm-torchtpu、sglang-torchtpu、TorchTitan TPU 版;TPU agent suite 以预览形式上线,支持 TPU v6e 与 TPU7x
阅读全文

Ornith-1.5-122B 开源重磅登场:单机 DGX 即可部署的 122B MoE 推理模型,SWE-bench Pro 斩获 76.9 分

开源 AI 实验室 Ornith 团队正式发布 Ornith-1.5-122B 混合专家推理模型,并在 MIT 宽松协议下完全开源。该模型专门面向单节点 GPU 服务器(如单台 DGX)设计,提供包括 FP8、GGUF 与 MLX 在内的全套量化版本,已同步上架 Ollama(ornith-1.5:122b)与 vLLM/SGLang 运行时。在权威基准评测中,Ornith-1.5-122B 展现出媲美超大规模闭源模型的编程与智能体能力:在 OpenHands 评测框架下,SWE-bench Verified 达到 84.5 分,SWE-bench Pro 斩获 76.9 分(相较 Qwen3.8-Flash-Next 的 43.9 分取得跨越式领先),TerminalBench 达 81.2 分,MCP-Atlas 达到 74.6 分。

Ornith-1.5-122B 开源重磅登场:单机 DGX 即可部署的 122B MoE 推理模型,SWE-bench Pro 斩获 76.9 分

核心要点速览

  • Ornith-1.5-122B 正式发布并遵循极为宽松的 MIT 许可证,打破大参数量高性能编程推理模型闭源垄断
  • 专为单台 DGX 等单节点多卡服务器量身定制,已无缝接入 vLLM、SGLang 与 Ollama(ornith-1.5:122b),提供完整 FP8/GGUF/MLX 支持
  • 在真实软件工程评测集 SWE-bench Pro 斩获 76.9 分,相比同体量开源标杆 Qwen3.8-Flash-Next(43.9 分)大幅提升 33 分
  • 全方位通过 TerminalBench 2.1(81.2 分)、CyberGym(80.0 分)与 MCP-Atlas(74.6 分)测试,树立端到端 Coding Agent 开源新旗舰
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ornith-1.5-122B⚡ Qwen3.8-Flash-Next🤖 OpenHands🌐 Ornith

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

DeepSeek 官方正式开源其生产级高性能推理引擎 DeepInfer(基于 Apache 2.0 协议发布)。DeepInfer 汲取了 vLLM、SGLang 与 TensorRT-LLM 架构精华,专为大规模部署 DeepSeek-V4.1-Flash 设计。引擎支持 NVIDIA SM100 架构与华为昇腾 Ascend 950 NPU,原生集成 FlashMLA、DeepGEMM、DeepEP 与 TileKernels。引入 DSpark 置信度投机采样(默认 5 个 Draft Token)、SWA 有界重放(140 Token 窗口)与 MoE 专家并行动态负载均衡。同时开源生产级分词与编解码组件 deepseek-recipe,构建从模型、算子到推理服务的全栈开源生态。

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

核心要点速览

  • DeepSeek 官方正式开源 DeepInfer 推理引擎(Apache 2.0),完整公开支撑 DeepSeek-V4.1-Flash 线上高吞吐与低延迟调度的底层代码
  • 跨异构硬件深度调优,同时全面适配 NVIDIA SM100 GPU 与华为昇腾 Ascend 950 NPU,提供硬件级确定性输出保证
  • 深度融合 FlashMLA、DeepGEMM、DeepEP 与 TileKernels 原生算子,并搭载基于 DSpark 的 5-Token 置信度投机解码与 140-Token 滑动窗口重放
  • 同步开源生产级 token 编解码套件 deepseek-recipe,彻底消除开源社区本地部署与官方 API 之间的对齐鸿沟
阅读全文
AD赞助内容

llm-d 1.0 发布:Red Hat、IBM、Google 主导的 Kubernetes 原生开源分布式推理栈进入生产可用,按厂商口径自托管 3,000 个编码 Agent 比商用 API 便宜 5–10 倍

10 月 20 日 PyTorch Conference 北美站上,CNCF 沙箱项目 llm-d 发布 1.0。它把 vLLM、SGLang 等推理引擎组织成一个统一的服务池,1.0 新增多租户优先级与公平调度(flow control)、路由高可用与零停机滚动升级(DisaggregatedSet)、v1 配置 API,以及面向 Agent 的会话感知路由和 Responses API 状态支持。项目由 Red Hat、IBM、Google Cloud、CoreWeave、NVIDIA 于 2025 年创立,现有 500 多名贡献者;JetBrains、DigitalOcean、Mistral 等已在生产中使用。

llm-d 1.0 发布:Red Hat、IBM、Google 主导的 Kubernetes 原生开源分布式推理栈进入生产可用,按厂商口径自托管 3,000 个编码 Agent 比商用 API 便宜 5–10 倍

核心要点速览

  • 规模(Red Hat 新闻稿,厂商口径):在 NVIDIA GPU 上部署约 7,530 亿参数的 GLM 5.2,峰值每分钟输出 660 万 token,同时服务最多 3,000 个编码 Agent 且零抢占,按云租用价算每 token 成本比同等商用 API 低 5–10 倍
  • 缓存复用:IBM 称在 Agent 编码负载中前缀感知路由拿到了 97% 的可复用缓存;IBM Research 量子纠错芯片项目前缀命中约 98%、综合成本约每百万 token 0.11 美元,比全闭源方案低 11.5 倍
  • Google Cloud 口径:Ironwood TPU 上的 Agent 编码负载,前缀感知路由加主机内存卸载让首 token 延迟中位数下降超 85%、吞吐提升 2.4 倍;Gemini 平台前缀缓存命中率从 35% 提到 70%
  • 1.0 新能力:flow control 多租户 QoS、路由热备高可用、DisaggregatedSet 统一管理 prefill/decode 滚动升级、v1 配置 API、Responses API 支持 previous_response_id
  • 生态:500+ 贡献者、25+ 家机构;JetBrains 的免费 Junie Lite、DigitalOcean Serverless Inference、Mistral 商用分级流量已在生产中使用;GitHub v1.0.0 发布说明坦言部分既定目标未完成
阅读全文

蚂蚁 inclusionAI 开源 5 款 Ming-3.0 语音模型:0.5B TTS 拿下开源权重音色控制第一,126B MoE 音频理解模型同步发布

蚂蚁 Ant Ling(inclusionAI)10 月 19 日以 MIT 协议开源 Ming-3.0 的 5 个模型,覆盖语音合成(tts-0.5B、tts-tiny 7.9B/1.3B 激活)、音频理解(audio-flash 126B/6.5B 激活、audio-tiny 9.3B/2.7B 激活)和语音识别(asr-tiny 8.6B/2B 激活)。官方称 tts-0.5B 在 Artificial Analysis Controlled Voice 榜以 1069 Elo 位列开源权重第一,发音稳健性 93.2% 并列全榜第一;asr-tiny 四类 ASR 平均错误率 4.41%。权重已上 Hugging Face 和 ModelScope,SGLang 与 vLLM 首日支持。

蚂蚁 inclusionAI 开源 5 款 Ming-3.0 语音模型:0.5B TTS 拿下开源权重音色控制第一,126B MoE 音频理解模型同步发布

核心要点速览

  • 阵容:3 个系列 5 个模型,TTS 2 个、音频理解 2 个、ASR 1 个,全部 MIT 协议。
  • TTS 成绩:tts-0.5B 在 AA Controlled Voice 获 1069 Elo,开源权重第一;Provider Voice 1188 Elo 排第 3;发音稳健性 93.2% 并列全榜第一(官方口径)。
  • TTS 能力:支持 7 种语言加四川话、粤语,14 种行内副语言标签(笑声、叹气、咳嗽等),44.1 kHz 输出,基于 Qwen2.5-0.5B。
  • 音频理解:audio-flash 总参 126B、每步激活 6.5B,可做长录音总结、语音问答、音频推理并生成工具调用请求。
  • ASR:asr-tiny 支持热词和对话上下文,在 15 个方言测试集上评测,四类任务平均错误率 4.41%(官方口径)。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ming-3.0-tts-0.5B⚡ Ming-3.0-tts-tiny⚡ Ming-3.0-audio-flash⚡ Ming-3.0-audio-tiny⚡ Ming-3.0-asr-tiny🌐 Ant Group🌐 inclusionAI🌐 SGLang🌐 vLLM

SGLang v0.5.22 重磅发布:DeepSeek-V4.1 在 H200 吞吐提升 2.3 倍、MI355X 提速 1.9 倍,InstantTensor 载入提速 10 倍

SGLang 团队正式发布 v0.5.22 大版本更新(凝聚 245 位贡献者提交的 950 个 PR):深度优化 DeepSeek-V4.1 推理性能,在 H200 单卡吞吐狂飙 2.3 倍,并通过 DSpark 首次在 AMD MI350X/MI355X 实现 1.9 倍吞吐提升;首创 InstantTensor 加载器将大模型冷启动显存载入提速 10 倍;B200 上 Qwen3.8-Flash-Next 解码提速 12%、B300 上 GLM-5.3-Flash 提速 10% 且 MiMo-V2.6-Pro 解码吞吐达 1.85 倍;并原生支持苹果 Apple Silicon 与 ComfyUI 扩散生态。

SGLang v0.5.22 重磅发布:DeepSeek-V4.1 在 H200 吞吐提升 2.3 倍、MI355X 提速 1.9 倍,InstantTensor 载入提速 10 倍

核心要点速览

  • SGLang v0.5.22 正式发布,汇聚 245 位贡献者的 950 个 PR
  • DeepSeek-V4.1 在 NVIDIA H200 单卡吞吐暴涨 2.3 倍,并通过 DSpark 首次在 AMD MI350X/MI355X 实现 1.9 倍吞吐提升
  • 全新 InstantTensor 加载器将千亿模型冷启动载入速度提升 10 倍(10x faster)
  • B200 上 Qwen3.8-Flash-Next 解码提速 12%,B300 上 GLM-5.3 提速 10% 且 MiMo-V2.6-Pro 解码达 1.85 倍
  • PD 分离架构使长 Prompt 首字延迟 p95 TTFT 减半(-50%),吞吐净增 27%,原生支持 Apple Silicon 与 ComfyUI
阅读全文
关联模型 / 智能体 / 厂商:

OpenBMB 开源 MiniCPM-V 4.7:35B-A3B 首个 MoE 端侧多模态模型,iPhone 17 Pro Max 实测 13+ token/s

2026-10-12 OpenBMB(面壁智能)发布 MiniCPM-V 4.7 开源多模态系列,含 35B-A3B(系列首个 MoE)与 1B 两款,Apache-2.0。配套的 Lookahead Expert Scheduling(LES)跨层预取专家,叠加分层混合精度量化与 DSpark 投机采样,官方在 iPad Pro M4(16GB)上把专家从 SSD 加载的解码速度从 2.97 提到 17.39 token/s(5.86 倍)。权重已上架 Hugging Face / ModelScope / Ollama,支持 vLLM、SGLang、llama.cpp 与 iOS / Android / 鸿蒙端侧部署。

OpenBMB 开源 MiniCPM-V 4.7:35B-A3B 首个 MoE 端侧多模态模型,iPhone 17 Pro Max 实测 13+ token/s

核心要点速览

  • 两款开源权重(Apache-2.0):35B-A3B(系列首个 MoE,语言底座 Qwen3.6)与 1B,另附 FP8 / AWQ / GPTQ / int4 / GGUF 与 DSpark 草稿模型(Hugging Face)
  • LES 端侧解码(官方口径,iPad Pro M4 16GB):基线 2.97 → LES 9.81 → +分层量化 14.92 → +DSpark 17.39 token/s,累计 5.86×(LES 文档)
  • iPhone 17 Pro Max 上 35B-A3B 达 13+ token/s;视觉 token 支持 4x / 16x 混合压缩,按任务切换细节与成本
  • 厂商评测(Instruct,4x):MMBench 91.72、OCRBench 91.20、OmniDocBench v1.6 94.24、MMMU 80.22,对比 Qwen3.6-35B-A3B 分别为 86.76 / 86.00 / 80.17 / 77.44;SimpleVQA、ScreenSpot 等项仍落后
  • Day-0 芯片支持 Rockchip、后摩、Intel、AMD、Arm;推理框架覆盖 vLLM、SGLang、llama.cpp、Ollama,微调支持 SWIFT / LLaMA-Factory
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniCPM-V 4.7 35B-A3B⚡ MiniCPM-V 4.7 1B⚡ Qwen3.6-35B-A3B🌐 OpenBMB🌐 面壁智能

IQuest-Q1 开源 320B MoE 编程 Agent 模型:15B 激活 / 524K 上下文,DeepSWE 64.6、Terminal-Bench 2.1 达 83.2

IQuest Research 的 IQuest-Q1(约 320B 总参 / 15B 激活、524K 上下文)面向仓库级编码、终端与长程工具调用;权重与部署镜像已在 Hugging Face / GitHub。官方同管线自评:DeepSWE v1.1 64.6、NL2Repo 63.0、CyberGym 84.5、Terminal-Bench 2.1 83.2;支持 SGLang/vLLM 与 Claude Code / Codex 接入。

IQuest-Q1 开源 320B MoE 编程 Agent 模型:15B 激活 / 524K 上下文,DeepSWE 64.6、Terminal-Bench 2.1 达 83.2

核心要点速览

  • 规格:~320B MoE / ~15B 激活、88 层、256 专家激活 8、524,288 上下文;混合注意力 3×SWA+1×FA(HF 模型卡)
  • Agent 编码自评:DeepSWE v1.1 64.6(DeepSeek-V4.1-Flash 74.2 / Opus 5 73.7);NL2Repo 63.0(Opus 5 75.3)
  • 终端与安全:Terminal-Bench 2.1 83.2;CyberGym 84.5(与 GLM-5.3 并列,Flash 88.1)
  • 后训练:SFT+RL,并强调 Multi-Teacher On-Policy Distillation(MOPD);官方声明仍属早期、文本-only
  • 落地:hf download IQuestLab/IQuest-Q1 + Docker 镜像 sglang-iquest-q1 / vllm-iquest-q1(tp=8);可接 Claude Code 2.1.140 / Codex 0.142
阅读全文