AI 编程实时动态与要闻

LG AI Research 免费开放 K-EXAONE 2.5 API:750B 总参数、31B 激活、512K 上下文,官方口径 SWE-Bench Pro 59.2 略高于 DeepSeek-V4.1-Flash

11 月 9 日,LG AI Research 在首尔 NVIDIA AI Day 上宣布,通过 EXAONE API 平台(docs.exaone.ai)免费开放 K-EXAONE 2.5 API,开发者、初创公司、企业和研究机构领取 API Key 即可用于服务开发与研究。K-EXAONE 2.5 是在 8 月发布的 K-EXAONE 2.0 基础上加训的技术验证模型:750B 总参数、31B 激活,纯文本,支持韩语和英语,上下文 512K,接口兼容 OpenAI。LG 自测四项 Agent 基准:SWE-Bench Pro 59.2、BrowseComp 78.0、AutomationBench 74.6、Claw-Eval 77.3,整体与 DeepSeek-V4.1-Flash、GLM-5.3 相当,但没有一项全面领先。NVIDIA 表示该模型训练用到了 Nemotron 数据集。官方未公布免费期限和额度,也未开放 2.5 权重。

LG AI Research 免费开放 K-EXAONE 2.5 API:750B 总参数、31B 激活、512K 上下文,官方口径 SWE-Bench Pro 59.2 略高于 DeepSeek-V4.1-Flash

核心要点速览

  • 免费开放:EXAONE API 平台 11 月 9 日上线,目前免费,领 API Key 即可调用;同批上线的还有 21M 参数的表格预测模型 EXAONE Tabular
  • 规格:750B 总参数 / 31B 激活,纯文本,韩语 + 英语,上下文与最大输出均为 512K,知识截止 2026 年 1 月;支持工具调用、结构化输出、代码生成和流式输出
  • 接口:OpenAI 兼容的 POST /v1/chat/completions,模型名 k-exaone_v2.5;推理无法关闭,reasoning_effort 可选 low / high / max,默认 max,推理 token 也计入 max_tokens
  • LG 自测(vs DeepSeek-V4.1-Flash / GLM-5.3):SWE-Bench Pro 59.21 vs 58.41 / 64.03;BrowseComp 78 vs 75.8 / 79;AutomationBench 74.6 vs 74.9 / 71.6;Claw-Eval 77.29 vs 75.78 / 77.64
  • 相比 K-EXAONE 2.0:AutomationBench 从 16.9 升到 74.6,SWE-Bench Pro 从 47.1 升到 59.21;以上均为厂商内部评测,未经独立复现,免费期限、额度和权重开放情况官方均未说明
阅读全文
关联模型 / 智能体 / 厂商:

腾讯开源 DSpine:Qwen3.8-27B 专用并行草稿模型,厂商口径 SWE-bench Pro 回放吞吐约 3.19 倍、全面高于 DFlash2

腾讯于 2026-11-07 14:20 UTC 在 Hugging Face 发布 tencent/Qwen3.8-27B-DSpine-b16:一个约 2B 参数、5 层的投机解码草稿模型,块大小 16、8,192 Token 滑动窗口,Apache 2.0 许可,配套代码在 GitHub Tencent/DSpine,论文为 arXiv 2609.36173。模型卡(厂商口径)显示,在 SGLang 0.5.22、BF16、并发 8 的条件下,SWE-bench Pro 回放在 xhigh 推理下输出吞吐从约 248 提升到约 791 tokens/s(约 3.19 倍),官方 DFlash2 为 2.87 倍;10 组 Agent 场景接受长度全部高于 DFlash2。注意 DSpine 每块草拟 16 个 Token,DFlash2 为 8 个,配置并不完全相同,结果尚无第三方复现。

腾讯开源 DSpine:Qwen3.8-27B 专用并行草稿模型,厂商口径 SWE-bench Pro 回放吞吐约 3.19 倍、全面高于 DFlash2

核心要点速览

  • 发布:腾讯 2026-11-07 14:20 UTC 上传 tencent/Qwen3.8-27B-DSpine-b16,约 20.3 亿参数(BF16 约 4GB),5 层、块大小 16、8,192 Token 滑动窗口,Apache 2.0
  • 吞吐(厂商口径):SWE-bench Pro 回放 xhigh 推理从约 248 到约 791 tokens/s,约 3.19 倍;DFlash2 为 2.87 倍
  • 最高加速(厂商口径):WorkBuddy Office 在 low 推理下约 3.84 倍(DFlash2 为 3.17 倍)
  • 接受长度(厂商口径):SWE-bench Pro xhigh 为 4.77 对 DFlash2 的 4.00;GSM8K 贪心解码 7.20 对 5.69
  • 注意:DSpine 草拟块 16、DFlash2 为 8,测试条件不完全对等;目前只有模型卡数据,尚无第三方复现
阅读全文

微软 Foundry Local 接 GitHub Copilot:本地跑 Qwen3.8-27B 做编码 Agent,约 24GB 显存即可,厂商口径 Terminal-Bench 2.1 约 73.0

微软 Foundry 团队于 2026-11-05 发博:Foundry Local CLI ≥0.13.0 可用 ONNX Runtime 在本机跑 4bit Qwen3.8-27B(权重约 18GB),经 Bring Your Own Key 接到 GitHub Copilot。需 NVIDIA ≥24GB 显存(24GB 时上下文约 64K;≥32GB 可达模型上限 262K)。官方引用模型卡口径 Terminal-Bench 2.1 73.0、SWE-bench Pro 61.7;并称在 RTX 5090 / DGX Spark 上生成速度优于同量化的 llama.cpp。Mac/AMD 尚在路线图。

微软 Foundry Local 接 GitHub Copilot:本地跑 Qwen3.8-27B 做编码 Agent,约 24GB 显存即可,厂商口径 Terminal-Bench 2.1 约 73.0

核心要点速览

  • 形态:Foundry Local ≥0.13.0 + 4bit Qwen3.8-27B(约 18GB 权重),经 BYOK 接 GitHub Copilot App
  • 硬件:NVIDIA ≥24GB 显存;24GB→约 64K 上下文,≥32GB→可达 262K;需自装 CUDA/cuDNN
  • 官方引用跑分(模型卡口径,非 4bit 复测):Terminal-Bench 2.1 73.0、SWE-bench Pro 61.7、NL2Repo-Bench 42.3、DeepSWE 1.1 42.2
  • 推理栈:ONNX Runtime + DFlash2 推测解码 + INT4/KV 量化 + 前缀缓存;厂商称长上下文相对 llama.cpp 优势更大
  • 边界:微软承认复杂推理仍宜云端;Mac/AMD 未上线;Copilot CLI 本地模型≠自动离线,需另开 COPILOT_OFFLINE
阅读全文

Ricursive 开源 Ripple-65B Preview:从零预训练的 65B 稠密模型,TerminalBench 2.1 80.5,Apache 2.0

Ricursive Intelligence 于 11 月 4 日(UTC 18:24)发布首个模型 Ripple-65B Preview,并在 Hugging Face 以 Apache 2.0 开源指令版(BF16、NVFP4)和基座版。官方模型卡显示:65B 稠密 Transformer、12T token 预训练、最长 1M 上下文,自报 TerminalBench 2.1 80.5、SWE-bench Pro v2.0 Hard 79.1、DeepSWE 1.1 44.3,在编码 Agent 任务上超过参数大得多的美国开源模型;可在 DGX Spark 等本地硬件运行。CEO Anna Goldie 称成本约为此前同类 SOTA 的十分之一。

Ricursive 开源 Ripple-65B Preview:从零预训练的 65B 稠密模型,TerminalBench 2.1 80.5,Apache 2.0

核心要点速览

  • Ripple-65B Preview 为 65B 稠密模型,80 层、d_model 5120 的“窄而深”结构,从 Olmo 3 基线改为类 Gemma 3N 架构。
  • 预训练 12T token(8K 序列),后训练含中训练、长上下文、SFT 与混合领域 RL,支持最长 1M 上下文。
  • 自报 TerminalBench 2.1 80.5,高于 Reflection Beam 501B(80.1)、Muse Spark Open 816B(76.4);但 SWE-bench Verified 76.5、DeepSWE 1.1 44.3 并非全面领先。
  • 官方称核心团队从 1 人扩到 5 人,代码计算效率相对 Olmo 3 提升 16 倍;2×B200 上约 250 tok/s。
  • Hugging Face 提供 BF16、NVFP4、基座版和 DFlash2 投机解码模型,许可均为 Apache 2.0。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ripple-65B Preview⚡ Reflection Beam 501B⚡ Muse Spark Open⚡ Nemotron 3 Ultra🌐 Ricursive Intelligence🌐 NVIDIA
AD赞助内容

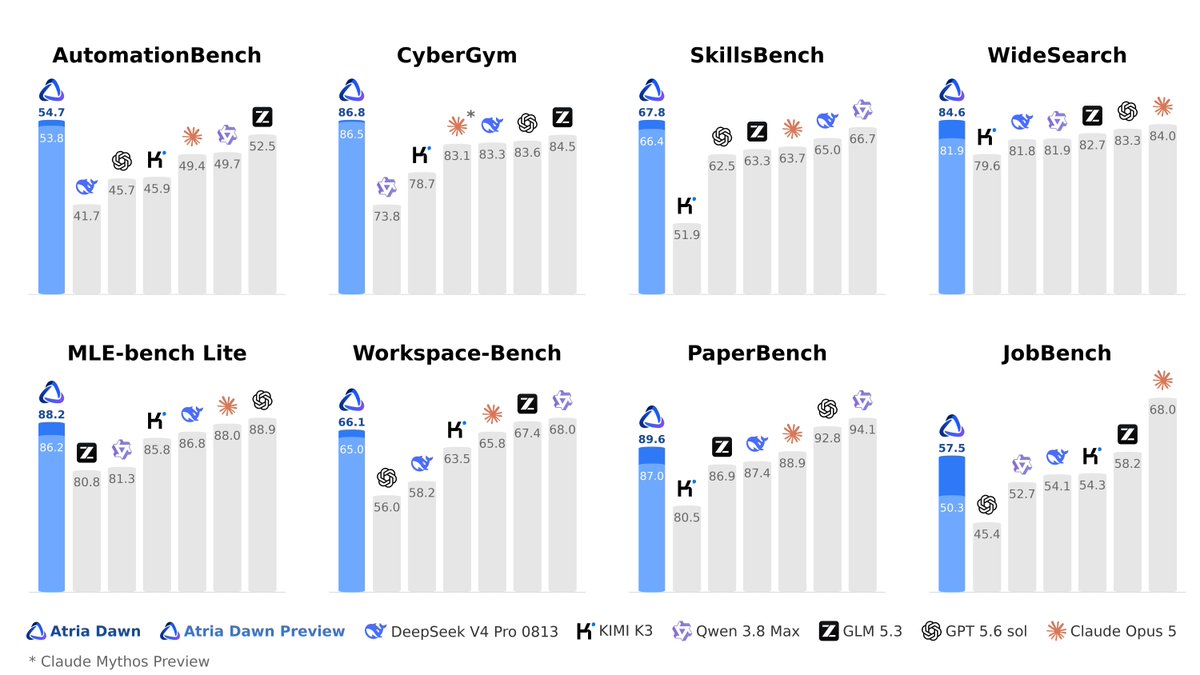
上海 AI 实验室发布 Atria Dawn 正式版:基于 744B MoE GLM-5.2 的智能体模型,上下文翻倍至 512K,MIT 开源

上海人工智能实验室把 Atria Dawn 从 Preview 升级为正式版,Hugging Face(internlm/Atria-Dawn 及 FP8 版)与 ModelScope 均已上线开放权重,MIT 许可。模型基于 744B 参数 MoE 的 GLM-5.2,面向科研与工程类长程智能体任务,上下文从 Preview 的 256K 翻倍到 512K,仅接受文本输入。官方表格显示其在 AutomationBench、CyberGym、SkillsBench 等智能体基准上领先所列模型,但在 SWE-bench Pro、Terminal-Bench 2.1 等编码基准上仍落后 Claude Opus 5(均为厂商口径)。

上海 AI 实验室发布 Atria Dawn 正式版:基于 744B MoE GLM-5.2 的智能体模型,上下文翻倍至 512K,MIT 开源

核心要点速览

  • 上下文 512K,是 Preview 版 256K 的两倍;基座为 744B 参数 MoE 的 GLM-5.2,仅支持文本输入
  • Hugging Face 与 ModelScope 提供 BF16 与 FP8 权重,MIT 许可
  • 厂商口径:AutomationBench 54.7、CyberGym 86.8、SkillsBench 67.8、BFCL V4 78.4,均为表内最高
  • 短板同样来自官方表:SWE-bench Pro 61.7 对 Claude Opus 5 的 76.5,Terminal-Bench 2.1 81.0 对 90.2
  • 本地部署需 SGLang v0.5.13.post1+ 或 vLLM v0.23.0+;也提供 OpenAI 兼容 API,可直接接入 Codex
阅读全文
关联模型 / 智能体 / 厂商:

BOSS 直聘南北阁实验室开源 Nanbeige4.3-33B:33B 稠密模型、512K 上下文、Apache 2.0,官方称 Terminal-Bench 2.1 达 80.9 超过 Qwen3.8-27B

BOSS 直聘(看准科技)旗下南北阁大模型实验室 @nanbeige 在 UTC 2026-10-25 12:11 发布 Nanbeige4.3-33B(原帖),模型和 Base 版已在 Hugging Face 以 Apache 2.0 开放权重(模型卡)。这是一个 Llama 架构的 33B 稠密模型,支持 512K 上下文,定位为 Nanbeige4.3 系列的「教师模型」,后续会蒸馏出 Nanbeige4.3-3B 等小模型。官方模型卡在同一套 harness、最高思考强度下对比 Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B:Terminal-Bench 2.1 为 80.9(Qwen3.8-27B 73.0),DeepSWE 65.5(42.5),但 SWE-Bench Pro 60.3 略低于 Qwen 的 61.7,GDPval 84.8 也低于 86.4。以上均为官方自测成绩,尚无第三方复现。

核心要点速览

  • 官方来源:@nanbeige X 原帖 与 Hugging Face 模型卡,抓取时原帖约 616 赞、79 转发、3.8 万浏览
  • 规格:33B 稠密、Llama 架构、512K 上下文、Apache 2.0,同时开放 Base 版
  • 官方自测编码:Terminal-Bench 2.1 80.9、Terminal-Bench 4.0 23.8、DeepSWE 65.5、SWE-Bench Pro 60.3(Qwen3.8-27B 分别为 73.0、6.3、42.5、61.7)
  • 官方自测协作类:Automation Bench 54.2、JobBench 44.8、GDPval 84.8(Qwen3.8-27B 为 38.3、34.5、86.4)
  • 部署:支持 Transformers、SGLang、vLLM,官方示例用 4 卡张量并行;后续将蒸馏 Nanbeige4.3-3B
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nanbeige4.3-33B⚡ Qwen3.8-27B⚡ Gemma4-31B⚡ Muse-Glimmer-30B🌐 Nanbeige🌐 BOSS Zhipin🌐 Kanzhun

Ollama 原生支持 Recursive Flint 40B:首个 2.5B 激活参数轻量 MoE 编程智能体模型,MacBook Pro 跑出 125+ tok/s

由 Richard Socher 创办的 Recursive 正式开源 39.8B(40B)混合专家(MoE)编程智能体模型 Flint(RecursiveSI/flint),采用 Apache 2.0 协议并在 Ollama(ollama run flint)与 llama.cpp 全面开箱即用。该模型每 Token 仅激活 2.5B 参数,拥有 262K 超长上下文,在 M4 Pro MacBook Pro 上可实现 125+ tokens/秒的超高速本地推理。在 SWE-bench Verified 取得 74.2%、SWE-bench Pro v2 达到 89.7%,成为 50B 以下端侧运行最强编程智能体底座。

Ollama 原生支持 Recursive Flint 40B:首个 2.5B 激活参数轻量 MoE 编程智能体模型,MacBook Pro 跑出 125+ tok/s

核心要点速览

  • Flint 采用 49 层 Transformer 架构(2 层密集层 + 47 层 MoE 层),总参数 39.8B,每 Token 激活仅 2.5B 参数
  • 原生配备 262,144 tokens(256K)超长上下文窗口,支持端到端仓库级代码理解与跨文件缺陷定位
  • 本地推理性能极佳,M4 Pro MacBook Pro 达 125+ tok/s,64GB RTX Spark 可达 150+ tok/s
  • 在 SWE-bench Verified 取得 74.2%,SWE-bench Pro v2 达 89.7%,LiveCodeBench v6 斩获 80.3%,支持 ollama run flint 一键拉取
阅读全文
关联模型 / 智能体 / 厂商:

Recursive 发布首个模型 Flint:40B 总参、2.5B 激活的开源本地编程模型,Apache 2.0,MacBook 上 125+ tok/s

10 月 21 日,Richard Socher 创办的 Recursive 发布首个模型 Flint:39.8B 总参数、每 token 约 2.5B 激活的 MoE 编程模型,权重以 Apache 2.0 发布在 Hugging Face。官方称它在 50B 以下 MoE 模型中的 SWE-Bench Pro v2、Terminal-Bench 2.1、SWE-Bench Verified 上领先,在 M4 Pro MacBook Pro 上超过 125 tok/s,并称几乎整个建模栈由其自动化研究系统 Eureka Machine 参与完成,从零到发布不到 4 个月。

Recursive 发布首个模型 Flint:40B 总参、2.5B 激活的开源本地编程模型,Apache 2.0,MacBook 上 125+ tok/s

核心要点速览

  • 规模:39.8B 总参、约 2.5B 激活(含输出头),256 路由专家选 6 + 1 共享专家,Apache 2.0(模型卡)
  • 跑分(官方口径):Terminal-Bench 2.1 54.9%、SWE-bench Verified 74.2%;模型卡写 SWE-bench Pro v2 89.7%
  • 速度(官方口径):M4 Pro MacBook Pro 125+ tok/s、64GB RTX Spark 150+ tok/s(短上下文),称为同级模型最高 2 倍
  • 上下文:模型卡配置 262,144 token;博客称最高支持 512K、建议 256K 以内
  • 生态:首日支持 llama.cpp、Ollama、LM Studio、vLLM、SGLang,另开源本地引擎 rec;可在 OpenCode 与 Pi 免费试用
阅读全文

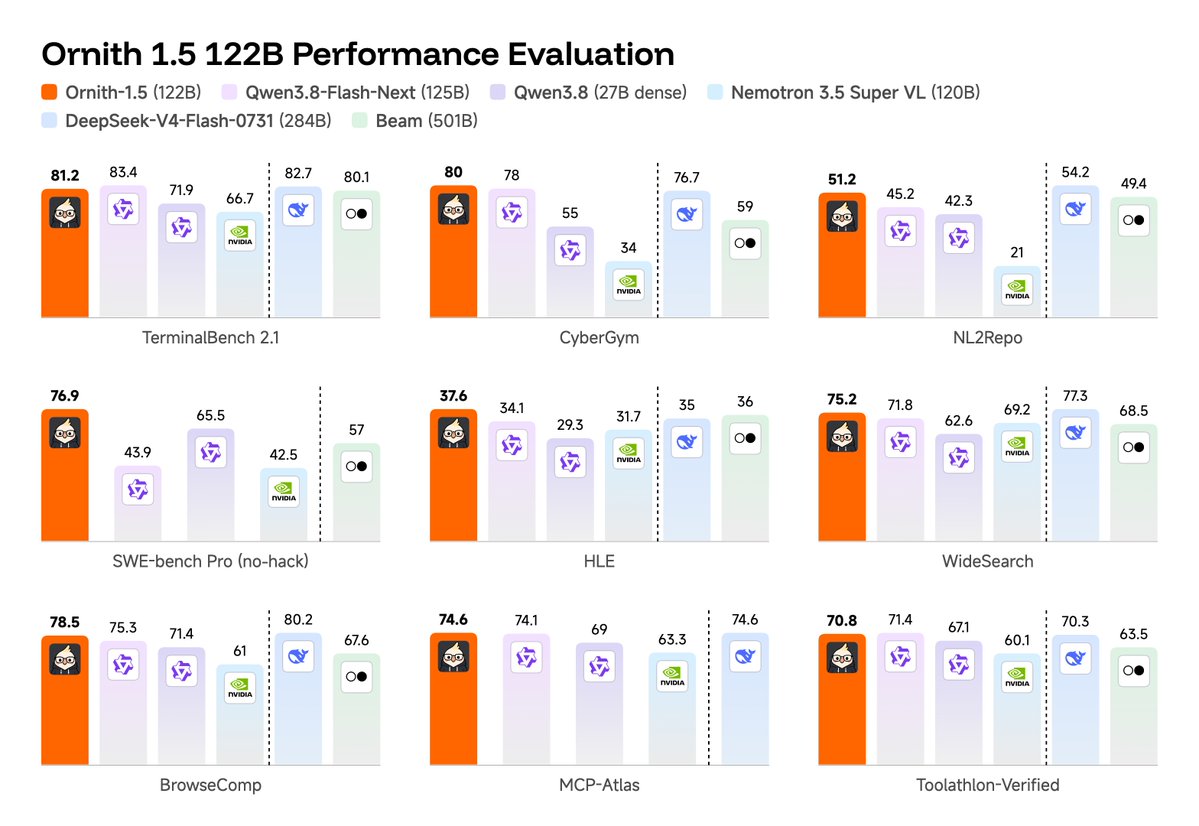
Ornith-1.5-122B 开源重磅登场:单机 DGX 即可部署的 122B MoE 推理模型,SWE-bench Pro 斩获 76.9 分

开源 AI 实验室 Ornith 团队正式发布 Ornith-1.5-122B 混合专家推理模型,并在 MIT 宽松协议下完全开源。该模型专门面向单节点 GPU 服务器(如单台 DGX)设计,提供包括 FP8、GGUF 与 MLX 在内的全套量化版本,已同步上架 Ollama(ornith-1.5:122b)与 vLLM/SGLang 运行时。在权威基准评测中,Ornith-1.5-122B 展现出媲美超大规模闭源模型的编程与智能体能力:在 OpenHands 评测框架下,SWE-bench Verified 达到 84.5 分,SWE-bench Pro 斩获 76.9 分(相较 Qwen3.8-Flash-Next 的 43.9 分取得跨越式领先),TerminalBench 达 81.2 分,MCP-Atlas 达到 74.6 分。

Ornith-1.5-122B 开源重磅登场:单机 DGX 即可部署的 122B MoE 推理模型,SWE-bench Pro 斩获 76.9 分

核心要点速览

  • Ornith-1.5-122B 正式发布并遵循极为宽松的 MIT 许可证,打破大参数量高性能编程推理模型闭源垄断
  • 专为单台 DGX 等单节点多卡服务器量身定制,已无缝接入 vLLM、SGLang 与 Ollama(ornith-1.5:122b),提供完整 FP8/GGUF/MLX 支持
  • 在真实软件工程评测集 SWE-bench Pro 斩获 76.9 分,相比同体量开源标杆 Qwen3.8-Flash-Next(43.9 分)大幅提升 33 分
  • 全方位通过 TerminalBench 2.1(81.2 分)、CyberGym(80.0 分)与 MCP-Atlas(74.6 分)测试,树立端到端 Coding Agent 开源新旗舰
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ornith-1.5-122B⚡ Qwen3.8-Flash-Next🤖 OpenHands🌐 Ornith

Meta 正式发布 Muse Glimmer 30B 技术报告:端侧消费级显卡即跑的端到端 Agentic 基础模型

Meta AI 研究团队正式公开 Muse Glimmer 30B 技术报告(arXiv:2610.24628)。该模型包含 300 亿参数,采用因果语言模型结合视觉感知编码器,专为无须依赖云端基础设施的端侧本地自主智能体打造。模型经由 4-bit 量化后仅需 32GB 显存,即可在单张消费级 GPU(如 RTX 5090)上全速运行。在严格的智能体基准测试中,Muse Glimmer 刷新同体量端侧模型纪录:MCPAtlas 工具调用得分高达 75.5(超越 Gemma4-31B 的 54.2 与 Qwen3.6-27B 的 62.5),在 SWE-Bench Pro 实测中斩获 51.2 分,并在 Apache 2.0 协议下完全开源。

Meta 正式发布 Muse Glimmer 30B 技术报告:端侧消费级显卡即跑的端到端 Agentic 基础模型

核心要点速览

  • Meta 正式公开 Muse Glimmer 30B 端侧智能体技术报告(arXiv:2610.24628),基于 Apache 2.0 协议全量开源
  • 单卡消费级硬件即开即用,经 4-bit 量化仅需 32GB 显存,完全适配单张 RTX 5090 等消费级设备,具备脱网离线运行能力
  • 在 Model Context Protocol 评测 MCPAtlas 上取得 75.5 分,大幅碾压 Gemma4-31B(54.2)与 Qwen3.6-27B(62.5)
  • 在权威软件工程测试集 SWE-Bench Pro 斩获 51.2 分,将端侧单卡自主编程智能体解决真实 Bug 的能力推进到实用化门槛
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Glimmer 30B⚡ Gemma4-31B⚡ Qwen3.6-27B🌐 Meta
AD赞助内容

告别单一 Issue 跑分偏见!JetBrains 发布 SWE-TaskFlow:基于 4782 场真实开发者会话重构 Agent 评测

现有的软件工程 Agent 基准(如 SWE-bench)几乎完全依赖从 GitHub Issue 派生的单向任务:给入一段 Issue 描述,让 Agent 尝试在单次多轮尝试中输出最终 Git Patch。然而,真实世界中的软件工程师真的是这样使用 AI 助手的吗?JetBrains 研究院在最新成果(arXiv:2610.09633)中公布了针对 JetBrains IDE 生产环境中 4,782 场真实软件工程师与 AI 交互会话(Production Sessions)的深度实证分析。研究发现,包含至少 3 轮交互的长会话呈现出截然不同的‘任务流(Task Flow)’:开发者的请求绝非单一的代码修改,而是跨越项目代码咨询答疑、架构规划、代码审查、功能重构与编译执行等多重任务类型的动态混合与频繁跳转。现有基准的单向任务模式严重脱离实际。为此,团队推出了 SWE-TaskFlow 框架:通过 Prompt 切分与可验证仓库问答技术,将任意 Issue 基准转换为贴合真实工程节拍的交互任务流,并提出 TaskFlow Alignment Score(TFAS)筛选真实轨迹。在 700 个 SWE-Bench Pro 任务的实测中,顺序多步交互协议使 Agent 算力成本翻倍但成功率未见稳定提升,证实交互协议本身是决定 Agent 实用价值的关键维度,论文与方法论已全面公开。

告别单一 Issue 跑分偏见!JetBrains 发布 SWE-TaskFlow:基于 4782 场真实开发者会话重构 Agent 评测

核心要点速览

  • JetBrains 分析 4782 场真实 IDE 开发者会话,揭示工程任务涵盖代码问答、规划、审查与执行的高频跳转
  • 发布 SWE-TaskFlow 评测框架与 TFAS 指标,将单一 Issue 转换为贴合真实工程节拍的交互任务流
  • 实测 700 个 SWE-Bench Pro 任务证实:分步交互使 Agent 算力成本暴涨 100% 却未带来稳定胜率提升,证实交互协议本身是关键变量
阅读全文
关联模型 / 智能体 / 厂商:

代码智能体有了“严师”随访!Rutgers 等开源 Opera:首创持久诊断笔迹,SWE-Bench 解题率跃升 15%

面向长程复杂软件工程(Long-Horizon Software Engineering)的代码智能体在排查深层 Bug 时极度依赖外部反馈,但传统的批评家(Critic)往往存在严重的“健忘症”与“误诊”:要么过早打断智能体正在进行的探索,要么给出一句模糊建议后便不再追踪,导致智能体表面上敷衍修改、深层问题依旧未解。罗格斯大学(Rutgers University)与利哈伊大学团队最新开源了突破性口头批评家框架 Opera(arXiv:2609.33987)。Opera 颠覆了单次打分范式,将每次纠错诊断定义为一份“持久随访便签(Persistent Note)”,持续跟踪智能体的后续动作直到问题彻底解决。系统结合周期性与事件驱动触发器,在下发建议前对比可见证据进行审计,并能敏锐区分智能体是“机械顺从”还是“真正修复”。在 Terminal-Bench 2.1、SWE-Bench Pro 子集和 DeepSWE v1.1 上,Opera 使非批评家智能体的任务解决率分别大幅提升 12.4、15.0 和 8.9 个百分点;更为关键的是,利用 Opera 引导的 Rollout 轨迹微调 Qwen3.5-9B,在不外挂 Critic 的纯推理模式下也能在跨仓库测试中取得 10.2% 的净增长,且彻底解决了跨 Harness(如从 OpenHands 切换到 Terminus-2)时的灾难性性能劣化。

核心要点速览

  • Rutgers 与 Lehigh 开源 Opera 框架,首创持久诊断便签(Persistent Notes)追踪机制,彻底治愈 Coding Agent 批评家健忘症
  • 在 Terminal-Bench 2.1 与 SWE-Bench Pro 上解题率分别暴涨 12.4% 与 15.0%,全维度刷新 Critic 基线记录
  • 引导轨迹微调 Qwen3.5-9B 获得 10.2% 离线净增益,攻克 OpenHands 到 Terminus-2 的跨 Harness 迁移劣化难题
阅读全文
关联模型 / 智能体 / 厂商:

Cline:腾讯 Hy4 Preview 以 770B/49B 激活、1M 上下文登上 SWE-bench Pro 榜首

Cline 宣布腾讯 Hy4 Preview 在 SWE-bench Pro 上领先。该开源权重模型总参 770B、激活 49B,上下文 1M,被 Cline 称为腾讯迄今最大的代际跃迁。开发者可 npm i -g cline 后用 /model 选择 Hy4 preview 直接跑仓库级修复。对编码代理生态意味着又一条可与闭源旗舰竞争的开源长上下文路径,尤其适合需要百万级上下文的多文件重构与基准评测。

核心要点速览

  • Hy4 Preview 为 770B 总参、49B 激活、1M 上下文的开源权重,Cline 称其在 SWE-bench Pro 领先。
  • Cline 视为腾讯迄今最大的代际跃迁,并已在产品内提供 Hy4 preview。
  • 安装 npm i -g cline 后通过 /model 即可切换,适合仓库级长上下文修复。
阅读全文

阿里通义开源 Qwen3.8-Flash:125B/6B 多模态 MoE,SWE-bench Pro 62.5,预览 Qwen4 架构

阿里通义千问开源多模态 MoE 模型 Qwen3.8-Flash,作为 Qwen4 架构早期预览。总参 125B 另加 51B N-gram 嵌入,每 Token 仅激活 6B;采用 GDN+QSA 混合注意力、Gated Residual 与 Muon 优化器。训练成本约为 Qwen3.7-Plus 的 1/9,却全面领先:DeepSWE 1.1 达 58.7、SWE-bench Pro 62.5、CoWorkBench 73.9、AndroidWorld 84.5、MathVision(含 CI)95.7。原生 262K 上下文,YaRN 可扩至 1M;1M 长度下 QSA 预填充最高 7.6 倍、解码 4.9 倍加速。QwenCloud 报价约 $0.15/$0.47 每百万 Token,权重已上线 Hugging Face,并获 NVIDIA NeMo、SGLang、Unsloth 与 OpenCode 的 Day-0 支持。

核心要点速览

  • 125B 总参、6B 激活,SWE-bench Pro 62.5、DeepSWE 1.1 58.7,训练成本约为上一代 Plus 的 1/9。
  • GDN+QSA 混合注意力在 1M 上下文下最高 7.6 倍预填充、4.9 倍解码加速。
  • 开源权重同步登陆 Hugging Face,QwenCloud / OpenRouter / OpenCode 与 NeMo、SGLang、Unsloth 提供 Day-0 接入。
阅读全文
关联模型 / 智能体 / 厂商:

SWE-bench 官方联合发布 SWE-bench Pro 多语言基准:全面纳入 Rust、Go 和 C++ 工业级缺陷修复评测

SWE-bench 评测团队联合顶尖研究机构推出了全新的 SWE-bench Pro 基准测试。新基准将测试用例从单纯的 Python 扩展到 Rust、Go、C++ 与 TypeScript 等 5 大工业级系统语言,包含 1,200 个来自顶级开源项目的真实 Issue 修复场景,更真实地衡量 AI 智能体在多语言混合微服务体系中的工程解决能力。

核心要点速览

  • 涵盖 Rust、Go、C++ 与 TypeScript 四大系统级语言的 1,200 个真实工程修复用例。
  • 引入编译期类型检查与集成测试通过率双重校验标准,杜绝虚假通过(False Positives)。
  • 首批排行榜已公布,Claude 3.7 Sonnet 与 DeepSeek-R1 领跑多语言综合解决率榜首。
阅读全文