
AI 编程实时动态与要闻

Artificial Analysis 发布 Endpoint Accuracy Index v1.1:100+ 无服务器端点近 1/4 低于参考权重部署

2026-11-06,Artificial Analysis 发布 Endpoint Accuracy Index v1.1:以自建官方权重部署为 100% 参考,用 BFCL-500、HLE-250、AA-LCR-25(等权)衡量各厂商 serverless 端点保住了多少精度。官方口径:已测 100+ 端点中近四分之一低于参考;AA-LCR-25 升至 v1.1 且重复从 10 提到 25(平均 95% CI 约 ±4.7→±2.6);覆盖扩至六款开源权重模型,新增 GLM-5.3 Flash 与 Muse Spark Open。
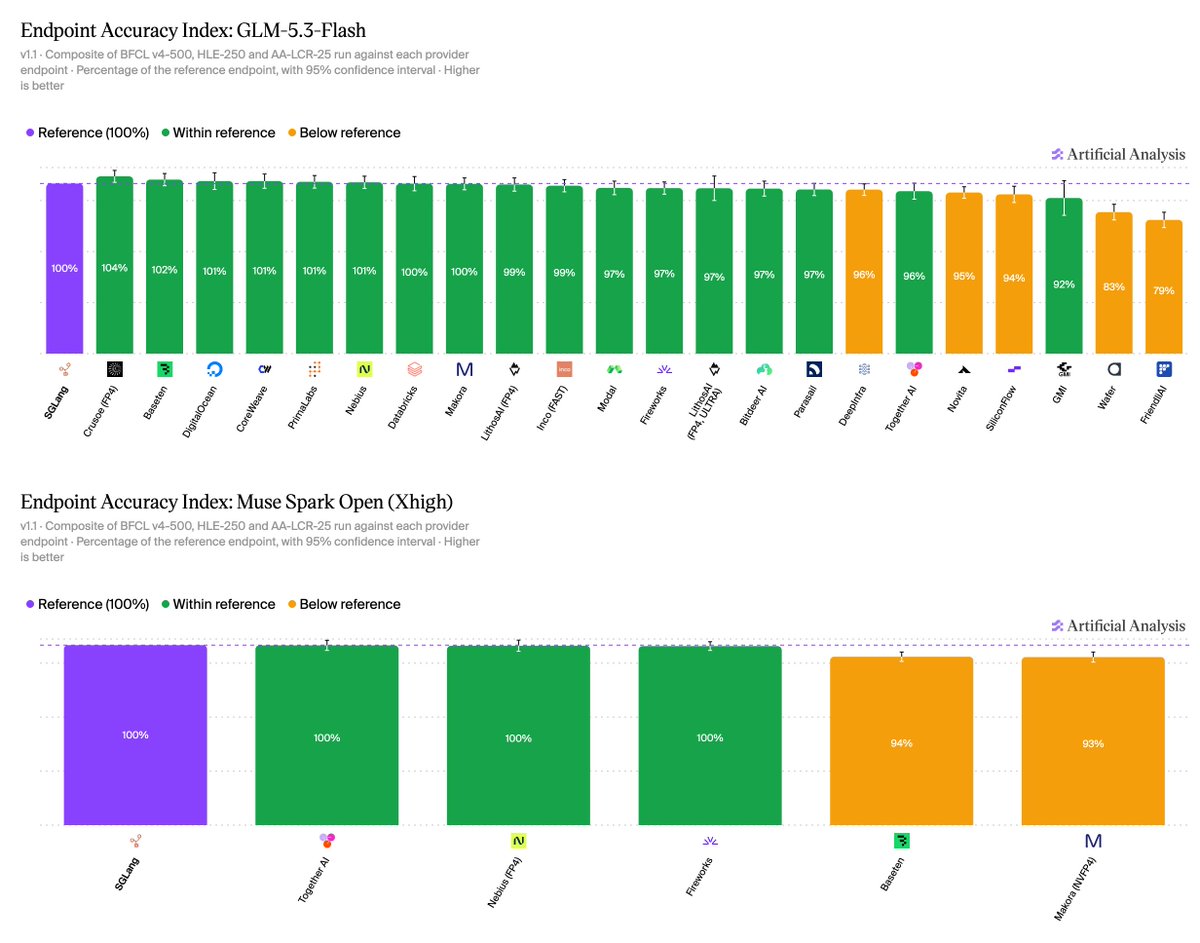
Artificial Analysis 发布 Endpoint Accuracy Index v1.1:100+ 无服务器端点近 1/4 低于参考权重部署

核心要点速览

  • 官方:@ArtificialAnlys 2026-11-06 02:44 UTC;changelog 05 Nov 2026;方法论页 Endpoint Accuracy Index v1.1
  • 厂商口径:100+ serverless 端点中近 1/4 低于自建参考;服务商常为速度/成本做量化、自定义 kernel、调栈或限输出
  • 套件等权:BFCL v4-500(3 次)、HLE-250(10 次)、AA-LCR-25(25 次);相对参考给 95% 置信区间并标注是否显著偏低
  • GLM-5.3 Flash:22 端点中 16 个与参考统计一致、1 个约 104.2;约 32K 输出上限端点 HLE-250 约 22%/29% vs 参考 55%
  • Muse Spark Open:5 端点中 3 个约 99.5–99.9(含 FP4);另 2 个主要在工具调用掉分(BFCL-500 约 50%/51% vs 59%)
阅读全文

Artificial Analysis 改用「单任务耗时」作为头号性能指标:GPT-6 Astra 满档约 17 分钟完成一题,快于 Opus 5.5 与 Gemini 4 Carbon

独立评测机构 Artificial Analysis 于 11 月 4 日(UTC 17:34)在 X 上宣布新版 API 性能基准:头号指标从输出速度改为 Time per Task,即完成一道 Intelligence Index 任务所需时间(每题输出 tokens ÷ 端到端输出速度)。新版覆盖约 1,000 个 serverless 端点,速度改为从发出请求算到最后一个 token,并加入多轮 Agent 编码与知识工作负载。官方数据:GPT-6 Astra 满档 51 tokens/s 但约 17 分钟完成一题,Claude Opus 5.5(max)约 26 分钟,Gemini 4 Carbon(high)约 29 分钟。

核心要点速览

  • Time per Task = 每道 Intelligence Index 任务的输出 tokens ÷ 端到端输出速度;逐 token 很快但话多的模型,可能比慢但省 token 的模型更晚完成任务。
  • 端到端输出速度从发出请求算到收到最后一个 token,包含首 token 前的等待(prefill 与隐藏推理);输出 token 改用各家 API 自报数量,不再用 o200k_base 分词器估算。
  • GPT-6 Astra(max)51 tokens/s,每题约 5 万输出 tokens、约 17 分钟;Claude Opus 5.5(max,111 tokens/s)约 26 分钟,Gemini 4 Carbon(high,71 tokens/s)约 29 分钟,后两者每题约 12–17 万 tokens。
  • 按各家 API 默认档(三者均为 medium),GPT-6 Astra、GPT-6.1 Sol、Opus 5.5 的单任务耗时降约 3–5 倍、成本降约 2–4 倍,Intelligence Index 低约 5–11 分;Opus 5.5 从约 26 分钟/10.04 美元降到约 6.8 分钟/2.45 美元。
  • 官方方法论页显示这是 3.0.0 版(10 月 30 日),测试频率改为每 6 小时一次,并新增端点错误率指标。
阅读全文

Fireworks 首届 Forge 大会发布一批新品:Ultra-fast 推理公测达 1500 tokens/秒,Background Mode 半价,Nexus Desktop 接入 Codex 与 Claude Desktop,Sovereign 私有部署预览

开源模型推理平台 Fireworks 11 月 3 日在首届 Forge 大会上发布一批新产品:基于 NVIDIA Blackwell 的 Ultra-fast 进入公测,在 DeepSeek V4.1 Flash 上最高 1500 tokens/秒,30 轮 Agent 任务从 1 分钟降到 8 秒;可等待任务的 Background Mode 半价;新增多日 Prompt 缓存和更高限流。Nexus Desktop 把开源模型路由带进 Codex app、Claude Desktop 和 OpenCode,Pro 每月 8 美元起;还有 No Eval、LoRA 无服务器推理、Fireworks Sovereign 私有部署等,并宣布 60+ 伙伴的 Frontier Ecosystem。

Fireworks 首届 Forge 大会发布一批新品:Ultra-fast 推理公测达 1500 tokens/秒,Background Mode 半价,Nexus Desktop 接入 Codex 与 Claude Desktop,Sovereign 私有部署预览

核心要点速览

  • Ultra-fast 公测:基于 NVIDIA Blackwell,在 DeepSeek V4.1 Flash 上最高 1500 tokens/秒;官方基准中 30 轮 Agent 任务耗时从 1 分钟降到 8 秒(Fireworks 官方博客)
  • 省钱选项:Background Mode 对可等待任务半价;多日 Prompt 缓存降低反复恢复上下文的成本;更高的 serverless 限流和 Elastic Burst 已正式可用
  • Nexus Desktop 上线:开源与闭源模型按个人路由,可在 Codex app、Claude Desktop、OpenCode 中使用;Pro 每月 8 美元起,Teams 每席每月 10 美元起
  • 训练侧:No Eval 私测,把生产 trace 转成任务评测;LoRA 无服务器推理公测,先支持 GLM 5.3 Flash,按 token 计费、空闲不收费;Muse Glimmer 30B 免费训练至 11 月 30 日
  • 企业侧:Fireworks Sovereign 私测,把推理引擎部署进客户自己的云或机房;官方称已在客户环境管理超过 2.5 万块 GPU;同时宣布 60+ 伙伴的 Frontier Ecosystem
阅读全文

Fireworks 上线 DeepSeek V4 Flash 原生视觉:无服务器与优先档同价 0.22/0.66 美元每百万 Token

Fireworks 宣布 DeepSeek V4 Flash 现已带原生视觉,覆盖无服务器与优先档。官方称多模态基准优于纯文本 0731 版本,价格保持每百万 Token 输入 0.22 美元、输出 0.66 美元。模型页显示 305B MoE、约 1040K 上下文、支持函数调用与图像输入,并带投机解码模块。

核心要点速览

  • 无服务器与优先档均可调用 DeepSeek-V4-Flash-Vision-Exp,给工作马模型加上图像输入。
  • 价格与纯文本 0731 相同:每百万 Token 输入 0.22 美元、输出 0.66 美元(缓存输入 0.007 美元)。
  • 305B MoE、约 1040K 上下文、函数调用 + 投机解码,适合带截图/UI 的编程智能体。
阅读全文
AD赞助内容

Fireworks 宣布 Training API 与 Fireworks Lab 全面开放:无服务器或专属 GPU 跑大规模强化学习

Fireworks 宣布 Training API 与 Fireworks Lab 全面可用,把训练、采样、服务与再训练收进同一平台,面向大规模强化学习。开发者可用 Python 自管损失、奖励、数据与环境,并接入托管分布式训练与 rollout;计算提供 Serverless 快速实验与 Dedicated 控成本两种模式。平台强调 rollout 吞吐、逐步权重同步以及训练器与推理引擎一致性。Lab 可嵌入前线研究员,客户包括 Cursor、Harvey、Figma、Vercel、Cognition 与 Factory。

核心要点速览

  • Training API 把自定义 Python 训练循环接到托管分布式训练与 rollout,覆盖 Serverless 与 Dedicated 两种算力。
  • 平台为强化学习设计,强调 rollout 吞吐、逐步权重同步以及训练器与推理引擎的模型一致性。
  • Fireworks Lab 可嵌入前线研究员,公开客户包括 Cursor、Harvey、Figma、Vercel、Cognition 与 Factory。
阅读全文

Replit Agent 联合 Neon 推出即时数据库分支与数据沙箱隔离:智能体自主调试不污染生产数据

Replit 与 Serverless Postgres 厂商 Neon 达成深度技术合作,在 Replit Agent 中内置即时数据库分支功能。当 Replit Agent 执行涉及数据表结构迁移或测试数据插入的任务时,系统自动在 500ms 内创建专属的隔离 Postgres 分支,彻底隔离破坏性写操作,测试通过后一键合并。

核心要点速览

  • 智能体自动在 500ms 内创建隔离的 Serverless Postgres 临时分支。
  • 破坏性 SQL 迁移与测试数据写入完全在沙箱中验证,不污染生产主库。
  • 验证通过后支持原子化结构合并,极大提升全栈智能体开发的安全性。
阅读全文
关联模型 / 智能体 / 厂商:

Fireworks AI Day-0 上线 GLM-5.3:美国托管 Serverless 推理与代码安全评测 SOTA

高性能推理服务平台 Fireworks AI 在 GLM-5.3 权重开源当日同步推出 Serverless API。该模型在 Z.ai 官方 Code Bench 上相比 5.2 提升 50%,在开源模型网络安全与长程 Agent 任务评测中取得 SOTA 表现。

核心要点速览

  • 大模型开源即上线(Day 0):为无法本地搭建 744B 级 MoE 算力集群的团队提供即开即用的弹性 API;
  • 专为复杂编程与安全测试优化:重点服务自动化漏洞挖掘、安全补丁生成与长周期自治任务;
  • 结合 Fireworks 专属推理优化引擎,在保障高并发的同时提供业界领先的流式输出吞吐。
阅读全文
关联模型 / 智能体 / 厂商:

Together AI 上线原生多模态 GLM-5.3 Flash 托管服务:DeepSWE 近 Luna,同等预算 2 倍产出

Together AI 宣布在其无服务器推理平台全面上线 GLM-5.3 Flash。作为首款 320B-A18B 原生多模态 MoE 模型,具备 100 万超长上下文与混合注意力,在 DeepSWE 编程基准中性能直逼 Luna,同等成本下产出翻倍。

核心要点速览

  • 320B 总参、18B 激活的原生多模态模型正式进入托管 API 矩阵,支持秒级自动扩缩容;
  • 原生视觉与混合注意力融合,兼顾大图表与海量代码库解析,大幅降低智能体开发调用开销;
  • 在 DeepSWE 软件工程基准评测中展现极高性价比,同等 Token 预算下完成的真实编程任务超两倍。
阅读全文
关联模型 / 智能体 / 厂商:

Modal Labs 上线 GLM-5.3-Flash 自动端点:Serverless GPU 秒级开箱即用,支持 OpenAI 兼容格式

Serverless GPU 算力平台 Modal 宣布上线 GLM-5.3-Flash 自动端点(Auto Endpoints)。开发者无需编写复杂的容器镜像与显存调度配置,即可通过标准 OpenAI 兼容 API 极速调用 320B-A18B 混合注意力大模型。

核心要点速览

  • 新开源模型 Day-0 / 当周极速上线成为 Serverless GPU 平台的核心竞争力标配;
  • Auto Endpoints 让工程团队完全跳过 Dockerfile 构建与显卡驱动调优,直接获得高弹性 API;
  • 针对多轮 Agent 编程场景提供高并发无状态执行支持,按需计费降低自建集群空转成本。
阅读全文
关联模型 / 智能体 / 厂商:
