AI 编程实时动态与要闻

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

Meta AI(@AIatMeta)于 11 月 5 日宣布,Connect 上预览的 Muse Realtime Avatar 开始在美国 Muse App 灰度:把 Muse Realtime Voice 变成可互动的实时形象。研究博客称系统为音频驱动的 Diffusion Transformer,与语音共享 speech token 流以同步口型与表情;单会话在 GB200 上可流式输出 448×768@25fps,用户话轮结束到音视频首字节约 870ms,并用 Meta Video Seal 做不可见水印。面向 18+ 用户;官方未公布全球时间表与开发者 API。

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

核心要点速览

  • 美国 Muse App 开始灰度 Realtime Avatar;Connect 时预览,现进入消费端(@AIatMeta)
  • 架构:语音 VQ token 同时驱动音频解码与 Avatar 视频;因果分块 + 自强制蒸馏,教师约 120 次评估压到学生 2 次(约 60×)
  • 性能口径:448×768@25fps,约 870ms 首包;单 GB200 相对 BF16 基线服务容量约 8×,可达 12 路并发(研究博客)
  • 主观评测:相对 Runway Characters、HeyGen LiveAvatar,评分者在整体与多数维度更偏好 Muse(厂商评测)
  • 安全:生成视频嵌入 Video Seal 不可见水印;示例不代表 App 内全部形象;无公开开发者 API
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark⚡ Muse Presence🤖 Muse🌐 Meta

Gemini Omni 1.2 Flash 正式 GA:视频最长 15 秒、输出价降约 30%,720p 约 $0.07/秒,1.1 将于 12 月 3 日自动路由

Google 于 11 月 5 日宣布 Gemini Omni 1.2 Flash(gemini-omni-1.2-flash)在 AI Studio 与 Gemini API 正式可用:视频生成与编辑上限提到 15 秒,官方称视频输出定价较上一代降约 30%(约 $12/百万 token,720p 有效价约 $0.07/秒),并加强多参考图一致性与对白自然度。changelog 写明自 2026-12-03 起,对 gemini-omni-1.1-flash 的请求将按 1.2 费率自动路由到 1.2。

Gemini Omni 1.2 Flash 正式 GA:视频最长 15 秒、输出价降约 30%,720p 约 $0.07/秒,1.1 将于 12 月 3 日自动路由

核心要点速览

  • 模型 ID:gemini-omni-1.2-flash,AI Studio / Gemini API 现已可用(官方 changelog 11-05)
  • 片段长度 3–15 秒(360p/720p/1080p/4K);多参考一致性官方称可达 6 张参考图
  • 厂商口径:视频输出价降约 30%,720p 约 $0.07/秒(约 $1.04/15 秒)
  • 2026-12-03 起 gemini-omni-1.1-flash 自动路由到 1.2 并按 1.2 计费
  • 消费侧:Flow、Google Vids、Gemini App 可做最长 15 秒剪辑与多轮编辑
阅读全文
关联模型 / 智能体 / 厂商:
⚡ gemini-omni-1.2-flash⚡ gemini-omni-1.1-flash🌐 Google DeepMind

Hume 发布 Audio Decision API:直接对原始音频提问,一次调用判断情绪、说话人数和背景声,官方称与人类评审一致率 70.7%

语音 AI 公司 Hume 11 月 2 日发布 Audio Decision API,号称首个「音频原生」的问答式决策模型:开发者上传原始音频,用一句话写问题并给出候选答案,接口返回每个答案的概率,不经过转写。支持是/否、多选、打分和时间片段四类问题,可判断说话人数、是否有人笑、来电者是否不耐烦、背景是否有警笛等。官方口径:训练用了 1000 万以上条人类判断,初步评测与人类评审平均判断的一致率为 70.7%(单个评审基线 56.5%)。目前需申请或加入候补名单获取访问权限。

Hume 发布 Audio Decision API:直接对原始音频提问,一次调用判断情绪、说话人数和背景声,官方称与人类评审一致率 70.7%

核心要点速览

  • 官方口径:初步评测中与人类评审平均判断一致率 70.7%,单个评审基线为 56.5%;评测样本量和语种未公布。
  • 训练数据为 1000 万以上条人类感知判断(Hume X 帖子口径),博客称累计数千万条评审打分。
  • 四类问题:是/否、多选、打分、时间片段,新增一个问题只需一行 JSON,无需标注或重新训练。
  • 开发者接口为 POST /v0/decisions/file,另有输入 token 估算接口,提供 Python 和 TypeScript SDK。
  • 官方称以前要 10 个以上模型组合的工作现在一次调用完成;价格官方未公布。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Hume Audio Decision Model🌐 Hume AI

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

语音模型公司 Cartesia 于 10 月 29 日发布 Managed Agents,一个面向企业电话场景的端到端语音 agent 平台,把自家语音识别、语音合成模型与 agent 框架一起设计调优,并自带电话接入、知识库、工具调用和批量外呼。官方称它在 Artificial Analysis 的 Speech Agent Arena 中以 1115 Elo 排第 1,在 ServiceNow 的 EVA-Bench 上拿到 87.4% 准确率和 90.7% 体验分(均为厂商口径,推理模型为 GPT-5.5);上线期价格打五折,为每分钟 0.03 美元。

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

核心要点速览

  • Artificial Analysis Speech Agent Arena 盲测偏好中,Managed Agents 以 1115 Elo 在 30 个 agent 中排第 1,高于 Gemini 3.1 Flash Live Minimal(1099)、Grok Voice 3.0(1064)和 GPT-Live-1(1041)(Cartesia 博客,厂商引用口径)
  • ServiceNow EVA-Bench 200 多个客服、IT 服务和 HR 场景首轮成绩:准确率 87.4%、体验分 90.7%,对比 Grok Voice 3.0 为 73.7%/71.2%、GPT Realtime 2.1 为 59.0%/61.6%(EVA-Bench)
  • 以上跑分都以 GPT-5.5 作为推理模型;Cartesia 内部评测称 85% 的通话没有抢话/打断问题,其他 agent 为 67%
  • 上线期五折,每分钟 0.03 美元;官方称该平台此前已在金融、零售、酒店、医疗场景跑过数千万次对话
  • 支持 44 种语言,目前英语、西班牙语、印地语、法语、日语可在通话中途切换,其余语言「即将支持」
阅读全文
AD赞助内容

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

NVIDIA AI 官方账号 10 月 28 日发布 Nemotron 3.5 Transcribe,权重已上架 Hugging Face 和 ModelScope。它是可用自然语言指令驱动的离线语音模型,一个检查点同时做 40 种语言转写、31 种语言与英语互译、13 种语言的说话人标注和音频问答,可处理最长 1 小时录音、最多标注 8 位说话人。官方称它在 Hugging Face Open ASR 英文榜以 5.33% 平均 WER 居开源模型第一;Artificial Analysis 测得 AA-WER 2.8%,与 24B 激活参数的 Voxtral Small 并列开源第一。权重、Granary v2 训练数据和微调配方一并开放。

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

核心要点速览

  • 架构:语音编码器加 Mamba-2/Transformer 混合 MoE 语言模型,总参数约 30B(模型卡含音频编码器计为 34B),每 token 激活约 4B(模型卡为 4.3B),提供 BF16、FP8、NVFP4 版本
  • 能力:40 语种转写、31 语种与英语互译、13 语种说话人标注、音频问答(问答仅英语训练)、词级时间戳,单段最长 1 小时、最多 8 位说话人
  • 官方/第三方口径:Open ASR 英文榜开源第一(平均 WER 5.33%),多语种 7 语言平均 4.62%,长音频 10.98%;Artificial Analysis AA-WER 2.8%,语音智能体对话集 AA-AgentTalk 1.8%(次优开源 2.3%)
  • Artificial Analysis 在 DeepInfra 托管端点实测:速度因子 75 倍,1 分钟音频不到 1 秒转完,价格每 1000 分钟 2 美元
  • 许可为 OpenMDW-1.1,可商用;配套开放 Granary v2 数据和 NeMo Speech 微调工具,官方医疗案例中微调比最佳提示词再降 45.8% 相对 WER
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe 30B-A4B⚡ Voxtral Small🌐 NVIDIA🌐 Hugging Face🌐 Artificial Analysis

腾讯混元开源同声传译模型 Hy-SimulMT:中英双向实时语音翻译,延迟约 3 秒并支持实时音色克隆

腾讯混元(Tencent Hy)10 月 26 日开源实时同声传译模型 Hy-SimulMT,支持中英双向语音到语音翻译,边听边译,同时输出译文文本和语音,并可实时克隆说话人音色。Hugging Face 上一次放出 6 个权重(30B-A3B 的纯译文版与带原文的 Interleave 版,各含 BF16、FP8、GGUF),模型卡标注 Apache-2.0;GitHub 同步提供 SimulInfer 推理服务与 SimulTrain 训练工具。官方口径:RealSI 长音频评测 StreamLAAL 约 3 秒,为对比系统最低。

腾讯混元开源同声传译模型 Hy-SimulMT:中英双向实时语音翻译,延迟约 3 秒并支持实时音色克隆

核心要点速览

  • 规模与形态:30B-A3B MoE(约 3B 激活),共 6 个权重:纯译文版与 Interleave(原文+译文)版,各有 BF16、FP8、GGUF(Hugging Face 合集)
  • 延迟(官方/厂商口径):RealSI 长音频评测 StreamLAAL 约 3 秒,为对比系统中最低,GEMBA 质量分超过对比的开源模型和 5 个商业 API 中的 4 个
  • 短音频(官方/厂商口径):FLEURS 90.3、CoVoST2 75.5、ACL6060 81.2、RealSI-Sentence 84.7,后者为表中所有系统最高;同表 Qwen3.8-LiveTranslate 为 88.4/82.1/80.5/84.4
  • 真人对比:18 段约 6 分钟的真实中英音频,对比 6 名 CATTI 一级/二级口译员,官方称质量相当、延迟常更低,并注明仅适用于该小规模测试
  • 部署:SimulInfer 一条 deploy.sh 命令拉起 vLLM(需 >=0.31)与 Web/WebSocket 服务,语音输出和音色克隆需另配 TTS;llama.cpp 支持尚未合入上游(SimulInfer 文档)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Hy-SimulMT-30B-A3B⚡ Hy-SimulMT-30B-A3B-Interleave⚡ Qwen3.8-LiveTranslate🌐 Tencent

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

2026-10-23(UTC 16:53,SGT 10-24 00:53),Block 官方账号 @blocks 发布 Dessa,Jack Dorsey 随后转发称其为「迄今最真实的全双工语音模型」。官方页面 block.xyz/dessa 介绍:Dessa 是真正的语音到语音模型,训练数据只有人类对话录音,不用文本、不用任何预训练模型;全双工,能边听边说,会自然插话和附和(“yeah!”“got it!”),推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行。官方称只用一套 NVIDIA GB200 NVL72 完成训练,学习语言所需的词量比 LLM 少数百倍。目前没有公开 API 或权重,只向一小批 AI 安全研究者开放早期访问。

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

核心要点速览

  • 训练数据只有人类对话语音:无文本、无预训练模型,从零训练(官方页面)
  • 全双工语音到语音:边听边说,会插话、附和,能直接听出并表达情绪、讽刺、笑声
  • 推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行
  • 官方称训练只用了一套 NVIDIA GB200 NVL72,学语言所需词量比 LLM 少数百倍
  • 暂无公开 API、权重或第三方跑分;目前只向少量 AI 安全研究者开放早期访问
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Dessa🌐 Block

Google 发布 Gemini API CLI(gemini-api)实验预览:零依赖 Go 二进制,让 Claude Code、Codex、Cursor 等编码 Agent 直接出图、出视频、转写并调度托管 Agent

Google AI Studio 团队发布 Gemini API CLI(命令名 gemini-api)实验预览版。它是一个无状态、零依赖的 Go 单文件,支持 macOS、Linux、Windows,Apache 2.0 开源。任何有 shell 权限的编码 Agent 配好 GEMINI_API_KEY 后,就能用一条命令调用文本推理、图像/视频/音乐/语音生成、文件与 YouTube 分析、音视频转写,以及 Deep Research 等托管 Agent。媒体结果直接写到磁盘、只把文件路径打印到 stdout,避免把 base64 塞进上下文。官方说明它是实验项目,不属于受支持的 Google 产品。

Google 发布 Gemini API CLI(gemini-api)实验预览:零依赖 Go 二进制,让 Claude Code、Codex、Cursor 等编码 Agent 直接出图、出视频、转写并调度托管 Agent

核心要点速览

  • 默认模型(官方 README):generate/analyze/transcribe 用 gemini-3.8-flash,image 用 gemini-nano-banana-2.1,video 用 gemini-omni-1.1-flash,music 用 lyria-3.5,tts 用 gemini-3.8-flash-tts
  • 安装:macOS/Linux 一行 curl 脚本、Windows 用 PowerShell 脚本,或 go install;GitHub 最新版本为 v0.4.3(2026-10-19 发布)
  • 面向 Agent 的机器接口:--usage 输出 KDL 命令树、--schema 输出 JSON Schema、--dry-run 离线校验且隐去凭据、--output-format json/toon、内置 --jq
  • 退出码区分 4 种情况:0 成功、1 运行/API 失败、2 用法或校验错误、3 鉴权失败;--agent-mode 输出结构化 JSON 错误
  • 还能管理托管 Agent 的沙箱环境、服务端凭据、Webhook 和 cron 触发器;Files API 上传文件保留 48 小时
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Gemini 3.8 Flash⚡ Gemini Nano Banana 2.1⚡ Gemini Omni 1.1 Flash⚡ Lyria 3.5⚡ Gemini 3.8 Flash TTS🤖 Gemini API CLI🤖 Claude Code🤖 Codex🤖 Cursor🤖 Antigravity🤖 Deep Research🌐 Google

Gradium 开源端侧 TTS 模型 Phonon:31M 参数、64 MB,笔记本 CPU 上 7 毫秒开口,英文版 Apache 2.0 可商用

10 月 20 日,法国语音 AI 公司 Gradium 开源 Phonon 端侧文本转语音模型家族:英文 Phonon 31m(q8 权重 64 MB,Apache 2.0)和 Phonon 40m(英/法/德/西/葡单语版与五语合一版,CC BY-NC 非商用)。模型基于 Kyutai 的 Pocket TTS 和 Mimi 编解码器,自带推理栈,覆盖 CPU、Metal、CUDA、Vulkan、WebGPU、Core ML 和骁龙,可在手机、浏览器、树莓派上离线运行。官方称 MacBook Air M5 CPU 上首段音频 7 毫秒,Kokoro 为 517 毫秒。

Gradium 开源端侧 TTS 模型 Phonon:31M 参数、64 MB,笔记本 CPU 上 7 毫秒开口,英文版 Apache 2.0 可商用

核心要点速览

  • 许可要看清:只有英文 Phonon 31m 是 Apache 2.0 可商用;Phonon 40m 各语言版和多语版均为 CC BY-NC 4.0,商用需联系 Gradium
  • 体积(官方):31m 的 q8 权重 64 MB,40m 为 74.6 MB;内置 37 个英文音色,多语版 102 个,也可用 Gradium 克隆或设计的音色
  • 速度(官方实测):MacBook Air M5 CPU 4 线程首段音频 6.9 毫秒、29.9 倍实时;Kokoro 517 毫秒(Kokoro 不流式输出);树莓派 5 上 38 毫秒开口、3.7 倍实时;骁龙 8 Elite Gen 5 上 7.5 毫秒
  • 准确率(厂商自建难句集,每种语言 500 句,已在 HF 公开):英文 WER 31m 1.70%、40m 2.22%,Kokoro 3.50%、NeuTTS Nano 8.71%;号码、日期、版本号等结构化文本靠文本规范化读对
  • 上手:uvx ptts 或 pip install ptts 即可本地合成,另有浏览器 npm 包 phonon-tts 和 GitHub 运行时 gradium-ai/xn-ptts
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Phonon 31m⚡ Phonon 40m⚡ Phonon 40m multilingual⚡ Pocket TTS⚡ Kokoro🤖 Pipecat🌐 Gradium🌐 Kyutai🌐 Arm🌐 Qualcomm🌐 Hugging Face

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

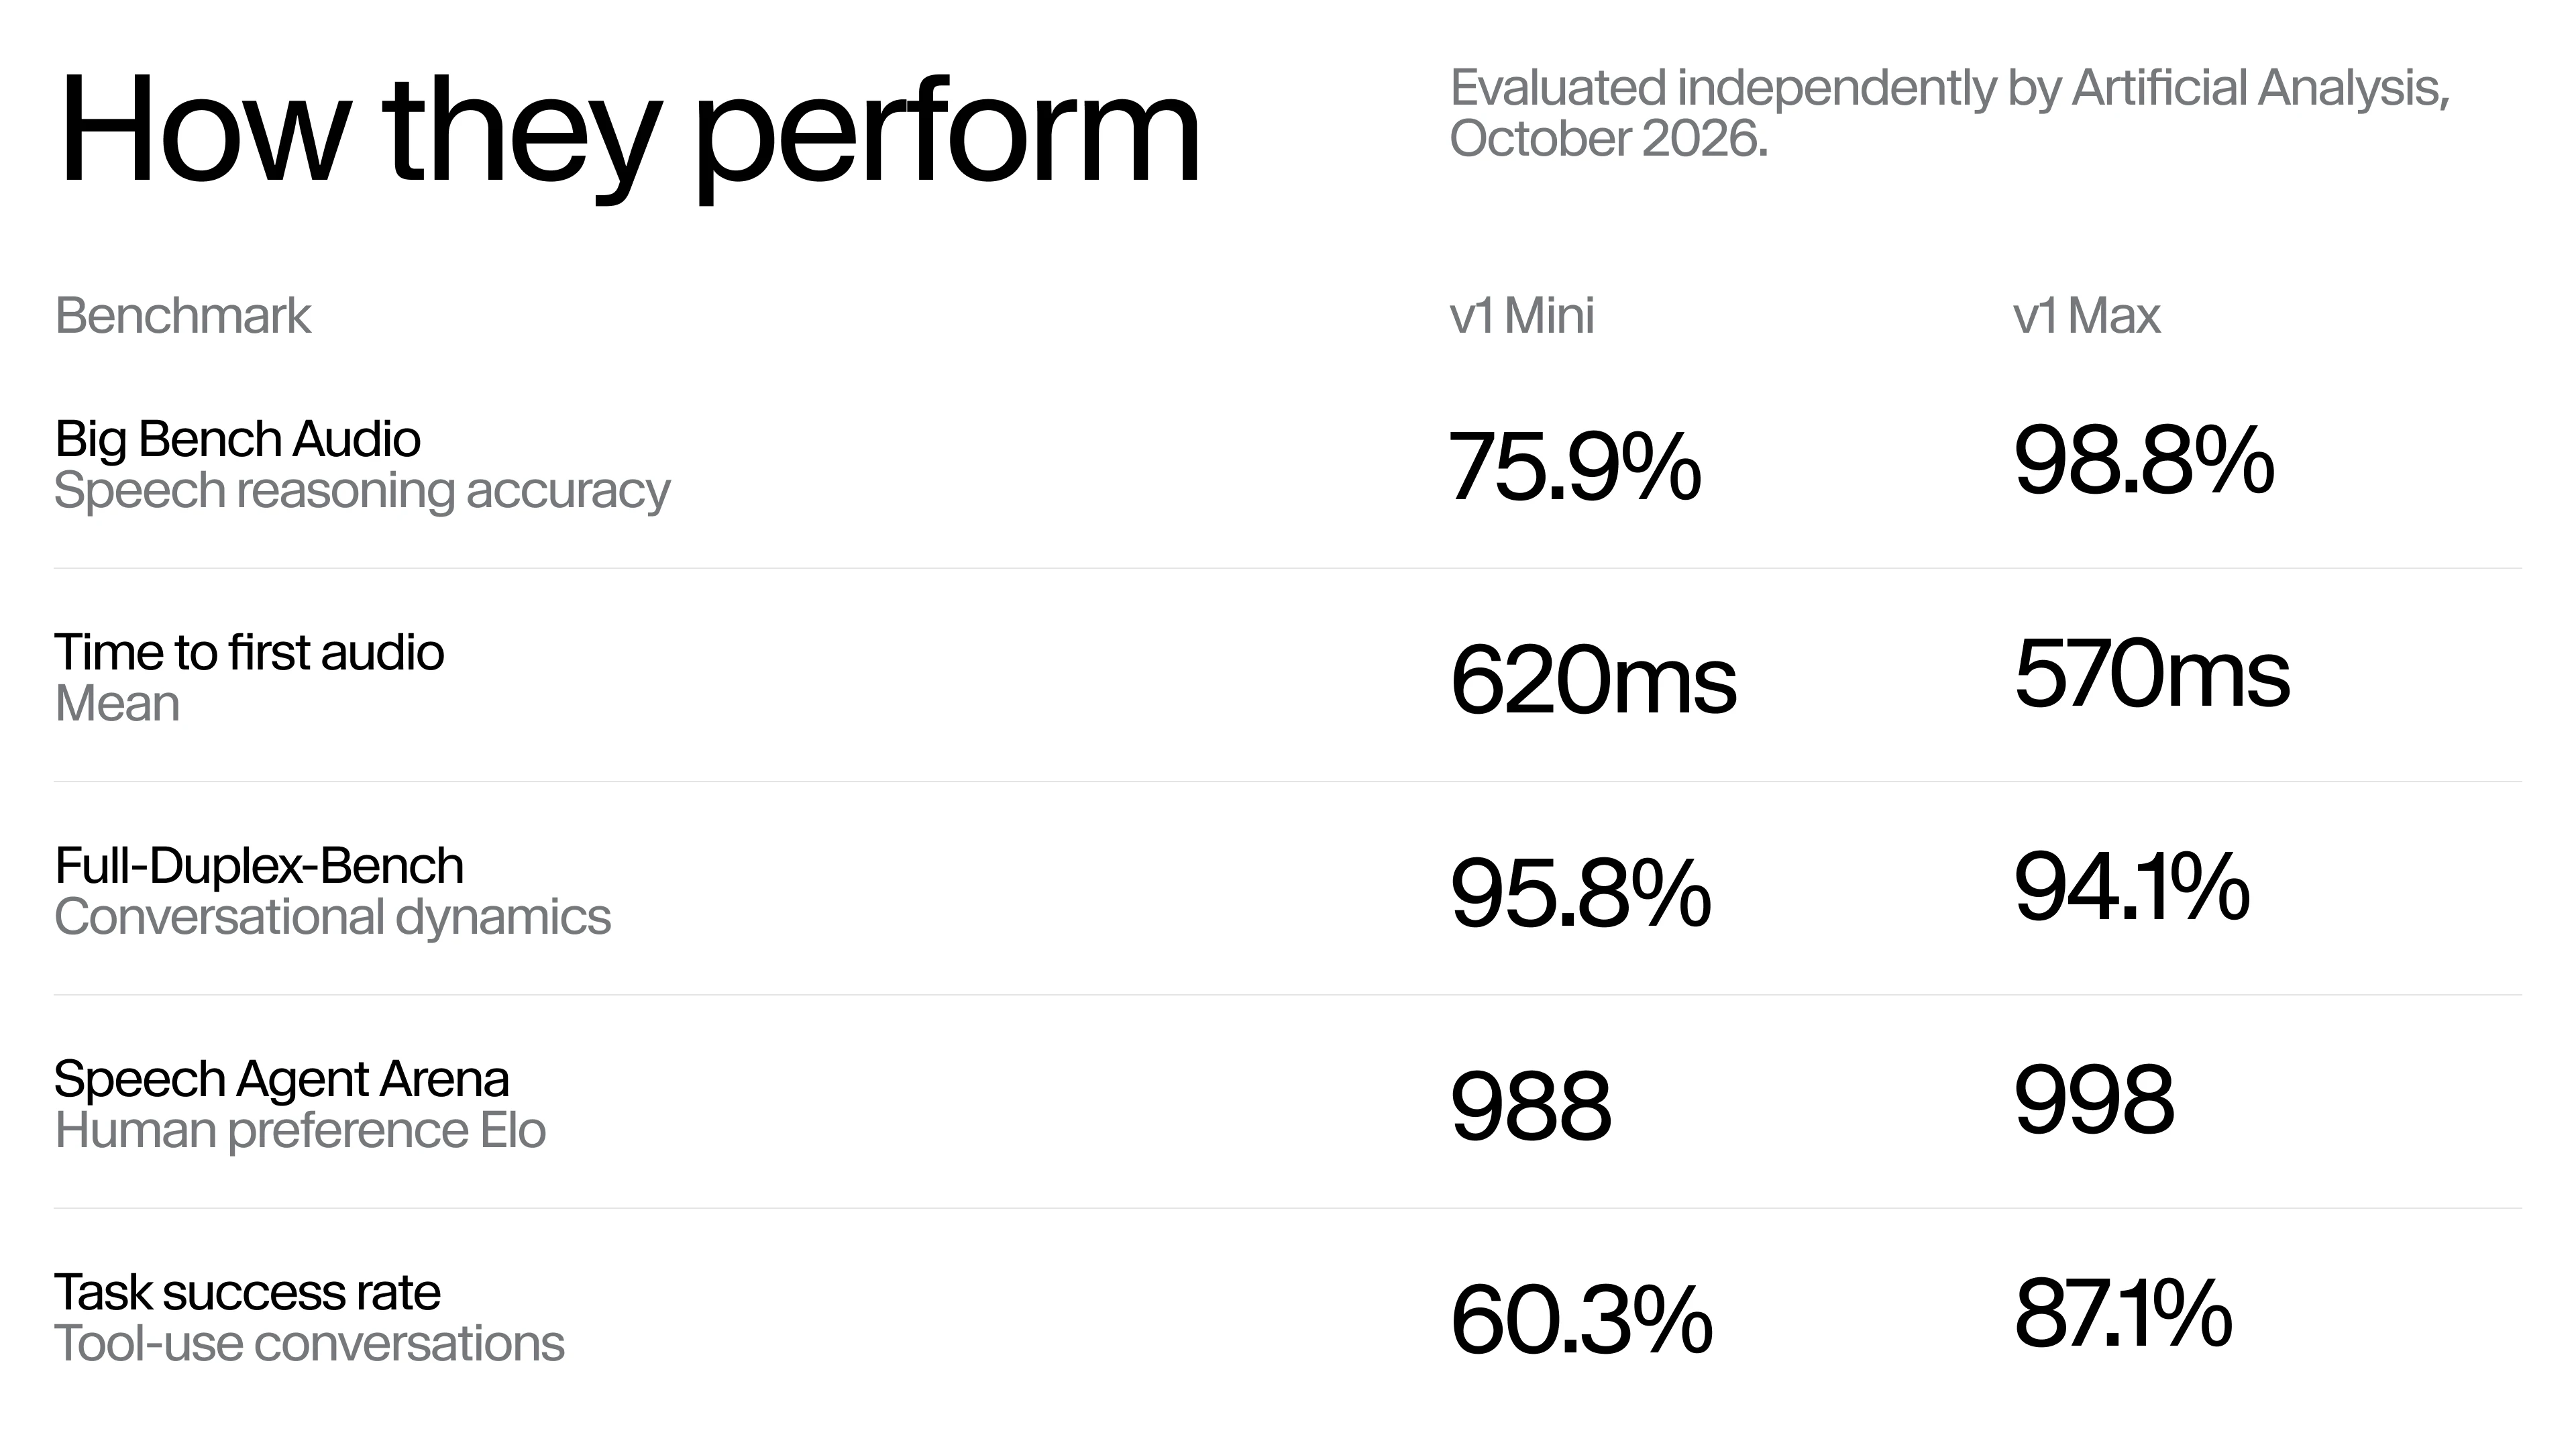
10 月 20 日,ElevenLabs 发布 Eleven Realtime,一类端到端语音到语音模型,每个模型本身就是完整的语音 Agent,不再需要自己拼语音识别、大模型和语音合成。v1 Mini 主打低成本自然对话,v1 Max 面向客服和多步骤工具调用。两者支持 90+ 语言、可用 17,000+ 种音色。官方引用 Artificial Analysis 独立评测:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开始说话。接口兼容 OpenAI Realtime API,改端点和模型名即可迁移。

ElevenLabs 发布端到端语音模型 Eleven Realtime v1 Mini / Max:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开口,兼容 OpenAI Realtime API

核心要点速览

  • 语音推理(Artificial Analysis 独立评测,官方引用):Big Bench Audio 1,000 道语音推理题,v1 Max 答对 98.8%,v1 Mini 75.9%
  • 速度(官方口径):Max 平均 0.57 秒开始说话,Mini 0.62 秒;官方推文说「半秒开口」,发布文给出的实测略高于半秒
  • 对话动态与偏好:Full-Duplex-Bench 上 Mini 95.8%、Max 94.1%;Speech Agent Arena 盲测 Max 998 分、Mini 988 分
  • 工具调用任务完成率 Max 87.1%、Mini 60.3%,官方因此建议重度调工具的场景用 Max
  • 覆盖 90+ 语言、17,000+ 音色;Realtime API 走 WebSocket(wss://api.elevenlabs.io/v1/convai/realtime),可直接用 OpenAI 官方 SDK,发布文未公布价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Eleven Realtime v1 Mini⚡ Eleven Realtime v1 Max🤖 ElevenAgents🌐 ElevenLabs🌐 Artificial Analysis
AD赞助内容

Mistral 发布 Voxtral 3 语音模型家族与语音 Agent SDK:转写支持 50+ 语言、TTS 每百万字符 13 美元,可欧盟托管或自部署

10 月 20 日,Mistral 发布 Voxtral 3:语音转文字模型 Voxtral Small/Mini Transcribe 3、实时转写 Voxtral Mini Transcribe Realtime 3、语音合成 Voxtral Mini TTS 3(Voxtral Speech 3),以及基于 LiveKit 的语音 Agent SDK,把“听—思考调工具—说”串成一条流式管线,官方称每轮响应不到 1 秒。转写覆盖 50+ 语言并支持说话人分离和上下文偏置,TTS 覆盖 35+ 语言、50+ 方言,另有 30 分钟录音即可复刻音色的 Pro Voice。模型已通过 Mistral API(欧盟、美国、全球端点)上线,也可自部署。

Mistral 发布 Voxtral 3 语音模型家族与语音 Agent SDK:转写支持 50+ 语言、TTS 每百万字符 13 美元,可欧盟托管或自部署

核心要点速览

  • 多语种转写(官方口径):FLEURS 45 种语言宏平均 WER,Voxtral Small Transcribe 3 为 4.1%(指定语言)/4.0%(自动识别),与 Microsoft AI Transcribe 2 持平,优于 Scribe v2 的 4.9% 和 Whisper large-v3 的 16.0%/14.9%
  • 说话人分离(官方口径):cpWER 方面 Small 为 18.4%、Mini 为 18.6%,上一代 Voxtral Mini Transcribe 2 为 30.9%,Gemini 3.5 Transcribe 为 38.4%
  • 价格:Voxtral Mini Transcribe 3 为 4B 参数,每分钟 0.0035 美元(文档标注 Public Preview、32k 上下文);Voxtral Speech 3 每百万字符 13 美元
  • 实时转写:Voxtral Mini Transcribe Realtime 3 延迟可低于 500 毫秒;官方 FLEURS 35 语言图中 480ms 档 WER 为 6.4%,仍高于 Gemini 3.5 Realtime Transcribe 的 4.2%
  • 语音 Agent SDK 基于 LiveKit,支持 SIP 电话与 WebRTC,每个环节可单独替换 LLM、音色或语言,Pro Voice 用 30 分钟录音即可复刻音色
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Voxtral Small Transcribe 3⚡ Voxtral Mini Transcribe 3⚡ Voxtral Mini Transcribe Realtime 3⚡ Voxtral Mini TTS 3🤖 Voxtral voice agent SDK🌐 Mistral AI🌐 LiveKit

蚂蚁集团开源语音大模型 Ming-3.0-tts:发音准确率 93.2% 登顶全球开源榜,MIT 协议商用友好

在 Artificial Analysis 最新发布的全球文本转语音(TTS)独立基准评测中,蚂蚁集团(Ant Group)开源的 Ming-3.0-tts 斩获 93.2% 的发音准确率,在全部 31 款参评模型中位列第一(超越 ElevenLabs v4 的 91.7%)。该模型提供 0.5B 密集版与 7.9B MoE 架构版本,支持高质量声音克隆与预设音色,在受控声音评测榜以 1,069 Elo 分位居开源第一,且以极度宽松的 MIT 开源协议完全向开发者免费开放。

蚂蚁集团开源语音大模型 Ming-3.0-tts:发音准确率 93.2% 登顶全球开源榜,MIT 协议商用友好

核心要点速览

  • 蚂蚁集团开源新一代语音大模型 Ming-3.0-tts,在 Artificial Analysis 独立测评中斩获 93.2% 发音准确率登顶全球开源第一
  • 发音表现超越 ElevenLabs v4(91.7%),在受控声音竞技场以 1,069 Elo 分位居开源模型榜首
  • 提供面向低延迟端侧的 0.5B 稠密版与极致拟真的 7.9B MoE 旗舰版,支持 3 秒极速零样本声音克隆
  • 采用无限制 MIT 开源协议完全免费商用,权重与代码已全面上线 Hugging Face
阅读全文
关联模型 / 智能体 / 厂商:

蚂蚁 inclusionAI 开源 5 款 Ming-3.0 语音模型:0.5B TTS 拿下开源权重音色控制第一,126B MoE 音频理解模型同步发布

蚂蚁 Ant Ling(inclusionAI)10 月 19 日以 MIT 协议开源 Ming-3.0 的 5 个模型,覆盖语音合成(tts-0.5B、tts-tiny 7.9B/1.3B 激活)、音频理解(audio-flash 126B/6.5B 激活、audio-tiny 9.3B/2.7B 激活)和语音识别(asr-tiny 8.6B/2B 激活)。官方称 tts-0.5B 在 Artificial Analysis Controlled Voice 榜以 1069 Elo 位列开源权重第一,发音稳健性 93.2% 并列全榜第一;asr-tiny 四类 ASR 平均错误率 4.41%。权重已上 Hugging Face 和 ModelScope,SGLang 与 vLLM 首日支持。

蚂蚁 inclusionAI 开源 5 款 Ming-3.0 语音模型:0.5B TTS 拿下开源权重音色控制第一,126B MoE 音频理解模型同步发布

核心要点速览

  • 阵容:3 个系列 5 个模型,TTS 2 个、音频理解 2 个、ASR 1 个,全部 MIT 协议。
  • TTS 成绩:tts-0.5B 在 AA Controlled Voice 获 1069 Elo,开源权重第一;Provider Voice 1188 Elo 排第 3;发音稳健性 93.2% 并列全榜第一(官方口径)。
  • TTS 能力:支持 7 种语言加四川话、粤语,14 种行内副语言标签(笑声、叹气、咳嗽等),44.1 kHz 输出,基于 Qwen2.5-0.5B。
  • 音频理解:audio-flash 总参 126B、每步激活 6.5B,可做长录音总结、语音问答、音频推理并生成工具调用请求。
  • ASR:asr-tiny 支持热词和对话上下文,在 15 个方言测试集上评测,四类任务平均错误率 4.41%(官方口径)。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ming-3.0-tts-0.5B⚡ Ming-3.0-tts-tiny⚡ Ming-3.0-audio-flash⚡ Ming-3.0-audio-tiny⚡ Ming-3.0-asr-tiny🌐 Ant Group🌐 inclusionAI🌐 SGLang🌐 vLLM

OpenAI 向全部 API 客户开放 prompt-to-voice:一句文字描述生成 GPT-Live 专属音色,创建免费,另增 9 个德法日韩印地语音色

OpenAI 于 10 月 16 日在官方更新日志宣布,prompt-to-voice 向所有 API 客户正式开放:开发者用一段文字描述口音、音高、音色和语速,即可通过 /v1/audio/voices 接口或 voice Playground 生成并保存自定义音色,在 GPT-Live 会话中复用。创建音色免费,语音生成按常规 GPT-Live 会话计费;每个组织最多保存 100 个。同时新增 9 个自然音色,覆盖德语、法语、印地语、日语和韩语。

OpenAI 向全部 API 客户开放 prompt-to-voice:一句文字描述生成 GPT-Live 专属音色,创建免费,另增 9 个德法日韩印地语音色

核心要点速览

  • 10 月 16 日起对所有 API 客户正式开放(GA),无需录音或授权录音即可建音色
  • 创建音色免费;在 GPT-Live 中出声、以及在 Playground 试听均按常规会话计费(官方口径)
  • 每个组织最多 100 个文字生成音色;可选 script_hint 示例台词,最长 2,000 字符
  • 新增 9 个自然音色:德语 3 个、法语 2 个、日语 2 个、印地语与韩语各 1 个
  • 限制:文字生成音色仅支持 GPT-Live,不支持 TTS、Realtime、Chat Completions;建音色接口不兼容零数据保留(ZDR)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT-Live-1⚡ GPT-Live-1.1🌐 OpenAI

MBZUAI IFM × Inception42 发布 Jais 3:六档开源阿拉伯语智能体模型(0.9B–375B)+ Jais Speech,512K 上下文落地 Hugging Face

阿联酋 MBZUAI 旗下 Institute of Foundation Models(IFM)与 Inception42 于 2026-10-15 正式发布 Jais 3:在开源底座 K2 Horizon 上做的首个语言适配,提供六档开源权重(0.9B 稠密至 375B-A23B 稀疏 MoE,每 token 激活约 23B)与阿拉伯语 ASR 模型 Jais Speech。全系列共享训练配方与智能体能力,上下文最长 512K(0.9B 为 128K),Apache-2.0,权重与分阶段 checkpoint 已上 Hugging Face,vLLM 宣布 Day-0 支持。

MBZUAI IFM × Inception42 发布 Jais 3:六档开源阿拉伯语智能体模型(0.9B–375B)+ Jais Speech,512K 上下文落地 Hugging Face

核心要点速览

  • 规模:六档 0.9B / 3.7B / 7B / 32B 稠密 + 36B-A4B(MoE+MoVA,约 4B 激活)+ 375B-A23B(约 23B 激活);旗舰需约 8×H200 BF16 节点(模型卡)
  • 官方自测阿拉伯语均分:375B 开源对照最高 84.0(Qwen3.5-397B 82.0);7B 79.4,相对同尺寸 K2 Horizon 基座 56.4→79.6(技术博客)
  • 智能体:3.7B/7B 在同尺寸对照中领先约 20 分;375B agentic average 60.2,SWE-Bench Verified 70.2、Terminal-Bench 2.1 73.8(官方同 harness 复测)
  • 语音:Jais Speech 在六套公开 ASR 测试宏平均 WER/CER 22.85/8.37,低于 Audar、Cohere Transcribe Arabic、omniASR 等对照(Jais 页)
  • 开箱:Apache-2.0;HF 集合 IFM/jais-3;vLLM≥0.30 / SGLang≥0.5.20 参考配方;推理 parser k2_horizon;配对 github.com/ifm-ai/JaisVoice
阅读全文
关联模型 / 智能体 / 厂商: