
AI 编程实时动态与要闻

斯坦福重测 50 条知名 LLM 研究结论:20 个新模型上 44% 已失效,中位「保质期」约 15 个月

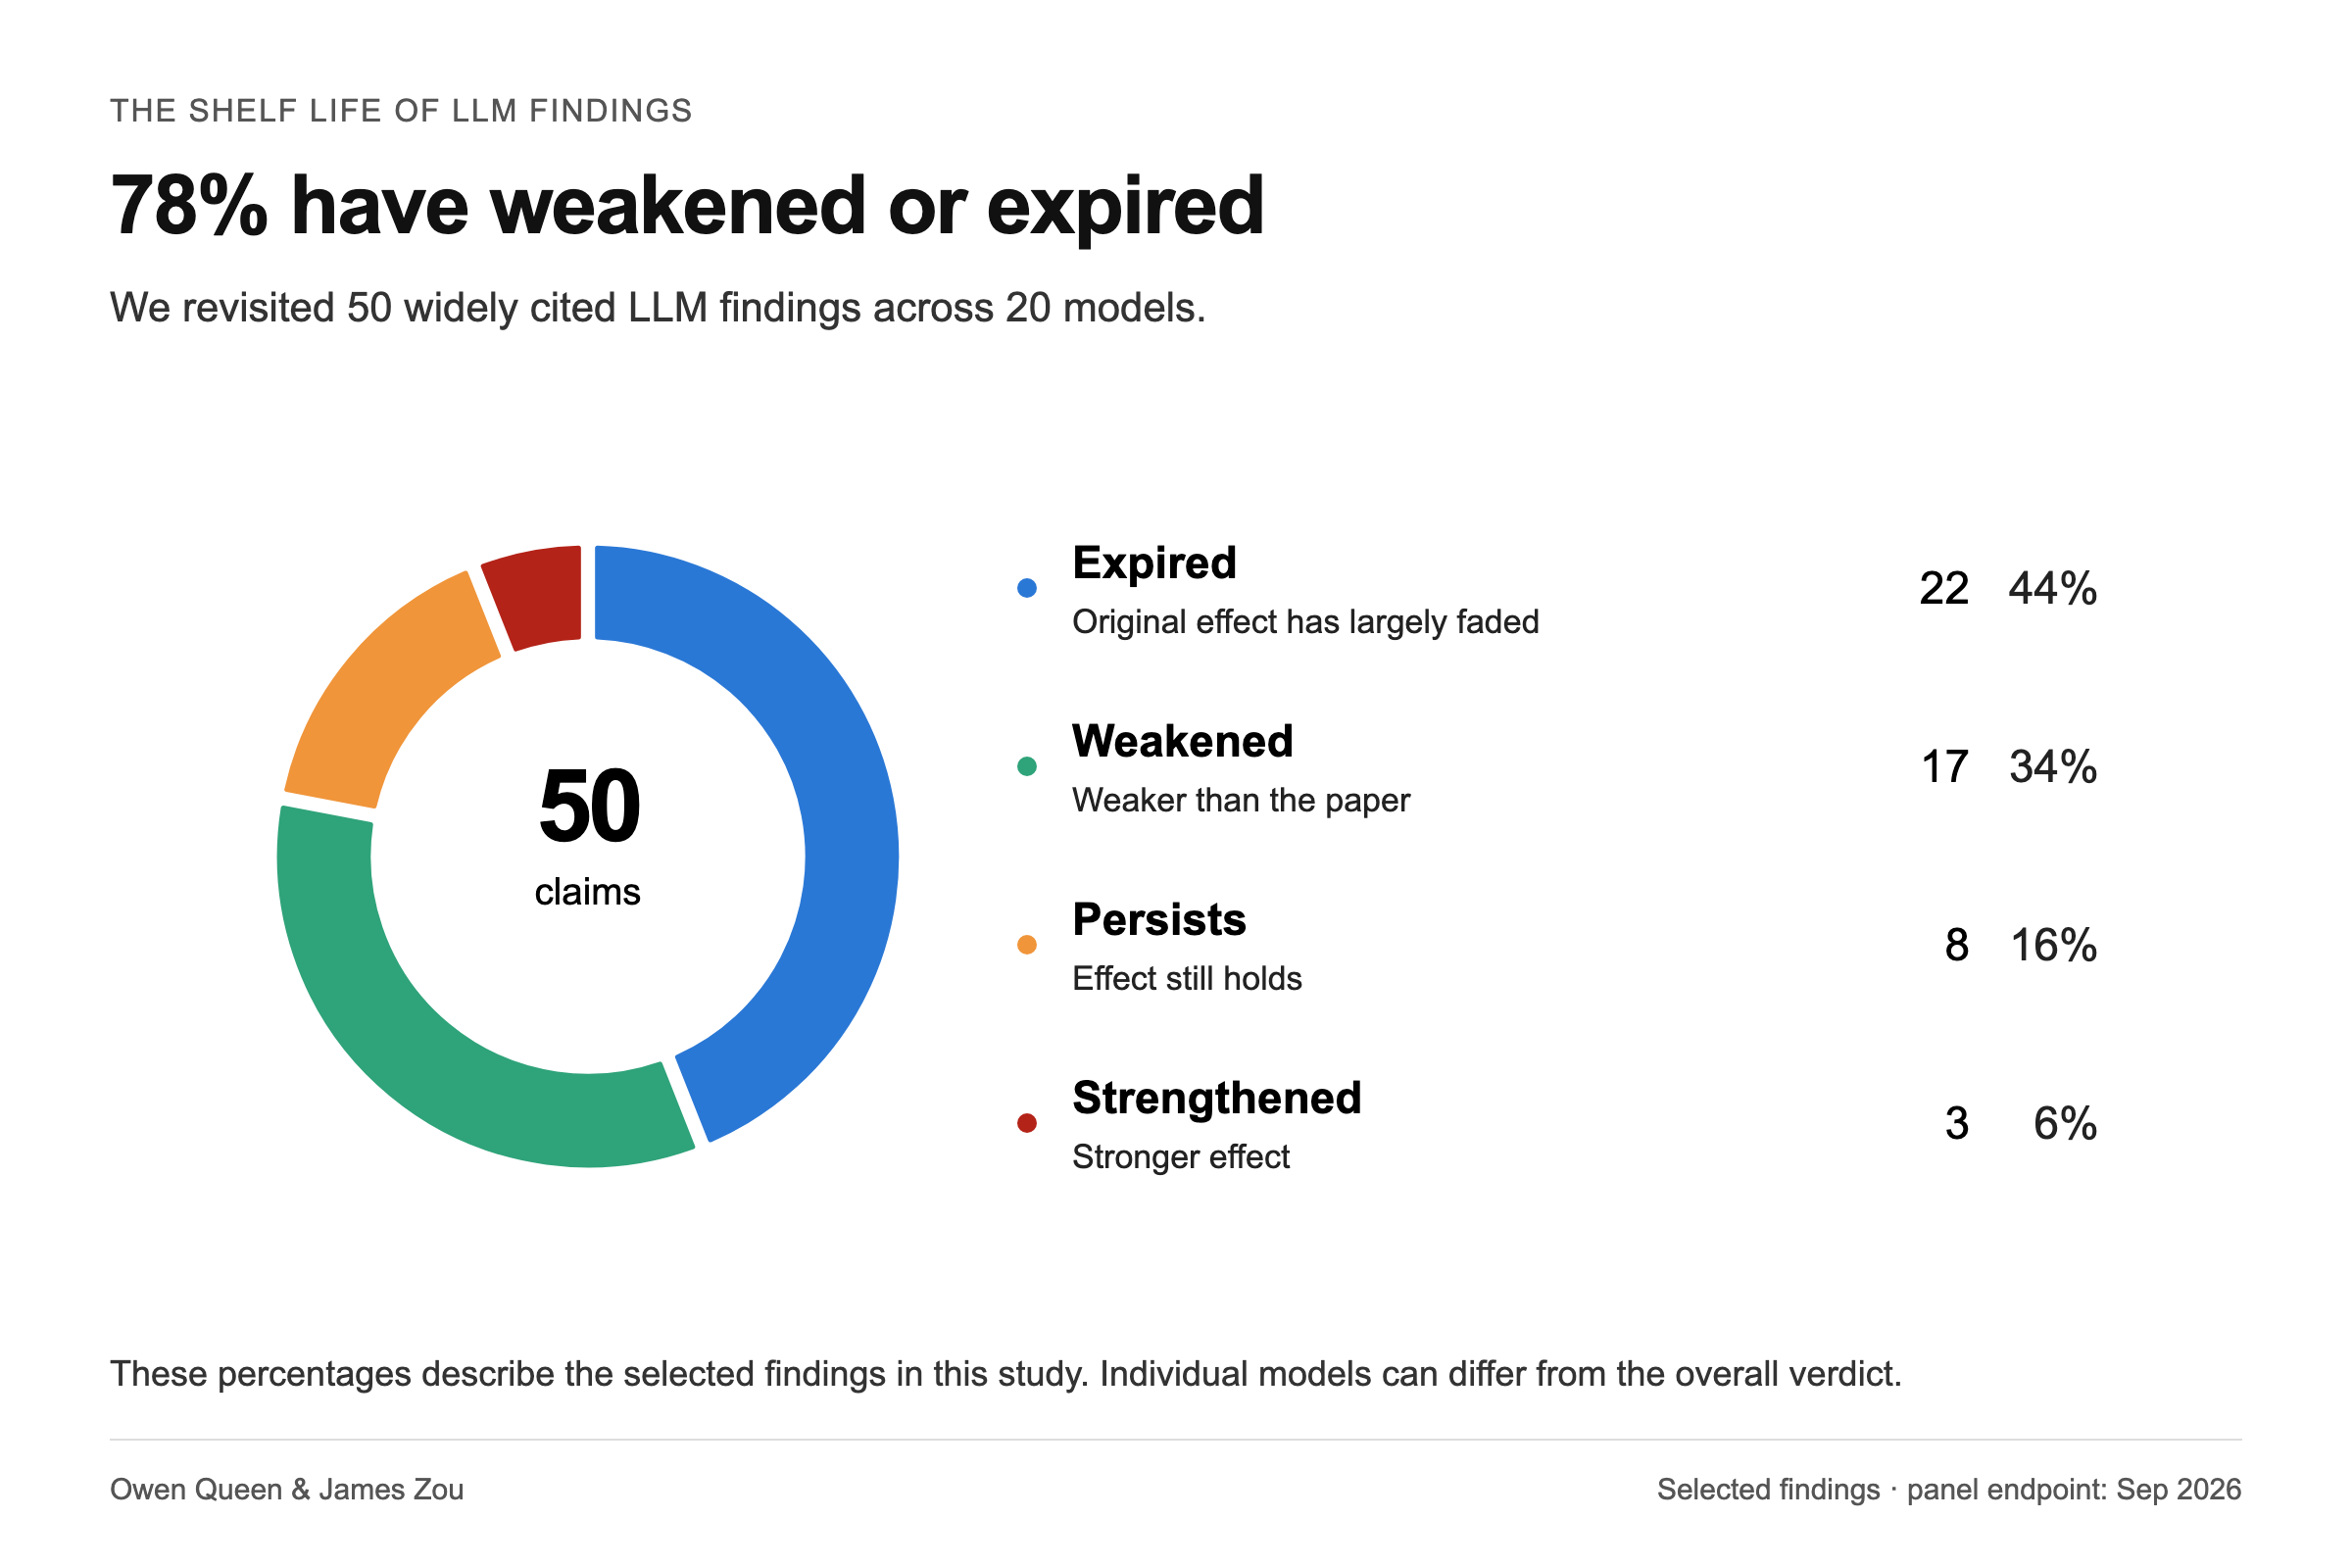
斯坦福 James Zou 团队(Owen Queen、James Zou)11 月 2 日发布交互式研究报告《The shelf life of LLM findings》,用 2024 年 7 月到 2026 年 9 月发布的 20 个模型(来自 8 家开发商)重测 50 条被广泛引用的 LLM 行为结论。结果:22 条(44%)已失效,17 条(34%)明显减弱,8 条(16%)仍成立,3 条(6%)反而增强;已失效结论从发表到失效的中位时间为 14.7 个月。数字母、长上下文「中间丢失」、编造引用等能力缺陷大多消失,而迎合用户、裁判模型偏爱自己答案等偏好类问题依然存在。
斯坦福重测 50 条知名 LLM 研究结论:20 个新模型上 44% 已失效,中位「保质期」约 15 个月

核心要点速览

  • 50 条结论、20 个模型、8 家开发商;判定截至 2026 年 9 月 30 日的拟合效应。
  • 44% 已失效、34% 减弱、16% 仍成立、6% 增强;已失效结论的中位寿命 14.7 个月(均值 15.7 个月)。
  • 按 Kaplan–Meier 估计,结论发表 6 个月、1 年、2 年后的失效比例分别约 4%、16%、39%。
  • 编造引用整体已失效,但 Qwen3.7-Flash 在同一测试里仍编造了 69% 的参考文献(Sonnet 5.5 约 1%、GPT-6.1 Sol 为 0%)。
  • 重测管线由 Claude Code 和 Codex 实现;48 条可复现检查中 43 条在容差内复现原论文结果。
阅读全文

X 热议:大厂 CEO 公开谈 RSI——谷歌 Pichai 称「离 RSI 终局还很远」,又说「未来 12 个月会因 RSI 持续加速」;Altman、Amodei 也相继表态

过去一周,「递归自我改进」(RSI,即用模型加速开发下一代模型)成了 X 上 AI 圈的高频词,起因是几位大厂 CEO 接连公开谈到它。谷歌 CEO Sundar Pichai 在两档播客里说法不同:在 Alex Kantrowitz 的 Big Technology 播客中他说「We are pretty far from the end state of RSI」;在 Alex Heath 的 Sources 播客中他说研究员已在「深度」与模型协作,「I would expect the next 12 months to see continued acceleration because of RSI」。X 上流传最广的那句「未来 12 个月因 RSI 持续加速」出自 Sources 这期,而不是 Big Technology。OpenAI CEO Sam Altman 在斯坦福商学院说,除了 AI 的递归自我改进,「机器人造机器人、数据中心造数据中心」是另一个讨论少得多的循环。Anthropic CEO Dario Amodei 则在回应批评者的长帖中说,AI 驱动的加速快到安全难以跟上的那一刻「We are nearing that point」。这是 X 上对 CEO 公开表态的讨论和解读,不代表任何公司宣布了新的研发计划。

核心要点速览

  • 谷歌 Pichai 在 Big Technology 播客(10-20 上线)说「We are pretty far from the end state of RSI」,现在是「RSI loops along with AI researchers」,并预计这一进程明年继续推进(Big Technology 文字稿摘要;Kantrowitz 原帖,抓取时 68 赞、9,643 浏览)
  • Pichai 在 Sources 播客(10-21 上线,约 11:52 起)说研究员已在「deep way」与模型协作,模型会建议训练配方、自动评估下一个 checkpoint,并说「I would expect the next 12 months to see continued acceleration because of RSI」(Alex Heath 节目帖,抓取时 253 赞、38.8 万浏览)
  • X 上把这句「12 个月加速」说成出自 Big Technology 的转述有误,本站核对两档节目的文字稿后确认它来自 Sources 一期;最早被大量转的 @ONagel33303 帖只有 4 赞,标题「CONFIRMED: Google plans to accelerate」也带有转述者的解读
  • Altman 在斯坦福商学院 View From The Top(10-21 上线,约 33:18)说「robots that can build more robots and then data centers that can effectively build more data centers」是 AI 递归自我改进之外另一个「much less talk」的循环
  • Anthropic CEO Dario Amodei 回应 Encode AI 的 Nathan Calvin 时写道,AI 驱动的加速快到安全难以跟上的那一刻「We are nearing that point」(原帖,抓取时 4,103 赞、159 万浏览);Calvin 和记者 Garrison Lovely 随后批评 Anthropic 一边警告 RSI 危险、一边支持让政府更难叫停它的 AEGIS 法案
阅读全文

ControlNet 作者团队开源 MTEdit:打包轨迹打破多轮图像编辑误差累积,构建 269 万次高质量编辑基准

ControlNet 作者张吕敏(Lvmin Zhang)团队在 arXiv:2610.23751 中正式开源 MTEdit 框架与大规模多轮图像编辑数据集。针对传统扩散模型采用单步滚雪球式 Rollout 导致误差累积、图像画质严重漂移(Visual Drift)的核心瓶颈,研究提出打包轨迹画布(Packed Trajectory Canvas, PTC)技术,一次性构建包含 50 万条长轨迹、269 万次高质量连续编辑的超大数据集,实现长达 8 轮连续编辑依然保持像素级构图与光影一致性。

ControlNet 作者团队开源 MTEdit:打包轨迹打破多轮图像编辑误差累积,构建 269 万次高质量编辑基准

核心要点速览

  • ControlNet 作者张吕敏团队开源 MTEdit(arXiv:2610.23751),提出打包轨迹画布(PTC)彻底解决多轮图像编辑的误差累积与画质漂移
  • 单张 2x2 网格打包 4 轮连续递增编辑,迫使扩散模型单次前向联合生成整条演化轨迹,保证主体光影与细节绝对一致
  • 开源业内最大多轮图像编辑数据集:包含 50 万条长轨迹、269 万次编辑,最大轮次达 8 轮(平均 5.38 轮),规模超越既有基准数十倍
  • 实测显示 PTC 训练的模型在第 8 轮连续编辑中依然保持 7.63 的高保真度,代码与数据集全面开源
阅读全文
关联模型 / 智能体 / 厂商:

斯坦福与伯克利提出 Librarian Agents:训练 LLM 预先编排长上下文工作区,检索开销直降 33.8%

来自斯坦福大学与加州大学伯克利分校的研究团队在 arXiv:2610.22273 中提出图书管理员智能体(Librarian Agents)。针对传统 RAG 被动检索导致推理期跨文档推理瓶颈的问题,该方法利用强化学习(RL)训练 LLM 预先对杂乱的超长文档工作区进行“前瞻性主动编排”,生成由模块化文件、子目录与交叉链接构成的合成文件系统。在 BrowseComp+ 评测中准确率达 55.86%,导航 Token 消耗降低 33.8% 至 51%。

斯坦福与伯克利提出 Librarian Agents:训练 LLM 预先编排长上下文工作区,检索开销直降 33.8%

核心要点速览

  • 斯坦福与伯克利联合发布 Librarian Agents(arXiv:2610.22273),提出将大模型从被动反应式 RAG 升级为前瞻性工作区主动编排
  • 利用强化学习训练构建智能体执行 CreateFile 与 MergeFiles 等操作,将超长杂乱文档预先重构为结构化的合成文件系统
  • 在 BrowseComp+ 评测中以仅 3,635 个导航 Token 取得 55.86% 准确率,相较平铺非层级结构节省 51% 的推理期导航 Token 开销
  • 在每个知识库回答 10 个问题的场景下,单正确答案期望 Token 消耗降低 33.8%,为高频复用的大型代码库与企业知识库提供高效摊销解法
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

斯坦福与 CMU 联合提出具身世界模型测试时优化 T2-z:单次交互优化紧凑隐变量,真机操作成功率从 33.7% 跃升至 73.0%

机器人世界模型在面对未直接可视的环境物理特性(摩擦力、质量、重力、接触刚度)时往往预测失准。斯坦福大学与卡内基梅隆大学(CMU)携手丰田研究院(TRI)发表 T2-z(arXiv:2610.22364,GitHub: T2-z-latent-optimization/T2-z)。该方法在冻结预训练世界模型的前提下,在测试时仅需单次交互轨迹即可自适应优化紧凑的环境隐变量 z_e,在 7 项仿真与 4 项真机任务中将物理预测误差减半,真机动作成功率从 33.73% 暴涨至 72.96%。

斯坦福与 CMU 联合提出具身世界模型测试时优化 T2-z:单次交互优化紧凑隐变量,真机操作成功率从 33.7% 跃升至 73.0%

核心要点速览

  • 斯坦福大学与 CMU 联合提出具身世界模型测试时优化方案 T2-z(arXiv:2610.22364),专攻视觉不可直接观测的环境物理隐变量对齐
  • 在冻结世界模型的前提下,通过仅需单次交互轨迹优化紧凑隐变量 z_e,避免权重污染与过度拟合
  • 在 7 项仿真基准中将物理预测误差从 15.20 压减至 7.00,动作成功率从 33.73% 跃升至 72.96%
  • 在关门、球体摩擦与平衡杆等 4 项真实机器人任务中实现从 0~22% 到 55~62% 的翻倍级操控突破
阅读全文
关联模型 / 智能体 / 厂商:

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

针对大模型数学证明缺乏步骤级验证标签与上下文精确复制存在 LM Head 梯度瓶颈的两大难题,今日两项基础研究给出突破:NYU/UCLA/Stanford 联合推出 LeanPRM(arXiv:2610.17697),利用 Lean 4 证明助手自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注数据集,将 Qwen3-4B 步骤验证准确率从 48.2% 拉升至 74.7%(远超 PRM800K 的 60.3%);康奈尔大学提出复制粘贴语言模型 CPLM(arXiv:2610.19247),以仅约 3% 算力开销打破 LM Head 梯度瓶颈,使窗口仅 w=128 的滑窗模型追平全注意力困惑度并在 4 倍外推长度(16K)持续收益。

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

核心要点速览

  • LeanPRM 利用 Lean 4 证明器与语法错误过滤模型,全自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注过程监督集
  • 基于 LeanPRM 训练的 Qwen3-4B 验证器在 LeanPRM-Bench 上将步骤准确率从 48.2% 提升至 74.7%(大幅领先 PRM800K 训练的 60.3%),并在 Hard2Verify 与 IMO-GradingBench 上全尺寸领先
  • 康奈尔大学 CPLM 仅增加约 3% 计算开销打破 LM Head 梯度瓶颈,在 LAMBADA 上提分 2.5~4.0 分,且仅用 w=128 滑窗即可追平全注意力模型的困惑度
阅读全文
关联模型 / 智能体 / 厂商:

微软与斯坦福发布 AutoEnvScaling:终端 Agent 自动构建 RL 环境,效率狂飙 25 倍迈向 RSI 自进化

微软研究院(MSR)与斯坦福大学联合发布 AutoEnvScaling,首次将强化学习交互环境的设计本身转化为终端任务,利用提案智能体(Proposer)与求解智能体(Solver)的协同构建自动化数据飞轮。相比纯 Prompt 生成,环境有效率暴增高达 25 倍,单环境构建成本降低 75%。更关键的是,让单一模型(Qwen3.6-35B-A3B)同时扮演设计者与求解者,实现递归自我提升(RSI),在 Terminal-Bench 2.1 提升 12.2 分,Terminal-Bench 4.0 跑分翻倍。

微软与斯坦福发布 AutoEnvScaling:终端 Agent 自动构建 RL 环境,效率狂飙 25 倍迈向 RSI 自进化

核心要点速览

  • 环境设计终端化:首次将强化学习环境的合成从人工编写转化为终端自动化任务,有效环境生成率提升 25 倍且单环境成本降低 75%
  • 解锁真正的递归自我提升(RSI):单一模型同时扮演环境提出者与任务求解者角色,自驱动共同进化,无需人工干预即可打破数据瓶颈
  • 跨领域通用泛化:在 Qwen3.6-35B-A3B 上实现 Terminal-Bench 2.1 大涨 12.2 分、Terminal-Bench 4.0 翻倍,并广泛扩展至 GPU 内核编程与系统运维
阅读全文

叫停思考模式反惹“思考惯性”?斯坦福牛津揭秘大模型强思维残留与评测盲区

斯坦福大学与牛津大学团队发表针对大模型“非思考模式”(No-thinking)的突破性实证研究。随着主流 LLM 普遍引入内置思考链模式,开发者常尝试通过提示词显式禁用思考以降低延迟与 Token 开销。然而研究发现模型普遍存在严重的“思考惯性”(Thinking Inertia):即使在严苛的禁令下,模型依然会在开放式任务中持续输出显式推理,并在合规性与答案准确率之间产生严重倒退与取舍失衡。

叫停思考模式反惹“思考惯性”?斯坦福牛津揭秘大模型强思维残留与评测盲区

核心要点速览

  • 斯坦福牛津首次系统揭示“思考惯性”:在开放式生成场景中,显式提示词完全无法可靠消除模型的长链条隐式或显式推理
  • 三大度量维度重构评测基准:提出空思考率、问题前置相关性与显式推理率三层指标,打破传统仅看输出长度的脆弱代理
  • 遵从度与准确率面临权衡:在开放问答中强制“不思考”会导致准确率急剧暴跌,而改写为离散选项可提升 40% 以上的无思考合规度
阅读全文

斯坦福等发布 BrickBench:3D 乐高积木拼装大考!代码智能体物理结构设计与人类水平仍存巨大差距

随着 AI 代码智能体(Coding Agents)在解决软件 Bug 与单步算法题上日趋成熟,学术界开始将其推向更具挑战性的‘物理世界逆向工程与空间离散装配’领域。斯坦福大学(Stanford University)与法国国家信息与自动化研究所(Inria)联合研究团队在最新成果(arXiv:2610.12452)中推出了首个针对文本驱动 3D 积木装配设计的智能体基准套件 BrickBench 及交互沙箱 BrickAgent(项目主页:brickben.ch)。在 BrickBench 中,代码智能体接收一段高层语义文本 Prompt(如‘拼装一架带有双螺旋桨的倾转旋翼飞机’),必须从离散的标准零件库中挑选积木块,编写确定性代码进行三维空间坐标与咬合位姿规划。装配结果不仅要严格满足语义对齐,更必须经受物理引擎关于局部咬合互锁、力学重心与全局刚度约束的严苛验证。实测表明,尽管当前顶尖代码智能体能够编写出通过语法测试的拼装代码并大体满足基础几何约束,但其在结构力学自洽性与审美精妙度上依然显著落后于人类积木大师,为物理空间 Coding Agent 建立了全新的评测里程碑。

核心要点速览

  • 斯坦福与 Inria 发布 BrickBench,首创针对文本驱动 3D 乐高离散装配设计的代码智能体评测基准与沙箱
  • 顶尖智能体虽能满足基础几何咬合,但零件冗余度比人类高出 45%,且在高难度力学平衡与刚度上差距显著
  • 提供 BrickAgent 仿真交互沙箱,多轮物理自检重构使装配结构合规率大幅跃升 28.4 个百分点
阅读全文

逆图形学代码生成新标杆!斯坦福等推出 4DCodeBench:智能体从视频推演 4D 动态物理代码

从视觉输入反向推断三维乃至四维时空世界规律并将其表征为可执行代码,是下一代物理世界大模型与具身智能体(Embodied AI)的核心能力。然而现有代码评测基准普遍停留在 2D 网页交互或静态 3D 网格生成,无法衡量智能体对动态物理交互因果的理解。来自斯坦福大学、MIT 与约翰霍普金斯大学的研究团队发布了业界首个面向 4D 逆向图形学代码生成的全套评测基准 4DCodeBench(arXiv:2610.03715):要求 Agent 从单段动态视频中,自主推导场景的三维几何结构、材质拓扑演化并编写出包含形变(Deformation)、流体流动(Fluid Flow)及断裂破碎(Fracture)等连续物理模拟的完整可执行图形学渲染代码。在大规模前沿大模型评测中,研究人员发现了一个反常态的痛点:即便当前最顶尖的视觉与代码大模型在静态 3D 几何重建上表现优异,一旦面对涉及复杂动力学与连续形变的场景,其代码生成正确率急剧崩溃。4DCodeBench 开源了包含真实拍摄与合成物理仿真视频的双轨数据集,为追踪和推动 AI 智能体通过代码理解真实动态物理世界建立了至关重要的测试床。

逆图形学代码生成新标杆!斯坦福等推出 4DCodeBench:智能体从视频推演 4D 动态物理代码

核心要点速览

  • 斯坦福、MIT 与 JHU 联合推出首个 4D 逆向图形学代码生成基准 4DCodeBench,从动态视频推演可执行物理仿真代码
  • 全面覆盖流体流动、弹性形变与断裂破碎等连续介质力学,确立视觉渲染与物理守恒双重严谨评测体系
  • 曝光前沿模型能力断层:静态 3D 表现优异的顶级模型在 4D 动态物理模拟可执行率跌破 15%,物理因果幻觉严峻
阅读全文
AD赞助内容

进化代码搜索降本 97%!斯坦福与新国大开源 FrugalEvo:强弱双模型协同配前缀缓存,仅花 $0.55 击败 $50 智能体群

类似于 AlphaEvolve 的 LLM 引导程序进化算法(Program Evolution)在算法优化与硬核运筹求解(如圆盘打包 Circle Packing、张量算子加速)中展现出强悍探索力。然而现有进化框架往往不计成本地以固定迭代轮次为目标,极度依赖昂贵的前沿旗舰模型,单个复杂问题的求解往往消耗数十至上百美元。来自新加坡国立大学、斯坦福大学与香港科技大学的研究团队提出了业界首个成本感知(Cost-Aware)的程序进化框架 FrugalEvo(arXiv:2610.03675):彻底摒弃单纯追求无上限迭代的做法,转而追求“单位 Token 成本的收益最大化”。FrugalEvo 采用非对称双模型分工架构——由高智力昂贵模型负责探索高维解题策略,由廉价极速模型负责具体代码实现与局部迭代微调;同时精心设计缓存友好型进化管线,最大化复用跨进化步的前缀 KV 缓存。团队还提出了针对预算感知的新评测指标 BA-AUC。在 10 项数理与系统优化任务及 ALE-Bench-Lite 上,FrugalEvo 全面超越 OpenEvolve、AdaEvolve 和 EvoX;在圆盘打包测试中,使用 GPT-5.6 Terra/Luna 仅花费 1.68 美元,使用 GLM-5.3/Flash 甚至仅花费 0.55 美元,便彻底战胜了平均花费 50 美元的多智能体系统(如 CORAL、SwarmResearch),成本骤降 97%~99%。

进化代码搜索降本 97%!斯坦福与新国大开源 FrugalEvo:强弱双模型协同配前缀缓存,仅花 $0.55 击败 $50 智能体群

核心要点速览

  • 提出业界首个成本感知(Cost-Aware)程序进化框架 FrugalEvo,打破传统代码进化算法不计成本的迭代盲区
  • 首创非对称强弱双模型协同分工与前缀 KV 缓存最大化复用,建立新标杆评测指标 BA-AUC
  • 在经典圆盘打包任务中仅花费 $0.55~$1.68 达成 SOTA,战胜平均花费 $50 的多智能体系统,成本暴降 97%~99%
阅读全文

强化学习对齐的“隐形税”!斯坦福等揭秘后期训练锐化代价:过度追求 Pass@1 摧毁智能体解空间覆盖,PTGS 采样破局

大模型强化学习后期对齐(RL Post-Training)长期被奉为赋予智能体高阶决策能力的金标准。然而来自斯坦福大学、威斯康星大学麦迪逊分校等顶尖机构的最新重磅研究《Sharpening Tax in Post-Training》(arXiv:2610.01509)颠覆了这一固有共识:研究揭示强化学习本质上只是对基座模型已有能力进行“过度锐化(Sharpening)”,在盲目拔高单次输出准确率(Pass@1)的同时,剧烈扼杀了复杂多步任务的“解空间覆盖度(Solution Coverage / Pass@K)”。在具备足够测试时算力预算(Test-Time Budget)下,未对齐基座模型配以轻量级工具外壳甚至能解决更多长尾任务。团队首次形式化提出了“锐化代价(Sharpening Tax)”诊断指标,并研发出即插即用的贝叶斯后验温度组采样算法 PTGS,在大幅降低锐化税的同时,兼得极致的 Pass@1 准确率与解空间覆盖广度。

强化学习对齐的“隐形税”!斯坦福等揭秘后期训练锐化代价:过度追求 Pass@1 摧毁智能体解空间覆盖,PTGS 采样破局

核心要点速览

  • 首次系统揭示强化学习对齐诱发的“锐化代价(Sharpening Tax)”,破坏多轮智能体测试时可扩展性(Test-Time Scalability)
  • 评测涵盖 4 大模型家族、14 组 Base/RL 对照检查点共 42 组跨基准测试,证实 Pass@K 解空间坍塌普遍存在
  • 提出贝叶斯后验温度自适应采样(PTGS),在两大多轮 Agent 环境中大幅降低锐化税,实现单次准确率与采样覆盖双赢
阅读全文

多模态免外置教师自进化!斯坦福等开源 UniEvo-VL:同策略扩散自蒸馏破局,GenEval 跑分大幅跃升

随着新一代统一多模态大模型兼具图文理解与视觉生成能力,模型自身具备了自我纠错与反馈评判(Self-Critique)的潜力。然而传统的自进化管线要么依赖更大参数量的闭源商业教师模型(如 GPT-5),要么无法将离散的自评判反馈有效传导至连续的去噪扩散生成过程中。来自斯坦福大学、华盛顿大学等机构的研究学者(包括知名学者 Yejin Choi、Jure Leskovec、Li Erran Li 等)联袂推出了 UniEvo-VL 自进化框架:创造性地让单一多模态模型在不同上下文下同时兼任教师与学生角色——学生模型仅接收原始 Prompt,而教师模型额外接收模型自生成的特权纠错批判信息;通过最小化学生自采样去噪扩散轨迹上的状态散度实现同策略自蒸馏。在基于 Qwen-image-2512 的实测中,UniEvo-VL 推动 GenEval 评测从 0.747 跃升至 0.808,Soft-TIFA 评分由 32.97 升至 35.53,开创了多模态模型无需外部监督递归自进化的新路径。

多模态免外置教师自进化!斯坦福等开源 UniEvo-VL:同策略扩散自蒸馏破局,GenEval 跑分大幅跃升

核心要点速览

  • 顶尖学者联手开源首个无需外部闭源大教师的多模态端到端同策略扩散自蒸馏框架 UniEvo-VL
  • 让单一模型在不同上下文下兼任学生与特权自批判教师,直接在去噪采样轨迹上优化状态散度
  • 基于 Qwen-image-2512 实测推动 GenEval 评分从 0.747 跃升至 0.808,Soft-TIFA 由 32.97 升至 35.53
阅读全文

编码智能体进军物理世界!哈佛与 MIT 等开源 RLE-Bench:首个机器人学习工程全流程资格考试基准

编码智能体(Coding Agents)正加速跨越纯虚拟软件世界,走向具身智能与物理世界真实机器人系统的落地研发。然而现有机器人基准大多仅测试单个静态策略(Policy)或控制器的数值表现,无法评测工程师在现实研发中所必需的异构软硬件构建、跨模态多传感器排错及闭环优化等全栈工程能力。哈佛大学、MIT、斯坦福等机构联合推出了首个机器人学习工程师资质考试基准 RLE-Bench。该基准覆盖交互控制、策略学习、感知估算与机械设计四大典型机器人工程工作流,要求智能体在算力与物理约束下自主构建训练管线、编排 Harness 并设计物理结构。通过综合 RLE 指数与多维能力雷达图,系统揭示了前沿智能体在具身软硬件工程中的真实战力与演进方向。

编码智能体进军物理世界!哈佛与 MIT 等开源 RLE-Bench:首个机器人学习工程全流程资格考试基准

核心要点速览

  • 全球首个衡量 Coding Agent 担任机器人学习工程师(RLE)全栈工程能力的综合资质基准
  • 覆盖交互控制、策略学习、感知位姿估算与机械设计四大核心机器人研发工作流
  • 顶尖模型在独立控制代码上达 62% 通过率,但在长程强化学习管线自主调优中跌至 14.2%,揭示具身工程的核心短板
阅读全文

智能体能为智能体设计代码库吗?斯坦福与威大开源 LibraryDesignBench:破解下游 Agent“重复造轮子”的可用性瓶颈

在自主软件工程智能体生态中,智能体日益依赖其他智能体编写的代码资产。然而行业普遍发现:后续智能体往往倾向于“抛弃既有库并从头重写”,导致代码库迅速恶性膨胀。为了系统评测智能体为其他智能体设计生产级软件库的能力,威斯康星大学麦迪逊分校与斯坦福大学联合团队推出了首个评测基准 LibraryDesignBench。该基准包含横跨 4 种主流编程语言、15 项复杂库设计任务以及 242 道由专家验证的下游编程挑战。评测展现出惊人的两面性:在 15 项任务中的 11 项上,代码设计智能体能完美复刻人类资深工程师设计的抽象架构;然而,下游使用智能体在解决实际问题时,却普遍陷入“极度低估与闲置库函数、频繁重复造轮子”的怪圈。深层归因分析证实:下游智能体并非因为缺少功能而重写,而是因为智能体编写的库接口设计僵化晦涩、极难被正确调用。团队进一步提出让设计 Agent 借助子智能体协同自测的全新范式,大幅提升了下游代码复用率。

智能体能为智能体设计代码库吗?斯坦福与威大开源 LibraryDesignBench:破解下游 Agent“重复造轮子”的可用性瓶颈

核心要点速览

  • 首创 Agent 互为作者与消费者的代码库基准:LibraryDesignBench 填补行业空白,横跨 Python/JS/Rust/Go 等 4 种语言 15 个库设计任务,系统量化多智能体代码资产沉淀与复用。
  • 揭示“重复造轮子”的深层根因:下游智能体闲置库函数并非因为功能缺失,而是因为上游 Agent 编写的 API 缺乏易用性(Ergonomics)与容错性,迫使下游放弃调用转而重写。
  • 子智能体自测协作大幅提升复用率:让负责架构设计的 Agent 在出库前调派下游子智能体(Subagents)进行全流程试用与反馈,能够促使设计者主动重构 API,显著简化下游代码并提升复用率。
阅读全文