
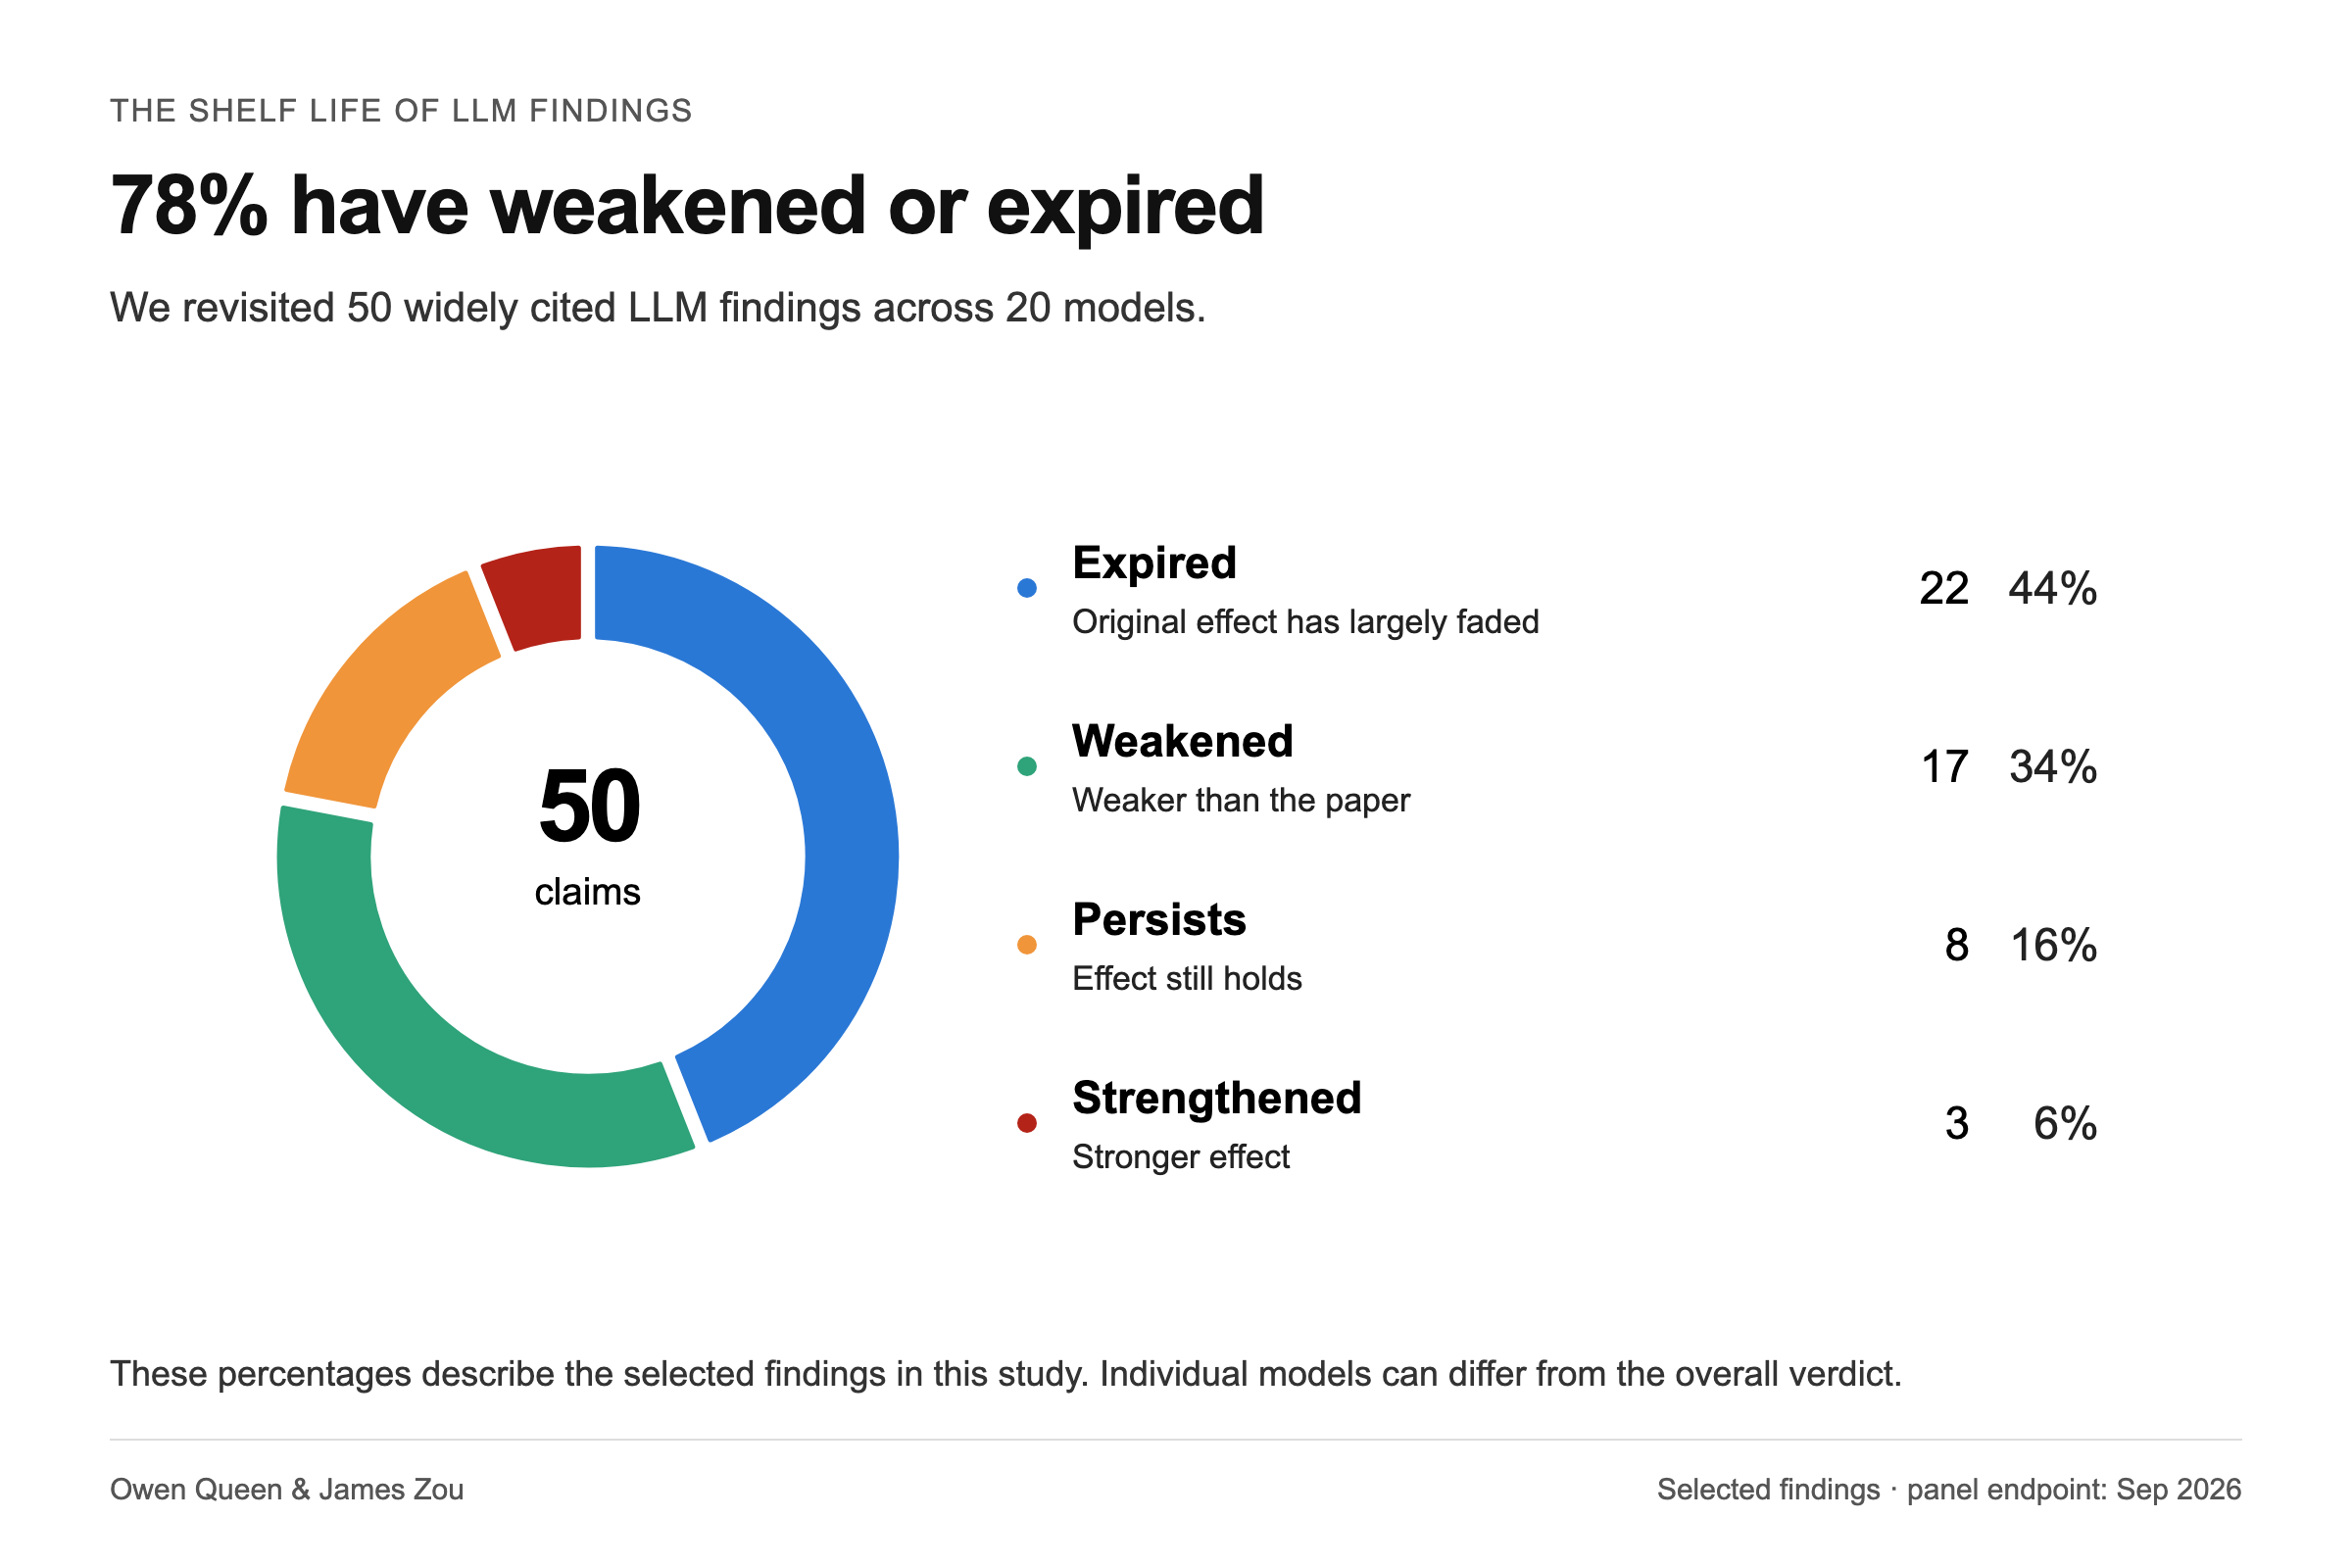
斯坦福 James Zou 团队(Owen Queen、James Zou)11 月 2 日发布交互式研究报告《The shelf life of LLM findings》,用 2024 年 7 月到 2026 年 9 月发布的 20 个模型(来自 8 家开发商)重测 50 条被广泛引用的 LLM 行为结论。结果:22 条(44%)已失效,17 条(34%)明显减弱,8 条(16%)仍成立,3 条(6%)反而增强;已失效结论从发表到失效的中位时间为 14.7 个月。数字母、长上下文「中间丢失」、编造引用等能力缺陷大多消失,而迎合用户、裁判模型偏爱自己答案等偏好类问题依然存在。
核心要点速览
- ✓50 条结论、20 个模型、8 家开发商;判定截至 2026 年 9 月 30 日的拟合效应。
- ✓44% 已失效、34% 减弱、16% 仍成立、6% 增强;已失效结论的中位寿命 14.7 个月(均值 15.7 个月)。
- ✓按 Kaplan–Meier 估计,结论发表 6 个月、1 年、2 年后的失效比例分别约 4%、16%、39%。
- ✓编造引用整体已失效,但 Qwen3.7-Flash 在同一测试里仍编造了 69% 的参考文献(Sonnet 5.5 约 1%、GPT-6.1 Sol 为 0%)。
- ✓重测管线由 Claude Code 和 Codex 实现;48 条可复现检查中 43 条在容差内复现原论文结果。
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
大量关于大模型的「常识」来自 2022–2024 年的论文:模型数不清 strawberry 里有几个 r、长上下文会丢中间信息、会编造引用、被质疑就放弃正确答案。这些结论至今仍被反复引用,用来设计评测、写安全策略、甚至做产品决策。问题是模型迭代极快,旧结论在新模型上是否还成立,很少有人系统检查。
架构亮点与底层机制
斯坦福 Owen Queen 和 James Zou 选了 50 条被广泛引用的结论,先在原模型或相近替代模型上复现原论文结果,再用同一套设置跑 20 个 2024 年 7 月到 2026 年 9 月发布的模型(8 家开发商,开源闭源、大小模型都有),按发布时间拟合效应变化趋势。效应归一化为相对值 e:1 表示与原论文一样强,0 表示消失;e 不超过 0.2 视为失效。重测管线由 Claude Code 和 Codex 编写,这也是两人团队能覆盖 50 篇论文的原因。
权威 Benchmark 与实测跑分对比
以下均为研究团队口径:22 条(44%)失效,17 条(34%)减弱,8 条(16%)仍成立,3 条(6%)增强。失效的多是能力缺陷;仍成立或增强的多是偏好与判断类问题,如迎合用户、裁判模型偏爱自己的答案、政治倾向偏左、该拒答时仍作答。模型之间差异很大:2026 年 7–9 月发布的模型中,失效条目数从 DeepSeek V4 Pro 的 11 条到 GPT-6.1 Sol 的 30 条不等;编造引用整体失效,但 Qwen3.7-Flash 仍编造了 69% 的参考文献。
开发者实战落地与开箱指南
别再拿两年前的论文结论当默认前提,评测和护栏要在你实际使用的模型上重测。偏好类问题(迎合、裁判自偏好)仍是真实风险:用 LLM 做评审时要换模型交叉打分。报告页面可按研究领域和判定结果筛选每条结论的卡片,GitHub 仓库提供摘要与说明。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察