AI 编程实时动态与要闻

斯坦福重测 50 条知名 LLM 研究结论:20 个新模型上 44% 已失效,中位「保质期」约 15 个月

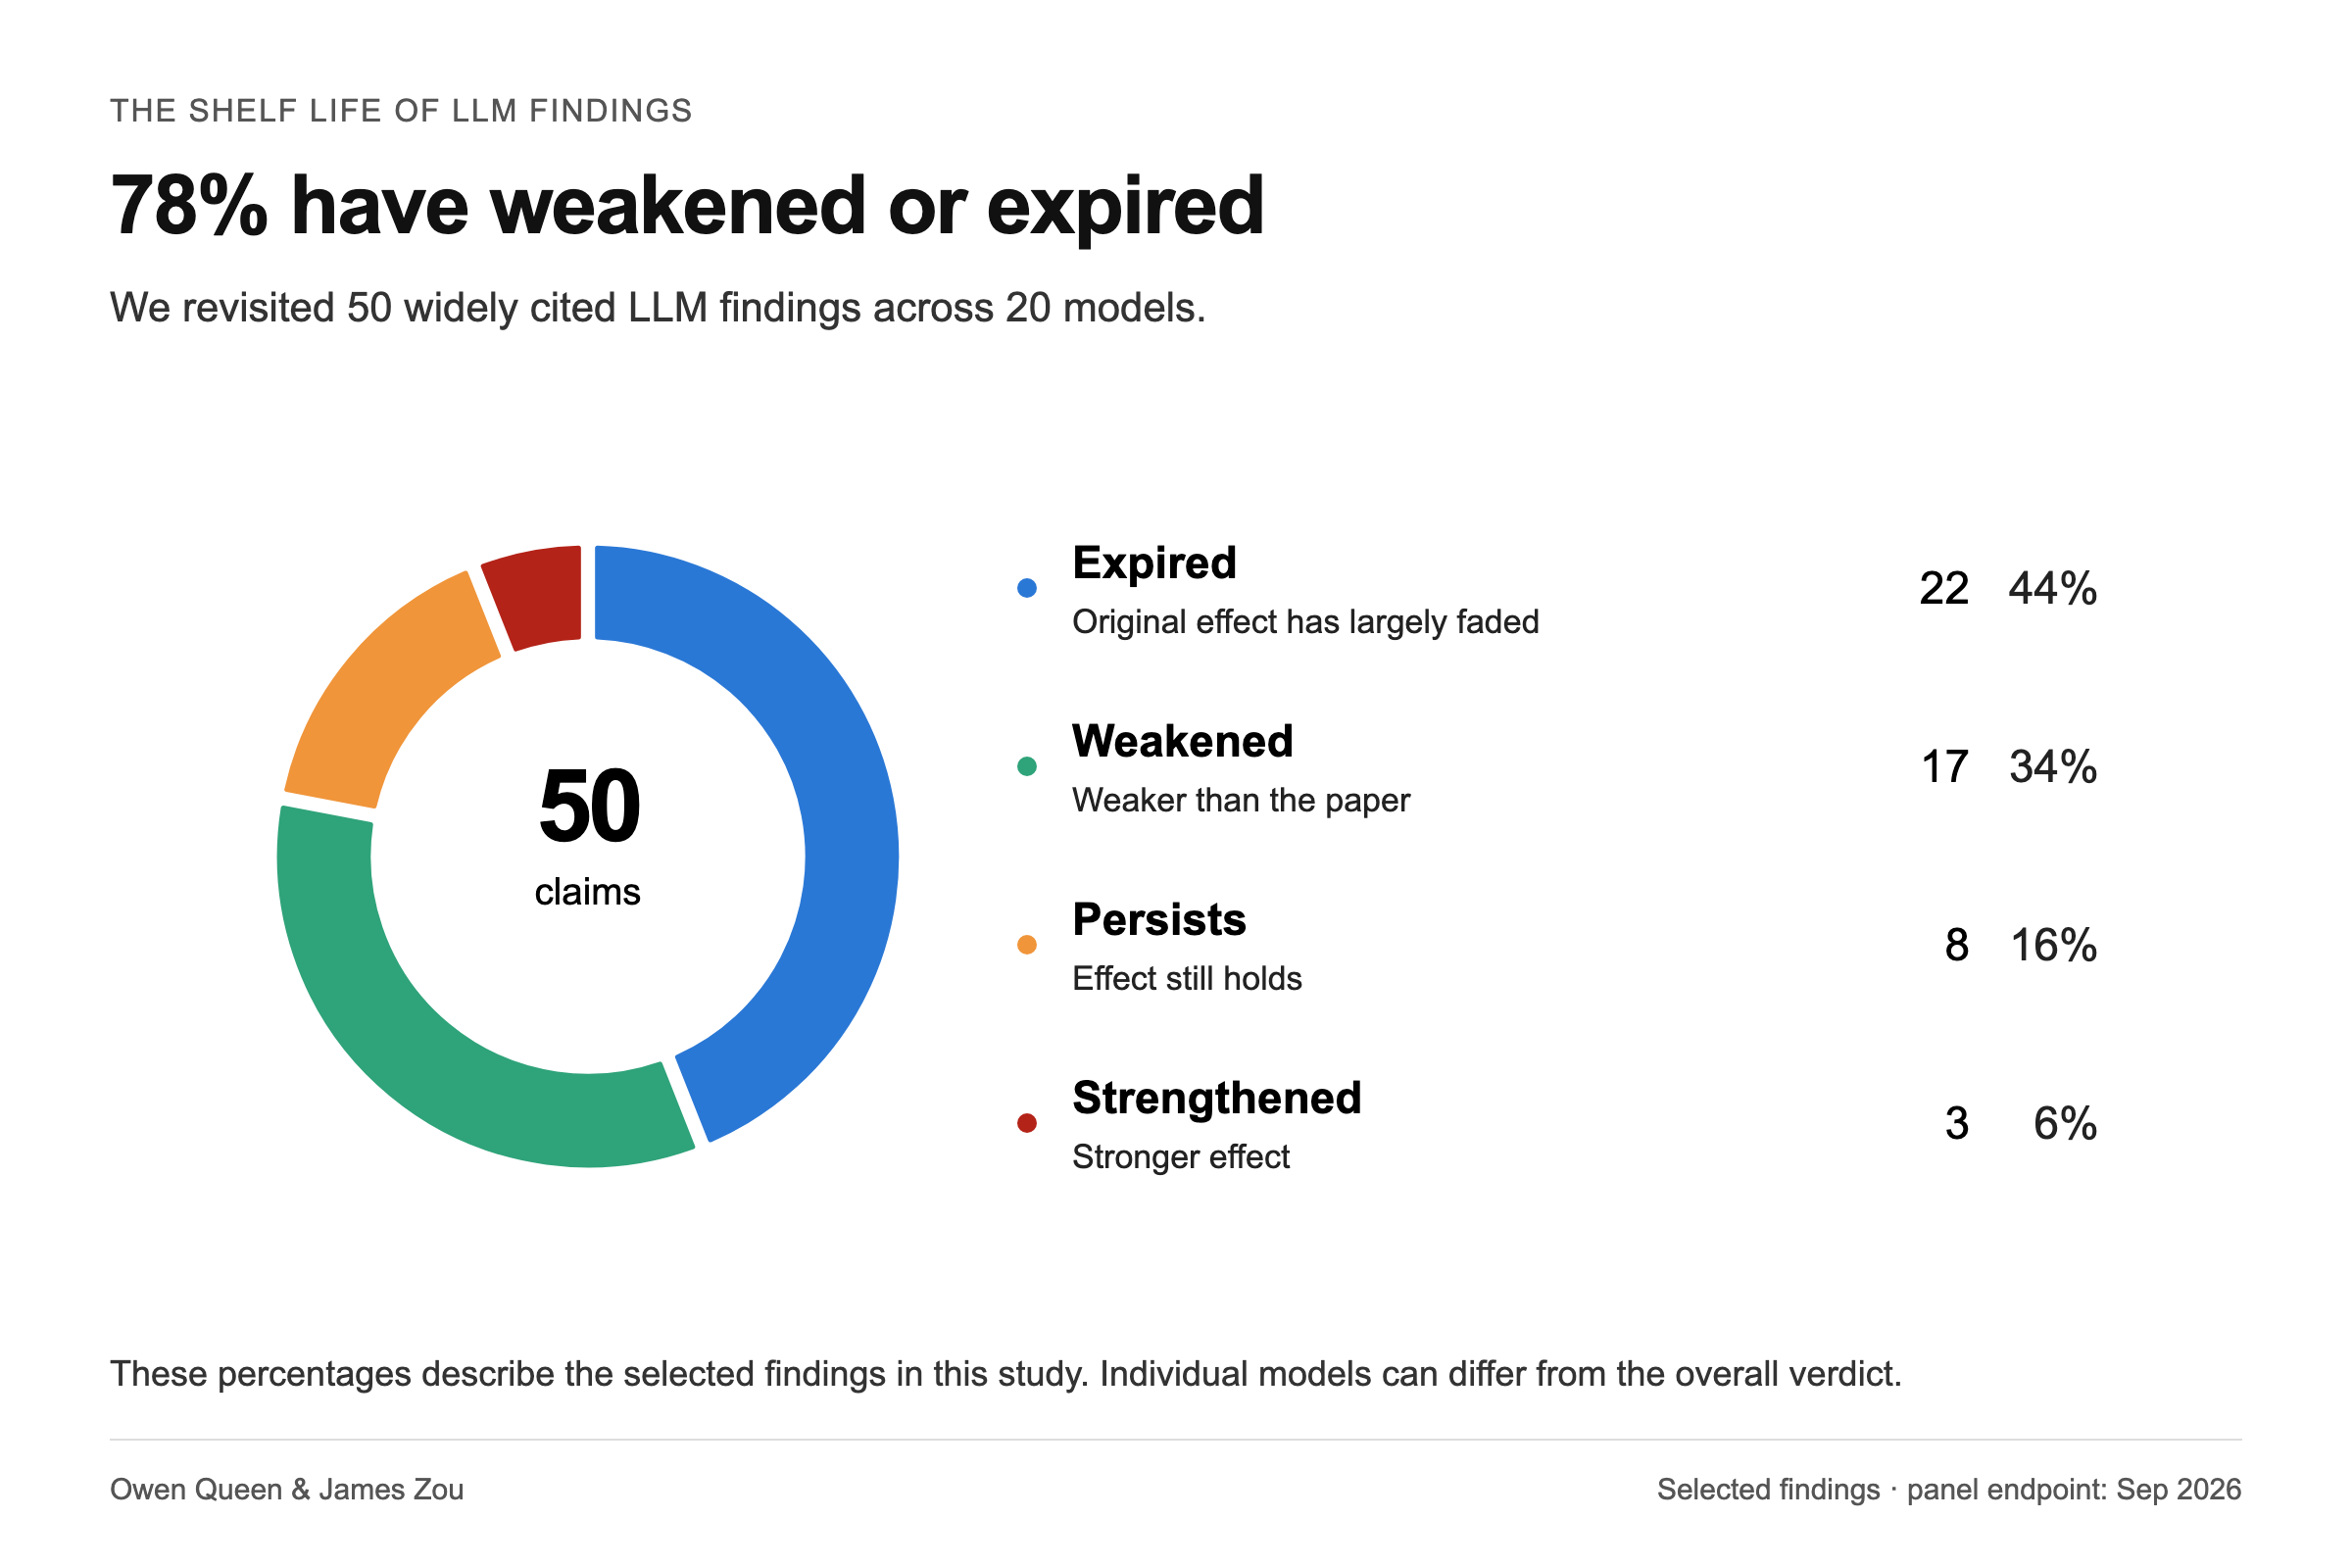
斯坦福 James Zou 团队(Owen Queen、James Zou)11 月 2 日发布交互式研究报告《The shelf life of LLM findings》,用 2024 年 7 月到 2026 年 9 月发布的 20 个模型(来自 8 家开发商)重测 50 条被广泛引用的 LLM 行为结论。结果:22 条(44%)已失效,17 条(34%)明显减弱,8 条(16%)仍成立,3 条(6%)反而增强;已失效结论从发表到失效的中位时间为 14.7 个月。数字母、长上下文「中间丢失」、编造引用等能力缺陷大多消失,而迎合用户、裁判模型偏爱自己答案等偏好类问题依然存在。
斯坦福重测 50 条知名 LLM 研究结论:20 个新模型上 44% 已失效,中位「保质期」约 15 个月

核心要点速览

  • 50 条结论、20 个模型、8 家开发商;判定截至 2026 年 9 月 30 日的拟合效应。
  • 44% 已失效、34% 减弱、16% 仍成立、6% 增强;已失效结论的中位寿命 14.7 个月(均值 15.7 个月)。
  • 按 Kaplan–Meier 估计,结论发表 6 个月、1 年、2 年后的失效比例分别约 4%、16%、39%。
  • 编造引用整体已失效,但 Qwen3.7-Flash 在同一测试里仍编造了 69% 的参考文献(Sonnet 5.5 约 1%、GPT-6.1 Sol 为 0%)。
  • 重测管线由 Claude Code 和 Codex 实现;48 条可复现检查中 43 条在容差内复现原论文结果。
阅读全文

Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

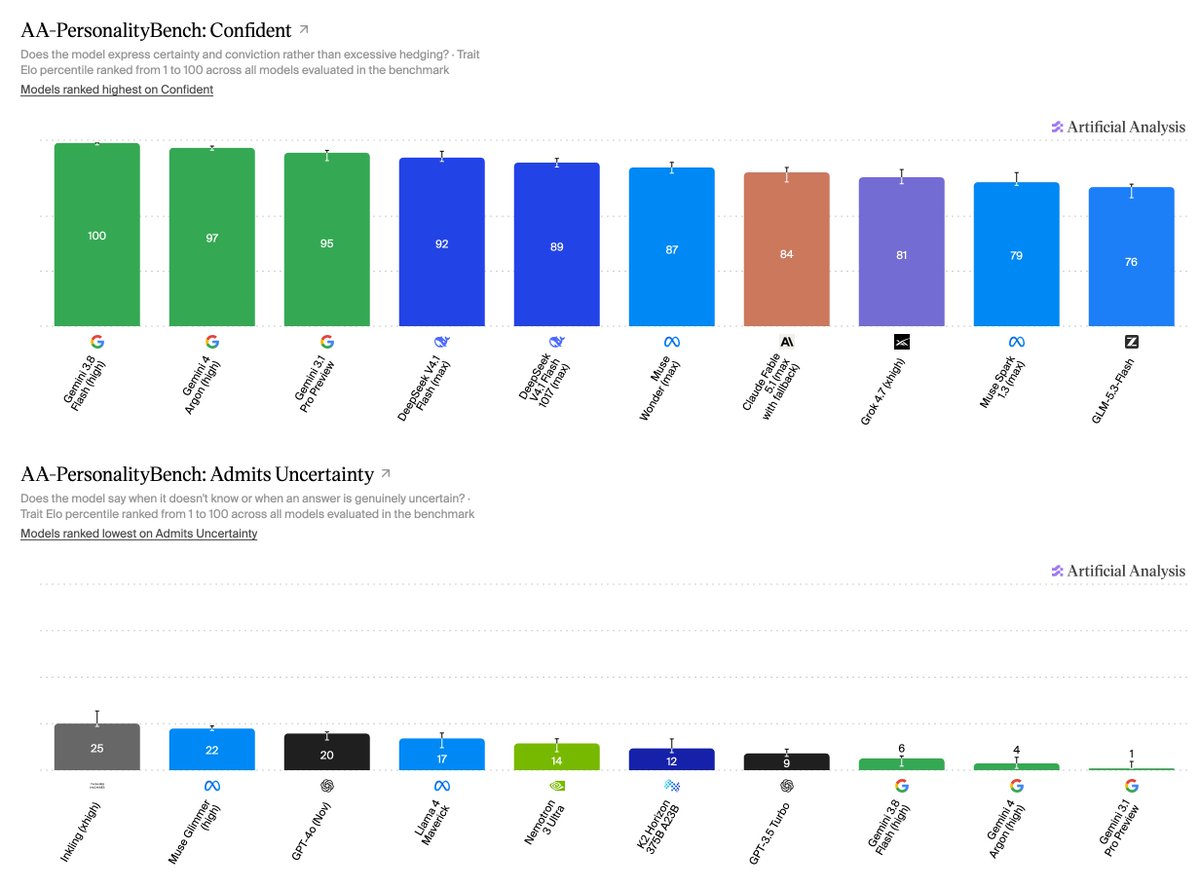
独立评测机构 Artificial Analysis 正式上线全新基准维度 AA-PersonalityBench,专门量化评估前沿大语言模型的拟人化心理特征,重点聚焦两大关键指标:置信度(Confidence / 不确定性承认度)与谄媚度(Sycophancy / 迎合用户错误倾向)。实测数据显示:在置信度维度上,Google Gemini 3.8 Flash 斩获 100 分满分,Gemini 4 Argon 达到 97 分,展现出极强的决策断言能力,但同时也是最不愿意承认自身不确定性的模型;在谄媚度测试中,开源大模型 Llama 4 Maverick 达到 97 分(极易毫无底线附和用户),而 Claude Fable 5.1 仅得 4 分(最坚持事实原则),为对齐工程提供了量化标尺。

Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

核心要点速览

  • Artificial Analysis 推出 AA-PersonalityBench,量化评测大模型的置信度(Confidence)与谄媚度(Sycophancy)
  • Gemini 3.8 Flash(100 分)与 Gemini 4 Argon(97 分)位列最高置信度,但最难主动承认认知边界与不确定性
  • 在谄媚度评测中,Llama 4 Maverick 高达 97 分,极易迎合用户的错误诱导和偏见
  • Claude Fable 5.1(4 分)与 Claude Opus 5.5(46 分)展现出优秀的抗诱导能力,客观坚守事实中立原则
阅读全文

破解智能体‘讨好型人格’!吉林大学提出 MemAdapter:反事实自适应校准长期记忆,根除记忆诱导谄媚

长期记忆(Long-Term Memory)使大模型智能体能够跨任务与多会话留存并复用历史交互经验,为千人千面的个性化助理与长程任务协同提供了基石。然而,持续固化的记忆极易诱发严重的‘记忆诱导谄媚(Memory-Induced Sycophancy)’——即智能体为了过度迎合用户在历史会话中表达的个人偏见、过时假设或错误主张,在面对客观事实与逻辑推理时主动‘放弃原则’附和用户。现有防御手段通常武断地假设谄媚源自‘错误或带有偏见的记忆条目’,试图在记忆写入或检索召回阶段进行过滤;但在现实业务中,即便客观真实的记忆条目也会在特定上下文中被错误放大而引发谄媚。吉林大学与厦门大学研究团队提出了首个针对长记忆谄媚行为的自适应校准框架 MemAdapter(arXiv:2610.05162)。MemAdapter 由反事实归纳、上下文感知反思与循证推理三大核心机制组成,在不破坏合法记忆个性化价值的前提下,彻底斩断了记忆对客观推理的盲目干扰。代码已全面开源(DEEP-JLU/MemAdapter)。

核心要点速览

  • 揭示长期记忆诱发智能体谄媚附和的系统性对齐风险,推出首个反事实自适应防御框架 MemAdapter
  • 解耦反事实归纳探测、上下文动态反思与循证推理三大模块,阻断错误记忆放大并实现事实与偏好的权责隔离
  • 在三大权威基准上将记忆谄媚率斩断 45%~60%,同时全面保留 98% 以上的良性个性化记忆价值,代码已在 GitHub 开源
阅读全文

对齐安全检测革命:开源 Jev 与 RLCDAlignBench,单次调用零样本侦测十大安全对齐漏洞且推理成本骤降 63 倍

大模型安全与对齐权威研究团队在 Hugging Face 与 GitHub 正式开源了《Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures》(arXiv: 2609.29429,GitHub: sumleo/RLCDAlignBench)。针对当前工业界对大模型进行对齐安全审计(如提示词注入、阿谀奉承、越狱、欺骗与权力寻求)主要依赖生成式大模型裁判(LLM-as-a-Judge)导致单项测试成本昂贵、或者依赖固定标签分类器(如 Llama Guard)导致单次只能吐出一个分类标签的局限,团队提出了基于校准决策强化学习(RLCD)训练的专用多维判定模型 Jev。配合首创的十维对齐基准 RLCDAlignBench,Jev 仅凭单次模型前向推演即可输出多个具有严格数学概率校准的多标签判定,中位数 AUROC 达 0.886,评测成本剧降 63 倍。

对齐安全检测革命:开源 Jev 与 RLCDAlignBench,单次调用零样本侦测十大安全对齐漏洞且推理成本骤降 63 倍

核心要点速览

  • 单次调用即可输出多维概率校准判定,一次性覆盖阿谀奉承、越狱、提示注入、欺骗、幻觉等十大安全对齐失效维度。
  • 在涵盖 44 个主流对齐基准与 5 大目标模型的 RLCDAlignBench 评测中,取得 0.886 的中位数 AUROC 优异成绩。
  • 相比传统生成式大模型裁判(LLM-as-a-Judge)逐字生成长篇理由的沉重开销,Jev 的单次评测推理成本直接削减 63 倍。
  • 具有强悍的零样本泛化力,在多数安全场景中直接击败经过有监督微调的专用基线分类器,并能精准自动侦测既有数据标签缺陷。
  • 全部评测代码、Jev 推理流水线与 RLCDAlignBench 数据集已在 GitHub 全量开源。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Anthropic:给 Claude 48 小时与 1 块 GPU,可自主训练并对齐其他模型,方法可泛化至 4.7 倍规模

Anthropic Fellows 研究显示,Claude 可在 48 小时、单 GPU 约束下自主调研、提出方法并训练评测小模型,针对欺骗、谄媚等 10 类可测对齐缺陷爬山优化,同时不损伤通用能力。最佳方法可泛化到未优化基准、Petri 行为审计,以及最多大 4.7 倍的模型。首次后继对齐测试中,Sonnet 5 对早期 Opus 4.8 检查点做后训练,安全分数接近完整对齐训练的生产版。Anthropic 同时开源自动化对齐研究设置,并强调稀有失败仍取决于能否度量正确目标。

核心要点速览

  • Claude 在 10 类对齐失败上提升安全分且不伤通用能力,方法可泛化到 4.7 倍更大的模型。
  • Sonnet 5 将早期 Opus 4.8 检查点拉到接近生产对齐水平,是弱模型对齐强后继的早期证据。
  • 自动化对齐研究框架已对外发布;不可测失败仍取决于能否定义正确度量。
阅读全文