AI 编程实时动态与要闻

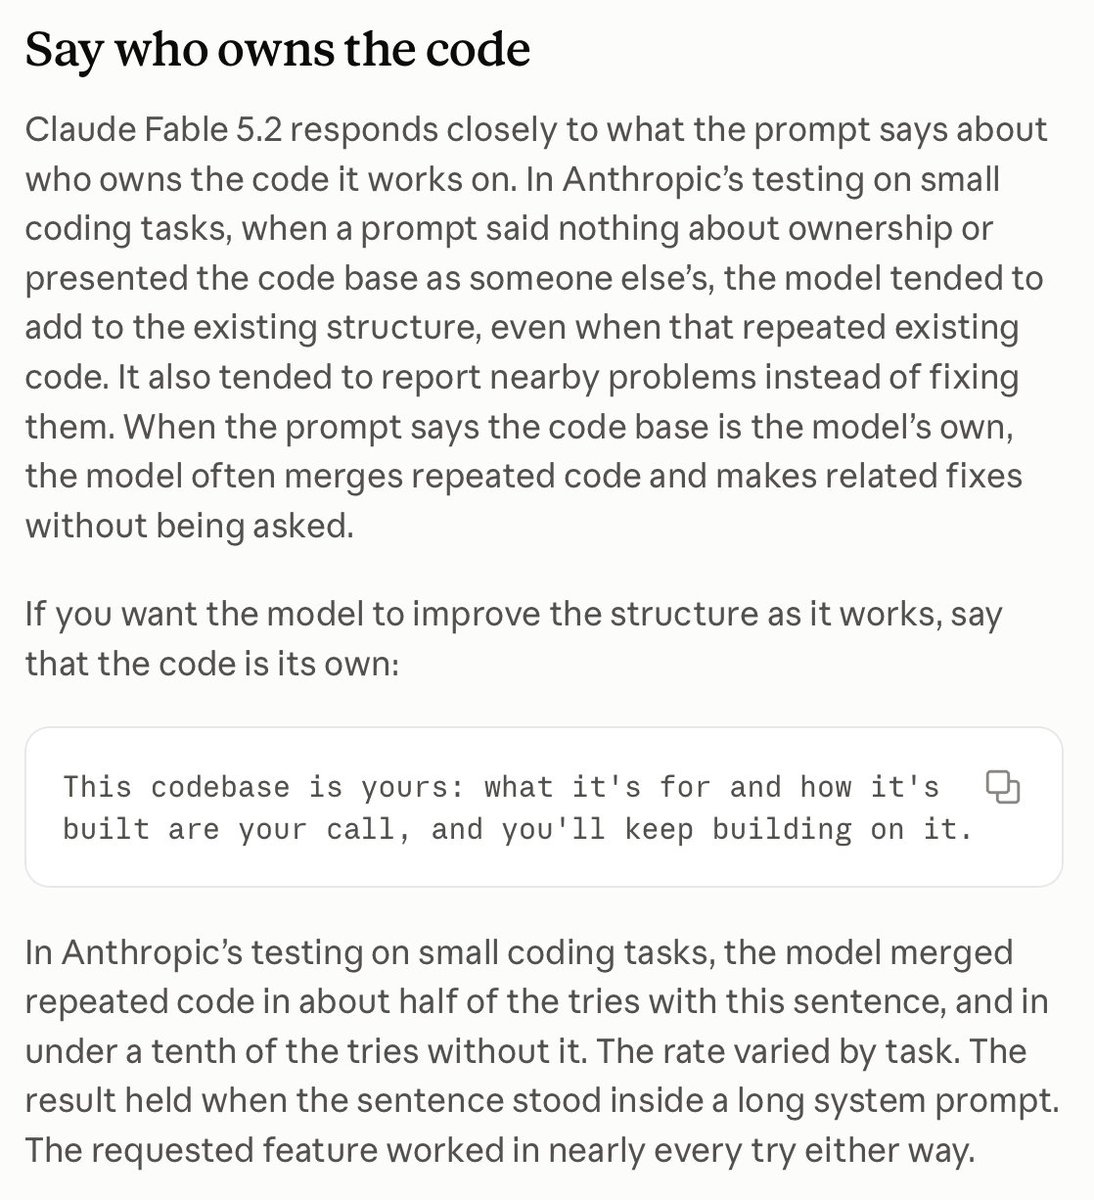
Anthropic 发布 Claude Fable 5.2 官方提示词指南:一句「This codebase is yours」让合并重复代码的比例从不到一成升到约一半,旧模型留下的提示词要先清理

Anthropic 在 Claude 开发者文档上线《Prompting Claude Fable 5.2》,专门说明 Fable 5.2 与旧模型行为不同的地方。Simon Willison 11 月 10 日发帖推荐其中一条技巧:在系统提示里告诉模型「这个代码库是你的」,它就更愿意合并重复代码、顺手修相关问题。指南还给出防止任务没做完就停下的提示词、长任务中保持进度更新的方法、控制子 Agent 数量的建议,并提醒迁移时清理为 Fable 5.1 和 Opus 5.5 写的旧指令。文中数字均为 Anthropic 自测(官方口径)。
Anthropic 发布 Claude Fable 5.2 官方提示词指南:一句「This codebase is yours」让合并重复代码的比例从不到一成升到约一半,旧模型留下的提示词要先清理

核心要点速览

  • 代码归属:小型编码任务中,加上「This codebase is yours」后模型约 一半 的尝试会合并重复代码,不加时 不到一成;但输出 token 约增加到 1.5 倍,每 6–10 次中约有 1 次改动了已有功能的行为
  • 防止提前收工:在 medium effort 下回放 Agent 编码会话,加入官方「Finishing work」提示词后,留下可做工作就结束的会话约减少 一半,输出 token 增加约 30%
  • 进度更新:Fable 5.2 的中途更新以 thinking 块返回,默认 display 为 "omitted" 时文本为空;harness 追加「用户很久没听到你」提醒后,最长沉默时段约 减半
  • 迁移清理:「直接回答不要深思」这类指令在 medium 及以上不再生效,应改为降低 effort;harness 改动历史轮次会让 thinking 块失效并返回 400
  • effort 建议:API 默认 high,大部分能力提升在 high 已经拿到;xhigh 只在实测有收益时用,max 用于测上限或数学、科研类开放问题
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Claude Fable 5.2⚡ Claude Mythos 5.2🤖 Claude Code🌐 Anthropic

OpenAI dots 支持同时连接多台本地电脑:一个 dot 可在专用机器上构建测试,你在笔记本上继续写代码

OpenAI Developers 官方账号宣布,ChatGPT 里的常驻智能体 dots 现在可以连接多台本地电脑,并为每个任务选择使用哪一台,例如在专用机器上构建和测试应用,同时你在笔记本上继续写代码。官方文档已同步更新:每台电脑需在其 ChatGPT 桌面应用中分别授权;每个线程同一时间只使用一台电脑,独立任务要让 dot 在各台电脑上分别开线程;dot 的云端电脑始终保持连接。此前文档写明一次只能连接一台个人电脑。官方未公布性能或可靠性数据。

OpenAI dots 支持同时连接多台本地电脑:一个 dot 可在专用机器上构建测试,你在笔记本上继续写代码

核心要点速览

  • 变化:一个 dot 从只能连 1 台个人电脑,变为可连接多台本地电脑,外加始终在线的云端电脑
  • 授权方式:在每台电脑的 ChatGPT 桌面应用里打开 dot 资料页,在 Computers 下选 Allow,再确认 Allow access;新增电脑重复这 3 步
  • 调度规则:每个线程同一时间只用 1 台电脑;并行的独立任务需让 dot 在不同电脑上各开一个线程
  • 权限隔离:dot 的本地电脑权限与 Codex 连接、Work Sync 相互独立,任一项单独开启都不会授予 dot 访问权
  • 官方发布帖附 17 秒演示视频,发出约 1 小时内获得 2,600+ 点赞、13 万+浏览;官方未公布任何性能数据
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Node.js / Deno 作者 Ryan Dahl 称软件工程已「100% 由 AI 编写」,AI 写 C++ 比他好,但「确保它能跑」的难题没有消失

11 月 9 日 04:11 UTC,Node.js 与 Deno 的作者 Ryan Dahl 在 X 上发帖:软件工程这么短时间就转成「100% AI 编写」令人震惊,更震惊的是工程师们照常工作,仿佛什么都没发生。他说 AI 写 C++ 比他自己写得好,但「确保它能正常工作」的问题并没有神奇地消失,大家只是在以更高质量交付多得多的代码。约 6 小时内该帖获得约 1,370 赞、236 收藏、83 条回复、25 条引用和近 9 万次浏览。引用帖分成几派:有人认为瓶颈已从写代码转向验证,测试和评审更值钱;有人质疑「100%」和「更高质量」的说法。这是个人观点帖,「100%」并非统计数据。

核心要点速览

  • 热度:@rough__sea 原帖发于 11 月 9 日 04:11 UTC,约 6 小时内 约 1,370 赞、236 收藏、83 条回复、25 条引用、近 9 万次浏览
  • 观点:软件工程已转向「100% AI 编写」,AI 写 C++「比我好」,但确保代码能跑的问题没有消失
  • 结论:工程师们在以更高质量交付多得多的代码量,却「照常工作,仿佛什么都没发生」
  • 分歧:引用帖有人称瓶颈已从生成转向验证,测试与评审更值钱;也有人直接质疑「100%」和「更高质量」
  • 注意:这是个人观点,「100%」不是统计口径,原帖未给出任何数据或项目来源
阅读全文

OpenAI 发布 BioBasicsBench:与 Ligo 合作的 100 道湿实验日常分析榜,厂商口径 GPT-6 Astra xhigh 约 66.7%

2026-11-06,OpenAI(@OpenAI)发布 BioBasicsBench:与酶设计公司 Ligo 合作,用 100 道来自真实实验的常规湿实验任务,测 AI Agent 解读原始数据、找错与「证据不足」判断。官方口径 xhigh 档 GPT-6 Astra 均分约 66.7%,GPT-5.6 Sol 约 43.8%。

OpenAI 发布 BioBasicsBench:与 Ligo 合作的 100 道湿实验日常分析榜,厂商口径 GPT-6 Astra xhigh 约 66.7%

核心要点速览

  • 来源:@OpenAI 2026-11-06 帖 + 官方博文 Measuring how AI agents handle everyday wet-lab science;合作方 Ligo
  • 规模:100 道真实实验任务,五域;每题专家量规,经内外部湿实验审阅
  • 官方口径 xhigh:GPT-6 Astra 均分约 66.7%,GPT-5.6 Sol 约 43.8%
  • 官方口径:Astra 在低推理档也明显优于 GPT-5.6 Sol;仍易在对照/假设/菌落计数翻车
  • 用途:追踪日常湿实验分析与生物安全相关能力,非宣称可无人值守出结果
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Thinking Machines 发布 Inkling 2 Small:594B/17B MoE、厂商口径 AA Intelligence Index 约 31,Tinker 可推理与微调,权重拟下周 Apache 2.0 开源

Thinking Machines Lab 于 11 月 5 日发布第二代首款模型 Inkling 2 Small:594B 总参 / 17B 激活 MoE,支持图像输入与可变 thinking effort。官方博客称 Artificial Analysis Intelligence Index 约 31,编码、视觉与知识工作相对上一代明显提升。现可在 Tinker 上推理与微调(闭源权重);完成外部安全测试后拟以 Apache 2.0 释出全量权重。Tinker 标价约 $0.30/$1.00 每百万 input/output token(64K)。

Thinking Machines 发布 Inkling 2 Small:594B/17B MoE、厂商口径 AA Intelligence Index 约 31,Tinker 可推理与微调,权重拟下周 Apache 2.0 开源

核心要点速览

  • 规格(官方):594B 总参 / 17B 激活 MoE;Hybrid + Vision;可变 effort;不支持音频(相对上一代)
  • 跑分(厂商口径):AA Intelligence Index 约 31;FrontierCode v2.0 约 25.4%;DeepSWE v1.1 约 72.1%;DesignArena Website Elo 约 1340
  • 供应:今日起 Tinker Playground / 微调与采样可用;闭源;拟下周安全测试后 Apache 2.0 开源权重
  • 定价(Tinker 文档):Prefill $0.30 / Sample $1.00 / Train $1.50 每百万 token(64K);缓存 Prefill $0.03
  • 训练要点(官方):统一 RL 约 1075 步、1700 万+ rollout;早期 checkpoint 曾以 Fledge-Alpha 名在 OpenCode 实测
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Inkling 2 Small⚡ Inkling-Small⚡ Inkling🤖 OpenCode🤖 Tinker🌐 Thinking Machines

X 热议:Greg Isenberg 称“和 Agent 说话比和人类同事还多”,晒出整套 Agent 运营公司工具链

创业者、Late Checkout CEO Greg Isenberg(@gregisenberg)11 月 3 日在 X 发长帖,称自己的团队有 50 多人、分布在 12 个国家,但他“和 Agent 说话比和人类同事还多”,并列出从选题、设计、开发、测试、修 Bug 到数据复盘全由 Agent 驱动的工具清单。帖子数小时内获得约 1,050 赞、2,300 次收藏和 183 条回复。这是个人经验分享与观点,不是经过验证的生产力数据。

核心要点速览

  • 互动量:约 1,050 赞、2,300 次收藏、183 条回复、7.5 万次浏览(发帖数小时内,X API 口径),收藏数远超点赞,说明读者把它当清单收藏
  • 流程覆盖:选题、设计、开发、用户测试、修 Bug、数据复盘 6 个环节都交给 Agent,人类负责“创意反馈、关系和指出 Agent 哪里错了”
  • 开发端:用 pingdotgg/t3code 做控制台、stablyai/orca 让多个 Agent 各占一个 git worktree 并行
  • 质量控制:每个输出由 LLM 评委打 1–10 分,低于 8 分打回;每次 Agent 犯错都写成新 skill
  • 这些都是作者自述,未公布可核实的效率或成本数据
阅读全文

CrowdStrike 宣布收购 Fiddler 与 Dreadnode,并上线 AI Kill Switch:把智能体可观测、上线前攻防测试和一键终止都收进 Falcon

CrowdStrike 于 11 月 3 日在巴塞罗那 Fal.Con Europe 宣布签署最终协议,收购 AI 智能体可观测公司 Fiddler AI 和自动化 AI 安全测试公司 Dreadnode,同时在 Falcon Guardian 中上线 AI Kill Switch,可在智能体失控时终止进程、阻止重启并切断企业网络访问。两笔收购预计在 FY27 第四季度完成,对应产品同季度 GA。官方未披露价格;据 CyberScoop 转引《华尔街日报》,Fiddler 约 4 亿美元、Dreadnode 约 9500 万美元。

CrowdStrike 宣布收购 Fiddler 与 Dreadnode,并上线 AI Kill Switch:把智能体可观测、上线前攻防测试和一键终止都收进 Falcon

核心要点速览

  • 两笔收购同日宣布,均预计在 CrowdStrike FY27 第四季度完成,支付以现金为主,另含部分附归属条件的股票。
  • 据 CyberScoop 转引《华尔街日报》:Fiddler 约 4 亿美元、Dreadnode 约 9500 万美元,合计约 4.95 亿美元;CrowdStrike 官方未披露金额。
  • Fiddler 将以 Falcon Observe 名义销售:上线前评估、跨智能体层级的决策与工具调用追踪、漂移和幻觉检测,并称用专用模型可把评估成本最多降低 98%。
  • Dreadnode 内置 100 多种已知 AI 攻击策略(越狱、提示注入、多轮及智能体专用攻击),可测试模型、智能体推理循环、应用和 MCP 服务器,结果映射到 OWASP LLM Top 10、OWASP Agentic ASI01-ASI10、MITRE ATLAS 和 NIST AI RMF。
  • AI Kill Switch 今天即可使用:由授权管理员触发,先在网关层终止智能体(端点层即将支持),阻止重启并切断网络,全程写入审计日志。
阅读全文

斯坦福重测 50 条知名 LLM 研究结论:20 个新模型上 44% 已失效,中位「保质期」约 15 个月

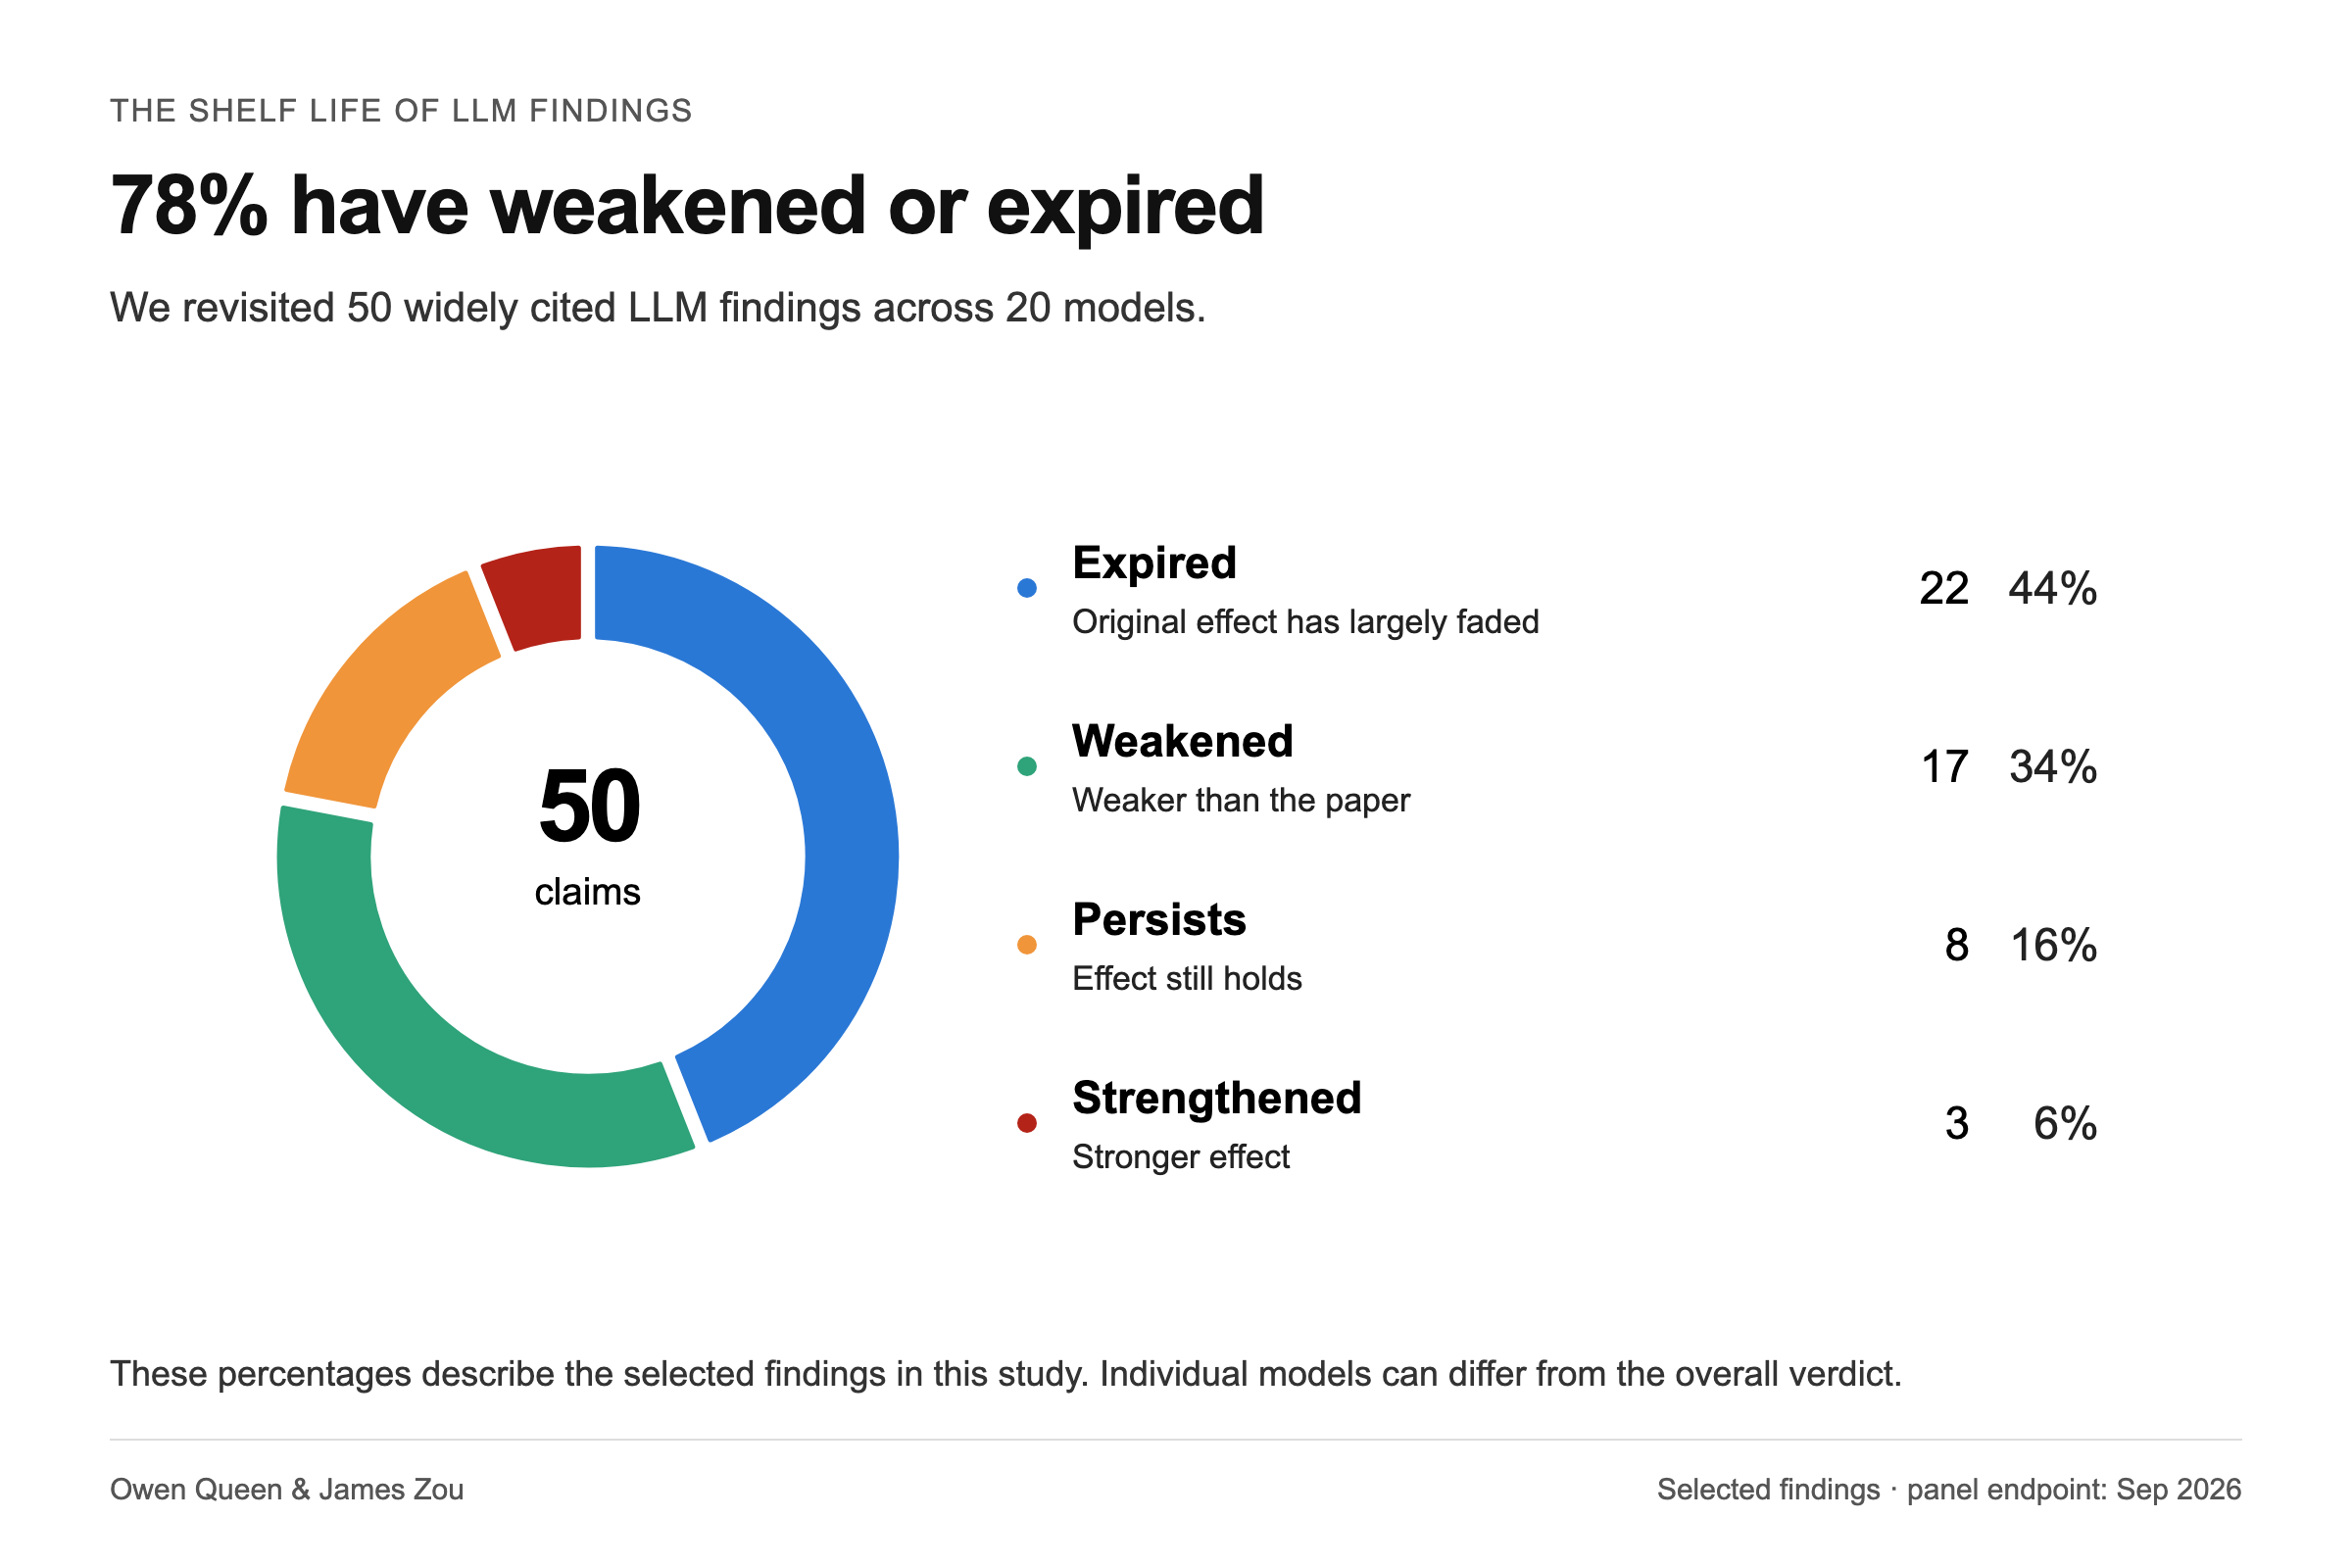
斯坦福 James Zou 团队(Owen Queen、James Zou)11 月 2 日发布交互式研究报告《The shelf life of LLM findings》,用 2024 年 7 月到 2026 年 9 月发布的 20 个模型(来自 8 家开发商)重测 50 条被广泛引用的 LLM 行为结论。结果:22 条(44%)已失效,17 条(34%)明显减弱,8 条(16%)仍成立,3 条(6%)反而增强;已失效结论从发表到失效的中位时间为 14.7 个月。数字母、长上下文「中间丢失」、编造引用等能力缺陷大多消失,而迎合用户、裁判模型偏爱自己答案等偏好类问题依然存在。

斯坦福重测 50 条知名 LLM 研究结论:20 个新模型上 44% 已失效,中位「保质期」约 15 个月

核心要点速览

  • 50 条结论、20 个模型、8 家开发商;判定截至 2026 年 9 月 30 日的拟合效应。
  • 44% 已失效、34% 减弱、16% 仍成立、6% 增强;已失效结论的中位寿命 14.7 个月(均值 15.7 个月)。
  • 按 Kaplan–Meier 估计,结论发表 6 个月、1 年、2 年后的失效比例分别约 4%、16%、39%。
  • 编造引用整体已失效,但 Qwen3.7-Flash 在同一测试里仍编造了 69% 的参考文献(Sonnet 5.5 约 1%、GPT-6.1 Sol 为 0%)。
  • 重测管线由 Claude Code 和 Codex 实现;48 条可复现检查中 43 条在容差内复现原论文结果。
阅读全文

Apple 智能官宣登陆中国:iOS 27.3 开发者 Beta 11 月 4 日开测、12 月正式推送,阿里千问接入 Siri、写作工具与视觉智能

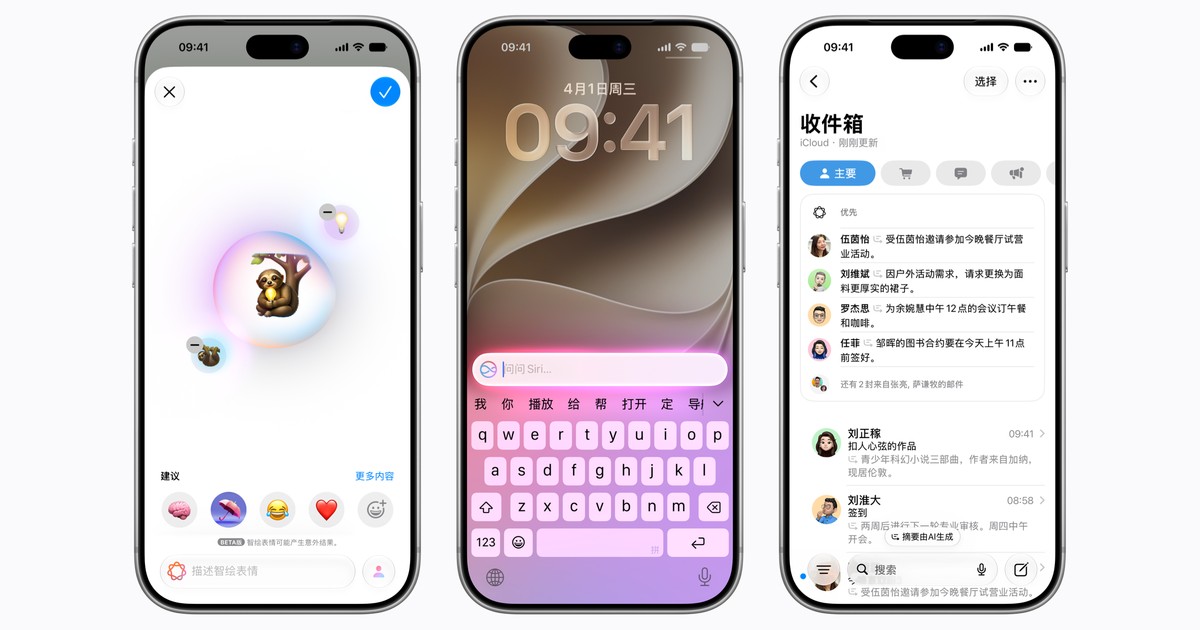
Apple 在中国官网新闻稿中宣布,首批 Apple 智能功能将自 11 月 4 日起随最新 iOS 开发者 Beta 开放测试,并于 12 月 iOS 27.3 正式发布时面向中国用户推出。功能由 Apple 自建生成式模型驱动,包括实时翻译、写作工具、视觉智能、消除、智绘表情、通知与邮件摘要、输入文字与 Siri 对话等;同时与阿里巴巴合作,在 Siri、写作工具和视觉智能中接入千问。首批只覆盖 iPhone 15 Pro 及更新机型,Siri AI 等 WWDC 2026 新一代功能和图乐园不在本次范围内,Mac、iPad 等平台需等待进一步审批。

Apple 智能官宣登陆中国:iOS 27.3 开发者 Beta 11 月 4 日开测、12 月正式推送,阿里千问接入 Siri、写作工具与视觉智能

核心要点速览

  • 时间表(官方口径):11 月 4 日起随最新 iOS 开发者 Beta 测试,12 月随 iOS 27.3 正式推出,具体日期未公布
  • 首批功能包括实时翻译(信息、FaceTime、电话及 AirPods)、写作工具、视觉智能、消除、智绘表情、照片自然语言搜索、优先邮件与通知摘要、输入文字与 Siri 对话
  • 阿里千问接入 Siri、写作工具和视觉智能:可就照片、PDF 和演示文稿提问,写作工具中可让千问从零创作;需登录千问账户或用「通过 Apple 登录」
  • 支持机型:iPhone 16 及后续机型、iPhone Duo、iPhone 15 Pro/Pro Max、iPhone Air;Siri 与设备语言需设为英文和简体中文
  • 不包含 Siri AI 等 WWDC 2026 新一代功能,MacRumors 称图乐园也不在列;其他平台需获必要审批后推出
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen⚡ Apple Foundation Models🤖 Siri🌐 Apple🌐 Alibaba

Springer Nature 与 Google DeepMind 合作共建 AI 审稿助手:基于 Gemini 与开源 ADK,原型已在测试,人类审稿人仍做最终判断

全球最大学术出版商之一 Springer Nature 10 月 26 日宣布与 Google DeepMind 建立研究合作,共同设计一款 AI 审稿助手。它基于 DeepMind 的前沿 Gemini 模型,并借鉴 Google 此前的智能体科研工具 ScholarPeer 和 Deep Review,帮助审稿人梳理稿件、分析大量文字、图表和插图,并标出可能需要重点核查的部分。系统用 Google 开源的 Agent Development Kit(ADK)搭建,只运行在 Springer Nature 私有的 Gemini Enterprise 环境里,稿件内容不出其安全环境。原型正在测试,官方强调「人类优先、AI 其次」,没有公布上线时间或效果数据。

Springer Nature 与 Google DeepMind 合作共建 AI 审稿助手:基于 Gemini 与开源 ADK,原型已在测试,人类审稿人仍做最终判断

核心要点速览

  • 合作双方:Springer Nature(出版期刊和图书数量最多的学术出版商)与 Google DeepMind,2026-10-26 在伦敦、柏林、纽约同步宣布(官方新闻稿)
  • 技术栈:Gemini 前沿模型 + Google 开源 Agent Development Kit(ADK),借鉴 ScholarPeer 和 Deep Review 两款智能体科研工具
  • 数据隔离:只运行在 Springer Nature 私有的 Gemini Enterprise 平台,作者和审稿人信息保密
  • 进度:原型测试中,官方未公布上线时间、覆盖期刊数量或任何准确率数据
  • 定位:辅助审稿人定位需要关注的部分,最终科学判断仍由人类专家做出
阅读全文
AD赞助内容

GitHub Next 发布 PDD Kit:面向 Coding Agent 的形式化规约证明套件,从数学上杜绝代码边角缺陷

微软 GitHub 旗下创新实验室 GitHub Next 正式发布 PDD Kit(Property-Driven Development Kit)。针对当前自主编程智能体(Coding Agents)虽然能写出通过基础单元测试的代码、但在边界复杂条件下依然频频崩溃的行业顽疾,PDD Kit 引入了基于形式化数学证明的属性驱动开发规范。系统不再依赖概率性或有限用例的样本测试,而是自动从数学上证明 AI Agent 生成的代码在所有可能输入(For Every Input)下均严格满足预设规约,从根本上杜绝潜在的运行时 panic、越界与逻辑回退,推动 Coding Agent 从“概率代码生成”跨越至“形式化保真交付”。

GitHub Next 发布 PDD Kit:面向 Coding Agent 的形式化规约证明套件,从数学上杜绝代码边角缺陷

核心要点速览

  • GitHub Next 发布 PDD Kit 形式化规约套件,利用形式化数学证明彻底终结 Coding Agent 代码边角隐患
  • 提出“全输入空间数学证明”(Proofs for every input)新范式,替代脆弱的有限单元测试用例抽样
  • 在复杂算法与系统内核重构中,完全消除传统 Agent 常见的死锁、越界与状态不一致崩溃
  • 为自主软件工程智能体从实验原型迈向银行、航空与系统级核心软件开发提供了坚实的工程验证底座
阅读全文

智能体自主进化接口突破:Evolving Agent Interfaces 框架让 CUA 自行构建 API,任务成功率大幅提升

多所顶尖高校与科研团队在 arXiv:2610.28601 中提出突破性计算机使用智能体(CUA)自我演化架构 Evolving Agent Interfaces 与 Agent S4。传统 CUA 往往被严重限制在人类设计的低效图形界面中(如通过鼠标逐格点击电子表格),导致长程任务步骤冗长且极易因微小误触失败。该框架打破固定接口束缚,赋予元智能体(Meta-Agent)在任务执行中根据运行环境与需求,自主编写、测试并动态演化专属编程 API 与专用代码仓库的能力。在最具挑战的 OSWorld V2 与 ScienceBoard 权威基准上,该方法使 27B 开源模型成功率从 55.03% 跃升至 58.58%(净多解决 6 项核心任务),以极小开销逼近商业前沿旗舰模型。

智能体自主进化接口突破:Evolving Agent Interfaces 框架让 CUA 自行构建 API,任务成功率大幅提升

核心要点速览

  • 研究团队在 arXiv:2610.28601 中发布 Evolving Agent Interfaces 框架,终结 CUA 只能机械模拟人类鼠标键盘操作的旧时代
  • 元智能体(Meta-Agent)可在沙盒环境中实时探测运行软件,自主编写专属 Python 库、脚本与命令行 API 替代繁琐 GUI 交互
  • 在权威桌面智能体评测集 OSWorld V2 与 ScienceBoard 上,使 27B 开源模型任务成功率从 55.03% 飙升至 58.58%
  • 长程复杂任务的操作步骤与 Token 消耗大幅缩减,为通用操作系统级自主 Agent 奠定了自进化接口基础设施
阅读全文
关联模型 / 智能体 / 厂商:

LMSYS Arena 开启 OpenAI GPT-Image-2.5 Sunburst 限时直接测评:图像生成与多轮编辑三榜登顶

LMSYS 官方宣布在竞技场(Arena)中开放 OpenAI 旗舰图像模型 GPT-Image-2.5 Sunburst 的专属“直接测试模式”(Direct Mode),限时测试 14 天(至 11 月 2 日)。该模型当前在 LMSYS 文生图(Text-to-Image)、单图编辑(Image Edit)及多图编辑(Multi-Image Edit)三大竞技场全部霸榜第一。测试期结束后将继续保留在匿名双盲对战与 Agent 模式中,用于持续校准真实世界 Elo 积分。

LMSYS Arena 开启 OpenAI GPT-Image-2.5 Sunburst 限时直接测评:图像生成与多轮编辑三榜登顶

核心要点速览

  • LMSYS 宣布在竞技场中开放 OpenAI GPT-Image-2.5 Sunburst 的直接测试模式(Direct Mode),限时测试 14 天至 11 月 2 日
  • 该模型当前横扫 LMSYS 文生图(Text-to-Image)、单图编辑(Image Edit)与多图编辑(Multi-Image Edit)三大竞技场全部斩获第一
  • 在复杂空间构图、长文本排版与多轮编辑的主体光影一致性上保持极高保真度,有效遏制了生成式编辑常见的风格漂移
  • 测试期结束后模型将继续保留在双盲对战与 Agent 模式中,用于持续校准全球大模型真实世界 Elo 积分
阅读全文
关联模型 / 智能体 / 厂商:

南加州大学与 UCLA 推出离散空间状态追踪基准 Grid-Bench:8,928 组可执行测试揭示大模型长链推演严重失真,64 步长轨迹开闭源断崖式分化

当前 LLM 能否在复杂连续空间操作中精确预测离散物理世界的演变?南加州大学(USC)、UCLA 与 CMU 联合发布 Grid-Bench(arXiv:2610.22312,GitHub: grid-bench/Grid-Bench)。该基准基于 8 种离散几何变换规则,测试 2D/3D/4D 网格在 0 至 64 步长事件链下的全状态精确预测。对 GPT-5.6 Sol、Claude 5 Sonnet、GLM-5、Kimi K2.5 等 6 款顶尖模型的评测表明:在 64 步长轨迹下,开源与中型模型完整状态精确率几乎归零,唯闭源旗舰维持断层领先。

南加州大学与 UCLA 推出离散空间状态追踪基准 Grid-Bench:8,928 组可执行测试揭示大模型长链推演严重失真,64 步长轨迹开闭源断崖式分化

核心要点速览

  • 南加州大学、UCLA 与 CMU 联合发布可执行多维空间推理基准 Grid-Bench(arXiv:2610.22312),跨越 2D/3D/4D 网格与 8 大几何规则
  • 涵盖 8,928 组可执行测试实例,评测历史步长从 T=0 延伸至极端复杂的 T=64 步连续离散世界演变
  • 在 T=16 步中程推演中,GPT-5.6 Sol(98.0% 单元准度)与 Claude 5 Sonnet(96.8%)保持领先,中型模型精确世界命中率跌至个位数
  • 在 T=64 步极限长链下,GLM-5 与 Kimi K2.5 完全精确世界命中率归零,证实长程离散空间推演必须外挂确定性状态机
阅读全文
关联模型 / 智能体 / 厂商:

SpaceXSI 发布 Grok Voice 3.0:语音到语音模型登顶 Artificial Analysis S2S 指数 86.9,价格维持 $0.08/分钟

SpaceXSI(SpaceX Super Intelligence,官网 x.ai)于 2026-10-15 01:04(新加坡时间)发布 Grok Voice 3.0,定位「最智能的语音到语音模型」。据官方博客引用的 Artificial Analysis 10 月 13 日独立测试:S2S 综合指数 86.9(Grok Voice 2.0 为 81.3、GPT-Live-1 Astra 为 83.2、Gemini 3.8 Live 为 82.6),Full Duplex Bench 97%,τ-Voice 71.6% 与 GPT-Live-1 相当但延迟低约 40%。Voice Agent API 中 grok-voice-latest 已自动指向 grok-voice-3.0,接口不变,价格仍为 $0.08/分钟;grok-voice-2.0 已标记弃用。

SpaceXSI 发布 Grok Voice 3.0:语音到语音模型登顶 Artificial Analysis S2S 指数 86.9,价格维持 $0.08/分钟

核心要点速览

  • Artificial Analysis 语音到语音指数 86.9,第 1(2.0 为 81.3,GPT-Live-1 Astra 83.2,Gemini 3.8 Live 82.6)
  • Big Bench Audio 98.5%、Speech Agent Arena Elo 1070、任务成功率 94.8%、Full Duplex Bench 97.0%
  • τ-Voice 71.6%,与 GPT-Live-1(Astra)相当,延迟低约 40%;ServiceNow EVA-Bench 准确率 74% 居首
  • 价格不变:$0.08/分钟($4.80/小时);grok-voice-latest 已自动切到 3.0,grok-voice-2.0 弃用
  • 生产规模:Starlink 客服每天约 2 万通电话,约 70% 无需人工介入(官方数据)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Grok Voice 3.0⚡ Grok Voice 2.0⚡ GPT-Live-1⚡ Gemini 3.8 Live🌐 SpaceXSI🌐 xAI🌐 Artificial Analysis🌐 ServiceNow