AI 编程实时动态与要闻

蚂蚁灵波开源触觉基础模型 LingBot-Touch:近 5000 小时真实触觉数据预训练,冻结的 546 万参数编码器让 4 种机器人策略在 26 项真机任务上成功率提升 14–26 个百分点

蚂蚁集团旗下具身智能公司灵波科技(Robbyant)11 月 9 日开源触觉基础模型 LingBot-Touch(Apache 2.0),用 JEPA 式潜空间预测和共享 Haptic Transformer,把压阻、磁感、视触觉三类传感器统一成同一套触觉 token。官方技术报告称:在 26 项双臂灵巧手真机任务上,接入冻结的 546 万参数 Tiny 编码器后,Diffusion Policy、π0.5、LingBot-VLA、T-Rex 的平均成功率分别提升 13.9–24.8 个百分点,而直接喂原始触觉信号最多只有约一半收益。Tiny 与 Small 两个权重已上 Hugging Face。

蚂蚁灵波开源触觉基础模型 LingBot-Touch:近 5000 小时真实触觉数据预训练,冻结的 546 万参数编码器让 4 种机器人策略在 26 项真机任务上成功率提升 14–26 个百分点

核心要点速览

  • 预训练语料 4,983 小时、46.4 万段交互、约 13.3 亿帧,来自触觉手套与遥操作机器人手,覆盖压阻、磁感、视触觉三种原理
  • 官方口径:26 项真机任务平均成功率,LingBot-VLA 48.3%→73.1%、π0.5 48.1%→69.9%、T-Rex 45.4%→68.6%、Diffusion Policy 21.6%→35.6%
  • Tiny 编码器仅 546 万参数,给所增强的策略增加不到 0.2% 参数;Small 为 2176 万参数,两者均为 12 层 Transformer
  • 仿真 12 项灵巧手强化学习任务中成功率 69%,对比任务专用 CNN 特征 46%、无触觉 21%
  • 注意:可迁移到预训练时没见过的传感器型号,但新的传感器排布仍需先做几何标定
阅读全文
关联模型 / 智能体 / 厂商:
⚡ LingBot-Touch⚡ LingBot-VLA⚡ pi0.5🌐 Ant Group🌐 Robbyant

NVIDIA 在 CoRL 发布开放世界动作模型 GR00T 2:同时预测未来画面与机器人动作,未见任务零样本成功率 40%,每任务 5 条示范微调 30 分钟升至 95%,代码 12 月开放

NVIDIA Robotics 官方账号在 CoRL 2026 宣布 GR00T 2,NVIDIA GEAR 实验室负责人 Yuke Zhu 同步发布技术细节。GR00T 2 是基于 Cosmos 的新一代世界动作模型(WAM):一个扩散 Transformer 同时去噪未来视频和动作块,一套模型可驱动平行夹爪、灵巧手和人形机器人。预训练数据包括 40.27 万小时第一视角人类视频、1.02 万小时 UMI 手持夹爪示范和 2.35 万小时机器人遥操作。官方口径下,50 个目标机器人从未练过的任务零样本成功率 40%,每任务 5 条示范(不到 3 分钟机器人数据)在单张 RTX 5090 上 LoRA 微调 30 分钟后升至 95%。推理模型可通过 WAM API 把 GR00T 2 当工具调用。代码 12 月开放,已在 Hugging Face 放出 10 万小时人类视频数据集。

NVIDIA 在 CoRL 发布开放世界动作模型 GR00T 2:同时预测未来画面与机器人动作,未见任务零样本成功率 40%,每任务 5 条示范微调 30 分钟升至 95%,代码 12 月开放

核心要点速览

  • 架构:一个扩散 Transformer 同时预测未来视频与动作块,各机器人只需一个小动作头,一套模型覆盖夹爪、灵巧手、人形机器人
  • 数据:40.27 万小时人类第一视角视频 + 1.02 万小时 UMI 示范(2897 个任务)+ 2.35 万小时遥操作;人类视频占比从 0 提到 100%,真机任务进度从 50% 升到 70%(官方口径)
  • 适配:50 个未见任务零样本 40%,1 条示范 71%,5 条示范 95%,单张 RTX 5090 LoRA 微调约 30 分钟
  • Agent 协作:推理模型经 WAM API 调用 GR00T 2,三种玩具连续 100 次组装各成功 97 次以上;在画面上标注抓取点后指令遵循率从 40% 升到 92%
  • GR00T 2 Turbo 为 2B 参数版本,在 Unitree G1 的 Jetson Thor 上单次预测 124 毫秒;代码 12 月开放,10 万小时人类视频已上 Hugging Face
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GR00T 2⚡ GR00T 2 Turbo⚡ Cosmos🌐 NVIDIA

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

Meta AI(@AIatMeta)于 11 月 5 日宣布,Connect 上预览的 Muse Realtime Avatar 开始在美国 Muse App 灰度:把 Muse Realtime Voice 变成可互动的实时形象。研究博客称系统为音频驱动的 Diffusion Transformer,与语音共享 speech token 流以同步口型与表情;单会话在 GB200 上可流式输出 448×768@25fps,用户话轮结束到音视频首字节约 870ms,并用 Meta Video Seal 做不可见水印。面向 18+ 用户;官方未公布全球时间表与开发者 API。

Meta 在美国 Muse App 推出 Muse Realtime Avatar:实时语音驱动表情与肢体,约 870ms 首包延迟

核心要点速览

  • 美国 Muse App 开始灰度 Realtime Avatar;Connect 时预览,现进入消费端(@AIatMeta)
  • 架构:语音 VQ token 同时驱动音频解码与 Avatar 视频;因果分块 + 自强制蒸馏,教师约 120 次评估压到学生 2 次(约 60×)
  • 性能口径:448×768@25fps,约 870ms 首包;单 GB200 相对 BF16 基线服务容量约 8×,可达 12 路并发(研究博客)
  • 主观评测:相对 Runway Characters、HeyGen LiveAvatar,评分者在整体与多数维度更偏好 Muse(厂商评测)
  • 安全:生成视频嵌入 Video Seal 不可见水印;示例不代表 App 内全部形象;无公开开发者 API
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Spark⚡ Muse Presence🤖 Muse🌐 Meta

Ricursive 开源 Ripple-65B Preview:从零预训练的 65B 稠密模型,TerminalBench 2.1 80.5,Apache 2.0

Ricursive Intelligence 于 11 月 4 日(UTC 18:24)发布首个模型 Ripple-65B Preview,并在 Hugging Face 以 Apache 2.0 开源指令版(BF16、NVFP4)和基座版。官方模型卡显示:65B 稠密 Transformer、12T token 预训练、最长 1M 上下文,自报 TerminalBench 2.1 80.5、SWE-bench Pro v2.0 Hard 79.1、DeepSWE 1.1 44.3,在编码 Agent 任务上超过参数大得多的美国开源模型;可在 DGX Spark 等本地硬件运行。CEO Anna Goldie 称成本约为此前同类 SOTA 的十分之一。

Ricursive 开源 Ripple-65B Preview:从零预训练的 65B 稠密模型,TerminalBench 2.1 80.5,Apache 2.0

核心要点速览

  • Ripple-65B Preview 为 65B 稠密模型,80 层、d_model 5120 的“窄而深”结构,从 Olmo 3 基线改为类 Gemma 3N 架构。
  • 预训练 12T token(8K 序列),后训练含中训练、长上下文、SFT 与混合领域 RL,支持最长 1M 上下文。
  • 自报 TerminalBench 2.1 80.5,高于 Reflection Beam 501B(80.1)、Muse Spark Open 816B(76.4);但 SWE-bench Verified 76.5、DeepSWE 1.1 44.3 并非全面领先。
  • 官方称核心团队从 1 人扩到 5 人,代码计算效率相对 Olmo 3 提升 16 倍;2×B200 上约 250 tok/s。
  • Hugging Face 提供 BF16、NVFP4、基座版和 DFlash2 投机解码模型,许可均为 Apache 2.0。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ripple-65B Preview⚡ Reflection Beam 501B⚡ Muse Spark Open⚡ Nemotron 3 Ultra🌐 Ricursive Intelligence🌐 NVIDIA
AD赞助内容

DeepSeek Harness 上线 Creator Mode:用一句话让 Agent 生成可用插件,官方放出 7 个演示 Prompt

DeepSeek 旗下开源 Agent 应用 DeepSeek Harness(MIT 协议)11 月 2 日在 X 官方账号发布 Creator Mode:用户用自然语言描述想要的插件,Agent 把它做成可直接使用的插件,演示包括 3D 地标馆、Transformer 3D 可视化、视频剪辑台和论文阅读器。官方同时在 cdn.deepseek.com 公开了 7 个中英双语演示 Prompt,并提醒部分插件经过多轮对话打磨,单条 Prompt 未必能完全复现视频效果。原帖约 2 万赞、169 万次浏览。官方未公布任何跑分。

DeepSeek Harness 上线 Creator Mode:用一句话让 Agent 生成可用插件,官方放出 7 个演示 Prompt

核心要点速览

  • Creator Mode:用自然语言描述想要的插件,Agent 生成可直接使用的插件,从设计工作台到沙盒游戏、3D LLM 可视化。
  • 官方公开 7 个演示 Prompt:3D 地标馆、Transformer 3D 演示、5 种界面风格切换、海报工作台、视频剪辑台、论文阅读器、会话 token 统计。
  • 入口已进入 v0.2.1-rc.5(10 月 30 日预发布):插件管理页新增「让 Agent 创建插件」,保留草稿进入创造模式。
  • GitHub 仓库 约 27 万星、MIT 协议;Harness 目前仍处于预览期。
  • 官方未公布任何跑分或成功率数据;原帖约 2 万赞、169 万次浏览。
阅读全文
关联模型 / 智能体 / 厂商:

商汤开源 SenseNova-Loop-9B-Preview:9B 循环 Transformer 跑出约 14.6B 的推理深度,主打长上下文与 Agent 工作流

商汤 10 月 30 日在官方 X 账号和 Hugging Face 发布 SenseNova-Loop-9B-Preview(Apache 2.0)。它把 32 层解码器里的第 4–27 层用同一套权重连跑两遍,每次前向执行 56 层计算,存储约 9B 参数、推理参数约 14.6B,并用两路 mHC(流形约束超连接)管理残差流。模型支持文本加图片输入,训练序列最长 262,144 token。官方图表显示它在 BIRD-Dev、WorkBuddy Bench 等多项 Agent 与数据任务上超过 Qwen3.5/3.6 同级模型,但 Terminal Bench 2.1 仍落后;技术报告尚未发布。官方 X 首帖约 910 赞。

商汤开源 SenseNova-Loop-9B-Preview:9B 循环 Transformer 跑出约 14.6B 的推理深度,主打长上下文与 Agent 工作流

核心要点速览

  • 结构:32 个不同解码层、第 4–27 层共享权重循环 2 遍,每次前向共 56 层计算;约 9B 存储参数、约 14.6B 推理参数(模型卡)
  • 官方口径跑分:BIRD-Dev 71.38(Qwen3.5-27B 69.84)、WorkBuddy Bench 66.89(Qwen3.6-35B-A3B 61.98)、AutomationBench 13.72(Qwen3.5-27B 10.17)
  • 短板同样来自官方图表:Terminal Bench 2.1 为 40.45,低于 Qwen3.6-27B 的 47.19;τ³-Banking 18.56,略低于 Qwen3.5-27B 的 19.59
  • 训练上下文最长 262,144 token;混合注意力为每 4 层 3 层线性注意力加 1 层全注意力;已支持 MTP 加速,DSpark/DFlash2 仍在训练
  • Apache 2.0 许可,需 trust_remote_code=True;官方给出 Transformers 5.18.0、LightLLM 4 卡和 SGLang PR 部署示例,技术报告待发布
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SenseNova-Loop-9B-Preview⚡ Qwen3.5-27B⚡ Qwen3.6-35B-A3B🌐 SenseTime

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

10 月 20 日,UCSD Hao AI Lab 的 FastVideo 团队开源 FastH3 Omni,这是 MiniMax H3 参考生成音视频(Ref2VA)模型的蒸馏版,可同时用文本、最多 9 张图、视频片段和人声参考生成带同步立体声的视频。采样从 50 步降到 8 次 transformer 计算,官方在 8 张 GB200 上测得端到端延迟降低 5.6–11.9 倍,训练代码一并开源,并提供面向 DGX Spark、RTX 5090 的 NVFP4 权重和 ComfyUI 支持。

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

核心要点速览

  • 步数:8 次 transformer 计算,基座 MiniMax H3 为 50 步,采用 PDD + DMD 蒸馏
  • 速度(官方口径):27 组对照负载、8×GB200,端到端延迟降低 5.6–11.9 倍;例如 15 秒单图请求 139.69 秒降到 14.14 秒
  • 输入:最多 9 张图、3 段视频、3 段音频,合计不超过 12 个参考;输出 24 FPS 视频 + 32kHz 立体声
  • 本地运行:DGX Spark(128GB)和 RTX 5090(32GB)用 NVFP4 QAD 权重,默认 480p;RTX 4090 可用 FP8 版
  • 许可:沿用 MiniMax-H3 Community License,不是 Apache/MIT
阅读全文
关联模型 / 智能体 / 厂商:

Google 联合 Meta 开源 TorchTPU:PyTorch 原生跑在 TPU 上,把 .to("cuda") 改成 .to("tpu") 即可迁移,vLLM、SGLang 同步上 TPU 原生后端

10 月 20 日 PyTorch Conference 2026 上,Google 宣布与 Meta PyTorch 团队共同开发的 TorchTPU 在 GitHub 开源,让 TPU 和 GPU、CPU 一样成为 PyTorch 原生设备:支持 eager 模式和 torch.compile、约 450 个 ATen 算子、torch.distributed 集合通信。同时开源 vLLM-TorchTPU、SGLang-TorchTPU 推理引擎,打通 TorchTitan、Ray、VeRL、Hugging Face Transformers v5(device_map="tpu"),并预览面向 Claude Code、Antigravity 等编码助手的 TPU agent suite。前一天 AWS 刚发布同类的 TorchNeuron。

Google 联合 Meta 开源 TorchTPU:PyTorch 原生跑在 TPU 上,把 .to("cuda") 改成 .to("tpu") 即可迁移,vLLM、SGLang 同步上 TPU 原生后端

核心要点速览

  • 迁移门槛(PyTorch 官方博客):现有代码把 model.to("cuda") 改成 model.to("tpu")、分布式后端换成 tpu_dist 即可跑起来;官方也说明想拿到峰值性能仍需按 TPU 调整形状和切分
  • 覆盖面(官方口径):约 4,917 个热门 Hugging Face 模型中 98%(4,821 个)可在 TPU 上无报错运行,657 个架构代表模型里 97%(638 个)与 GPU 数值一致
  • 训练扩展(官方口径):TorchTitan 上 Qwen3 MoE 235B 从 1,024 扩到 8,192 颗 TPU v7,MFU 基本稳定在 27%–29%;64 颗 TPU v7 上吞吐 1,828 TPS,接近 JAX/MaxText 的 1,937 TPS
  • 推理成本(官方转引 SemiAnalysis InferenceX):TPU v7 加 vLLM-TorchTPU 在 8K/1K 场景每百万 token 2.01 美分,9 月首测时为 3.6 美分
  • 同步开源 4 个仓库:torch_tpu、vllm-torchtpu、sglang-torchtpu、TorchTitan TPU 版;TPU agent suite 以预览形式上线,支持 TPU v6e 与 TPU7x
阅读全文

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

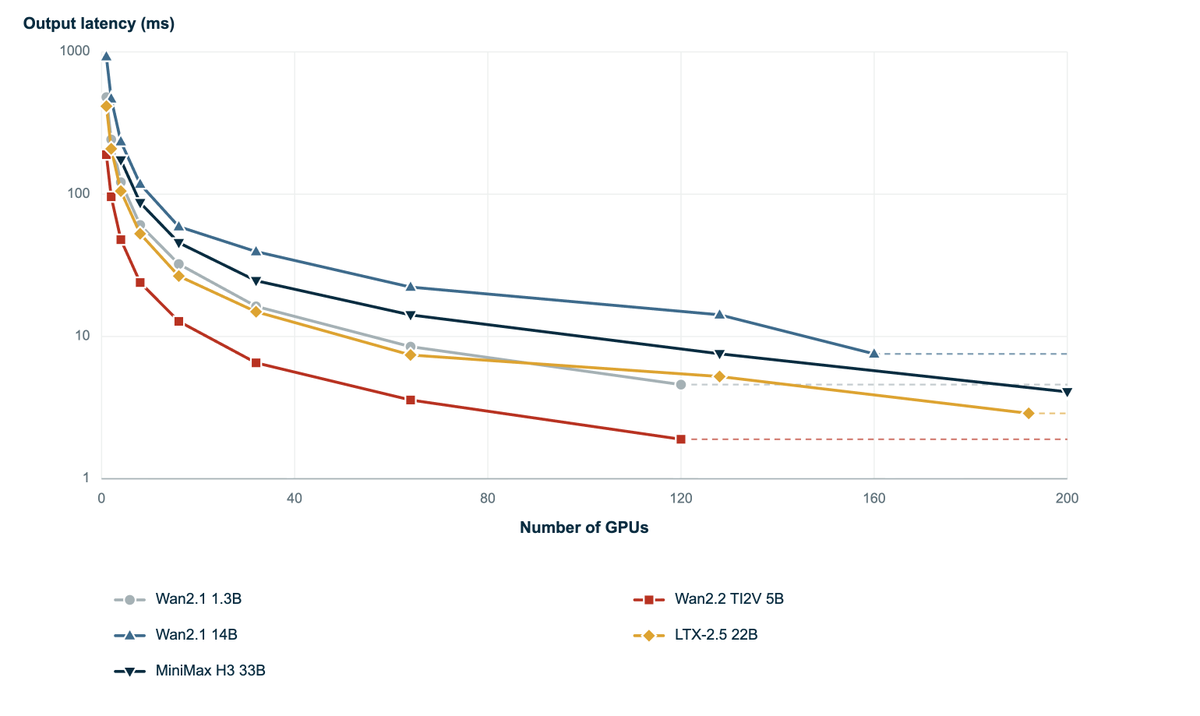
vLLM 官方项目组正式宣布将 PhysisServe 的核心推理加速架构整合至 vLLM-Omni 多模态全能推理引擎中。针对物理世界 AI、视频扩散生成与具身大模型在长程去噪阶段面临的高显存占用与高延迟痛点,PhysisServe 创新性提出去噪步与 Transformer 跨块流水线并行(Block Pipelining)、时间分片批处理与虚拟秩联合调度。在 200 张 GPU 集群上对 MiniMax H3 33B 展开实测,实现每 4.1 毫秒输出一个 Chunk(折合千帧/秒渲染),Wan2.2 5B 单卡单请求延迟从 173 毫秒降至 98 毫秒。

vLLM-Omni 宣布整合 PhysisServe:物理世界与视频扩散模型推理加速,4.1 毫秒极速输出

核心要点速览

  • vLLM 官方宣布将 PhysisServe 核心加速架构合流至 vLLM-Omni,专精于物理世界大模型与视频扩散生成推理
  • 首创去噪步与 Transformer 跨块流水线并行(Block Pipelining)与时间分片批处理,彻底消除多卡通信气泡
  • 在 200 卡集群上 MiniMax H3 33B 达成每 4.1 毫秒产出单 Chunk(纯 DiT 计算达千帧/秒),Wan2.2 5B 单卡时延降至 98 毫秒
  • 24 卡集群并发承载能力暴增 1.7~3.3 倍,代码已全面开源至 GitHub 并即将进入 vLLM-Omni 正式版
阅读全文
关联模型 / 智能体 / 厂商:

Adobe 与布朗大学开源多模态多参考视频编辑框架 OmniXRef:镜头轨迹误差大降 5 倍,横扫五大属性控制

Adobe Research 与布朗大学在 arXiv:2610.22744 中正式发布统一多模态多参考视频编辑框架 OmniXRef。针对现有视频编辑模型通常仅支持单一文本提示、难以精确解耦多参考源(如参考视频的运镜、参考图像的主体外观与自然语言指令)的行业痛点,OmniXRef 采用单流扩散 Transformer(Diffusion Transformer)架构,提出 Mix-Patchify 与参考相对位置编码(R2-RoPE)。实测显示在运镜轨迹迁移中旋转误差低至 0.874、平移误差 3.961,超越顶尖商用闭源系统达 5 倍以上。

Adobe 与布朗大学开源多模态多参考视频编辑框架 OmniXRef:镜头轨迹误差大降 5 倍,横扫五大属性控制

核心要点速览

  • Adobe 与布朗大学联合开源多模态多参考视频编辑框架 OmniXRef(arXiv:2610.22744),支持文本、图像与视频多参考源自由组合
  • 基于单流 Diffusion Transformer 架构,提出 Mix-Patchify 与 R2-RoPE 相对位置编码,实现多模态上下文联合注意力建模
  • 在镜头轨迹迁移中旋转误差仅 0.874、平移误差 3.961,精度超越顶尖商用视频系统 Seedance 2.5 达 5 倍以上
  • 全面覆盖运镜、动作、主体、画风与特效五大属性解耦控制,开源项目主页已正式上线
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

香港大学提出混合线性注意力投机解码 ReaDy:复用循环状态作为动态上下文,B200 解码吞吐达 302 TPS

传统投机解码(Speculative Decoding)依赖目标模型的静态隐层特征,无法适应草稿模型随位置变化的动态上下文需求。香港大学团队发表 ReaDy(arXiv:2610.20503,HF 6 赞)。该框架首次为混合线性注意力模型(Hybrid Linear Attention,结合 Transformer 与 Mamba/RWKV 循环层)设计了以紧凑循环隐状态为动态上下文的投机草稿机制。在 NVIDIA B200 单卡上对 Qwen3.8-27B 展开评测,投机接受长度达 4.53,单卡解码吞吐飙升至 302.78 TPS,较标准自回归提速 2.4 倍。

香港大学提出混合线性注意力投机解码 ReaDy:复用循环状态作为动态上下文,B200 解码吞吐达 302 TPS

核心要点速览

  • 香港大学提出首个专为混合线性注意力(HLA)架构打造的投机解码方法 ReaDy(arXiv:2610.20503)
  • 创新性地复用 HLA 骨干中的紧凑循环隐状态作为动态上下文,解决传统草稿模型特征静态僵化的问题
  • 在单张 NVIDIA B200 上对 Qwen3.8-27B 展开实测,解码吞吐达到 302.78 TPS,较标准自回归提速 2.4 倍,在 DSpark 基础上再提升 7.97%
  • 仅需 Rank 8 超轻量读取器即可达成最佳性能,投机接受长度达到 4.53 个 Token
阅读全文
关联模型 / 智能体 / 厂商:

CMU 与复旦奠基循环架构理论 Hugging MoE:三明治拓扑破解参数重用瓶颈,8B 循环 MoE 媲美 32B 深层前馈模型

循环语言模型(Looped Language Models)通过在逻辑深度上反复复用物理 Transformer 块大幅缩减权重规模,但过往架构将循环位置、输入注入与隐状态设计深度纠缠。卡内基梅隆大学(CMU)与复旦大学联合发表 Looped Models Done Right 第一部分(arXiv:2610.23036)。团队提出“前奏-循环块-尾声(Prelude-Recurrent-Coda)”三明治架构,在 5000 亿 Token 严苛预训练中,仅含 8.0B 常驻/7.94 亿激活参数的 Huginn MoE 在 MMLU、GSM8K 与 MATH500 上全面追平 32.0B 常驻/32 亿激活的前馈 MoE 基线。

CMU 与复旦奠基循环架构理论 Hugging MoE:三明治拓扑破解参数重用瓶颈,8B 循环 MoE 媲美 32B 深层前馈模型

核心要点速览

  • CMU 与复旦大学联合发表循环模型奠基之作(arXiv:2610.23036),首次系统解耦循环位置、输入注入与隐状态设计
  • 提出“前奏-循环块-尾声(P8-R12^8-C8)”三明治拓扑架构 Huginn,打破传统均匀全量循环的表征崩溃瓶颈
  • 将原则推广至循环 MoE 架构,在 5000 亿 Token 预训练中,8.0B 常驻/7.94 亿激活参数的 Huginn MoE 性能全面打平 32.0B 常驻/32 亿激活的前馈基准
  • 常驻显存开销暴降 75%,为在 16GB~24GB 消费级显卡部署 30B 级高性能推理提供了坚实工程路线
阅读全文
关联模型 / 智能体 / 厂商:

小红书、北大与港中文深圳提出 LangDiT:专为连续扩散语言模型重构 Transformer,生成困惑度骤降至 11.33 刷新 SOTA

现有连续扩散语言模型(CDLM)普遍直接套用自回归 LLM 或图像 DiT 架构,存在特征尺度失控与梯度路由紊乱问题。小红书、北京大学、香港中文大学(深圳)与 UCLA 团队联合发表 LangDiT(arXiv:2610.22330)。通过骨干网与 Q/K RMSNorm、展宽噪声条件调制、词表头残差截断解耦及置信度门控自条件引导,在 OpenWebText 基准上将 LangFlow 生成困惑度压至 21.72,适配 Plaid 架构后进一步取得 11.33 的全新 SOTA 困惑度记录。

小红书、北大与港中文深圳提出 LangDiT:专为连续扩散语言模型重构 Transformer,生成困惑度骤降至 11.33 刷新 SOTA

核心要点速览

  • 小红书、北大与港中文深圳联合发表 LangDiT(arXiv:2610.22330),首次系统重构专属于连续扩散语言模型的 Transformer 架构
  • 通过 Q/K RMSNorm、展宽噪声条件调制解耦数值稳定性与时间步注入,利用词表头梯度截断消除自条件反馈污染
  • 在 OpenWebText 1024 长度无条件文本生成中,将 LangFlow 生成困惑度降至 21.72,将 Plaid 困惑度大幅压缩至 11.33 的全新纪录
  • 在仅需 128 步去噪采样下仍取得 27.51 的优异困惑度,证实骨干网络定制是非自回归语言模型取得质变的核心动力
阅读全文
关联模型 / 智能体 / 厂商:

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

针对大模型数学证明缺乏步骤级验证标签与上下文精确复制存在 LM Head 梯度瓶颈的两大难题,今日两项基础研究给出突破:NYU/UCLA/Stanford 联合推出 LeanPRM(arXiv:2610.17697),利用 Lean 4 证明助手自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注数据集,将 Qwen3-4B 步骤验证准确率从 48.2% 拉升至 74.7%(远超 PRM800K 的 60.3%);康奈尔大学提出复制粘贴语言模型 CPLM(arXiv:2610.19247),以仅约 3% 算力开销打破 LM Head 梯度瓶颈,使窗口仅 w=128 的滑窗模型追平全注意力困惑度并在 4 倍外推长度(16K)持续收益。

零人工标注步骤准确率从 48.2% 飙至 74.7%!LeanPRM 用形式化证明器锻造过程奖励模型,康奈尔 CPLM 滑窗逼平全注意力

核心要点速览

  • LeanPRM 利用 Lean 4 证明器与语法错误过滤模型,全自动构建含 10,634 篇证明与 15.2 万个步骤标签的零人工标注过程监督集
  • 基于 LeanPRM 训练的 Qwen3-4B 验证器在 LeanPRM-Bench 上将步骤准确率从 48.2% 提升至 74.7%(大幅领先 PRM800K 训练的 60.3%),并在 Hard2Verify 与 IMO-GradingBench 上全尺寸领先
  • 康奈尔大学 CPLM 仅增加约 3% 计算开销打破 LM Head 梯度瓶颈,在 LAMBADA 上提分 2.5~4.0 分,且仅用 w=128 滑窗即可追平全注意力模型的困惑度
阅读全文
关联模型 / 智能体 / 厂商:

Google AI Studio 向 Pro 订阅者开放 Gemini 4 Argon 构建模式,Transformers v5.20.1 原生支持 Reflection AI Beam 与 Meta 816B Muse Spark Open

Google AI Studio 正式宣布向 Google AI Pro 订阅开发者全面开放旗舰模型 Gemini 4 Argon 的 Build 与 Playground 交互构建能力;与此同时,Hugging Face Transformers 连发 v5.20.0 与 v5.20.1,免远程代码原生集成 Reflection AI 编码大模型 Beam、Meta 816B(42B 激活/1M 上下文)全模态编程模型 Muse Spark Open、蚂蚁 Ling 3.0 Flash 及面壁 MiniCPM-V 4.7。

Google AI Studio 向 Pro 订阅者开放 Gemini 4 Argon 构建模式,Transformers v5.20.1 原生支持 Reflection AI Beam 与 Meta 816B Muse Spark Open

核心要点速览

  • Google AI Studio 正式向 Pro 订阅用户开放 Gemini 4 Argon 的 Build 与 Playground 模式(https://ai.studio/build),赋能长程交互式应用构建
  • Hugging Face Transformers v5.20.1 原生合入 Reflection AI 面向私有化与长程 Agent 打造的低 Token 消耗旗舰编码模型 Beam,并修复 DeepGEMM Mega MoE 专家并行 Bug
  • 同步原生支持 Meta 816B 总参数(42B 激活、1,048,576 上下文、支持 BF16/NVFP4)全模态编程模型 Muse Spark Open 与蚂蚁 KDA+MLA 混合架构 Ling 3.0 Flash
阅读全文
关联模型 / 智能体 / 厂商: