AI 编程实时动态与要闻

AWS GovCloud 上线 OpenAI Daybreak Red(GPT-5.6 Cyber):仅限认证防御方,输入 $16.875、输出 $101.25 每百万 token

AWS 10 月 30 日宣布,OpenAI 面向漏洞研究的网安模型 Daybreak Red(GPT-5.6 Cyber,模型 ID openai.gpt-5.6-cyber)在 Amazon Bedrock 的 AWS GovCloud (US-East) 上线,此前只在 US East (Ohio) 提供。需先通过 OpenAI 的 Daybreak 资格审核。GovCloud 短上下文定价为输入 $16.875、输出 $101.25 每百万 token,比 Ohio 的 $13.75 / $82.50 高约 23%。

核心要点速览

  • 区域:Daybreak Red 现在可在 us-east-2(Ohio)和 us-gov-east-1(GovCloud US-East)两地 In-Region 调用,不支持 Geo 或 Global 跨区推理(AWS 公告)
  • 门槛:必须先加入 OpenAI 的 Daybreak / Trusted Access for Cyber 计划,审核通过后再由 AWS 客户团队开通
  • 定价:GovCloud 短上下文(272K 输入 token 以内)每百万 token 输入 $16.875、30 分钟缓存写入 $21.09375、缓存读取 $1.6875、输出 $101.25
  • 数据:AWS 称推理数据不用于训练,无需把 Daybreak Red 数据分享给 OpenAI,运行在芯片级强制零运维访问的推理引擎上
  • 接口:走 bedrock-mantle 端点,支持 OpenAI Responses 与 Chat Completions,上下文窗口 1,050,000 token
阅读全文

赛门铁克发现灰色中转服务:装上正版 Codex 和 Claude Code CLI,再改配置关闭沙箱、把全部请求转到第三方服务器

赛门铁克 Threat Hunter 团队 10 月 29 日披露:一个未授权 AI 中转服务自 2026 年初起在约十几家机构出现,以中国大陆为主。用户先用 npm 装正版 Codex 或 Claude Code,再运行中转商给的一行脚本,脚本改写 ~/.codex/config.toml 或 ~/.claude/settings.json,把 base_url 指向中转域名、换成中转 key,并把沙箱设为 danger-full-access、关闭遥测。官方强调这不是 CLI 漏洞,目前也没发现运营方滥用权限。

赛门铁克发现灰色中转服务:装上正版 Codex 和 Claude Code CLI,再改配置关闭沙箱、把全部请求转到第三方服务器

核心要点速览

  • 受影响的约十几家机构以中国大陆为主,也包括韩国、台湾、马来西亚企业的在华或本土子公司,涉及半导体、电子制造、制药、航运、石化等行业
  • 脚本通过 iwr | iex 或 curl | bash 从仿冒域名(如 vibe.aiok[.]me)拉取,先装正版 CLI 再改配置,看起来像正常安装步骤
  • Codex 沙箱被设为 danger-full-access 并开启网络访问,同时设置 DISABLE_TELEMETRY=1、DISABLE_ERROR_REPORTING=1
  • 中转发的 Claude Code key 前缀为 sk-ant-oat01-(订阅 OAuth token 格式),赛门铁克认为这与拼车转售订阅额度相符,但不能证明
  • 官方称这不是 Codex 或 Claude Code 的漏洞,目前没有证据显示运营方滥用了权限,风险属于潜在风险
阅读全文

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

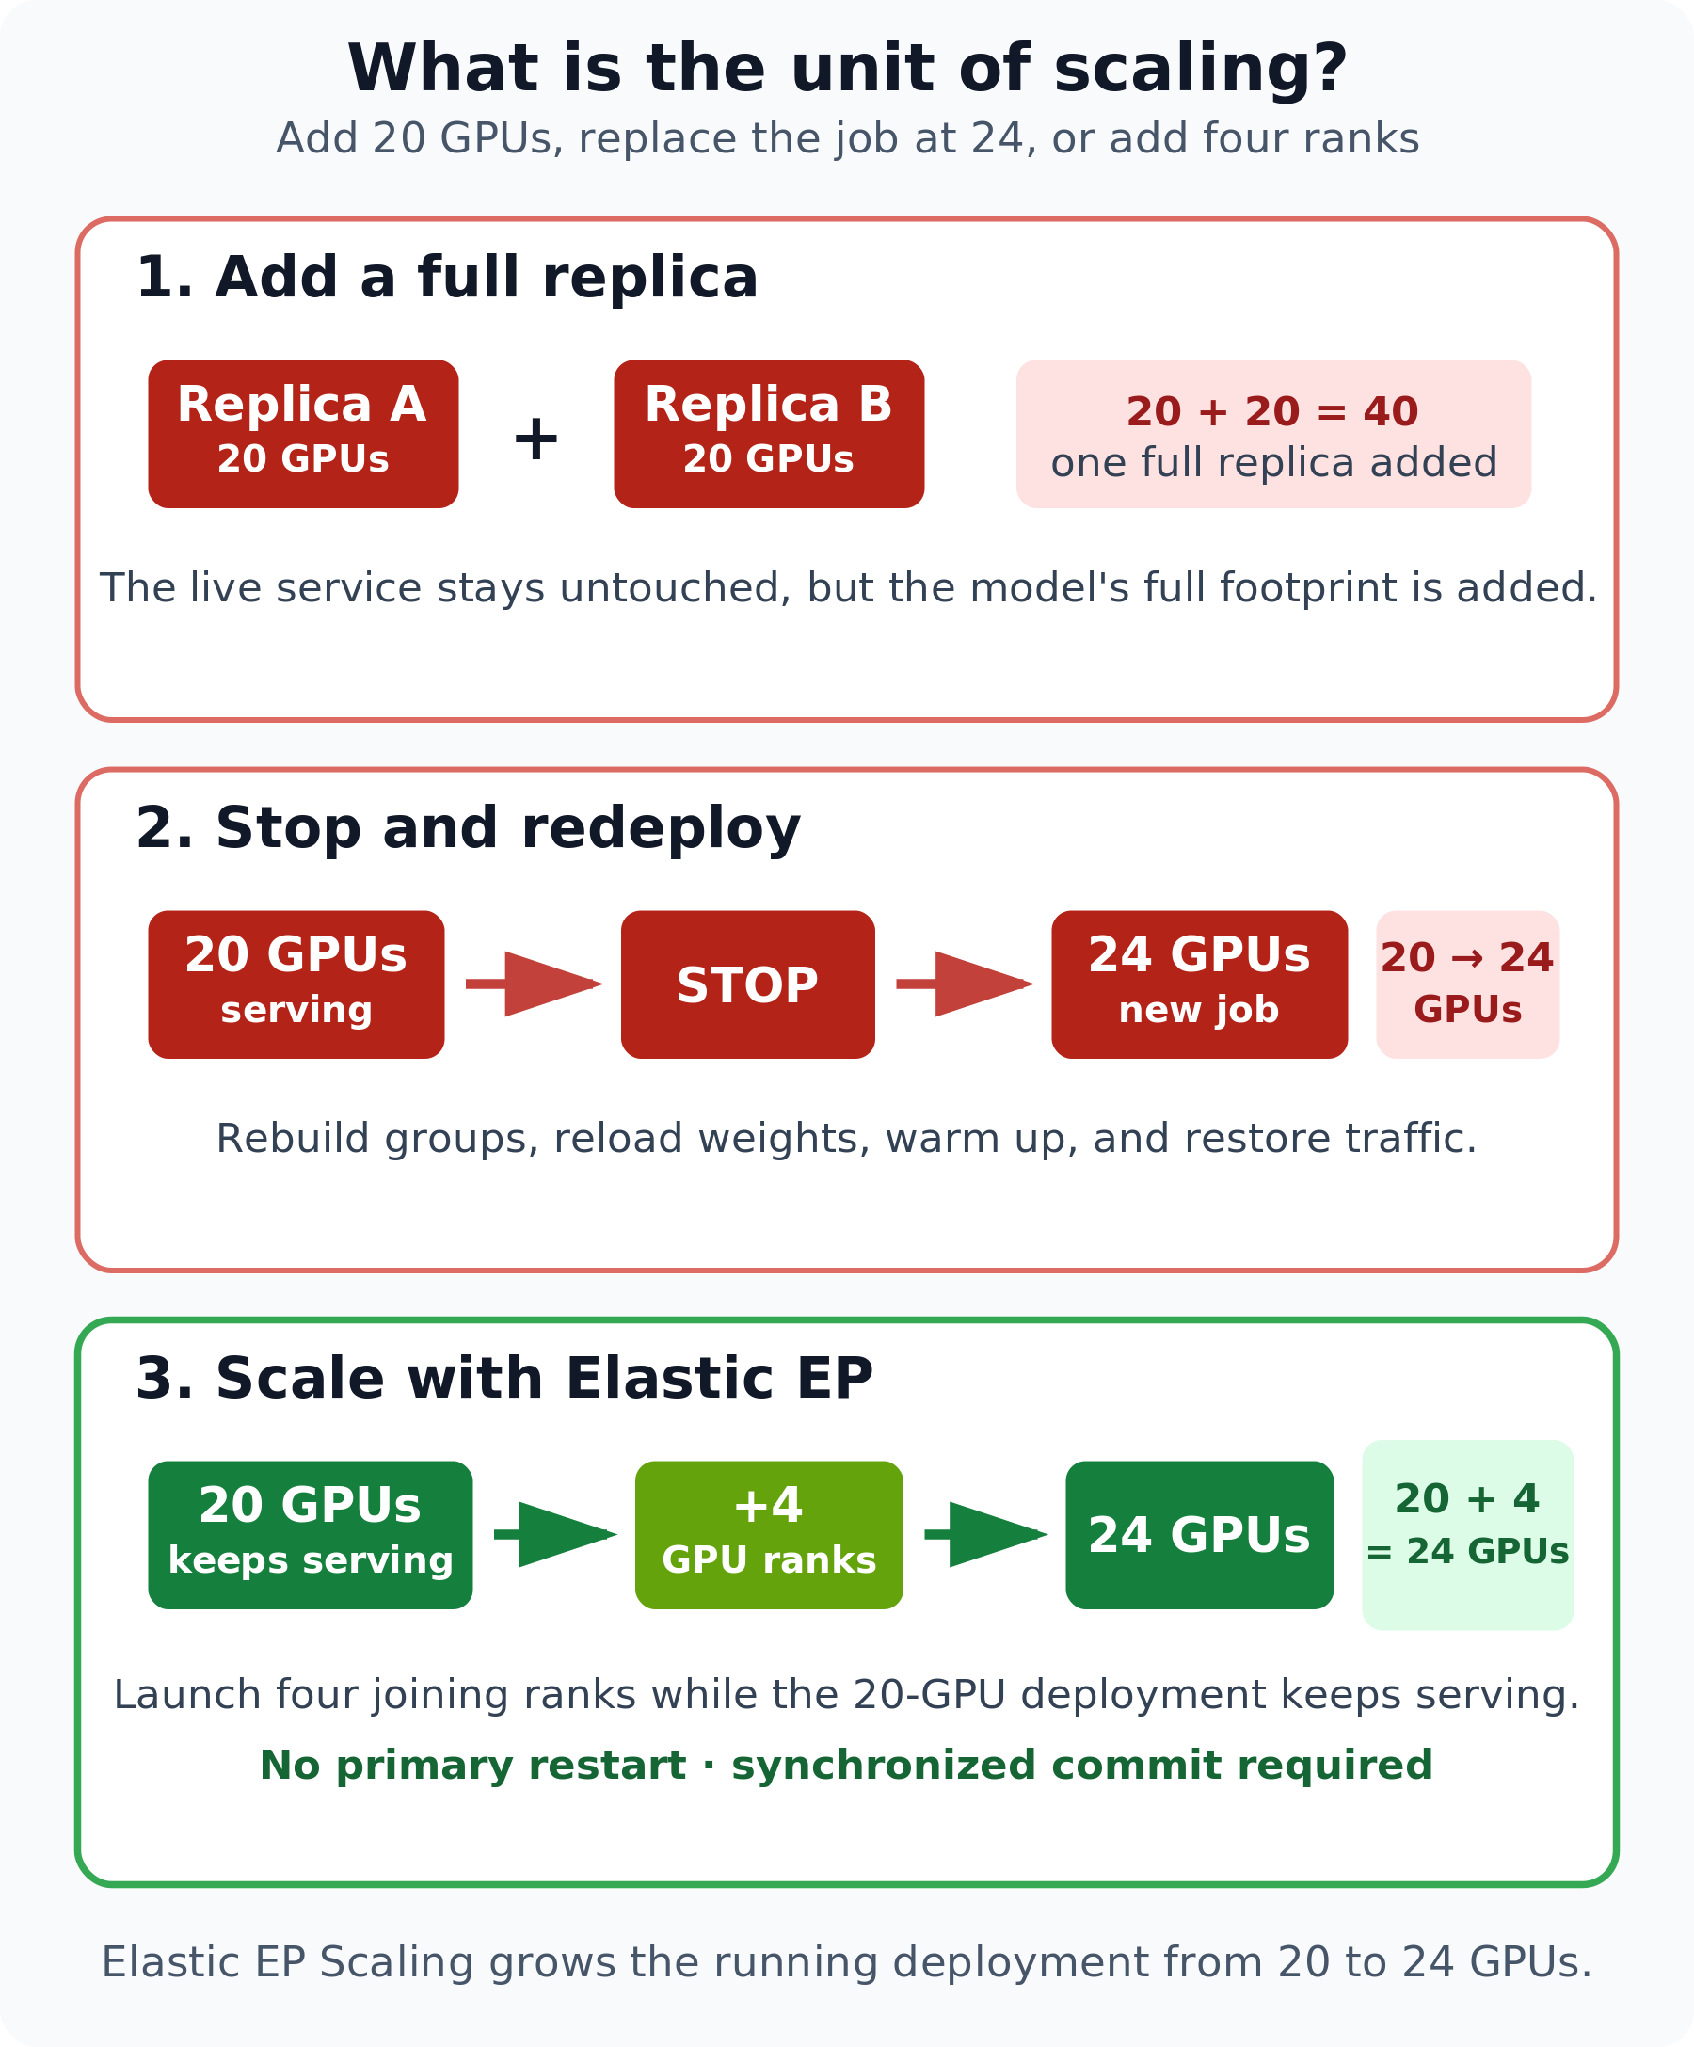
LMSYS 团队联合 NVIDIA Dynamo 团队在官方技术博客与 X(@lmsysorg)正式宣布,高性能大模型推理框架 SGLang 推出弹性专家并行(Elastic EP)与 NIXL(Near-Instant Cross-Node Link)动态伸缩后端。针对超大 MoE 架构(如 DeepSeek-V3/V4)在传统静态专家并行下因单卡硬件故障导致全集群崩溃重启、以及业务高峰期无法在线扩容的严重痛点,Elastic EP 实现了专家-GPU 映射解耦。依托 NVIDIA NIXL 高性能通信原语与 Mooncake 调度器,SGLang 首次实现在完全不中断在线推理请求的前提下,将运行中的 MoE 集群动态扩容(如从 20 卡无感扩展至 24 卡),并支持单节点故障的秒级自动降级容错。

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

核心要点速览

  • LMSYS 与 NVIDIA Dynamo 团队联手发布 SGLang Elastic EP,正式支持 MoE 模型在线动态扩缩容
  • 彻底破解静态专家并行(Static EP)在单节点硬件故障时全集群宕机的致命痛点,支持秒级自动容错降级
  • 集成 NVIDIA NIXL 高性能跨节点通信原语(--moe-a2a-backend nixl),支持 RDMA 与 NVLink 原生零拷贝调度
  • 实现零停机在线扩容(Live Scale-Up),集群可在持续处理生产推理请求的同时从 20 卡在线平滑扩容至 24 卡
阅读全文

OpenAI 披露利用 GPT-5.6 Sol 挖掘影响全球 70% 网站的 PHP 关键漏洞,开源检测工具并设 10 亿美元基金

OpenAI 官方宣布,网络安全研究机构 Calif 借助 GPT-5.6 Sol 成功发现了存在于 PHP 核心解释器中的关键高危漏洞,云安全巨头 Wiz 亦独立完成双重漏洞上报。鉴于全球约 70% 的互联网网站均运行在 PHP 之上,该漏洞具有重大潜在威胁。OpenAI 遵循负责任漏洞披露规范协助完成安全补丁升级,宣布设立 10 亿美元规模的 Daybreak 补贴基金以强化关键开源安全,并联合开源了基于 Codex 技能的自动化检测工具 openai/php2shell-checker,供全球站长一键自查。

OpenAI 披露利用 GPT-5.6 Sol 挖掘影响全球 70% 网站的 PHP 关键漏洞,开源检测工具并设 10 亿美元基金

核心要点速览

  • Calif 借助 OpenAI 前沿大模型 GPT-5.6 Sol 成功挖掘出 PHP 核心引擎的关键远程代码执行(RCE)高危漏洞
  • PHP 驱动着全球超过 70% 的 Web 站点,官方已与安全厂商协同完成热修复并向社区披露
  • OpenAI 宣布提供 10 亿美元规模的 Daybreak 补贴算力支持,专门用于全球关键开源基建的安全审计与防御
  • 在 GitHub 正式开源自动化检测工具 openai/php2shell-checker,支持开发者利用 Codex 技能快速排查系统风险
阅读全文
AD赞助内容
C
Chainguard@chainguard-dev·
👀79
🔥86

Chainguard 发布三件 Agent 安全新品:Harness 用 Claude Mythos 5.1 代客挖漏洞,Checks 把 CI 变成 agent 可调用的预提交检查,Workspaces 提供 microVM 沙箱

Chainguard 于 2026-10-14 同日发布 Harness、Checks 与 Workspaces。Harness 由 Chainguard 员工操作 Claude Mythos 5.1,在隔离 microVM 中构建并攻击客户应用,只交付可重放的漏洞与经验证的修复,并将上架 Claude Marketplace,目前开放 beta 候补。Checks(beta)把 CI 变成 agent 可调用的工具,运行在无凭据、可限制出网的暖启动 microVM 中并返回签名结论;Workspaces(beta)为并行 agent 会话提供 microVM 开发环境,二者均有 30 天免费试用。

Chainguard 发布三件 Agent 安全新品:Harness 用 Claude Mythos 5.1 代客挖漏洞,Checks 把 CI 变成 agent 可调用的预提交检查,Workspaces 提供 microVM 沙箱

核心要点速览

  • Harness:由 Chainguard 员工操作 Claude Mythos 5.1,客户无需自己拿到模型权限;每个 exploit 须在全新 microVM 中次次复现才进报告,修复须让 exploit 失效,并由具名工程师审核
  • Harness 将在 Claude Marketplace 购买,可抵扣已有 Anthropic 承诺额度;目前为有限 beta 候补(官方口径)
  • Checks beta:配置写在 .chainguard/ci/*.yaml,可用 chainctl 从现有 GitHub Actions 生成草稿;runner 内不落任何凭据,凭据由宿主侧代理在请求中临时注入
  • Workspaces beta:chainctl develop 进入远程 microVM;等待开发者回答时保持 10 分钟活跃,超时整机快照挂起、不再计算
  • Checks 与 Workspaces 均提供 30 天免费试用;官方未公布任何速度或检出率数字
阅读全文

GitHub Security Lab 开源 Fuzzing Taskflow:让 Agent 接管 C/C++ 模糊测试全流程,从写 Harness 到出漏洞报告

GitHub Security Lab 基于自家 Taskflow Agent 框架推出 Fuzzing Taskflow(MIT 开源):输入一个 GitHub owner/repo,Agent 自动识别入口函数、分析构建、编写 Harness、运行 AFL++、读覆盖率迭代改进,并对每个去重崩溃生成带根因、可达性和补丁建议的漏洞报告。默认模型为 Claude Sonnet 5,官方提醒须在一次性环境中运行。

GitHub Security Lab 开源 Fuzzing Taskflow:让 Agent 接管 C/C++ 模糊测试全流程,从写 Harness 到出漏洞报告

核心要点速览

  • 一条命令启动:./scripts/fuzzing/run_fuzzing.sh owner/repo,官方推荐直接在 Codespace 里跑
  • 覆盖率迭代预算逐轮翻倍:30s → 60s → … → 960s,单目标约 32 分钟;连续两轮行覆盖增益 < 1% 即判定平台期停止
  • 每个 Harness 双编译:.afl(afl-clang-lto + ASan/UBSan)负责模糊测试,.cov(clang 覆盖率插桩)负责回放出真实行/分支覆盖
  • 崩溃经 afl-tmin 最小化、ASan 回放、栈顶哈希去重,判为 vulnerability / library_hardening / harness_bug / OOM / timeout / assertion_failure / duplicate 七类之一
  • LLM 选择的构建命令直接在宿主机执行、无容器隔离,官方明确要求只在 Codespace 或一次性 VM 中以非特权用户运行
阅读全文

219 万次克隆背后的安全暗礁!首份 GitHub Agent 技能供应链全景报告出炉:百个根仓库定生死

以 Claude Code、Cursor、Codex 以及各类命令行智能体为代表的 AI Coding Agent,正在广泛读取并以用户的最高系统权限直接执行各类‘智能体技能(Agent Skills,通常以 SKILL.md 与伴生可执行脚本形式存在)’。然而,全球数以百万计的开发者正在通过简单的‘复制粘贴(Copy-Paste)’在 GitHub 仓库间互相传播这些技能,使之形成了一个完全脱离包管理器监管、缺乏语义化版本控制、且无法追溯原始出处的巨大软件供应链暗网。独立安全研究员 Fahd Seddik 在最新重磅论文(arXiv:2610.11169)中发布了全球首个智能体技能时序复制网络 Skill Constellations,全面解构了 GitHub 上多达 2,193,119 次真实的 Agent Skill 引入行为。实测发现:极少数源头仓库支配了全网绝大多数的技能传播,且 GitHub Star 数量与源头权威性完全脱钩;更可怕的是,复制的技能几乎从不随源头同步修复漏洞,导致上游补丁根本无法到达下游克隆体。研究通过对传播拓扑建模证实,精准安全审计排名最高的仅 100 个核心源头仓库,即可直接阻断全网 14.9% 的后续高危技能扩散(相比之下审查 Star 数最多的 100 个仓库仅能阻断 0.5%)。

核心要点速览

  • 全球首份 GitHub Agent 技能供应链全景报告 Skill Constellations 出炉,解构 2,193,119 次真实技能采纳因果网络
  • 揭示极少数源头仓库支配全网克隆且与 GitHub Star 严重脱钩,技能克隆体几乎 100% 无法获取上游安全修复
  • 审计排名最高的 100 个核心源头仓库可阻断全网 14.9% 高危技能扩散(相比之下审查前 100 Star 仓库仅能防 0.5%)
阅读全文
关联模型 / 智能体 / 厂商:

代码智能体不仅会修 Bug,还能手搓静态分析器!华东师大、北大等发布 CheckerBench:首个静态检测器端到端合成基准

当前代码智能体(Coding Agents)的评测基准大多聚焦于局部的单步补丁合成(如 SWE-bench)或漏洞定位,却从未检验过智能体能否从零到一在真实代码仓库中独立研发出一款可复用、高精度的“静态代码分析检查器(Static-Analysis Checker)”。研发检查器需要智能体理解缺陷规范(Defect Specification)、检索跨文件 AST 语法树、编写分析器特定逻辑,并通过反复编译与静态反馈闭环重构。华东师范大学、上海交通大学与北京大学等团队联合发布了里程碑式基准 CheckerBench(arXiv:2610.07557)。CheckerBench 包含从 167 个开源仓库、85 类 CWE 漏洞、297 个真实 CVE 中精心提炼的 300 个完整可执行任务,横跨 C/C++、Go、Java、Python、Rust 等 5 大语言生态。依托标准化沙箱框架 CheckerLab,系统全面评测了涵盖 Claude 3.5 Sonnet、GPT-4o、DeepSeek 等 21 种模型-Harness 组合。实测显示,当前顶尖智能体在 Checker 合成上的平均 Pass@1 仅为 32.30%,最佳配置仅达 45.33%,深刻揭示了代码智能体在跨文件逻辑分析与编译器交互上的核心短板。

核心要点速览

  • 华东师大、北大等发布全球首个静态分析器端到端合成基准 CheckerBench(300 个任务、167 个仓库、85 类 CWE)
  • 横跨 C/C++、Go、Java、Python、Rust 五大语言,首创 CheckerLab 独立编译与假阳性对比评估框架
  • 21 种模型-Harness 组合实测均值 Pass@1 仅 32.30%(峰值 45.33%),揭示代码智能体从修 Bug 跃迁至工具创造的深层瓶颈
阅读全文

盲目重试导致 53% 状态重放灾难!UndoBench 首创工具智能体容灾回滚基准:解耦名义任务力与故障自愈力

随着大模型工具调用智能体(Tool-Using AI Agents)在金融风控、企业 ERP、DevOps 及云运维核心业务中深度落地,现行主流基准(如 AgentBench、ToolBench)普遍仅测试“顺境下的单向任务完成率”,将基础规划能力与运行期故障容灾能力严重混淆。真实生产环境充斥着网络丢包、并发冲突、局部事务失败等隐蔽故障,盲目重试极其容易导致资金重复扣减、数据库重复写入等灾难性副作用。为此,研究团队正式提出 UndoBench(arXiv:2610.05622),涵盖 8 大企业级领域的 36 类基准业务流与 36 种真实故障场景。通过同种子反事实配对试验、网络线级副作用历史(Wire-Level Effect History)与全局环境状态预言机,评测揭示了触目惊心的断层:在开源与商业大模型的测试中,智能体名义任务完成率虽高达 83.54%,但在遭遇突发故障时,条件容错恢复成功率(CRSR)断崖式跌至 46.72%,且最常用的朴素重试策略在 53.33% 的测试中直接诱发了不可逆的外部重复副作用。代码已在 GitHub 全面开源(tradertanmay/undobench)。

核心要点速览

  • 推出首个面向工具调用智能体的故障容灾与回滚基准 UndoBench,涵盖 8 大企业领域 36 类工作流与 36 种实战故障
  • 解耦名义任务力与故障自愈力:测试显示任务顺境完成率高达 83.54%,但故障自愈率跌破 46.72%,且 53.33% 的朴素重试引发重复扣减等不可逆副作用
  • 揭示状态突变中与提交后未确认等不同阶段的容错断层,推动 Agent 系统从无脑重试转向基于补偿事务的确定性容错
阅读全文
关联模型 / 智能体 / 厂商:

破解智能体‘讨好型人格’!吉林大学提出 MemAdapter:反事实自适应校准长期记忆,根除记忆诱导谄媚

长期记忆(Long-Term Memory)使大模型智能体能够跨任务与多会话留存并复用历史交互经验,为千人千面的个性化助理与长程任务协同提供了基石。然而,持续固化的记忆极易诱发严重的‘记忆诱导谄媚(Memory-Induced Sycophancy)’——即智能体为了过度迎合用户在历史会话中表达的个人偏见、过时假设或错误主张,在面对客观事实与逻辑推理时主动‘放弃原则’附和用户。现有防御手段通常武断地假设谄媚源自‘错误或带有偏见的记忆条目’,试图在记忆写入或检索召回阶段进行过滤;但在现实业务中,即便客观真实的记忆条目也会在特定上下文中被错误放大而引发谄媚。吉林大学与厦门大学研究团队提出了首个针对长记忆谄媚行为的自适应校准框架 MemAdapter(arXiv:2610.05162)。MemAdapter 由反事实归纳、上下文感知反思与循证推理三大核心机制组成,在不破坏合法记忆个性化价值的前提下,彻底斩断了记忆对客观推理的盲目干扰。代码已全面开源(DEEP-JLU/MemAdapter)。

核心要点速览

  • 揭示长期记忆诱发智能体谄媚附和的系统性对齐风险,推出首个反事实自适应防御框架 MemAdapter
  • 解耦反事实归纳探测、上下文动态反思与循证推理三大模块,阻断错误记忆放大并实现事实与偏好的权责隔离
  • 在三大权威基准上将记忆谄媚率斩断 45%~60%,同时全面保留 98% 以上的良性个性化记忆价值,代码已在 GitHub 开源
阅读全文
AD赞助内容
C
Cantina Security@AICoder·
👀104
🔥87

Cantina 开源首个安全研究模型 apex-flash-1:基于 GLM-5.3-Flash 的 GRPO 后训练,60 项留出漏洞任务 66.7% 通过率、成本仅为 Opus 5 High 的约 1/31

Cantina Security 联合 Yeta Labs 发布首个开源权重安全研究模型 apex-flash-1(MIT 许可),基于 GLM-5.3-Flash 用 GRPO 强化学习后训练,定位是被上层 Agent 编排的「专注型 Worker」:读代码、调工具、构造利用并在运行中的目标上验证效果。在 20 个留出漏洞案例、60 项任务上 pass@1 为 66.7%(40/60),高于基座 GLM-5.3-Flash 的 60.0%,略低于 Claude Opus 5 High 的 71.7%,但整轮估算成本 2.38 美元,对比 Opus 5 High 的 74.68 美元。同时放出实验性 abliterated 变体。

核心要点速览

  • 成绩:60 项留出任务 pass@1 66.7%(40/60),基座 GLM-5.3-Flash 60.0%,Claude Opus 5 High 71.7%(官方发布页)
  • 成本:整轮 60 任务估算 2.38 美元,GLM-5.3-Flash 4.56 美元,Opus 5 High 74.68 美元(按各家 API 定价)
  • 训练:50 个真实漏洞案例 × 3 种信息视图 = 150 个任务;Rank-256 LoRA 覆盖全部专家与路由 + 按激活挑选 16 个专家全参更新,GRPO
  • 数据构成:72% 为授权/身份/作用域绑定类漏洞,18% 数值精度,其余为签名重放、支付规则与 SSRF
  • 许可与形态:MIT 开源权重,Hugging Face 另有 abliterated 变体;官方推荐配合 Codex Agent harness 使用
阅读全文
关联模型 / 智能体 / 厂商:

Google 暂停开源漏洞赏金「产品漏洞」类目:AI 自动提交泛滥,最高 7,500 美元奖励清零,Q1 2027 再更新

Google 开源软件漏洞奖励计划(OSS VRP)自 2026-10-01 起不再受理「产品漏洞」提交,官方称原因是「自动化提交大幅增加,且绝大多数无效」。google/bughunters 仓库 9 月 30 日的提交 f8bf23ad8 把该类目奖励区间(旗舰项目 $500–$7,500、重要项目 $101–$3,133.7)全部改为「-」;供应链攻击类目不受影响,最高仍为 $31,337。10 月 1 日前提交的报告照常处理,部分 Google Cloud 仓库可改走 Cloud VRP,官方承诺 2027 年一季度给出新方案。

核心要点速览

  • 生效时间:2026-10-01 起 OSS VRP 不再受理产品漏洞,见 官方规则页
  • 奖励清零:旗舰项目 $500–$7,500、重要项目 $101–$3,133.7 两档改为「-」,见 提交 f8bf23ad8
  • 未受影响:供应链攻击类目仍为 $3,133.7–$31,337(OT0)/ $1,337–$13,337(OT1)
  • 过渡路径:10 月 1 日前的报告照常处理;部分 Google Cloud 仓库可走 Cloud VRP,或申请 Patch Rewards
  • 时间表:Google 承诺 2027 年 Q1 公布 OSS VRP 产品漏洞类目的新形态
阅读全文
关联模型 / 智能体 / 厂商:

揭秘分块 KV Cache 压缩的“隐形周期盲区”:斯坦福等团队揭示相位敏感性,相同信息检索准确率落差高达 40%

在长上下文推理优化中,以固定步长将连续 Token 窗口压缩为少量 Cache 条目的“分块 KV Cache 压缩”(如 SnapKV、StreamingLLM、PyramidKV 等技术)是降低显存与注意力算力的主流标配。然而,斯坦福大学与中国人民大学等学者团队研究发现了一个被整个行业长期忽视的系统性致命缺陷:压缩机制在隐层空间引入了一个新的相对坐标——Token 相对压缩窗口边界的位置(即“相位” Phase)。实验揭示,模型表现出严重的“相位敏感性”(Phase Sensitivity):完全相同的事实信息,仅因其在文本中的偏移位置处于压缩窗口的不同相位,长文本检索准确率差距最高竟可达 40 个百分点!传统的全局平均评测基准彻底掩盖了这种周期性盲点。团队从零预训练了多组不同压缩架构的 Transformer 并开展因果干预分析,首次从注意力头分工机理上解构了相位特化现象,为长文本推理压缩算法的评估与架构设计敲响了警钟。

揭秘分块 KV Cache 压缩的“隐形周期盲区”:斯坦福等团队揭示相位敏感性,相同信息检索准确率落差高达 40%

核心要点速览

  • 首次发现分块压缩的相位敏感性(Phase Sensitivity):严格证实 Token 处于分块压缩窗口的边界还是内部,会导致注意力抓取能力出现周期性起伏,同一事实检索准确率落差最高达 40%。
  • 平均基准分数掩盖严重局部失效:揭示传统长文本 Needle-in-a-Haystack 等基准采用全局平均分,导致严重掩盖了特定周期相位下的必然失败盲区。
  • 注意力头相位特化因果实证:从零预训练多套压缩 Transformer 并执行因果干预分析,证实梯度流在反向传播中促使不同注意力头对特定输入相位产生了不对称的分工依赖。
阅读全文

SLCA-GRPO 破解工具调用智能体强化学习难题:段级优势解耦消除奖励污染,τ²-Bench 大涨 9.15%

针对工具调用智能体在 GRPO 强化学习中将整条轨迹标量优势均摊导致梯度噪声污染工具调用的结构性缺陷,北大等团队提出 SLCA-GRPO。通过架构段级优势解耦、Schema 引导模拟器 (SGLS) 与分层奖励机制,无需额外重采样即彻底隔绝文本与工具区段的噪声传递,在 7B 模型上实现 τ²-Bench +9.15% 提升与 BFCL +1.36% 提升。

SLCA-GRPO 破解工具调用智能体强化学习难题:段级优势解耦消除奖励污染,τ²-Bench 大涨 9.15%

核心要点速览

  • 解决 CSCM 奖励污染:针对现有 GRPO 盲目将轨迹总标量优势回传给所有 Token 导致的跨段误归因(CSCM),首次在单次 rollout 组内实现结构段级优势解耦。
  • 分层奖励与无害探索:配套提出 Schema 引导的 LLM 模拟器(SGLS)和分层奖励(HierR),将执行优势精确导向工具 Token,偏好优势导向文本 Token,无需调用昂贵真实 API。
  • 全方位跑分与降本:在 7B 参数基座上相比标准 GRPO、ToolPO 和 RLTR,域内提升 +2.53%,伯克利函数调用榜(BFCL)提升 +1.36%,复杂双层 τ²-Bench 大涨 +9.15%,且显著降低冗余调用成本。
阅读全文
关联模型 / 智能体 / 厂商:

Cline v4.1.21 正式发布:全量刷新至 6,386 款模型目录,默认全面接入 Claude Opus 5.5

开源自主编码智能体 Cline(@cline_dev)正式发布 v4.1.21 版本更新。本次更新全面刷新了底层模型目录,覆盖 209 家供应商共计 6,386 款模型;针对未显式固定模型的 11 家主流供应商(包括 GitHub Copilot 与 Google Cloud Vertex AI),默认推荐模型直接升级为 Anthropic 最新的 Claude Opus 5.5。此外,Cline 新增了日本开源端点 ai& 支持,并紧急升级了底层 YAML 解析器以修复安全隐患。

Cline v4.1.21 正式发布:全量刷新至 6,386 款模型目录,默认全面接入 Claude Opus 5.5

核心要点速览

  • 模型目录扩容至 209 家供应商与 6,386 款模型,实现目前开源 Coding Agent 中最全面的端点覆盖。
  • 11 家核心供应商默认解析模型自动升迁至 Claude Opus 5.5,复杂多文件重构性能显著提升。
  • 新增 OpenAI 兼容的开源模型服务商 ai&,为亚太开发者提供低延迟开源权重访问通道。
  • 强制提升 js-yaml 依赖版本至 4.3.2,彻底修复潜在的 YAML 解析溢出与注入风险。
阅读全文